DeepSeek-V4技术晓读:10% 缓存,27% 算力,百万上下文效率革命
期待了很久的DeepSeek-V4终于发布了,今天刚读完技术报告,这里就跟大家聊聊一些技术侧的解读。
如果让我用一个词来形容过去两年大模型的进化,我会选“变大”。参数从百亿飙到万亿,序列长度从4K硬拉到百万Token,仿佛只要GPU不烧,什么都敢往里塞。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
但做架构的人心里都清楚,这背后藏着一个巨大的尴尬:你把100万字的文档喂给模型,它翻来覆去地算,结果90%的算力没用在“思考”上,全浪费在“回忆”刚才读过什么。
DeepSeek刚交出的DeepSeek-V4,就是冲着这个行业顽疾来的。
看完这篇技术报告,我脑子里只剩一个想法:下一代大模型的架构方向,可能真的要被改写了。
一、大模型的“金鱼脑”困境:你喂的字越多,它忘得越狠?
我们先做一个思想实验。
你在读一本100万字的专业手册。正常人的做法是,读到后面忘了前面,就翻回去查。但大模型不是。它被设计成必须把整本书的每个字,和当前这句话的关系,从头算一遍。
在技术上,这叫“注意力机制的二次复杂度”。翻译成人话就是:你喂的字数每翻一倍,模型要做的计算就翻四倍。
更让人崩溃的是,这还不只是计算量的问题。为了存下这些中间结果(也就是KV Cache,你可以理解成模型的“草稿纸”),显存先炸了。DeepSeek-V3.2处理100万Token时,光存这些草稿纸就需要一大笔显存开销——而这里面大部分内容,其实跟当前要理解的那句话半毛钱关系没有。
这就是我所说的“金鱼脑悖论”:大模型不是记性差,恰恰是它记的方式太“笨”了。它没有“查字典”的机制,只能把整本书背下来,做题的时候再现场推算每一个字的含义。
那问题来了:有没有可能,让模型学会“该记的记,该算的算”?
下面我们就讲讲DeepSeek-V4的记忆解决方案。
二、给大模型装上“伸缩型海马体”:内存要省,但脑筋不能省
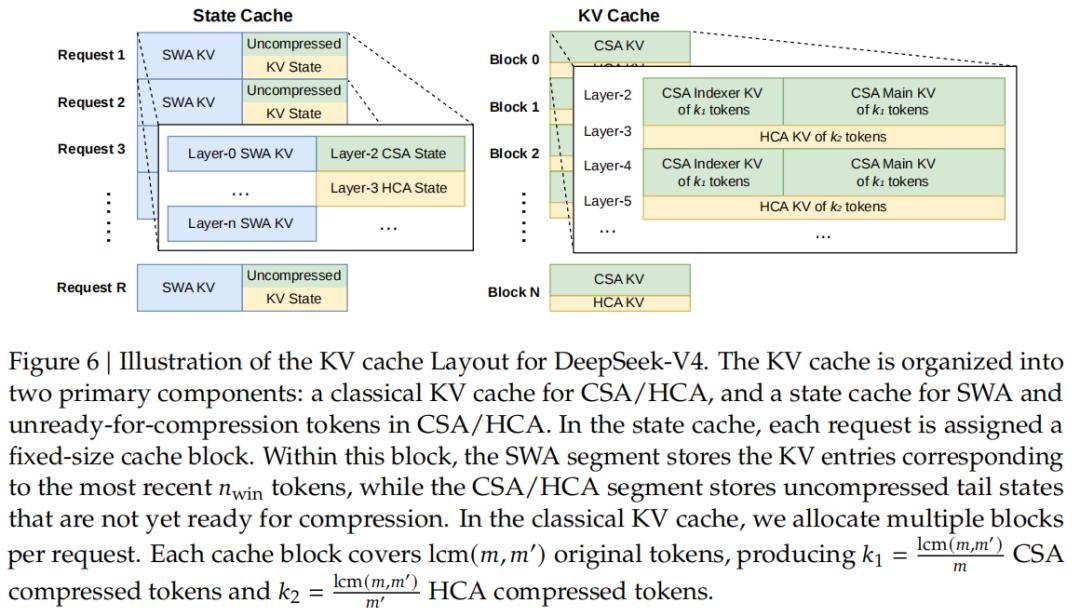
DeepSeek-V4给出的解法,粗暴但极其有效。它设计了一套混合注意力架构,核心逻辑就一句话:把过去的“像素级全量回忆”,变成“压缩后的选择性回忆”。
我来拆解一下这套架构里的两个核心模块——用我最喜欢的一个类比:你在考场上看长阅读题。
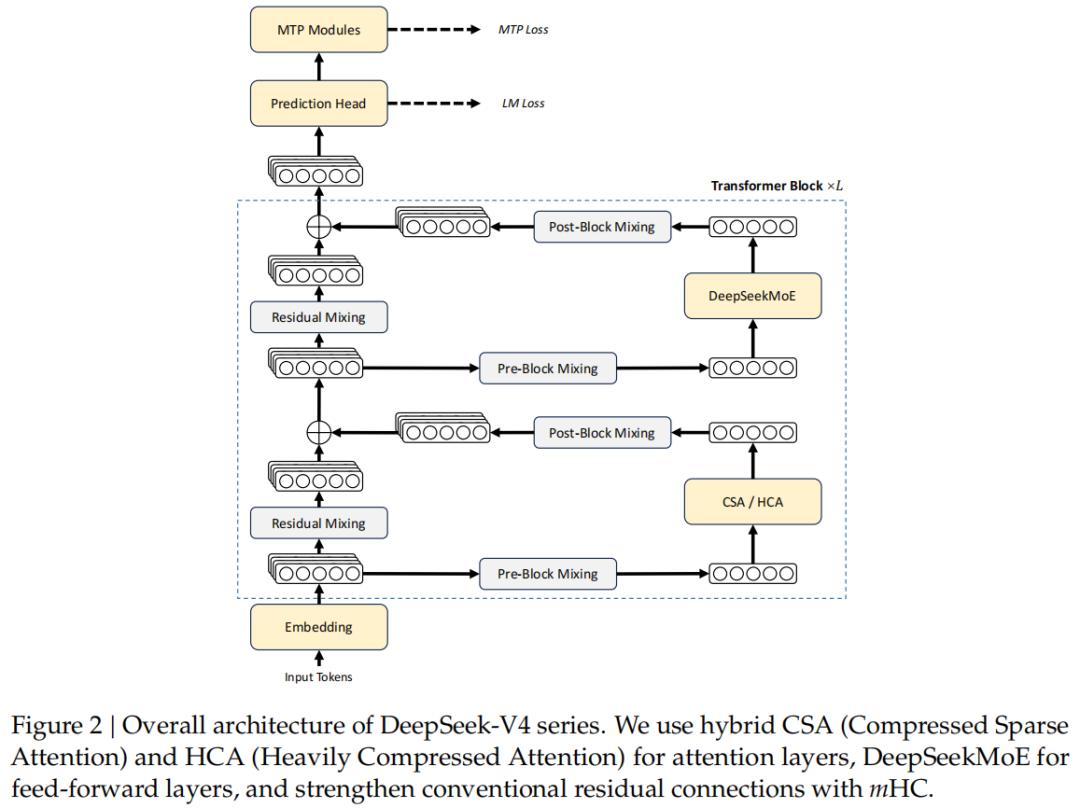
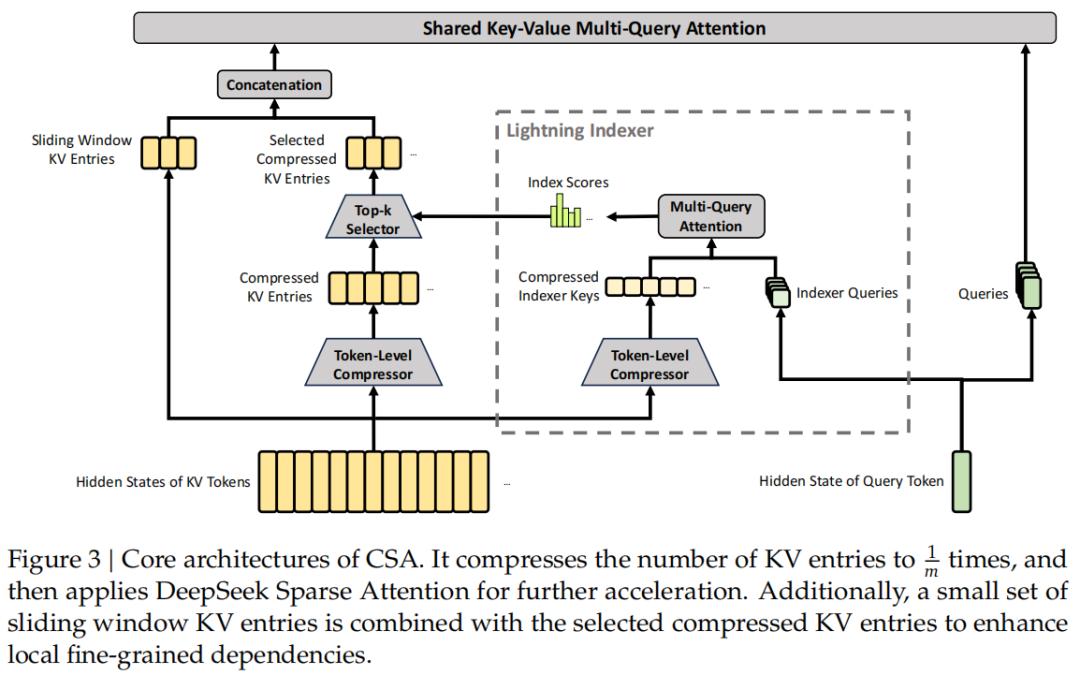
第一个模块叫CSA(压缩稀疏注意力)。
这就像你把长文章每4句话,压缩成一句摘要。然后做题的时候,你不是翻原文,而是只看这些摘要里跟题目最相关的几条。而且你还会额外看一眼当前这句话紧挨着的上下文(滑动窗口),防止摘要丢了细节。
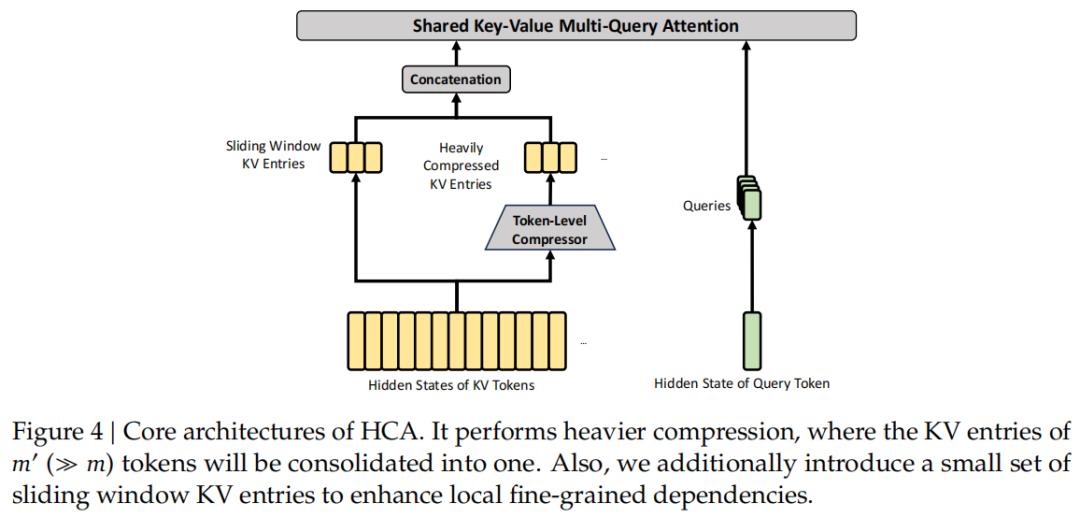
第二个模块叫HCA(重度压缩注意力)。
这更狠,每128句话才压成一条摘要。它不挑重点,全量密集地扫这些摘要。这适合那些需要“通读全文找基调”的题目,细节丢了无所谓,宏观逻辑必须抓住。
这两个模块的精妙之处,不在于它们压缩了信息,而在于它们“交错部署”。
浅层网络用重压缩(HCA),抓宏观脉络;深层网络用轻压缩稀疏检索(CSA),抓细节关联。这完全模拟了人脑处理长文本的方式:先速读建框架,再精读抠细节。
你可能会问,这么搞,效果不会崩吗?
让我最惊讶的,还不是效果没崩,而是它省得实在太狠了。
三、最反常识的结论:1M上下文,计算量竟然比短文本还“划算”?
先看两组数据。
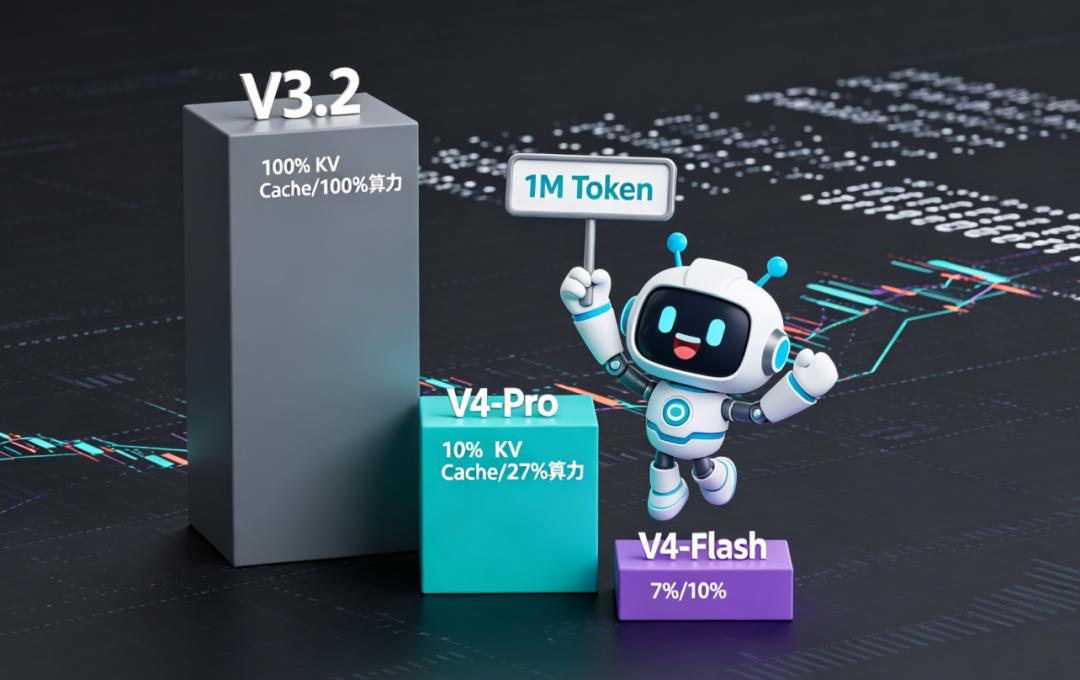
第一组,KV Cache(显存草稿纸)的缩减:
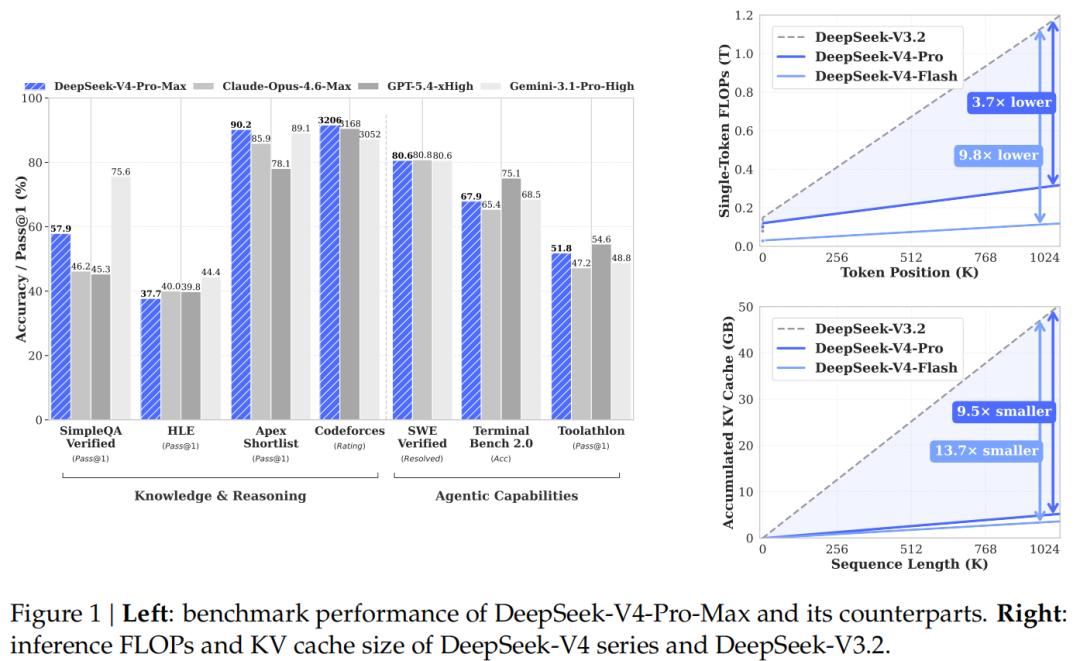
在100万Token下,DeepSeek-V4-Pro需要的KV Cache,只有DeepSeek-V3.2的10%。而更小的V4-Flash,更是只有V3.2的7%。
什么概念?原来需要10张显卡存草稿,现在一张就够了。
第二组,单Token推理计算量的缩减:
同样是100万Token,V4-Pro的单Token推理计算量,只有V3.2的27%。V4-Flash直接干到了10%。
这意味着一个彻底颠覆行业认知的事实:在DeepSeek-V4上,处理长文本的“边际成本”被打下来了。
以前是序列翻一倍,成本翻四倍;现在是序列翻了250倍(从4K到1M),成本的增长却被架构创新给“吃掉”了。
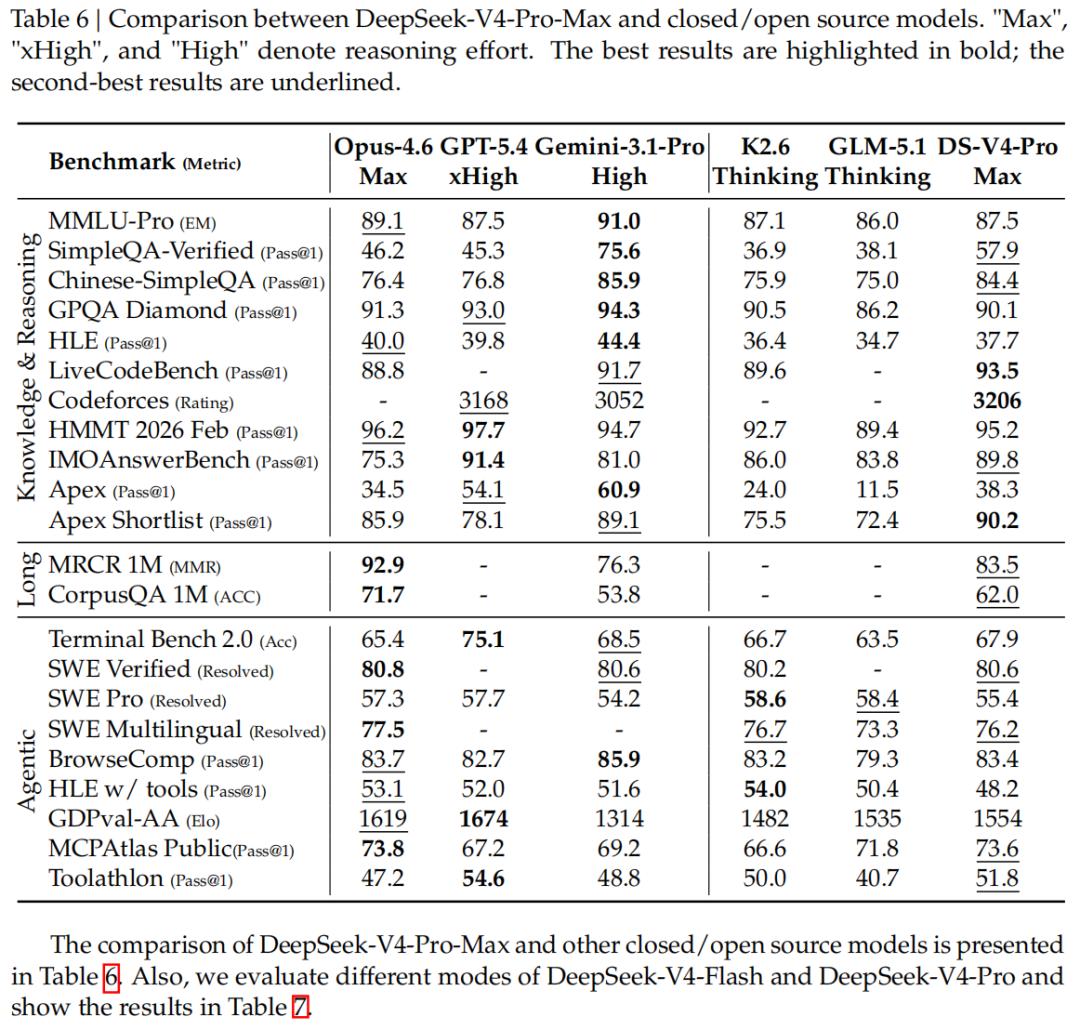
在长上下文评测MRCR(大海捞针测试)里,V4-Pro压着Gemini 3.1 Pro打;在实际检索任务CorpusQA上,同样优于Gemini 3.1 Pro。
效率更高,效果更好。这就是架构创新的暴力美学。
而且,下面这个结论,是所有做大模型应用的人最该关注的——DeepSeek-V4在处理128K以内的上下文时,检索性能几乎没有任何衰减。直到超过128K,才开始出现温和的下降。
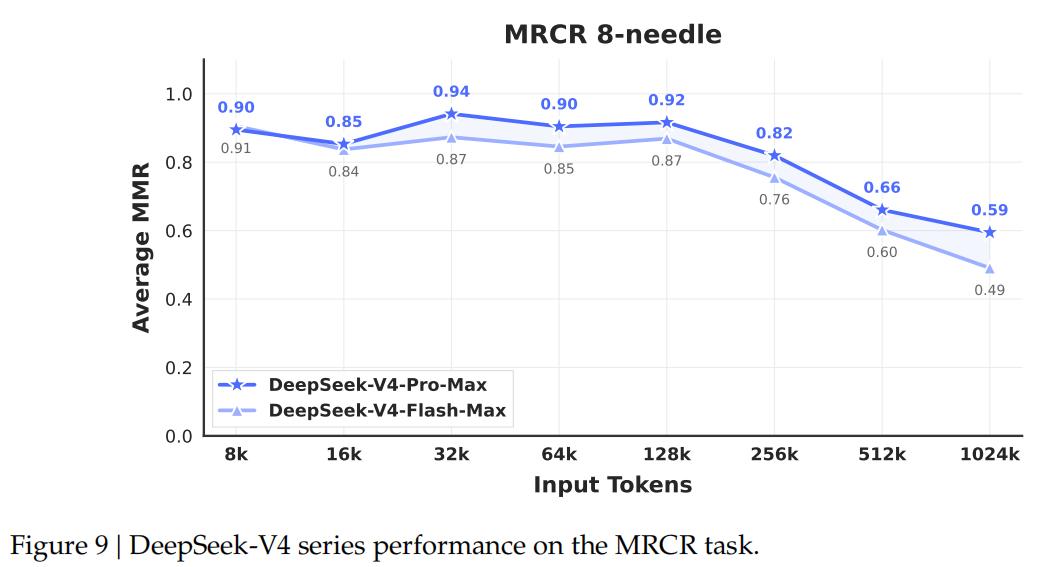
这意味着,对于绝大部分现实世界的长文档任务,V4已经是一个“满血”模型。
四、为什么它能做到?——“计算”负责聪明,“记忆”负责渊博
要理解DeepSeek-V4为什么这么强,你得先理解一个更深层的原理:模型的前几层,到底在干嘛?
大量研究表明,Transformer的浅层,大部分算力其实消耗在了“静态知识的模式匹配”上。比如识别专有名词、提取实体关系、理解基本语法。这些东西,其实不一定需要“算”,很多时候“查”就行了。
DeepSeek-V4的混合注意力,本质上是用记忆的思维解决了计算的问题。
压缩后的KV Cache,就像一个结构化的“外部记忆体”,把那些固定的、模式化的上下文信息存起来。当深层网络需要做复杂推理时,直接从记忆体里捞,而不是从原始Token序列里重新算。
这让我想起认知心理学里的“组块”理论。人脑之所以能处理复杂信息,就是因为我们把零散的信息压缩成了“组块”。DeepSeek-V4的CSA/HCA压缩,就是在给大模型建立“认知组块”。
再往深一层说,这还解决了另一个隐形瓶颈:通信墙。
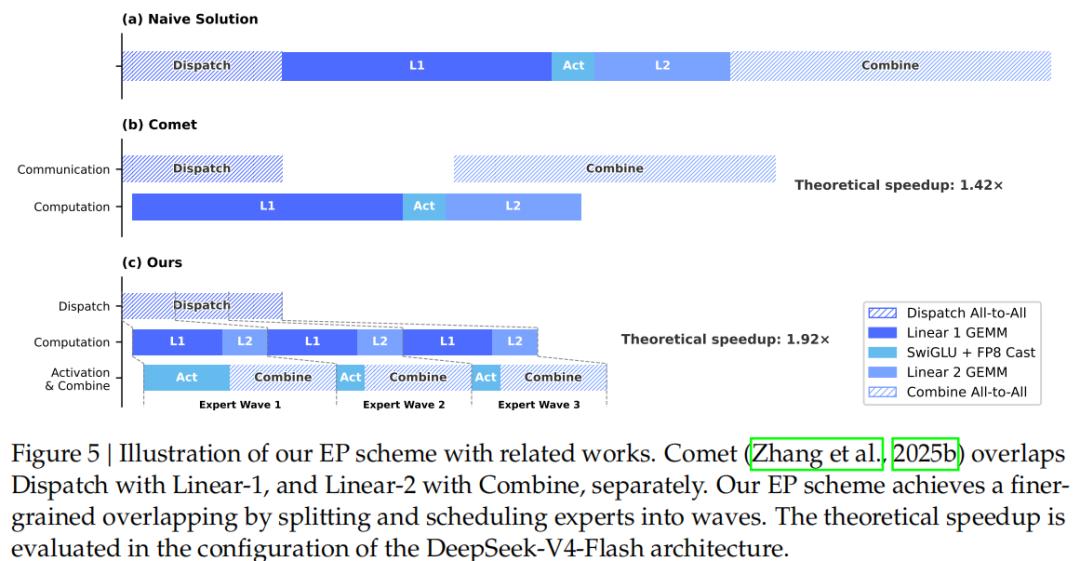
MoE模型里,专家之间的数据搬运是很大的开销。现在KV Cache体积暴降,搬运的数据量少了,通信瓶颈自然就缓解了。DeepSeek-V4在论文里甚至做了极致的工程优化——Fine-Grained通信计算重叠,让数据搬运和计算几乎完全并行,这是它能从“纸上理论”变成“实际可用”的关键临门一脚。
五、工程落地:这不仅是一篇论文,这是一张量产蓝图
我见过太多架构创新死在工程落地上。但DeepSeek-V4这篇论文,最让我感到“恐怖”的,是它对工程实现的极致思考。
为了把FP4精度真正用起来,他们设计了一套“无损耗反量化”方案——FP4到FP8的转换不丢精度,这在之前很少有人这么干。结果是,专家权重直接砍到4位精度,内存带宽压力骤减。
为了在推理时彻底消灭“重复预填充”的开销,他们设计了基于磁盘的KV Cache共享方案。同一个长文档,多个请求共享一份压缩后的Cache。这在企业级RAG场景里,是实实在在的降本增效。
还有一个我个人认为最“天才”的小设计——Quick Instruction特殊Token。
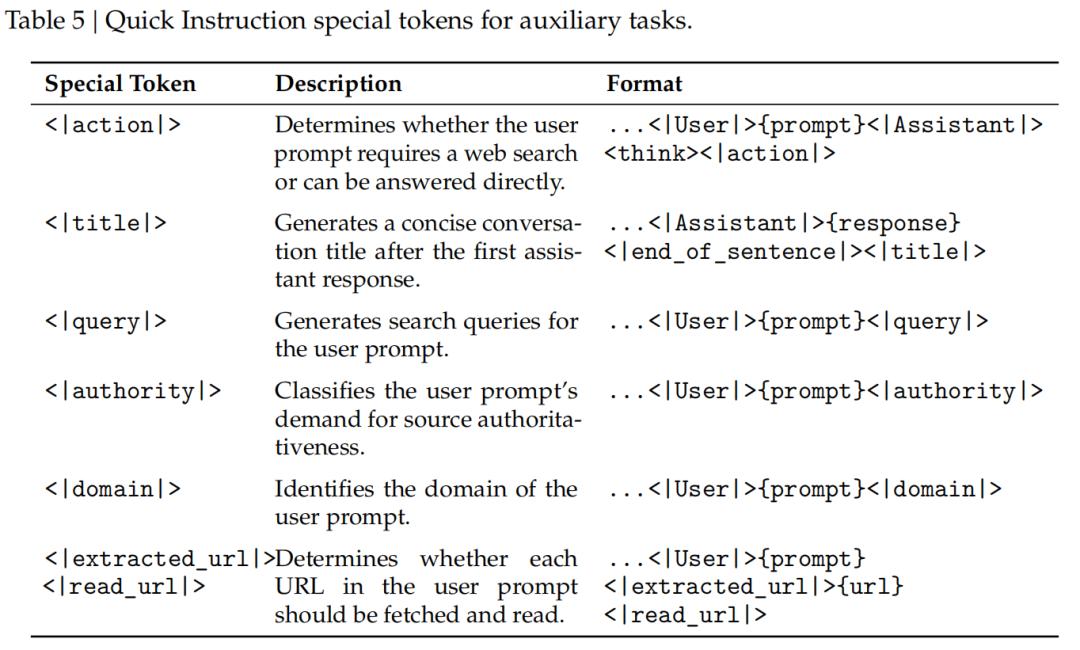
在Chatbot里,判断要不要搜索、用户意图识别这些辅助任务,以前得靠另一个小模型跑一次推理。DeepSeek-V4直接在主模型输入里插几个特殊Token,复用已经算好的KV Cache,零额外推理成本完成这些任务。
首Token延迟直接往下砍,这是对用户体验的一种“架构级关怀”。
这整套组合拳打下来,DeepSeek-V4不再是实验室里的“概念车”,而是一台可以直接开上产线、在百万Token战场里狂飙的“量产超跑”。
写在最后:放弃“全知全能”的执念,拥抱“知道该记住什么”的智慧
写到这里,我突然想起博尔赫斯那篇著名的小说——《博闻强记的富内斯》。
富内斯拥有完美的记忆,能记住每一片树叶的纹理、每一秒的光影变化。但他却痛苦不堪。因为他无法抽象思考——“思考,就是忘记差异,就是归纳,就是抽象。”
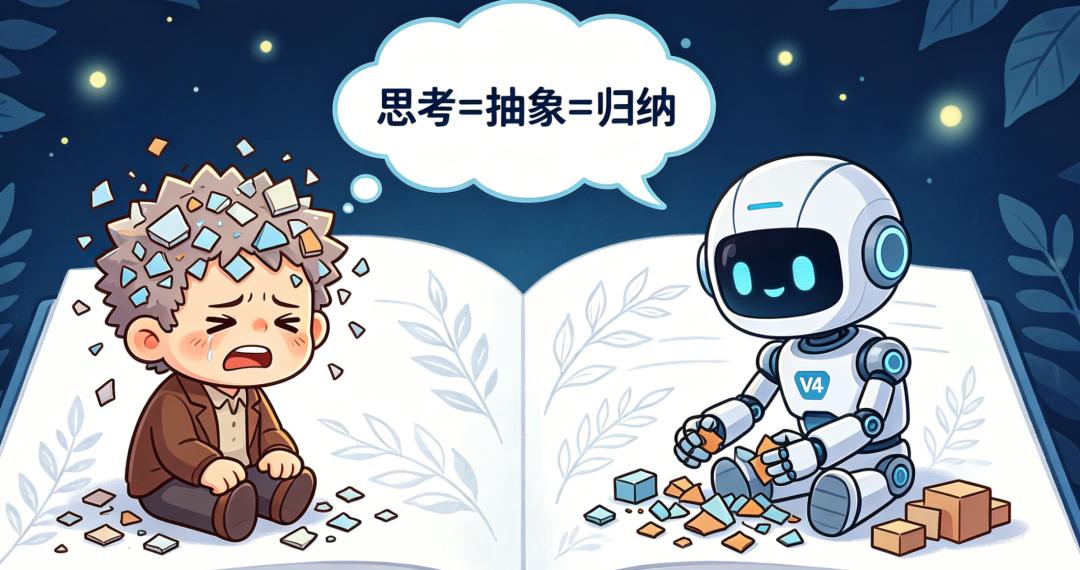
纯全量注意力的大模型,就是博尔赫斯笔下的富内斯。它能记住一切,却被记忆压垮了思考。
而DeepSeek-V4的意义,不只是提出了一种新的注意力机制。它是在告诉我们:真正高效的智能,不是去“记住一切”,而是懂得“该用什么方式,记住该记的东西”。
该细看的地方,用滑动窗口精读。该全局把控的地方,用重压缩速读。该关联检索的地方,用稀疏注意力跳读。
这既是一种架构创新,更是一种设计哲学。放弃对“无损”的执念,拥抱对“效率”的追求。
这或许才是大模型走向真正百万级上下文、甚至在线学习的最关键一步。
毕竟,聪明的人,从来不是记得最多的那个。而是最懂得如何管理自己记忆的那个。
参考资料
• DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence