SIGIR'26|DPPMG首创图文同源个性化多模态生成:图文一致更懂你
今天要给大家分享一个我们团队刚刚被 SIGIR 2026 接收的研究成果,给大家分享一下,这个技术到底是怎么让 AI 真正 "读懂你“的同时也让生成图文更一致的。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
不知道你有没有过这样的崩溃时刻:找AI生成一张硬核科幻电影海报,明明反复强调要冷色调、暗黑风、紧张感,结果它给你画了个蓝天白云配飞船的小清新插画。
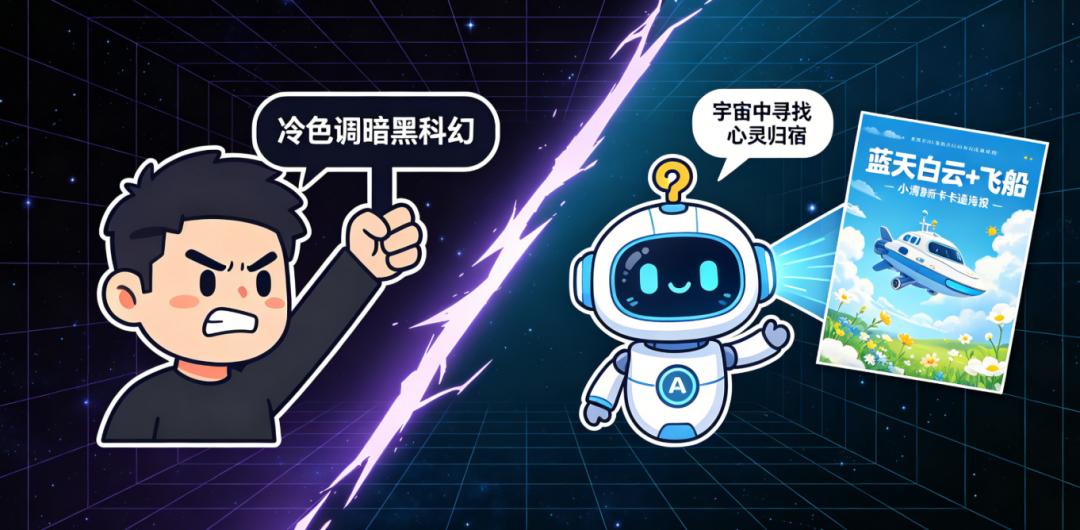
更离谱的是,配套的电影简介写得像文艺片独白,什么“在浩瀚宇宙中寻找心灵的归宿”,海报和文字各玩各的,完全不在一个频道上。
这种“AI不懂我”“图文各说各话”,真的不是你的Prompt写得不好。这是整个AI多模态生成行业,存在了好几年的普遍死穴。过去这么多个性化生成方案,很多都走偏了,没有摸到问题的本质。我们团队花了近一年时间,终于挖透了根源,并且提出了一个全新的底层解决方案——DPPMG离散偏好学习框架。
先问大家一个灵魂问题:为什么AI猜不透你的喜好?为什么生成的图文对不上?本质上,是两个天生的瘸腿问题,从来没被真正解决过。
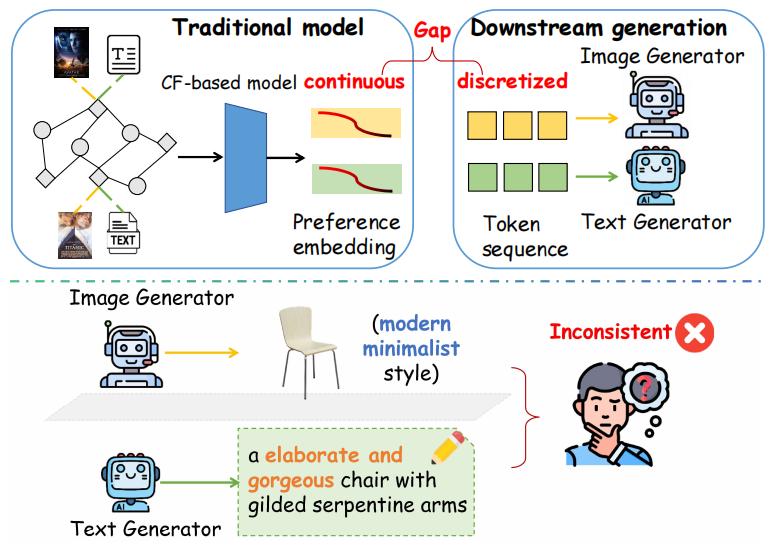
第一个问题,是偏好建模和内容生成之间的底层鸿沟。
推荐系统搞了二十多年,最擅长的就是从你的点击、浏览、收藏里挖偏好,用图神经网络、协同过滤这些成熟技术,精准算出你喜欢什么风格、什么题材、什么调性。但问题来了:推荐系统输出的是连续的向量,就像一幅连绵的山水画;而现在所有的大模型、扩散模型,天生只认离散的token——也就是一个个独立的字、词、符号,像活字印刷里的单个铅字。
连续的山水画,根本没法直接拆成活字去印刷。之前的解决方案有多敷衍?要么把用户的历史内容一股脑全塞进prompt,有用的没用的混在一起,全是噪音;要么把图片转成干巴巴的文字描述,“这是一张有飞船的图”,直接丢了90%的视觉细节。AI连你的审美是什么都不知道,怎么可能生成你想要的东西?
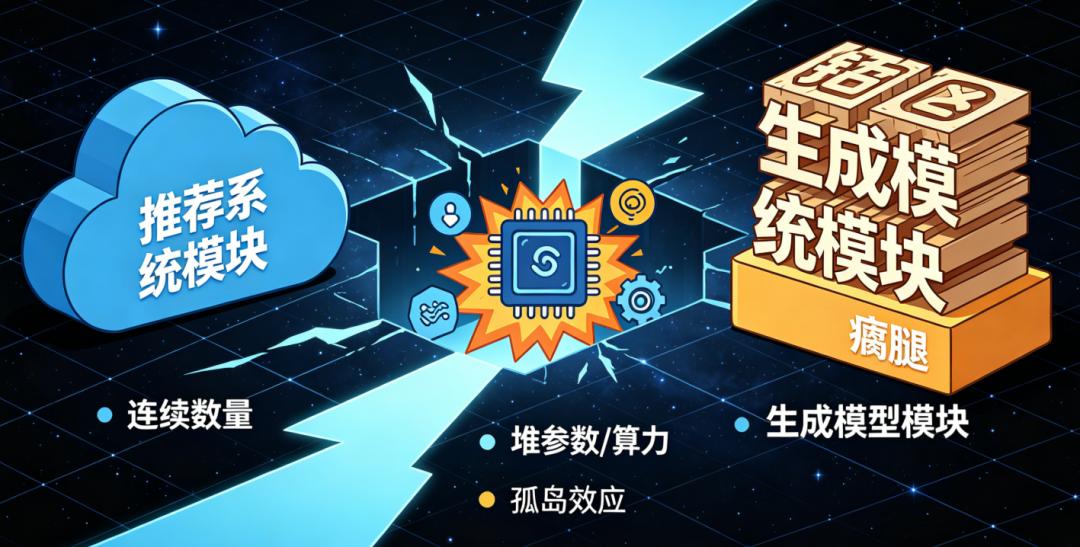
第二个问题,是单模态生成的孤岛效应。
我们现实里接触的内容,从来都是图文一体的:电影是海报配简介,广告是图片配文案,短视频是画面配台词。但现在的AI,生成图片和生成文字是两条完全独立的流水线,图片管审美,文字管内容,根本不互通。就像两个翻译,一个翻英文、一个翻中文,各翻各的,最后合起来驴唇不对马嘴。我们看到的90%以上的AI图文翻车,根源都在这里。
更可惜的是,很多人解决问题的思路,居然是“堆参数、堆算力”。全量微调成本高到中小公司根本承受不起,LoRA微调还是要动大量参数,很容易把模型本身的通用能力搞崩。而且最关键的是,这些方法从根本上解决不了上面两个底层矛盾,只是在表面修修补补。
那我们是怎么做的呢?我们提出的DPPMG框架,核心逻辑可以用一句话概括:活字印刷式偏好定制。
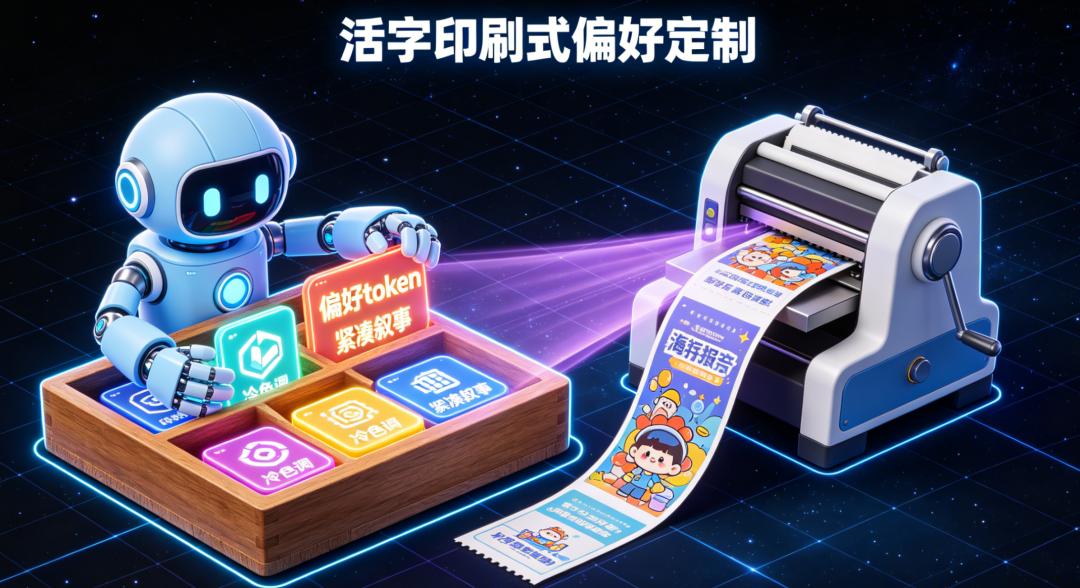
我们用两阶段的设计,彻底补上了前面说的两个漏洞。
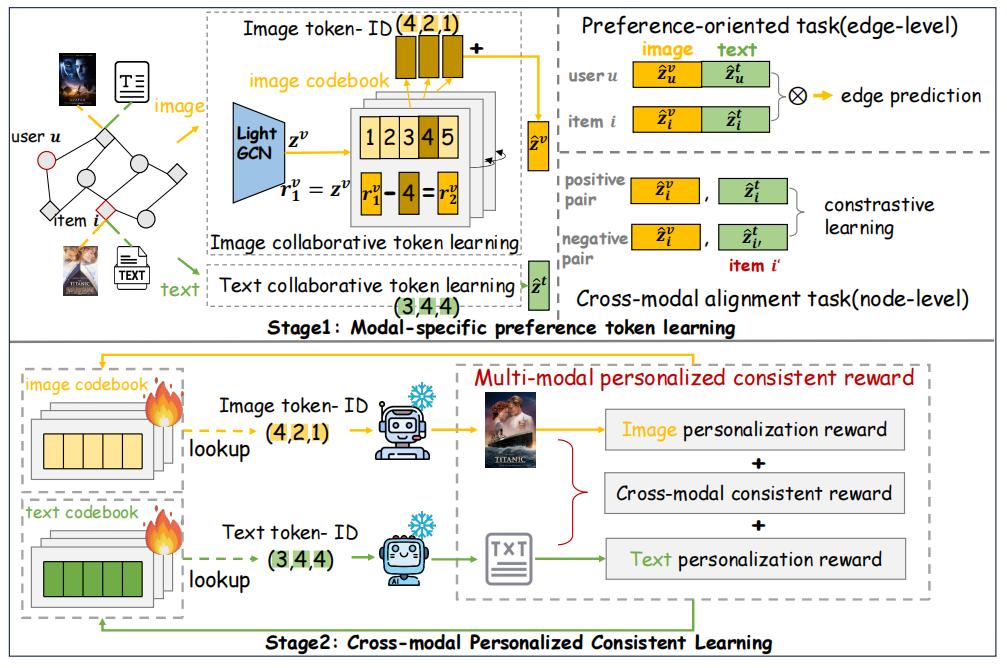
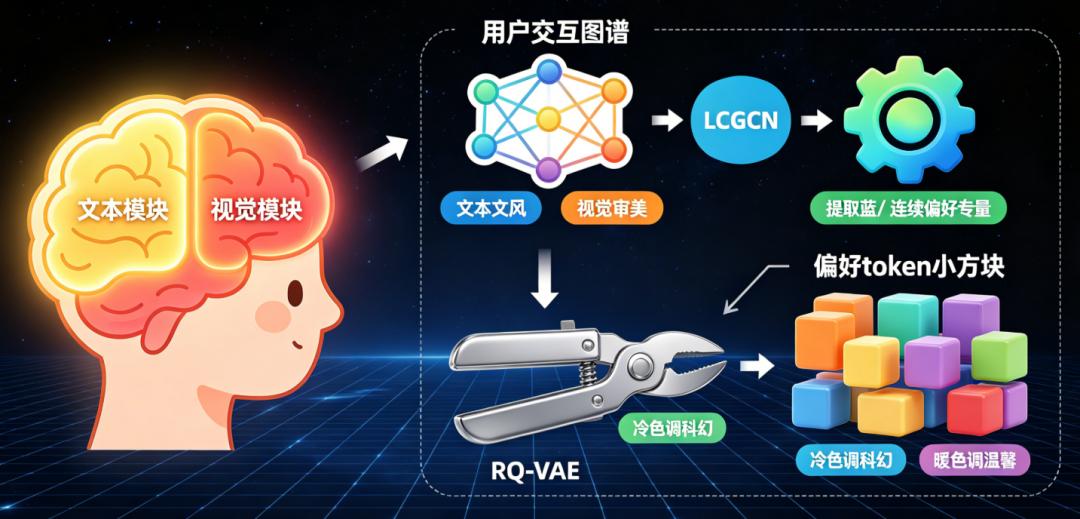
第一阶段,我们把用户模糊的、连续的偏好,做成一套专属的、AI能直接读懂的“活字铅字”。
我们没有沿用传统的混合偏好建模方式,而是复刻了人类大脑“认知模块化”的逻辑——先为文本和视觉分别构建独立的用户交互图谱,分开建模用户的文字文风偏好和视觉审美偏好,从源头避免“图文风格错位”。
首先,我们用推荐系统中非常成熟的LightGCN模型,分别提取用户的文本和视觉专属连续偏好向量。我们引入了残差向量量化技术,也就是RQ-VAE,把连续的偏好向量,拆解成了固定长度、可解释的离散“偏好token”。
这个过程就像把人类复杂的情绪,转化成精准的表情包。每个token都对应一个明确的偏好标签,比如“冷色调科幻”“紧凑叙事”“柔和发光轮廓”。AI不用再猜你喜欢什么,直接调用这些token就行。
为了保证这些“活字”的可靠性,我们还加了两个关键约束:一个是偏好真实性约束,确保用户点击过的内容得分永远高于未点击内容;另一个是跨模态对齐约束,让同一风格的文本token和视觉token指向同一个语义空间。这就从根源上解决了“图文各说各话”的问题。
第二阶段,我们把这些专属“活字”插进生成模型,用最小的成本实现个性化。
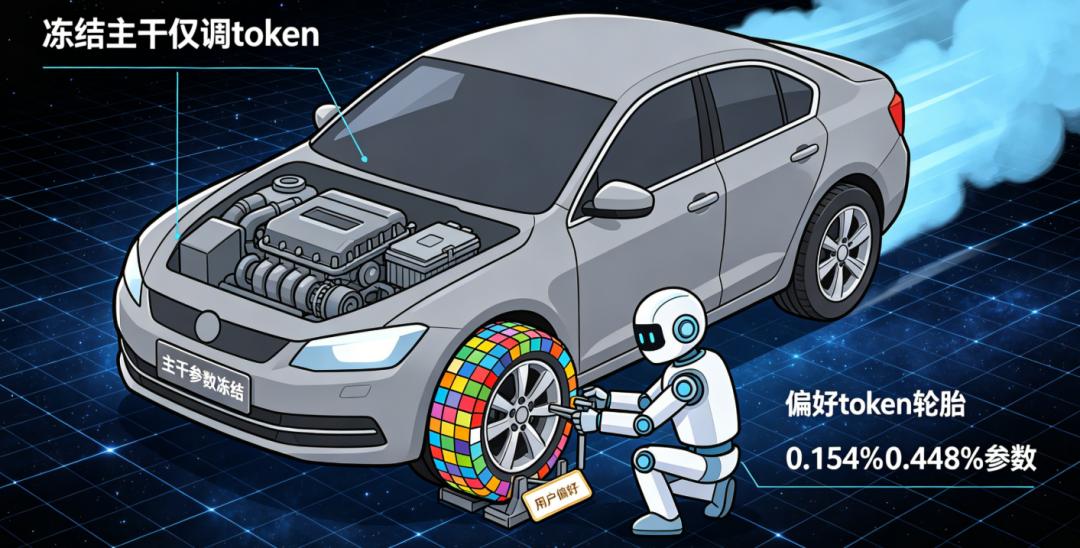
为了极致提升系统效率,整个过程中,大模型和扩散模型的主干参数完全冻住,一丝不动。我们只微调这些偏好token相关的参数。就像你给一辆车换了一套定制的轮胎,发动机、变速箱全不动,就能让这辆车完美适配你的驾驶习惯,还不用重新造车。
我给大家看一组数据:我们这个方案,图像分支需要训练的参数仅占0.15%,文本分支仅占0.44%,99.8%以上的模型参数保持不动。训练成本只有全量微调的几百分之一,单张A100显卡就能跑,而且完全不会破坏原模型的通用能力。这对于中小公司来说,绝对是福音。
最后,我们还设计了“跨模态一致性+个性化”的联合奖励机制,一边确保生成的图文都贴合用户偏好,一边让图文的语义、风格完全对齐。
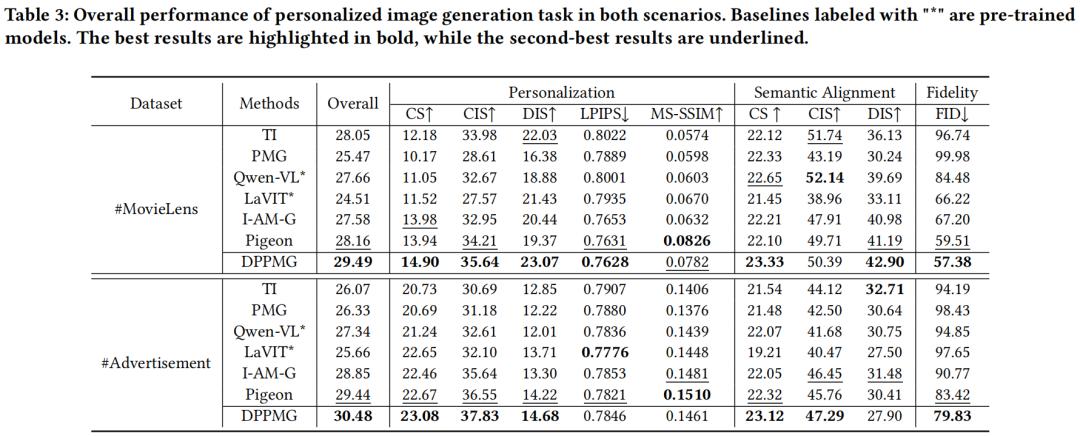
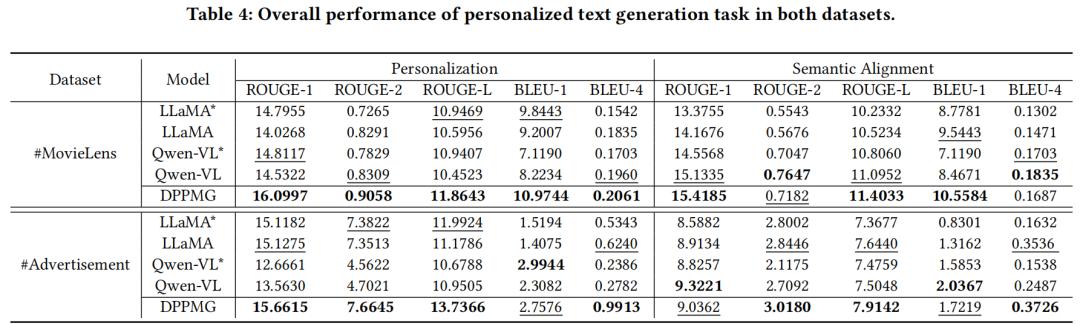
为了验证这个方案的效果,我们在电影和广告两个真实工业数据集上,做了全面的对比实验。结果显示:DPPMG在图像个性化相似度、文本个性化匹配度的多个核心指标上,均全面超越了此前的最优模型。
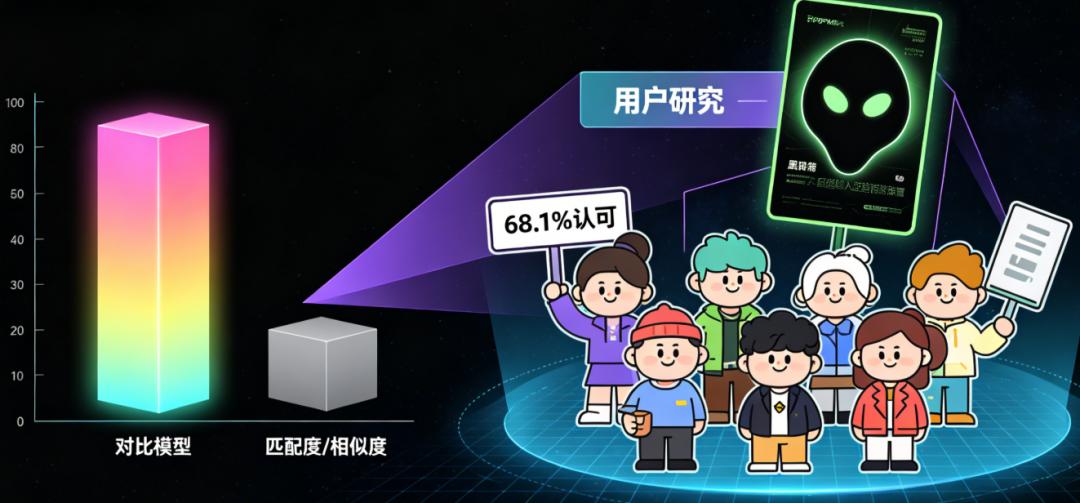
更有说服力的是用户研究结果:68.1%的测试用户认为,DPPMG生成的图文匹配度远高于同类方案。
我给大家举一个最直观的例子:
有一个用户,过往常浏览《星球大战》《夺宝奇兵》这类硬核科幻电影。我们给他生成电影《异形》的海报和简介。传统方案生成的海报,要么是纯暗黑恐怖风,完全不符合用户的审美;要么简介写得温情脉脉,和海报风格脱节。
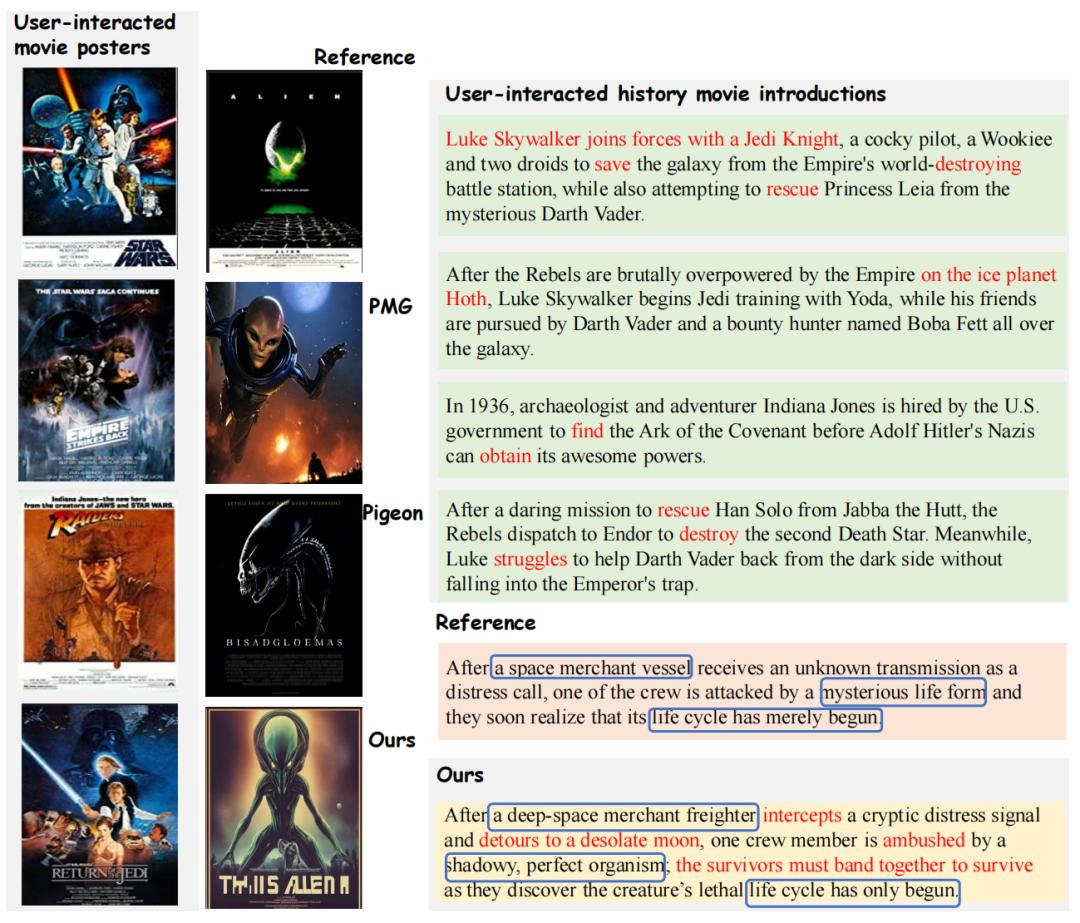
而DPPMG生成的海报,既保留了《异形》本身神秘暗黑的基调,用了黑绿配色和外星生物剪影,又融入了用户偏爱“柔和发光轮廓、略带卡通感角色”的视觉偏好。配套的简介,不仅精准保留了“太空商船、求救信号、未知生物”等核心剧情,还沿用了用户历史浏览内容中“救援、对抗、生存”的紧凑语气。图文语义高度契合,完全没有出现传统方案的脱节问题。
还有一个例子:
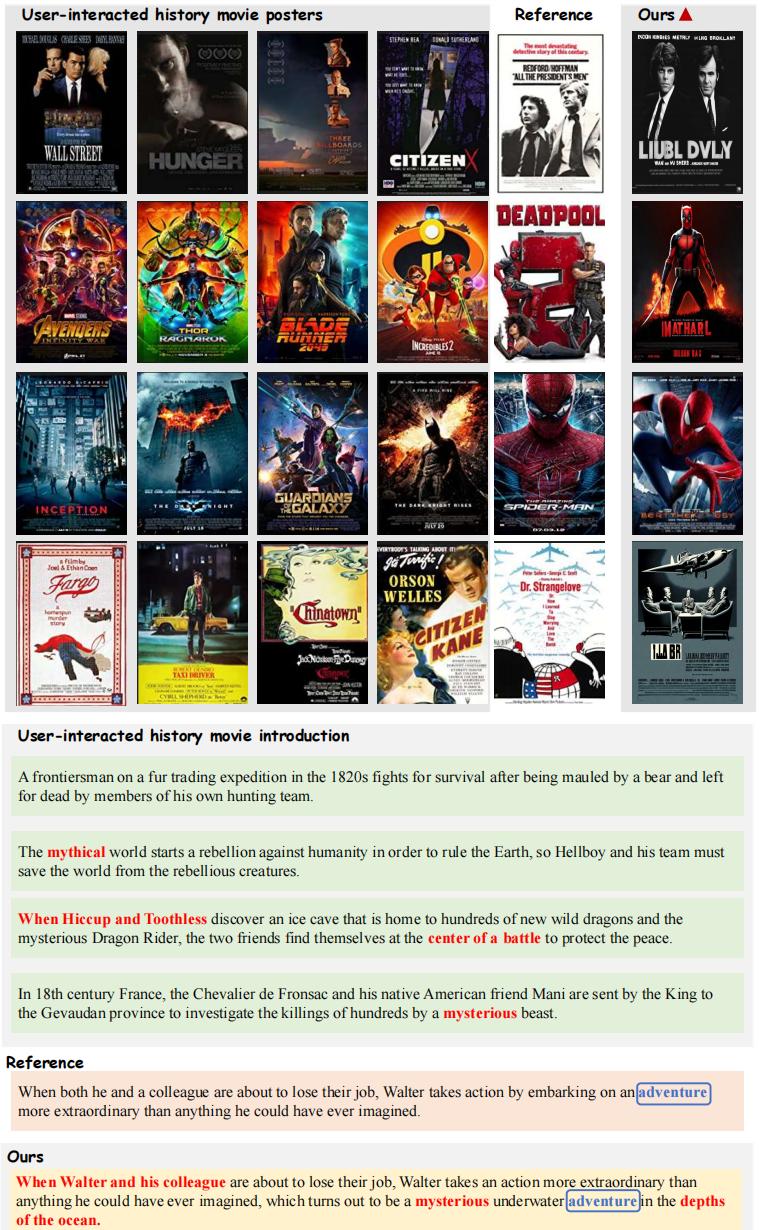
给偏爱“冒险生存”风格的用户,生成的海报是角色特写、动态构图,简介侧重“绝境求生”的剧情;给喜欢“奇幻生物”风格的用户,海报则是充满神秘气息的生物造型,简介围绕“奇幻世界叛乱”展开。
这就是DPPMG的核心优势:既能精准捕捉每个用户的个性化偏好,不管是视觉风格还是文本语气,又能保证生成的图文不脱节、风格统一,而且不用大规模微调模型,仅靠少量偏好token就能实现。
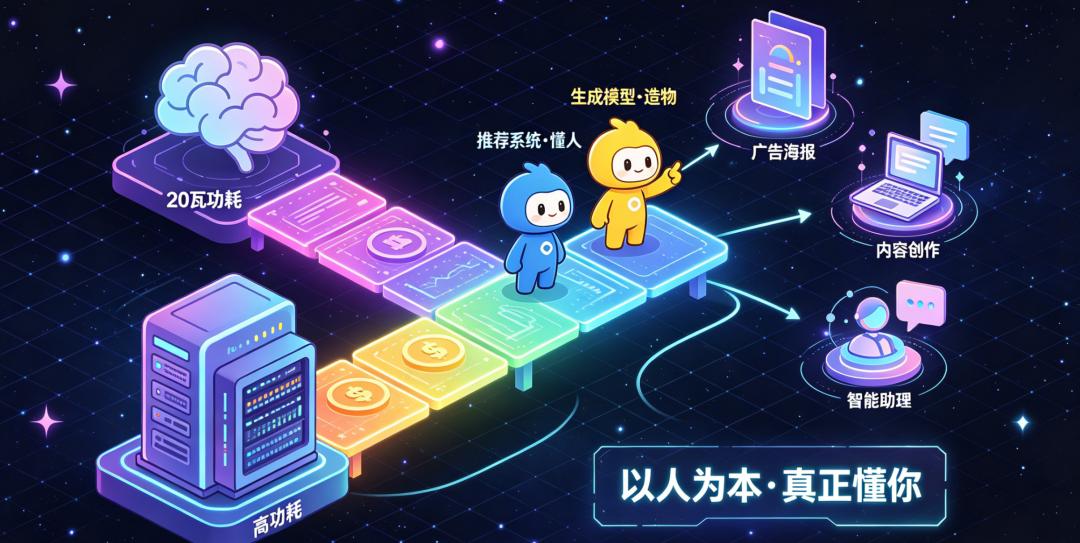
最后,我想和大家分享一点我们做这个研究的思考。现在整个AI行业都在卷参数、卷算力,好像参数越多、算力越足,AI就越聪明。但人类的大脑仅用20瓦功耗,就能完成超级计算机都做不到的事,核心就在于分工明确:该感知的感知,该记忆的记忆,该推理的推理。
DPPMG的创新,本质上就是给AI找对了分工:让擅长挖掘用户偏好的推荐系统负责“懂人”,让擅长生成内容的大模型负责“造物”,用离散的偏好token作为两者之间的桥梁。而不是让生成模型既要学习海量的通用知识,又要记住每个用户的个性化偏好,最后什么都做不好。
AI发展到今天,我们已经从“能不能生成内容”的阶段,进入到“能不能生成我想要的内容”的阶段。我们认为,AI的终极命题从来不是“全能”,而是“懂你”。真正的以人为本,不是让AI变成无所不能的超人,而是让它能读懂人类那些模糊的、不可言说的“我喜欢”。
DPPMG框架已经具备了通用性和可扩展性,未来能够应用在包括广告生成、内容创作、智能助理等多种业务场景。我们相信,这个新范式,能够让更多用户体验到“真正懂你”的AI生成能力。
我们也欢迎更多的研究者和工程师,和我们一起完善这个技术,推动AI多模态生成向更懂人的方向发展。谢谢大家!
作者:张长旺 @ https://changwangzhang.github.io
参考资料
• Discrete Preference Learning for Personalized Multimodal Generation, SIGIR2026.