英伟达发布Lyra 2.0|800帧零漂移,3D生成旧方案可以退休了
核心痛点 (❓)
- • 图1:用于直观展示Lyra 2.0的核心能力,作为开头钩子后的视觉冲击。匹配“背景、问题、场景、对比(旧方法)”。
原理拆解 (🏗️ / 💡)
- • 图2 (整体架构图):必须插入到讲解整体工作流程的章节开头。匹配“架构、框架、overview、pipeline”。
- • 图9 (统计分析图):插入到讲解“空间记忆”检索机制时,用于说明超参数选择。匹配“性能评估、计算效率”。
- • 表3 (消融实验表):插入到消融实验分析章节。匹配“消融、贡献、组件、影响”。
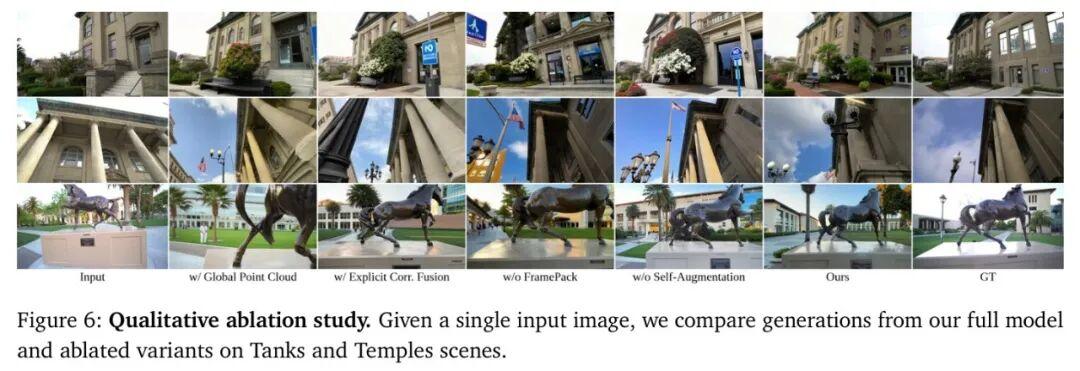
- • 图6 (消融研究):插入到消融实验分析章节,作为表3的定性补充。匹配“消融研究、定性对比”。
实验验证 (🏆 / 🔬)
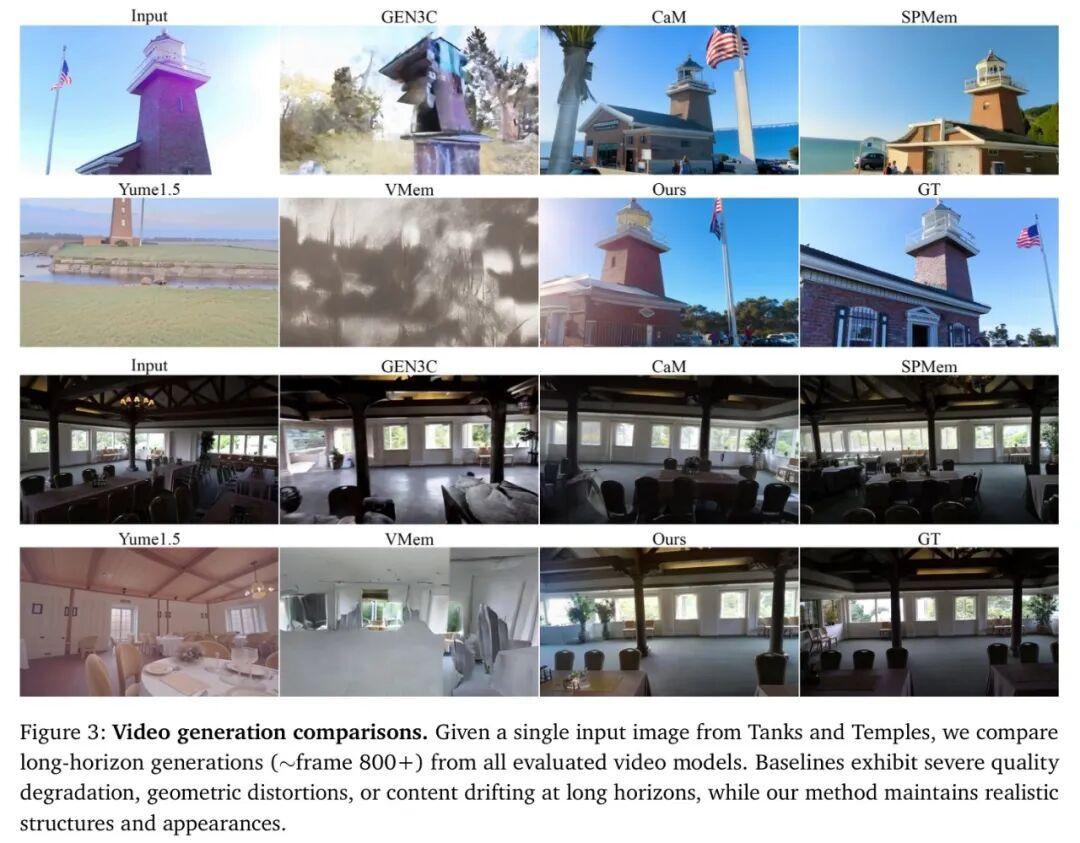
- • 图3 (视频生成对比):插入到SOTA对比章节,展示长时序生成质量。匹配“对比、SOTA、视觉对比、结构保真”。
- • 表1 (长视频SOTA对比):插入到SOTA对比章节,展示量化指标。匹配“SOTA对比、FID、SSIM”。
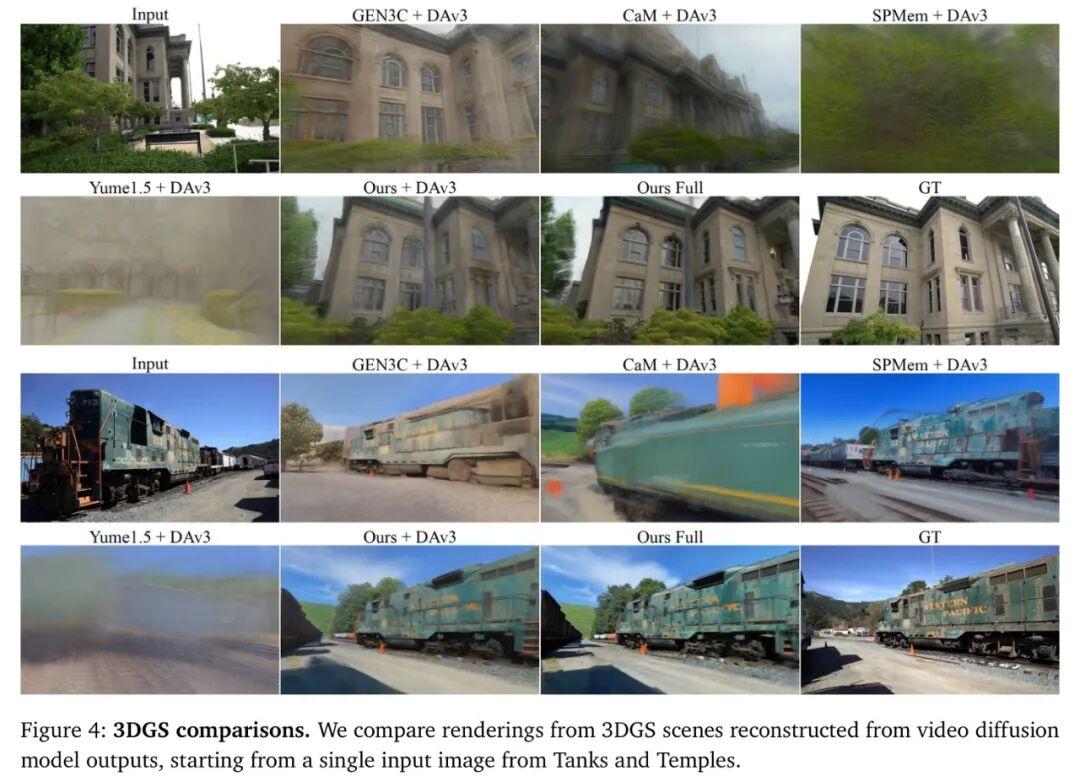
- • 图4 (3DGS渲染对比):插入到3D场景生成对比章节,展示渲染质量。匹配“渲染质量、视觉对比、纹理保真”。
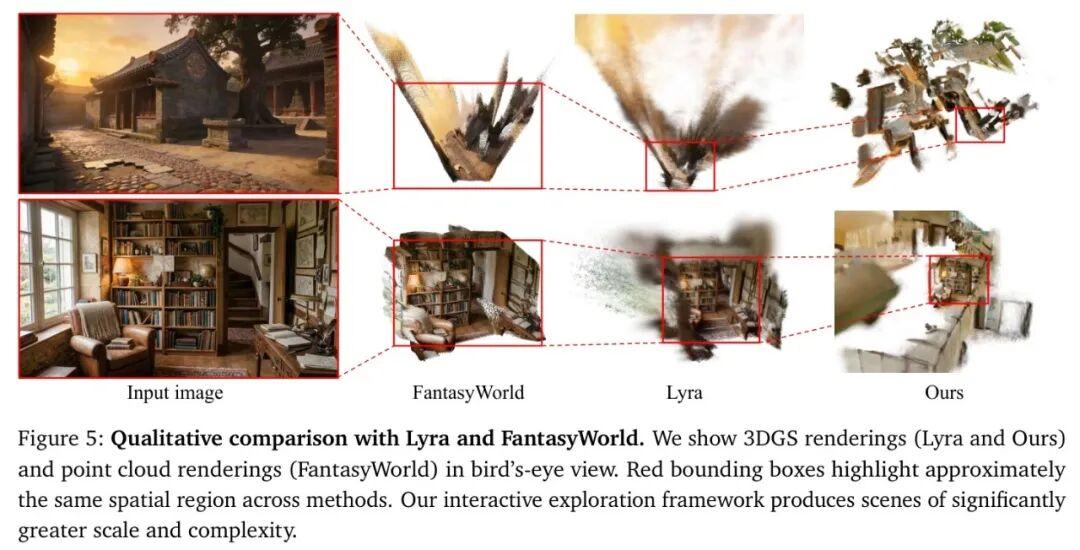
- • 图5 (3D场景生成对比):插入到3D场景生成对比章节,展示鸟瞰视图。匹配“方法对比、鸟瞰视图、视觉质量评估”。
- • 表2 (3D场景SOTA对比):插入到3D场景生成对比章节,展示量化指标。匹配“SOTA对比、FID、主观质量”。
应用与展望 (🚀)
- • 图7 (应用演示):插入到讲解实际应用与工程落地的章节。匹配“应用演示、机器人仿真、交互式界面”。
- • 图8 (In-the-Wild生成):插入到讲解方法泛化能力和实际部署的章节。匹配“In-the-Wild、多视角探索、场景生成”。
你还在为生成式3D重建的“空间失忆”和“时间漂移”两大顽疾头疼吗?给你一张街景图,模型生成的视频走几步就忘了来时的路,再走几步画面就糊成一团?今天,一个名为Lyra 2.0的框架,通过一套“几何导航,像素创作”的颠覆性设计,不仅解决了这两个核心难题,更实现了从单张图像到可交互、可仿真的宏大3D世界的惊人跨越。
读完本文,你将彻底理解Lyra 2.0如何像一位拥有“空间记忆”的建筑师,仅凭一张蓝图,就能在脑海中构建并持久维护一个庞大而一致的数字世界。
❓ 核心痛点:为什么3D世界生成总是“健忘”又“跑偏”?
想象一下,你给AI一张客厅的照片,让它生成一个虚拟漫游视频。一开始效果惊艳,但当你操控相机“走”到房间另一头再“回头看”时,问题来了:沙发可能变了形状,墙壁纹理对不上,整个场景仿佛失忆了一般。
这背后是当前生成式3D重建的两大死穴:
- 空间遗忘:现有视频扩散模型(如Wan 2.1)的自注意力机制只能“看到”有限的时间窗口(比如最近几十帧)。一旦相机移动,先前观察过的区域就超出了模型的“短期记忆”。当相机重访这些区域时,模型只能凭空“脑补”,导致全局布局崩坏。
- 时间漂移:自回归生成如同“传话游戏”,每一步微小的合成误差(颜色偏差、结构模糊)都会累积放大。在长轨迹探索中,持续引入的新视角减少了与可靠历史帧的重叠,误差失去约束,最终导致画面严重失真、色彩漂移。
现有的解决方案往往顾此失彼:要么依赖脆弱的全局3D重建作为条件,一旦重建有误,后续生成全盘皆输;要么完全让模型自己“硬想”长程几何关系,结果在大视角变化下彻底失效。
但为什么99%的优化尝试都失败了?关键就在于没有将“几何推理”与“像素合成”这两个任务优雅地解耦。
🏗️ 架构解析:Lyra 2.0如何像建筑师一样工作?
Lyra 2.0的答案清晰而有力:让3D几何只负责“导航”和“索引”,让强大的视频生成先验专注于“创作”和“修补”。它不再强迫一个模型同时做两件事,而是构建了一个分工明确的协作系统。
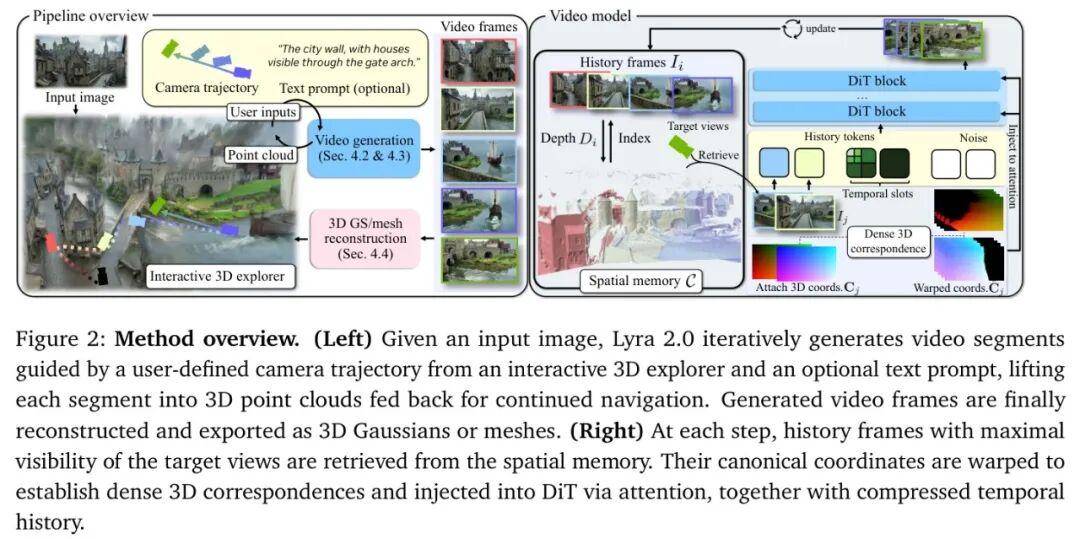
整个系统是一个“检索-生成-更新”的闭环。用户给定单张输入图像和一条想要的相机轨迹,系统便开始工作:
- 检索:根据目标相机位姿,从一个动态增长的 “3D缓存” 中,检索出几何上最相关的历史帧(最多5帧)。
- 生成:将检索到的历史帧、它们与目标视角之间的密集3D对应关系,以及压缩后的时间历史上下文,一同输入给一个强大的相机条件视频扩散模型(基于Wan 2.1 DiT),生成下一段视频。
- 更新:将新生成的帧及其估计的深度信息,作为新的“记忆”存入3D缓存,为后续生成提供更丰富的空间锚点。
这个流程的核心创新,在于中间那个“3D缓存”和它的使用方式。它不是一个融合了所有误差的“终极全局地图”,而是一个逐帧存储、独立维护的几何档案库。每帧都有自己的点云和深度图,避免了错误跨帧传播。
💡 核心创新点一:3D几何驱动的“防遗忘”记忆系统
3D缓存:不融合,只索引
Lyra 2.0为每一帧生成图像都维护两个几何信息:全分辨率深度图和一个下采样(8倍)的点云。关键是不做全局融合。这就像建筑师不把所有的测量草图强行拼成一张总图,而是分门别类放好,需要时再按索引抽取。这样做避免了早期深度估计的误差被累积并污染整个场景表示。
几何感知检索:找最“有用”的历史
当要为新的目标视角生成画面时,系统如何从缓存里挑出最有帮助的“记忆”?
它计算一个可见性分数。简单来说,就是把每个历史帧的点云投影到目标视角的虚拟屏幕上,看有多少点能被“看到”(且不被遮挡)。系统会贪婪地选择那些能覆盖最多尚未被覆盖的目标像素的历史帧,最多选5帧。
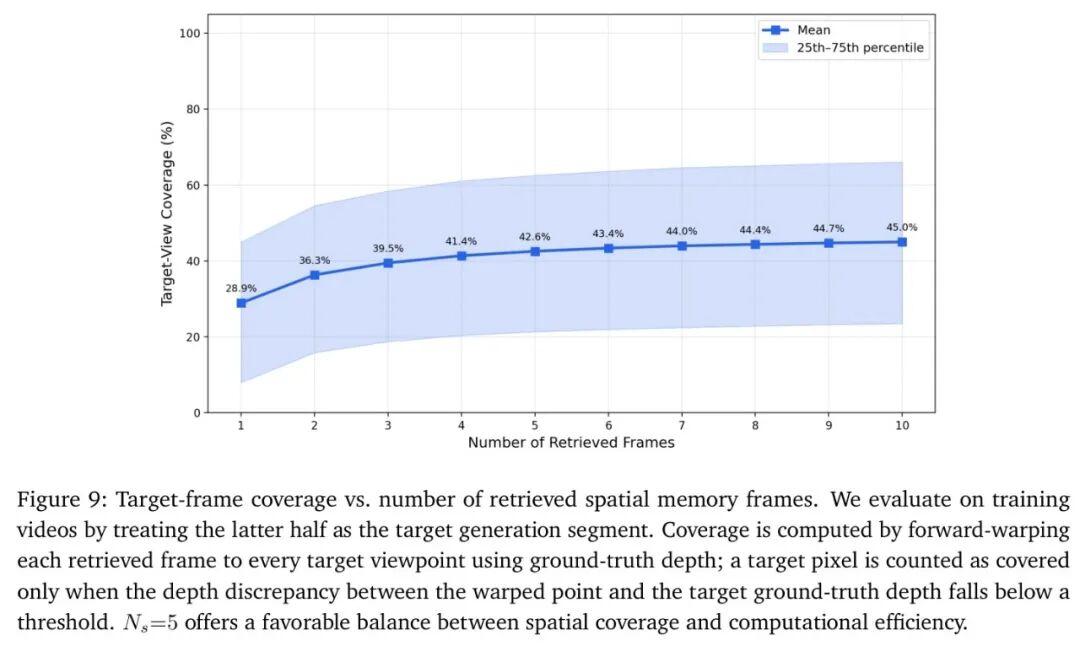
这张图清晰地展示了检索帧数的收益递减规律。覆盖度从1帧的28.9%提升到5帧的约42%后,增长明显放缓。因此,选择Ns=5是一个兼顾效果与效率的明智决策。
注入“空间记忆”:规范坐标的妙用
检索到历史帧后,如何将它们的信息有效传递给生成模型?直接拼接RGB图像?那会把扭曲伪影也带进去。
Lyra 2.0的解法极为巧妙:它传递的是扭曲后的规范坐标映射。对于每个检索到的帧,系统生成一个映射图,其通道包含归一化的2D像素坐标和一个代表帧序号的标识。然后,利用该帧的深度图,将这个坐标映射前向扭曲到目标视角。
为什么是坐标而不是RGB?
因为坐标图只携带几何对应关系(目标视图的某个像素对应历史帧的哪个位置),而不包含任何外观信息。这相当于给生成模型一张“寻址地图”,告诉它:“你要画的这个角落,可以参考记忆库中A照片的左上角区域。”至于那个区域具体长什么样、颜色如何,则由模型强大的生成先验来负责合成和修正。这就完美实现了几何导航,像素创作的解耦。
💡 核心创新点二:“防漂移”的自增强训练
解决了“遗忘”,还要解决“跑偏”。漂移的根源在于训练-推理差异:训练时模型以完美的真实历史帧为条件,推理时却不得不以自己上一步不完美的输出为条件。
Lyra 2.0引入了轻量级的自增强训练。在训练过程中,以一定概率(70%)对作为条件的历史帧潜在特征添加噪声,并让模型执行单步去噪,得到一个带有典型生成伪影的“受损”条件。然后,模型需要基于这个受损的条件,去预测一个干净的目标帧。
这就好比在训练飞行员时,不仅让他在晴空万里中飞行,还特意让他练习在仪表故障、视野受限的恶劣条件下安全降落。当模型在推理中真的遇到自己上一步生成的“不完美天气”时,它早已训练有素,知道如何纠正偏差,而不是让错误滚雪球。
这个设计成本极低(仅需一次额外前向传播),效果却非常显著,从根源上抑制了长序列中的质量退化。
🏆 实验验证:数据说话,全面碾压
理论再美,也需要数据支撑。Lyra 2.0在多个标准数据集和任务上进行了全面测试,结果令人信服。
长视频生成:告别失真与漂移
首先看单图生成长视频的任务。下表是与多个SOTA方法的对比,指标包括衡量相似度的SSIM、感知差异的LPIPS、图像质量的FID,以及专门评估长视频的人类主观质量、风格一致性和相机控制精度。
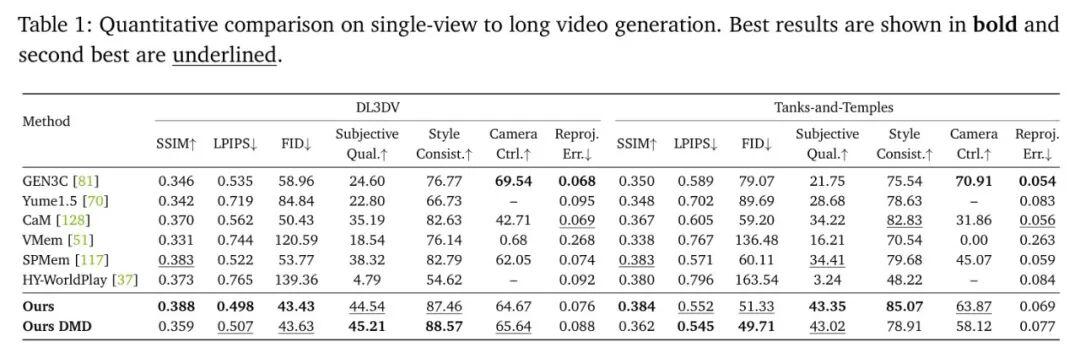
数据解读:
- • 全面领先:在两个数据集上,Lyra 2.0在SSIM、LPIPS、FID、主观质量、风格一致性等核心质量指标上基本都取得了最佳或次佳成绩。
- • 兼顾控制与质量:像GEN3C这类依赖强几何约束的方法,相机控制精度(Camera Ctrl.)高,但牺牲了生成质量(SSIM、主观质量低)。而像CaM这类依赖记忆的方法,质量尚可但控制精度差。Lyra 2.0是唯一能在高视觉保真度和精确相机控制之间取得卓越平衡的方法。
- • 蒸馏版本高效:其4步蒸馏模型(Ours DMD)在质量指标上与35步完整模型相当,但推理速度快了13倍,为交互式应用铺平道路。
视觉对比更是一目了然:
3D场景生成:从视频到可探索世界
生成长视频不是终点,将其重建为高质量的3D场景(如3D高斯溅射)才能用于VR、仿真等下游任务。Lyra 2.0生成的3D一致视频,为后续重建提供了完美素材。
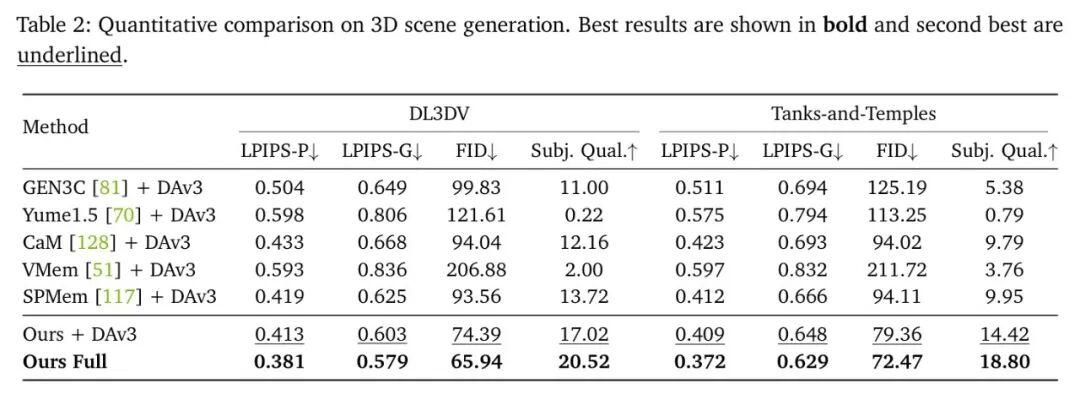
关键洞察:表格中LPIPS-P指标衡量的是3D重建结果与生成视频之间的差异。Lyra 2.0的LPIPS-P值最低,这说明它生成的视频本身3D一致性就极高,因此重建出的3D模型与生成视频的视角几乎无差别。其他方法生成的视频本身就不一致,重建时自然漏洞百出。
视觉上,这种优势转化为更干净、更完整的3D场景:
🔬 消融实验:每个模块都不可或缺
一项技术的可靠性,体现在其每个组件的贡献都经得起检验。Lyra 2.0的消融研究深刻揭示了其设计的内在逻辑。
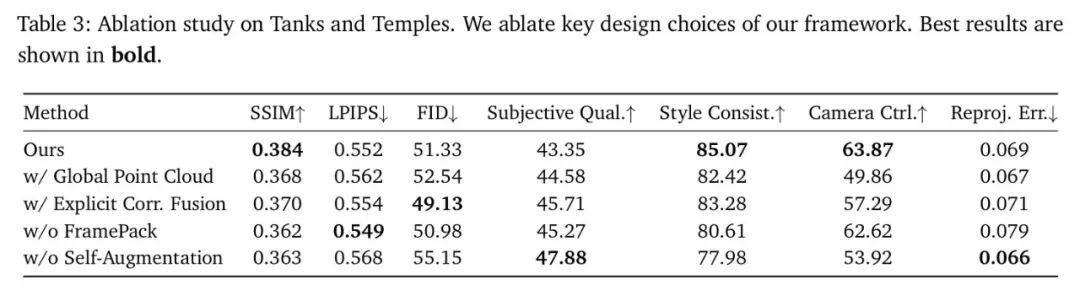
结合定性与定量结果,我们能看到:
- 全局点云 vs 逐帧缓存:用全局融合点云代替逐帧缓存(w/ Global Point Cloud),会导致相机控制精度和风格一致性大幅下降。因为错误的深度估计在全局图中被固化并放大,污染了所有后续条件。
- 学习聚合 vs 硬融合:用硬几何融合代替学习的MLP来聚合多帧对应关系(w/ Explicit Corr. Fusion),相机控制精度下降。这说明学习机制能更好地处理噪声深度估计带来的不确定性。
- FramePack的重要性:移除FramePack模块(w/o FramePack),风格一致性暴跌,重投影误差上升。没有长时间上下文的锚定,模型无法抵抗漂移。
- 自增强的魔力:移除自增强训练(w/o Self-Augmentation),虽然单帧主观质量略有提升(因为训练条件更“干净”),但长程一致性指标(风格一致性、相机控制)崩溃式下降。这完美印证了自增强对于解决训练-推理差异、防止误差累积的核心价值。
🚀 从论文到应用:落地才是硬道理
技术的终极价值在于应用。Lyra 2.0不仅是一篇论文,更是一套即插即用的3D世界创作工具链。
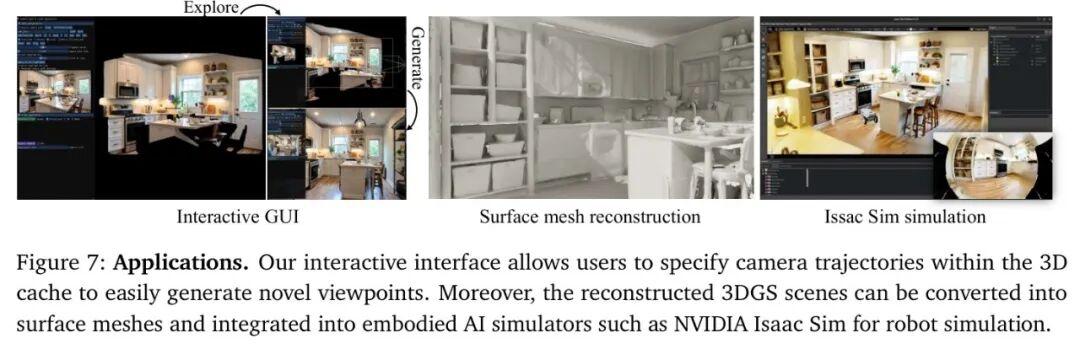
交互式探索:用户可以通过GUI实时指定相机轨迹,系统逐步生成并扩展场景,真正实现了“所见即所得”的3D世界构建。
仿真就绪:生成的3D高斯和表面网格可直接导入主流的物理仿真引擎(如Isaac Sim),用于训练机器人导航、交互,为具身智能提供了海量、高质量的合成训练环境。
强大的泛化能力:
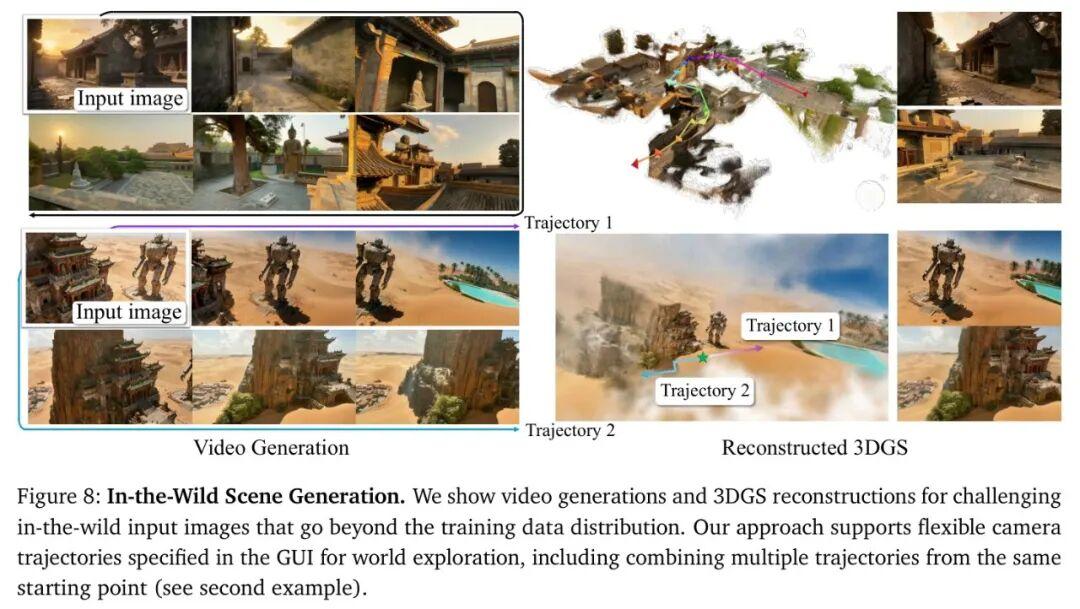
无论是古建筑还是现代室内,Lyra 2.0都能保持高水平的生成一致性和重建质量。
⚖️ 客观评价与展望
当然,Lyra 2.0并非完美。论文诚实地指出了其局限:目前主要针对静态环境,尚未显式建模动态物体(如行走的人、行驶的车)。此外,其训练数据(DL3DV)中的曝光变化有时会被模型学习并复制,可能导致重建场景的光度不一致。
但它的框架是开创性的。它清晰地指出了一条通往可扩展、高质量3D内容生成的路径:解耦几何与外观,用稳健的几何代理引导强大的生成先验。
未来的工作可以沿着多个方向展开:引入动态场景建模、融合更鲁棒的光度一致性约束,甚至将该框架与文本、语音等更丰富的模态相结合,实现真正“一句话生成一个世界”的终极梦想。
🌟 价值升华
总结来说,Lyra 2.0给我们带来的核心启示有三点:
- 分工明确胜于大包大揽:让3D几何做它擅长的导航和索引,让扩散模型做它擅长的创作和合成,通过规范坐标等巧妙的接口设计实现二者高效协作。
- 对抗缺陷要从训练源头入手:自增强训练以极低的成本,从根本上缓解了自回归生成中的误差累积问题,是提升长程一致性的治本之策。
- 生成与重建必须闭环优化:不仅追求生成的视觉质量,更要以生成结果能被高质量重建为目标来设计整个系统,LPIPS-P这样的指标为我们指明了方向。
这项技术最让你兴奋的应用场景是什么?是快速构建游戏开放世界?是为机器人创建无限多样的训练环境?还是让每个人都能轻松打造自己的数字孪生空间?
欢迎在评论区分享你的洞见!
如果这篇近5000字的深度解读让你对3D生成的前沿有了新的认识,请点赞、在看支持原创技术分享,并转发给更多可能需要的朋友。
#AI技术 #3D生成 #深度学习 #计算机视觉 #论文解读 #AIGC
参考
Lyra-2.0