Qwen3.5-Omni 报告解读|彻底诠释全模态模型应该如何一步步修炼?
想象一下,你正在和智能助手语音对话,讨论一个长达10小时的会议录音。你希望它能实时转录、即时总结,并用自然的语音回应你的追问。但现实是:延迟让你焦躁,机械的合成音让你出戏,复杂的多语言场景更是让它频频出错。
这不是科幻,而是我们与多模态AI交互时每天都在经历的困境。
现在,一个名为Qwen3.5-Omni的模型,声称要终结这一切。它不仅号称能统一处理文本、图像、音频和视频,更承诺带来类人的实时交互体验和前所未有的多语言覆盖。但最核心的问题是:它如何在保持顶尖理解能力的同时,实现如此低延迟、高质量的语音生成?背后那个名为 ARIA 的神秘技术,究竟是何方神圣?
读完本文,你将彻底弄懂这个可能是目前最全能的多模态大模型的内部构造,掌握其实现“听、说、看、想”无缝协同的核心密码。
❓ 核心痛点:多模态AI的“木桶效应”
当前的多模态模型,往往存在明显的“木桶效应”。视觉模型可能很强,但一处理音频就“耳聋”;语音模型或许流畅,但面对图像就“失明”。更致命的是,将不同模态的能力生硬拼接,会导致交互延迟飙升、体验割裂。
我们梦想中的AI助手,应该像人类一样:能边看视频边听解说,并即时用自然的语音和你讨论剧情。这要求模型必须具备:
- 超低延迟的流式处理:语音交互中,几百毫秒的延迟就足以破坏沉浸感。
- 高质量的语音合成:声音不仅要清晰,更要有人情味,能传达情感和韵律。
- 真正的多模态统一理解:不是简单拼接视觉和听觉特征,而是在一个统一的“大脑”里融合处理。
- 广泛的语言包容性:不仅要支持主流语言,还得能听懂各地的方言。
过去,没有一个模型能同时做好这四点。要么为了效率牺牲质量,要么为了质量牺牲实时性。而Qwen3.5-Omni的提出,正是为了打破这个僵局。它通过一个名为 Thinker-Talker 的“双脑”架构,试图从根本上重塑多模态交互的范式。
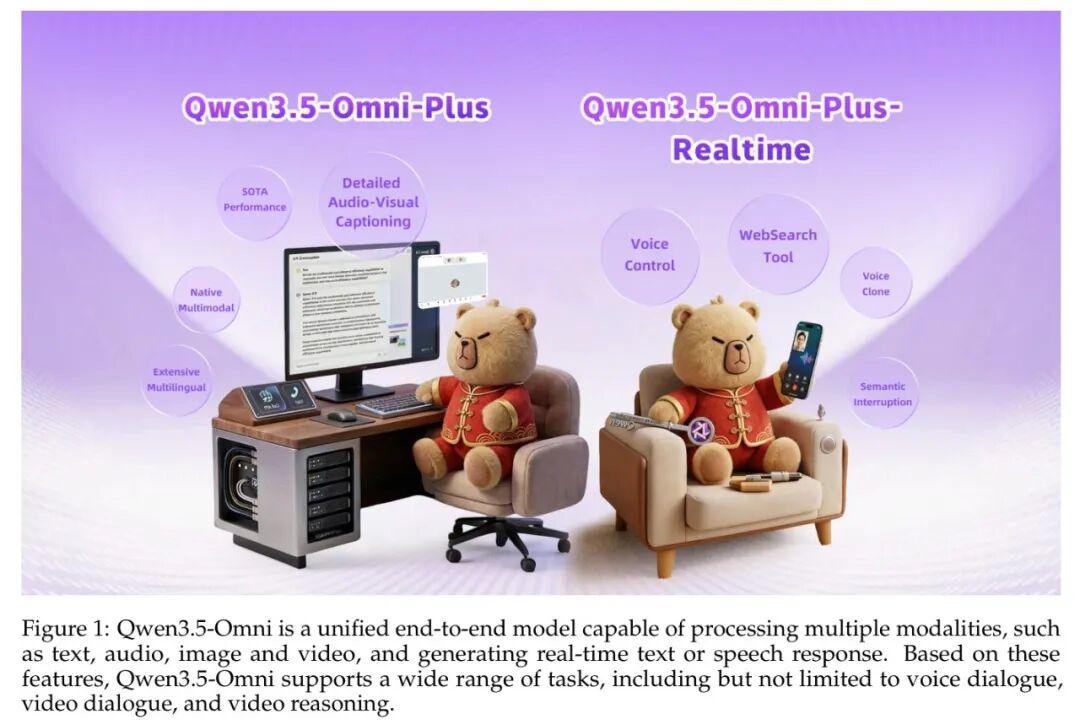
从图中我们可以直观感受到它的野心:一端追求极致的SOTA性能(左侧熊),另一端追求丝滑的实时交互(右侧熊)。但将这两个看似矛盾的目标统一在一个模型里,技术上是如何实现的?
🚀 原理拆解:“双脑”协同与ARIA对齐魔法
理解Qwen3.5-Omni,关键在于它的“双脑”设计:Thinker(思考者)负责理解与规划,Talker(对话者)负责语音生成。这个设计精妙地解耦了复杂的认知任务和耗时的声学建模。
🏗️ 整体架构:Thinker-Talker的精密协作
我们先通过整体架构图,一览其全貌。
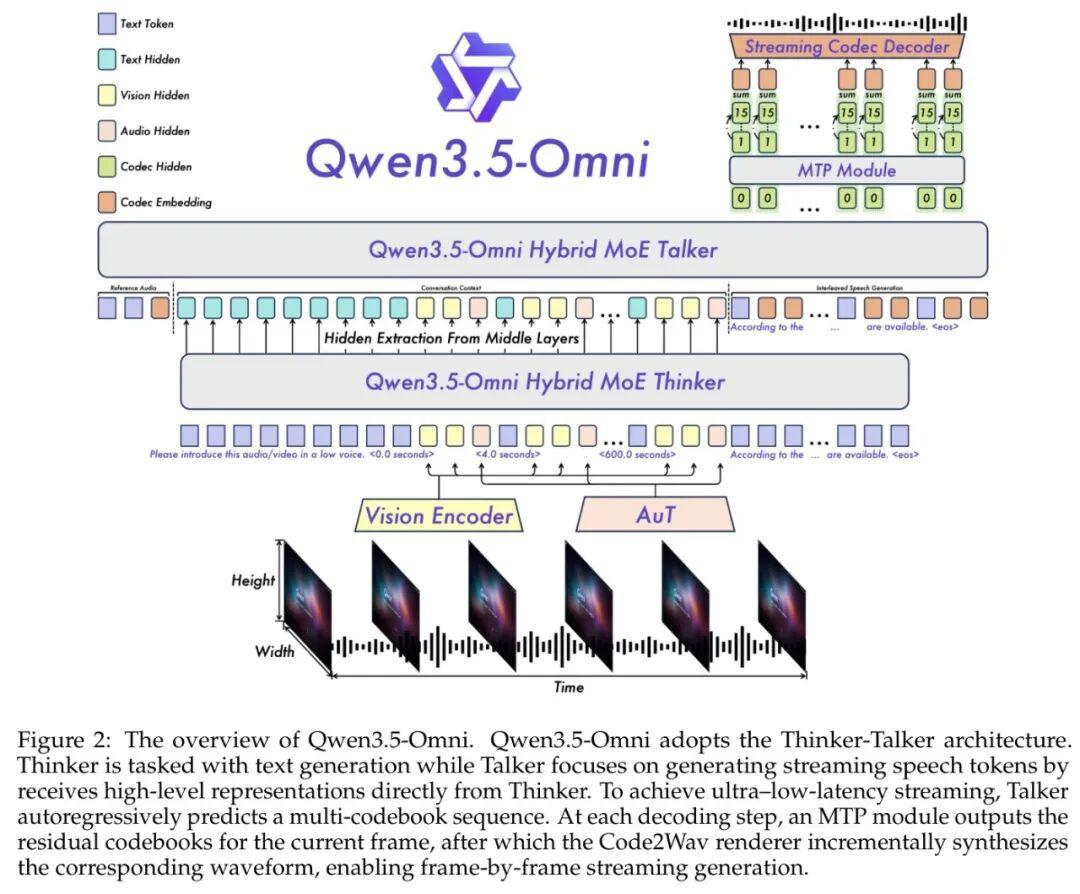
如图所示,信息流是这样的:
- 输入与编码:文本、图像/视频、音频分别通过分词器、视觉编码器和音频编码器(AuT) 转化为统一的特征表示。注意底部的 AuT 和 Vision Encoder,它们是模型感知世界的“耳朵”和“眼睛”。
- Thinker(思考):所有模态的特征被交织在一起,送入Thinker模块。这是一个基于混合MoE(混合专家) 的Transformer,负责进行深度的多模态理解、推理和规划,并生成文本形式的“思考结果”。
- Talker(说话):Thinker的输出(文本)被传递给Talker。Talker的核心任务是自回归地预测多码本语音序列。它利用一个MTP模块预测残差码本,再通过Streaming Codec Decoder 将码本序列实时解码为波形。
这个流程听起来清晰,但魔鬼藏在细节里。Thinker如何保证长音频/视频的理解效率?Talker又如何解决文本与语音单元不匹配导致的合成不自然问题? 我们深入两个核心模块。
💡 音频之耳:AuT编码器的深度设计
音频理解是多模态的基石。Qwen3.5-Omni没有使用现成的语音识别系统,而是从头训练了一个强大的音频到文本编码器(AuT)。
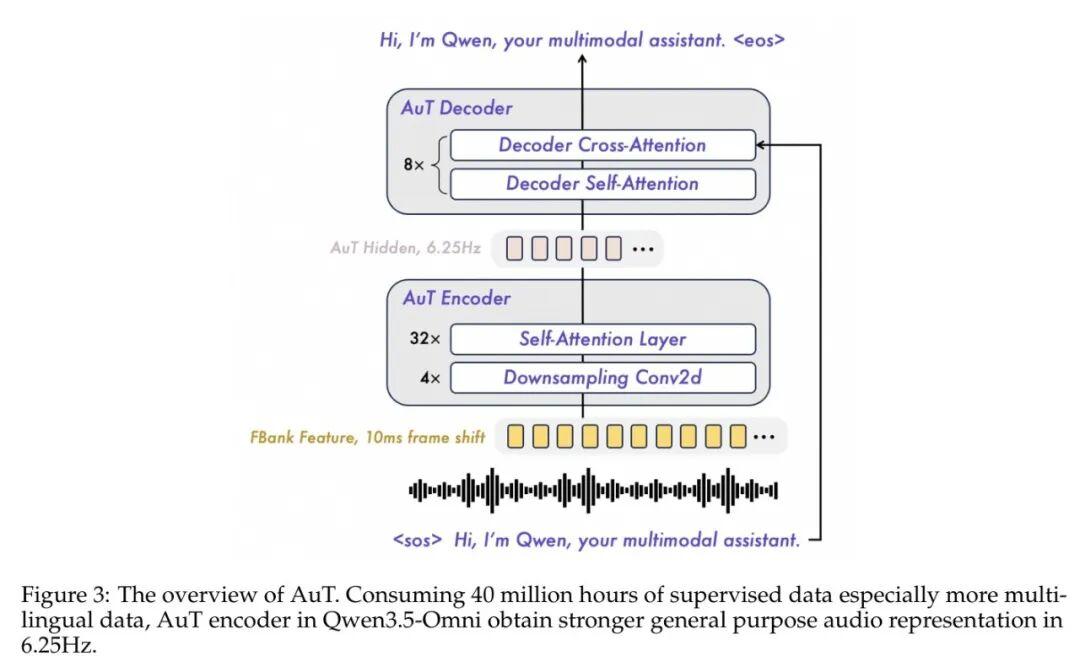
AuT是一个标准的编码器-解码器架构,但其设计充满巧思:
- • 高效下采样:输入音频经FBank特征提取后,通过4层卷积进行16倍下采样,将序列长度大幅压缩,减轻了后续Transformer的计算负担。
- • 深层编码:编码器包含32层自注意力层,对压缩后的音频特征进行深层语义理解。
- • 交叉注意力解码:解码器包含8层,每层通过交叉注意力机制对齐编码器的音频特征,从而生成准确的文本。
关键指标:AuT的输出频率是6.25Hz,意味着每秒钟的音频被编码成约6个特征向量。这个速率在信息密度和计算效率之间取得了良好平衡。更重要的是,它在4000万小时的多语言音频数据上训练,为模型提供了强大的“听力”基础。
💡 语音之口:ARIA技术的革命性突破
Talker模块最引人注目的创新是 ARIA(自适应速率交错对齐) 。要理解它的价值,得先看传统方法的痛点。
在流式语音合成中,模型需要一边生成文本,一边生成对应的语音单元(Codec Token)。但问题是,文本的编码效率(Token/秒)和语音的编码效率(Token/秒)是不同的,且在不同语言中差异巨大。强行按固定比例交错文本和语音Token,会导致对齐错乱,产生漏词、发音错误或韵律怪异。
ARIA的解决方案极其聪明:它放弃了固定的对齐模板,转而采用一种自适应约束。简单来说,它的规则是:在生成的任何前缀部分,累积的语音Token数量与文本Token数量的比值,不能超过该句话整体的全局比值。
这就好比两个人协同走路,ARIA不规定“你一步我必须跟两步”,而是约定“你不能跑得比我快太多,但具体步伐可以灵活调整”。这带来了两大好处:
- 跨语言鲁棒性:无论目标语言的文本-语音压缩率如何,ARIA都能动态适应。
- 流式兼容性:它天然支持在生成部分文本后,紧接着生成连贯的语音,完美契合流式交互场景。
Talker在超过2000万小时的多语言语音数据上预训练,再经过强化学习和说话人微调,最终实现了既自然又可控的高质量语音生成。
⚡ 效率引擎:模块化与流式优化
为了实现低延迟实时交互,Qwen3.5-Omni在架构层面做了大量优化,其模块化设计和支持流式处理的特性一目了然。
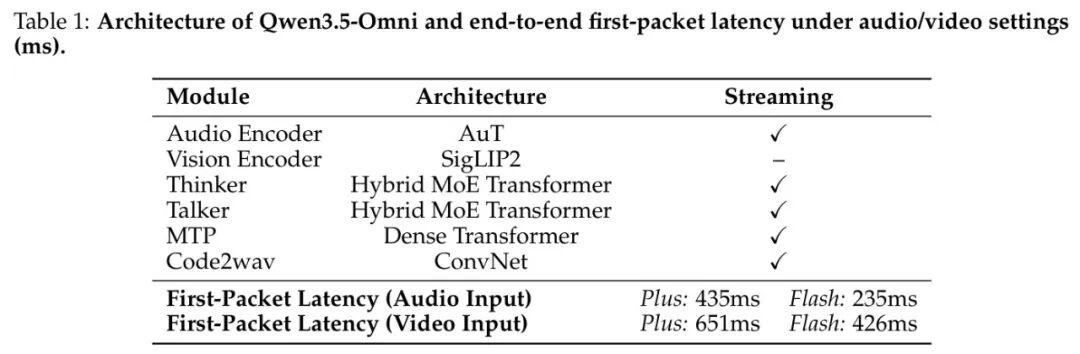
从表1可以清晰看到:
- • 模块化:Audio Encoder、Vision Encoder、Thinker、Talker等核心模块均采用先进架构(如AuT、SigLIP2、Hybrid MoE Transformer)。
- • 流式支持:多数核心模块都支持流式处理,这是低延迟的基石。
- • 延迟对比:专为速度优化的 Flash模式,在音频和视频输入下的首包延迟相比Plus模式降低了约40%-50%,这是一个非常显著的提升。
那么,在高并发请求的压力下,它的表现如何呢?
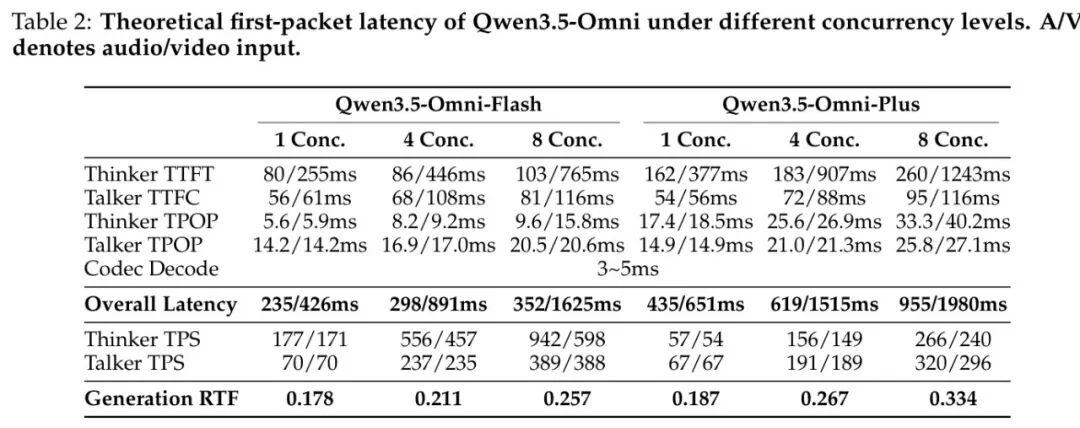
表2揭示了在高并发场景下的系统行为:
- • 延迟随并发上升:这是预期之内,但Flash版本在并发为8时,整体延迟仍远低于Plus版本。
- • 吞吐量优势:Flash版本的Thinker和Talker TPS(每秒处理Token数) 显著更高,意味着单位时间内能服务更多用户。
- • Flash模式的性价比:在追求实时交互的场景,Flash模式以可接受的性能轻微下降,换来了延迟和吞吐量的巨大优势。
💡 实战思考:这种“Plus精度旗舰”与“Flash速度先锋”的双版本策略,非常契合实际产品部署需求,让开发者可以根据场景灵活选择。
📊 实验验证:数据堆里的“全能王”
理论再优美,也需要数据验证。Qwen3.5-Omni在超过215项音频和音视频基准测试中进行了全面评估,结果堪称“暴力”。
🏆 文本与理解能力:根基稳固
首先,作为一个多模态模型,它的纯文本能力是否被削弱了?
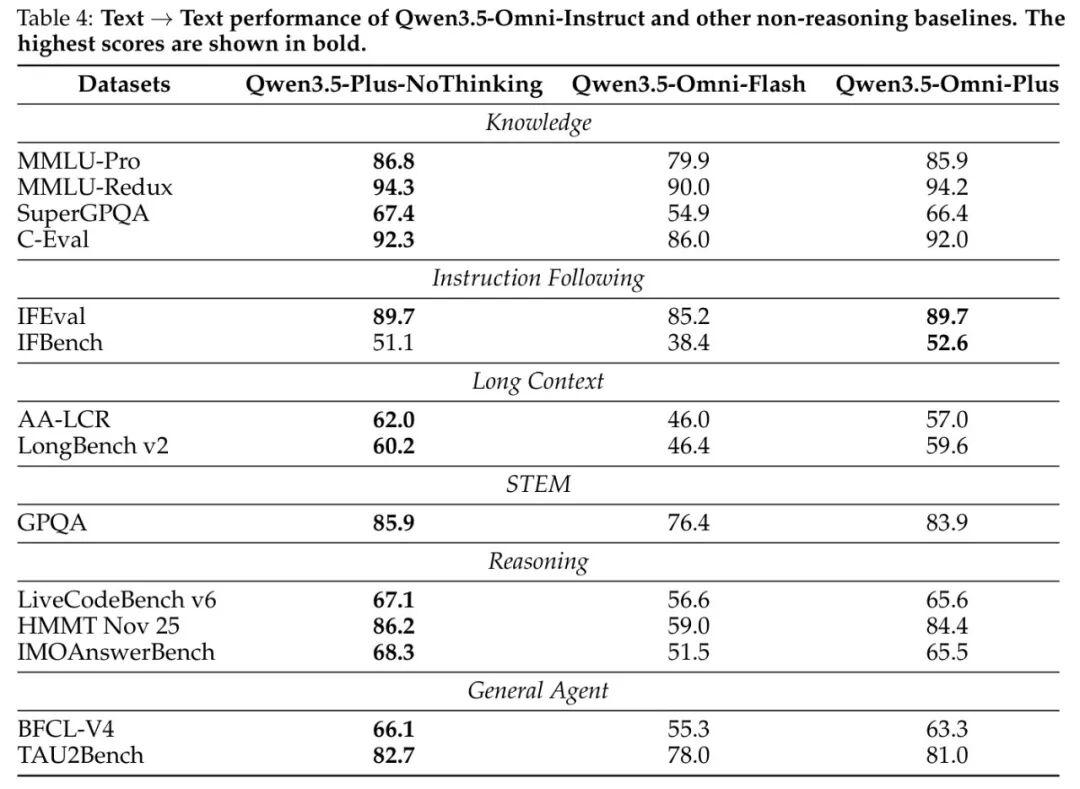
表4给出了答案:Qwen3.5-Omni-Plus的文本能力与其纯文本版本的兄弟模型(Qwen3.5-Plus-NoThinking)旗鼓相当。这说明大规模的多模态训练并没有损害其语言核心,为其他模态的能力提供了坚实的基石。
🏆 音频理解:全面超越Gemini?
音频理解是它的重头戏。与业界最强的通用模型之一Gemini-3.1 Pro正面交锋,结果如何?
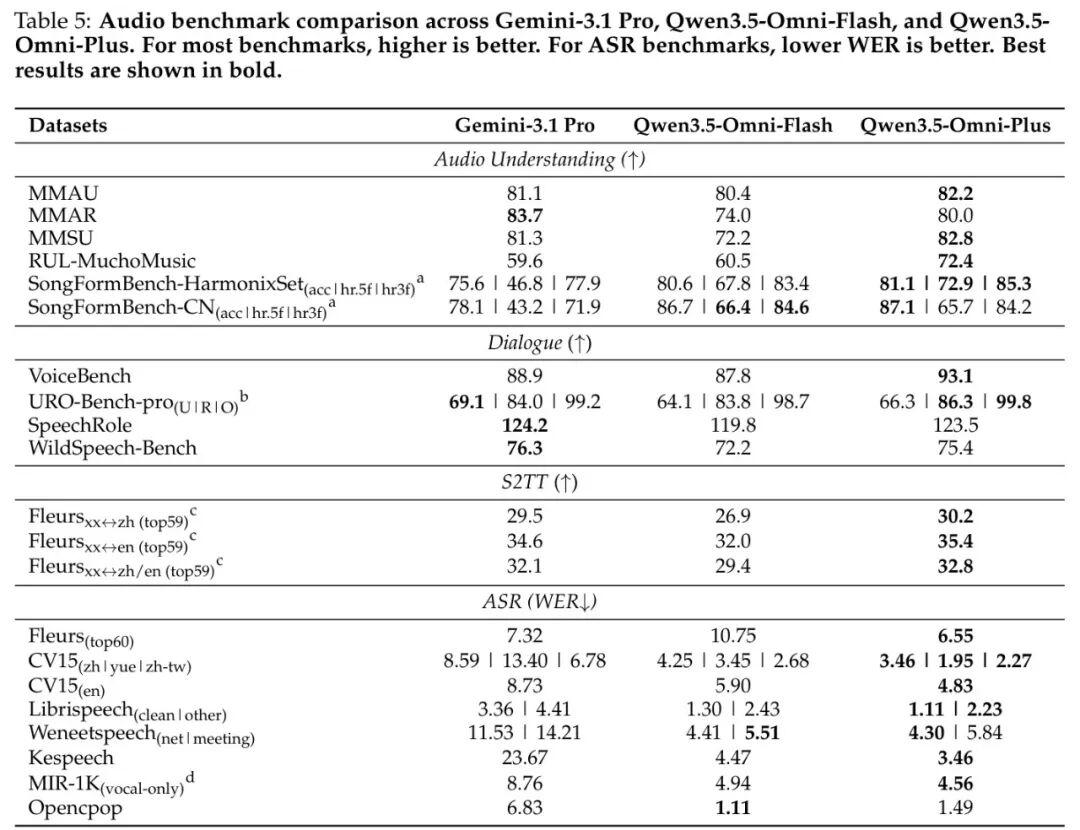
表5的结果令人印象深刻:
- • 音频理解(MMAU等):在多个数据集上优于或持平Gemini-3.1 Pro。
- • 语音对话(VoiceBench):在端到端语音对话基准上显著领先。
- • 语音识别与翻译(ASR/S2TT):在词错误率(WER)上全面占优。
这组数据清晰地表明,Qwen3.5-Omni在通用音频处理能力上,已经建立了全面的竞争优势。
🏆 视觉与音视频理解:多模态融合的实力
视觉和音视频理解是检验其多模态融合能力的关键。
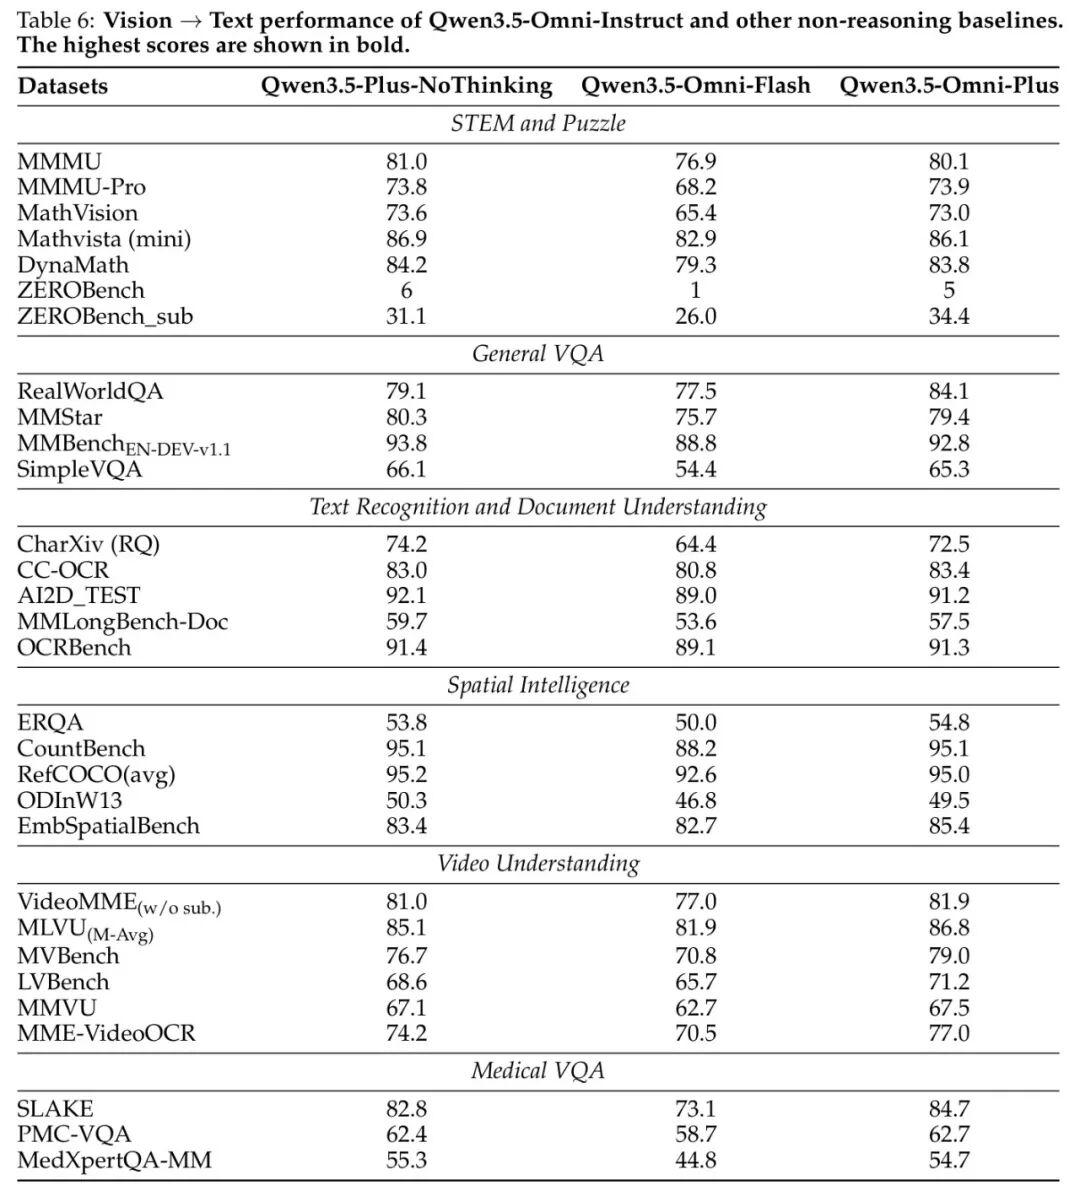
表6显示,其视觉理解能力与纯视觉模型版本相当,并在部分视频理解任务上更优,证明了音视频联合训练带来了增益而非干扰。
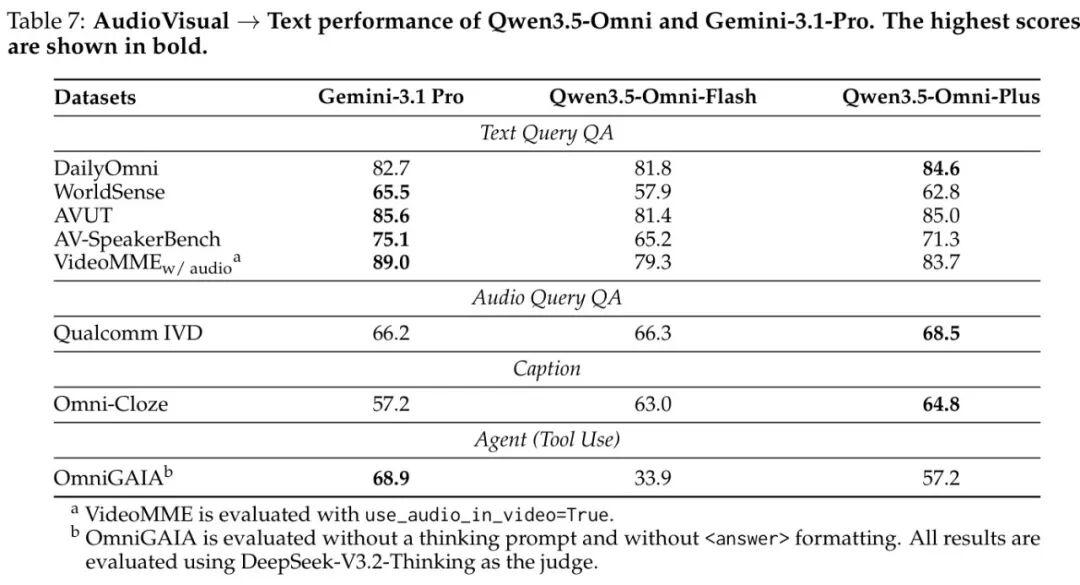
表7则聚焦于更复杂的音视频理解任务。可以看到,在DailyOmni、Qualcomm IVD(真实世界交互)等基准上,Qwen3.5-Omni-Plus取得了领先或显著领先的优势。这证明其统一的架构在处理交织的视听信息时,确实发挥了“1+1>2”的效果。
🏆 语音生成:从零样本到多语言的统治力
语音生成是Talker模块的“才艺展示”。评估主要看两个方面:内容准确性和说话人相似度。
零样本语音生成:在SEED-TTS基准上,衡量合成语音与目标文本的内容一致性(WER越低越好)。
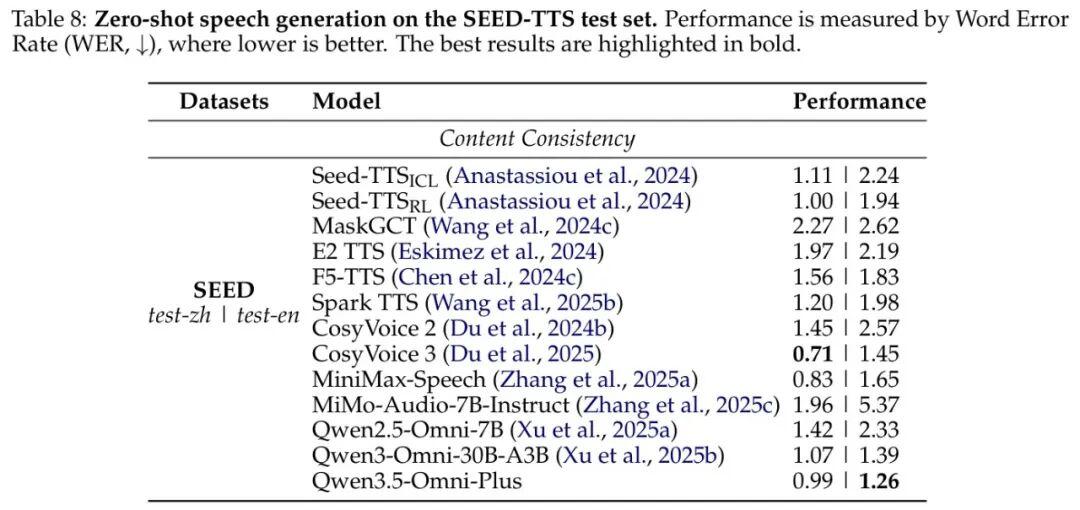
如表8所示,Qwen3.5-Omni-Plus在中文和英文测试集上均取得了最低的词错误率(0.99和1.26),击败了包括CosyVoice、MiniMax-Speech在内的众多专业TTS模型,展现了其零样本语音生成的强大实力。
多语言语音生成:在19种语言上,同时评估内容一致性(WER)和说话人相似度(SIM)。
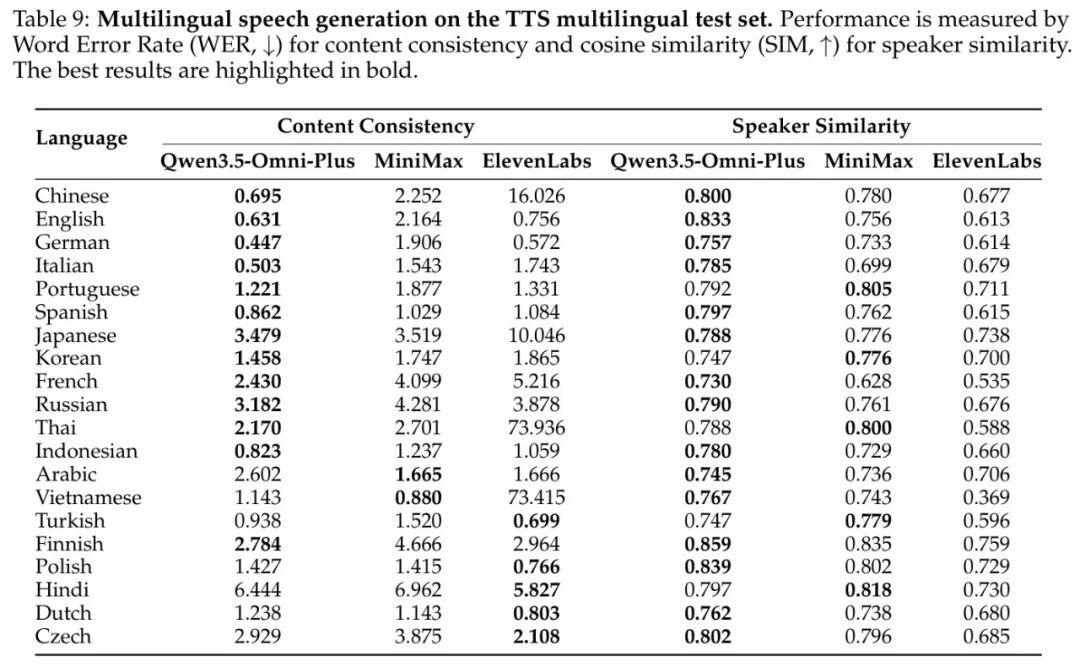
表9的结果更具冲击力。在对比MiniMax和ElevenLabs两个商业系统时,Qwen3.5-Omni-Plus在绝大多数语言的WER上表现最优,同时在说话人相似度上也保持领先。这意味着它不仅能准确地说多国语言,还能很好地模仿目标音色。
🏆 语言覆盖:真正的“地球村”模型
技术的最终目标是普惠。Qwen3.5-Omni在语言支持上的广度,定义了“多语言”的新标准。
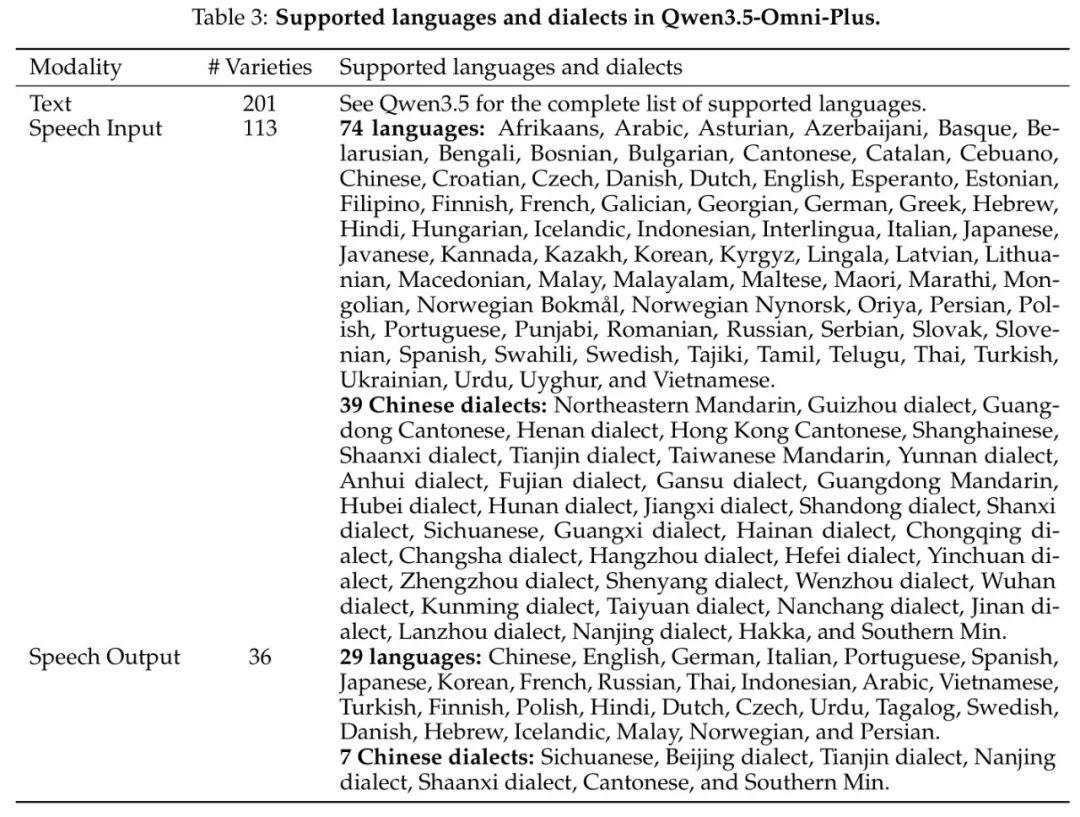
表3的数据令人惊叹:
- • 文本:支持201种语言变体。
- • 语音输入:支持113种(含74种语言和39种中文方言)。
- • 语音输出:支持36种(含29种语言和7种中文方言)。
这不仅覆盖了全球主要语言,更深入到了中文的众多方言(如粤语、闽南语等),对于打破数字世界的语言障碍具有重大意义。其多语言语音识别和翻译能力也在基准测试中得到了验证。
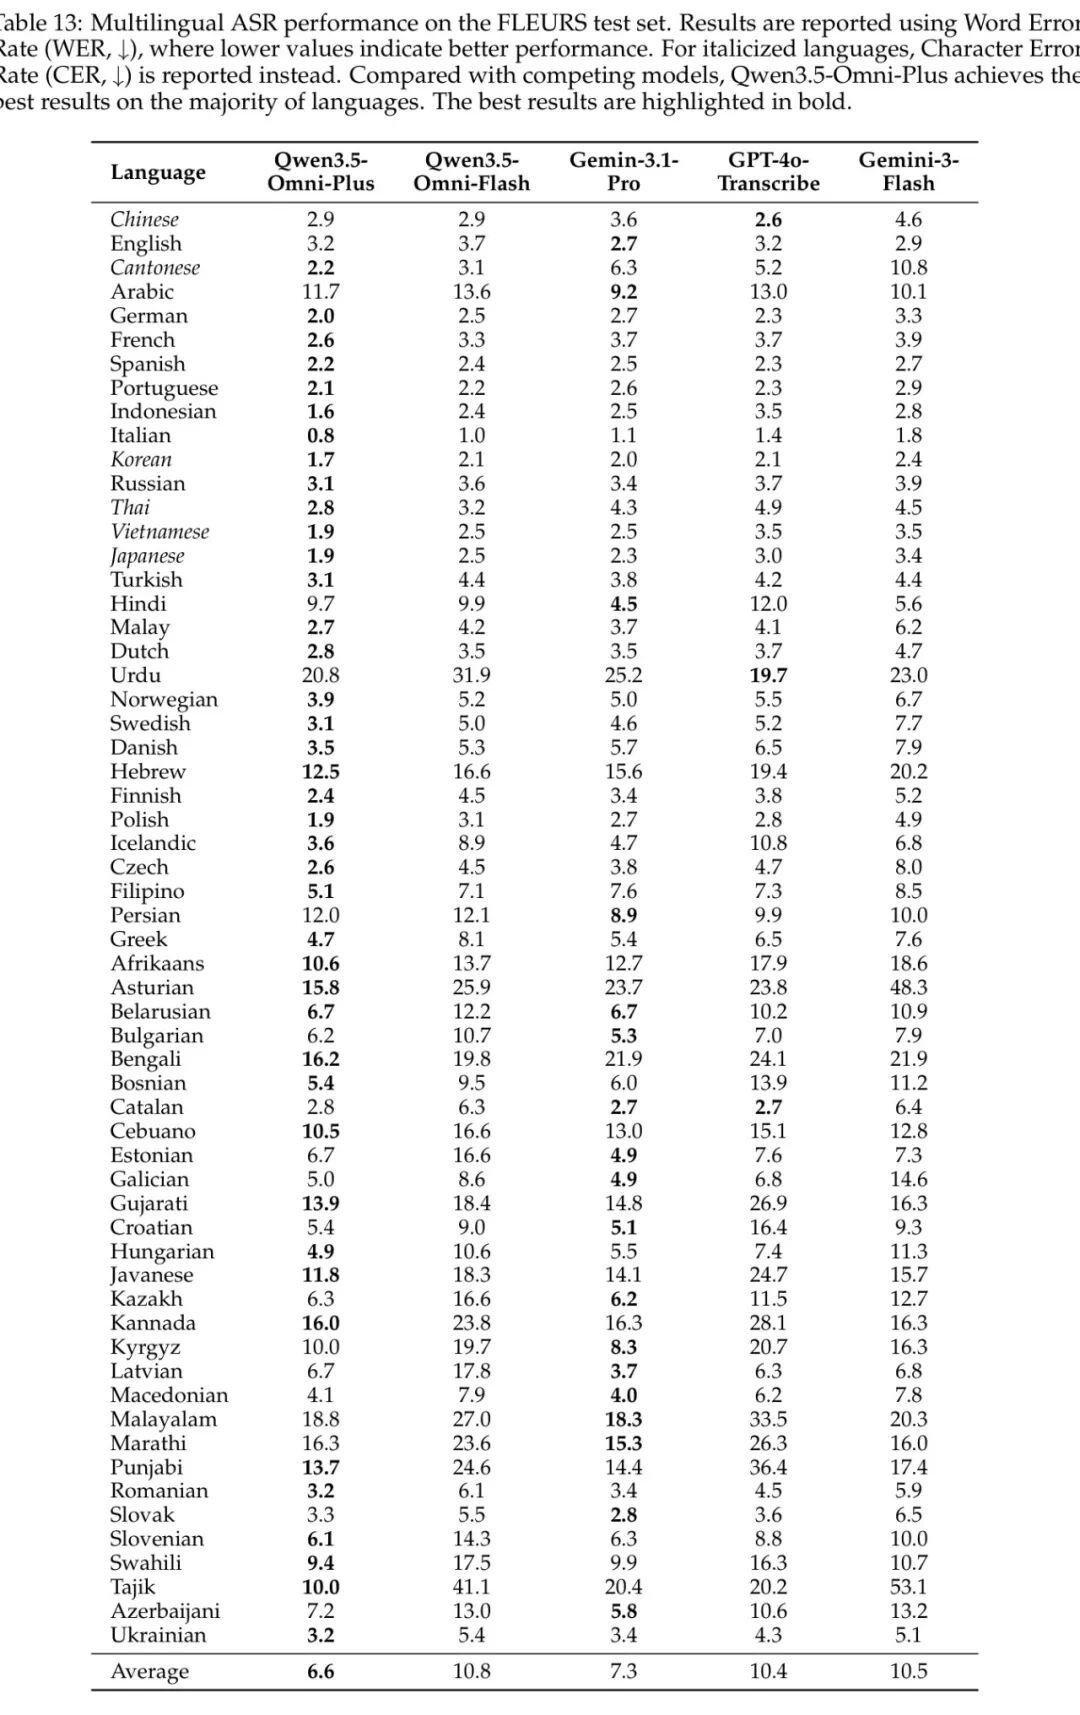
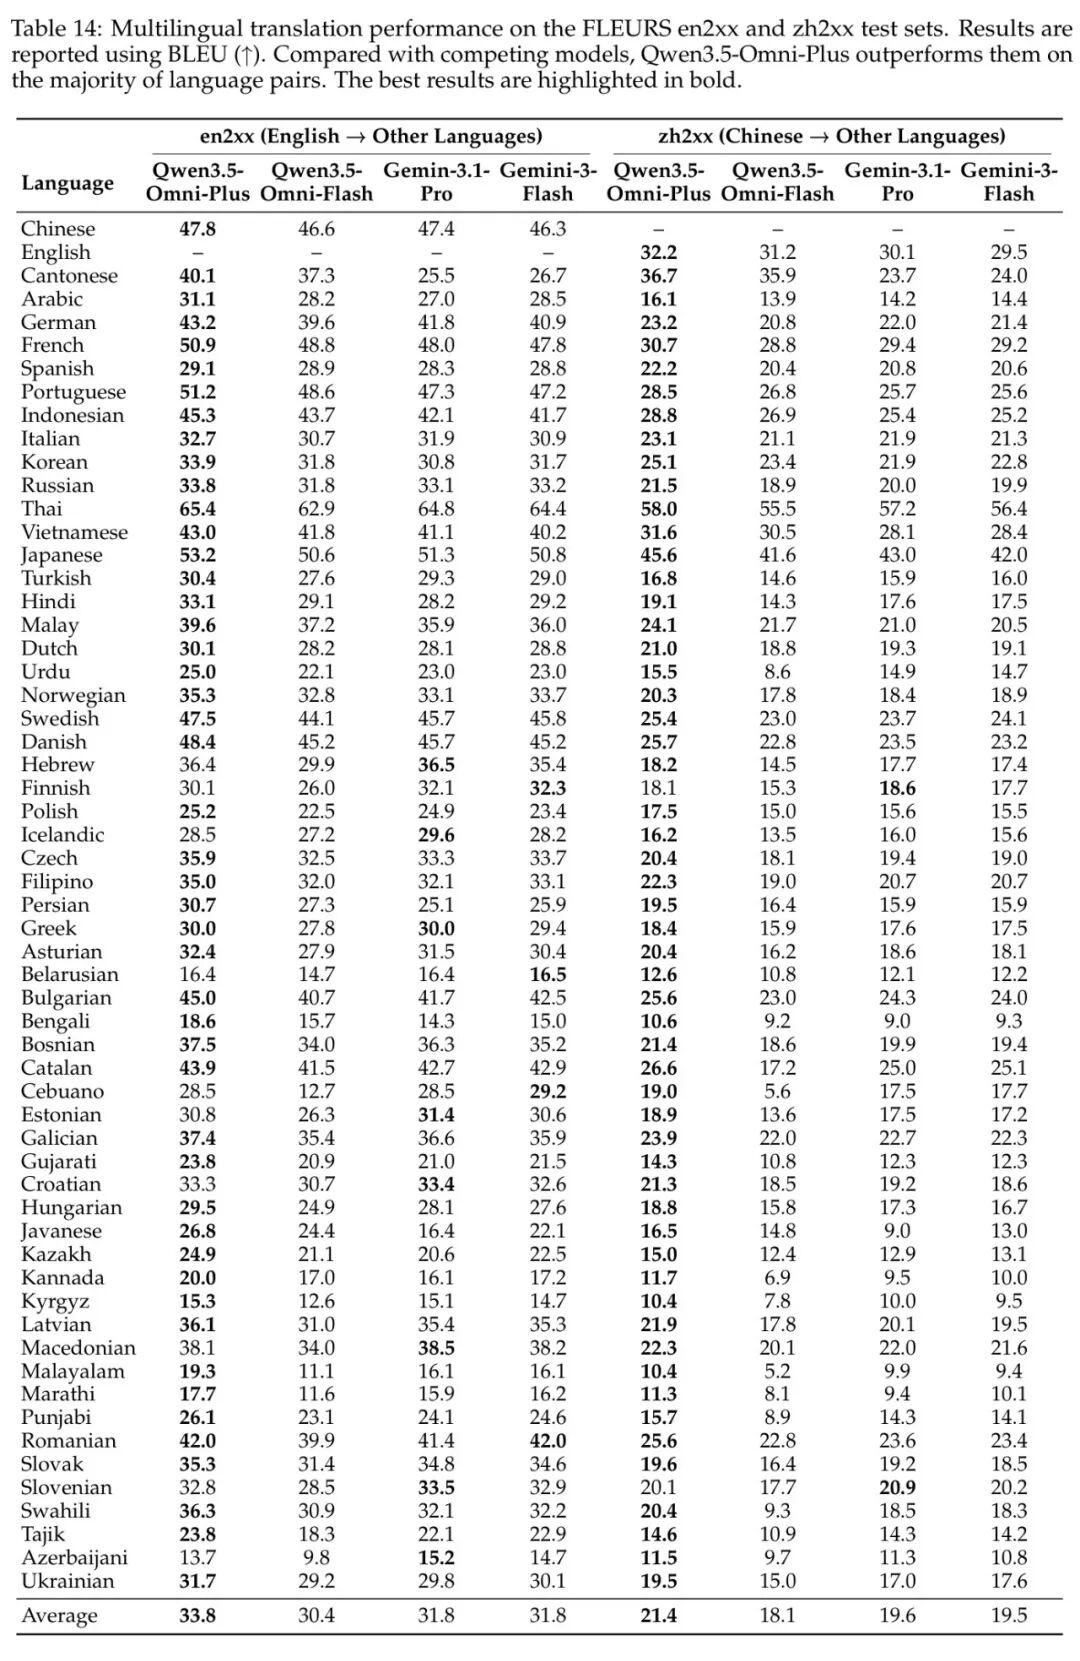
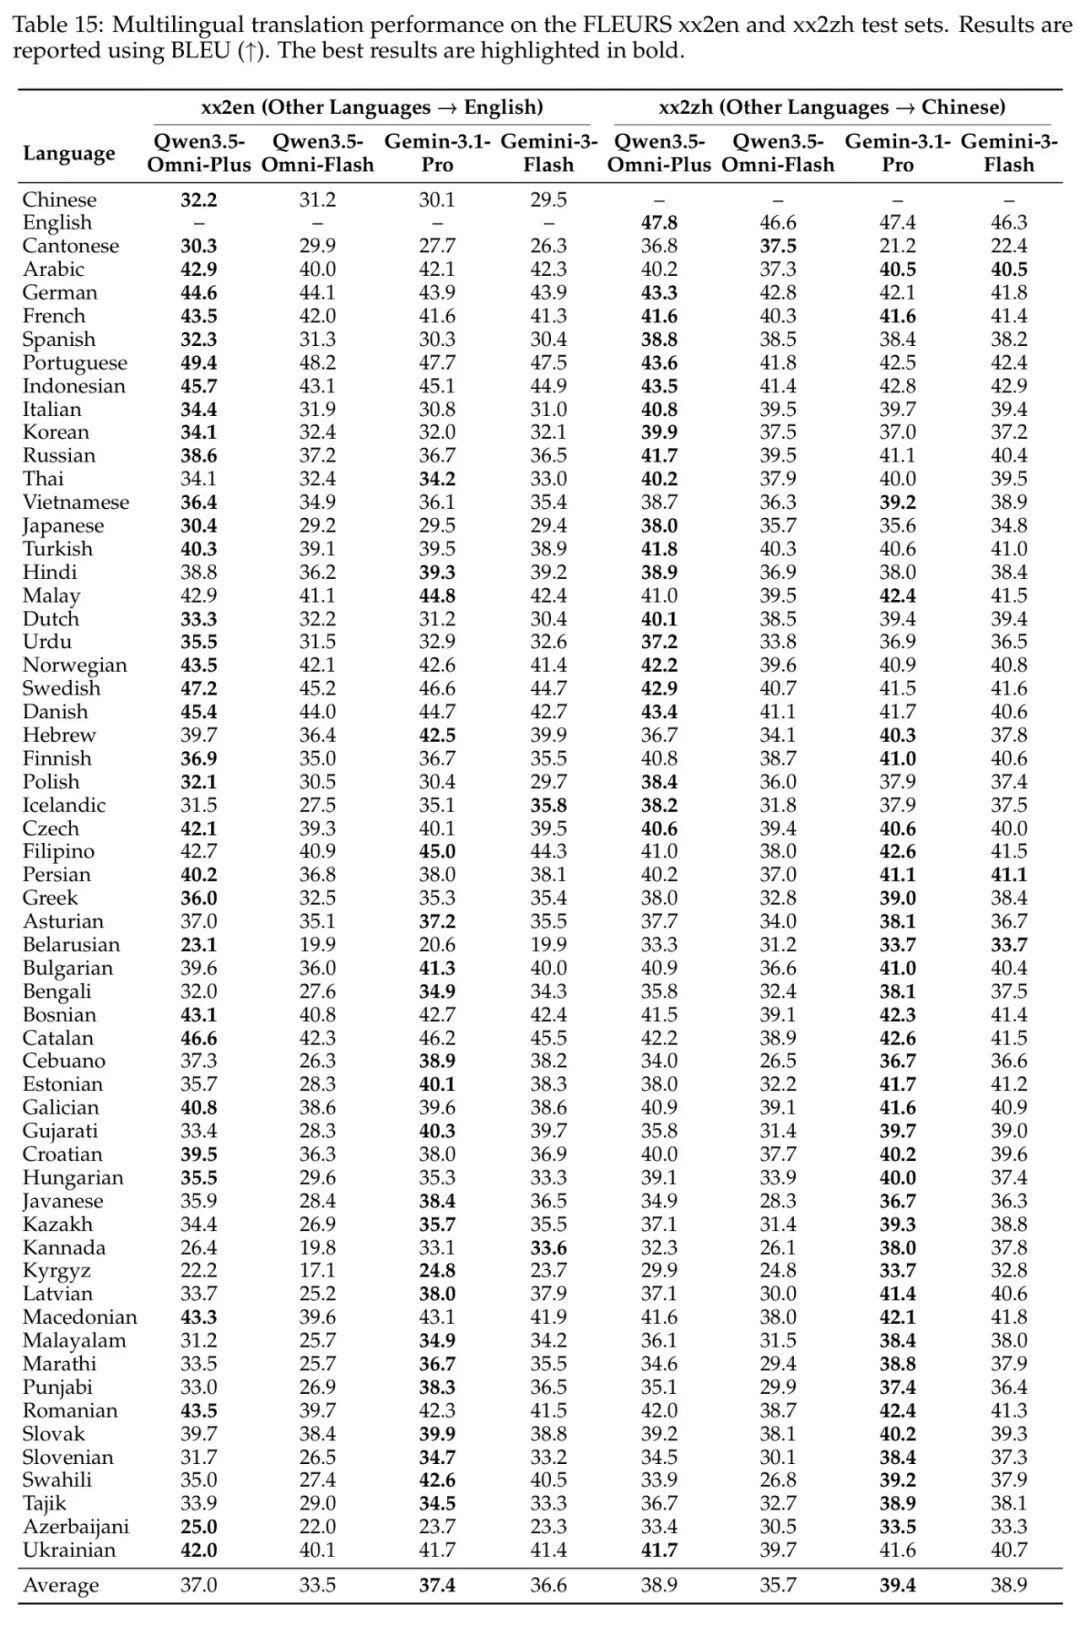
表13、14、15综合表明,Qwen3.5-Omni-Plus在多语言ASR和翻译任务上,整体表现优于Gemini-3.1 Pro,尤其在粤语、韩语、日语等关键亚洲语言上优势明显。例如,在粤语ASR上,其词错误率(2.2%)远低于Gemini-3.1 Pro(6.3%)。
⚖️ 客观评价与未来展望
毫无疑问,Qwen3.5-Omni展现了一套令人印象深刻的全模态能力体系。但站在技术批判的角度,我们仍需冷静看待:
- • 计算开销:虽然Flash模式优化了延迟,但一个支持256k上下文、千亿参数级别的混合MoE模型,其推理成本依然不容小觑。这对于大规模商业化部署是一个现实的挑战。
- • 能力边界:尽管在多模态理解上表现优异,但在需要深度数值推理、复杂逻辑规划的“硬推理”任务上,它可能仍与顶尖纯文本模型有差距。多模态模型的“通才”路线与“专才”模型之间的权衡,是一个长期议题。
- • 数据依赖:其卓越性能建立在4000万小时音频、超万亿Token多模态数据的预训练基础上。数据规模和质量仍然是决定模型高度的关键因素。
然而,它的出现清晰地指明了一个方向:原生、统一的多模态架构是可行的,并且能催生出像“视听氛围编码”这样的涌现能力。Thinker-Talker架构与ARIA技术,为后续研究提供了宝贵的范式参考。
🌟 价值总结与行动号召
回顾全文,Qwen3.5-Omni带来的核心启示有三点:
- 架构创新是根本:“Thinker-Talker”双脑设计,从系统层面解决了理解与生成的耦合难题,ARIA技术更是攻克了流式语音合成的关键对齐痛点。
- 规模与质量并重:在万小时级多模态数据上的原生训练,使其在音频理解、多语言支持上建立了显著优势,同时保持了文本、视觉能力的顶尖水平。
- 实用性导向:提供Plus/Flash双版本,并极致优化流式延迟,表明其设计始终围绕真实交互场景展开。
这项技术最可能率先颠覆哪些领域?是实时多语言会议助手、沉浸式交互娱乐,还是无障碍沟通工具?欢迎在评论区留下你的洞察与想象!
如果这篇近5000字的深度拆解,帮你洞悉了下一代多模态AI的核心技术脉络,请点赞+在看支持我们的原创深度解读。分享给你身边对AI技术感兴趣的朋友,一起探讨未来。
关注我们,第一时间获取最硬核的AI技术前沿解读。
#AI技术 #多模态大模型 #语音合成 #Qwen #实时交互 #论文解读
参考
Qwen3.5-Omni Technical Report