PolyBench:首个大规模LLM实时市场预测和交易能力测评基准
“PolyBench: Benchmarking LLM Forecasting and Trading Capabilities on Live Prediction Market Data”
预测未来是科学挑战,机器学习虽有相关方法,但开放域预测未解决,实现大规模预测对AI意义重大。
本文提出PolyBench,含38,666个二元预测市场的多模态基准。同时提出多维评估框架,评估7个大语言模型的预测准确性和交易可行性。结果显示7个模型表现差异大,仅2个获正收益,强语言模型不保证在实盘盈利。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
从实时市场信号预测现实事件需融合定性新闻与定量订单簿动态,现有基准未解决此挑战。本文推出多模态基准 PolyBench,源于 Polymarket,记录 38,666 个二元预测市场、4,997 个事件的时间点截面,同步耦合订单簿状态与实时新闻流。
用 PolyBench 评估 7 个先进大语言模型,在 2026 年 2 月 6 - 12 日相同时间戳锁定的市场状态下生成 36,165 个预测,通过模拟订单簿执行评估多项指标。实验结果表明,7 个模型表现差异大,仅 MiMo - V2 - Flash(CWR 17.6%)和 Gemini3 - Flash(CWR 6.2%)获正财务回报,其余 5 个虽信心高但亏损。
本研究凸显语言流畅与真实概率推理间差距,确立 PolyBench 为未来大语言模型研究无污染、基于金融的评估标准。
简介
预测未来是科学挑战,机器学习虽有相关方法,但开放域预测未解决,实现大规模预测对AI意义重大。大语言模型是开放域预测的候选者,虽有进展,但能否用多模态数据在去中心化预测市场准确预测和交易仍待解答。去中心化预测市场是严格评估环境,现有基准有不足。
本文提出PolyBench,含38,666个二元预测市场的多模态基准。同时提出多维评估框架,评估7个大语言模型的预测准确性和交易可行性。结果显示7个模型表现差异大,仅2个获正收益,强语言模型不保证在实盘盈利。
相关工作
部署大语言模型(LLMs)于实时去中心化预测市场,涉及金融时间序列建模、无污染LLM评估和金融智能体基准测试三个研究领域。
事件预测和金融时间序列
计算金融从经典计量经济模型发展到大型金融基础模型,多针对连续资产变量,NLP 预测基准缺实时市场依据,PolyBench 结合订单簿快照与新闻流,可评估现实金融条件下的二元事件结果。
克服训练前数据泄漏
静态基准测试易受数据污染,模型可能在预训练时记住评估实例,导致报告准确率虚高,使基准分数无法可靠反映真实泛化能力。去中心化预测市场不受此问题影响,因其预测评估时尚未发生的事件,无法基于真实结果预训练。PolyBench 能强制实现真正的零样本时间推理,提供无污染的大语言模型预测能力衡量标准。
LLMs作为自主预测智能体
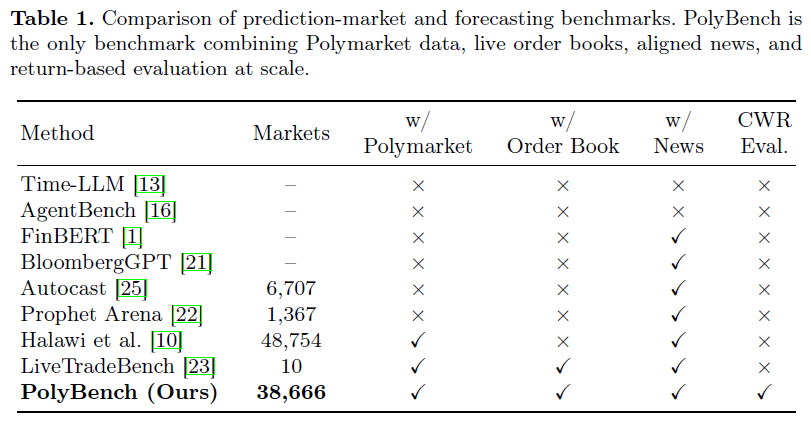
近期研究转向评估大语言模型(LLMs)作为自主决策智能体。Halawi等表明基于LLM的系统在Polymarket上可接近人类群体的准确性,Prophet Arena揭示实时事件预测瓶颈,但二者仅从文本维度评估,忽略订单簿机制和交易执行成本。PolyBench将预测市场视为多模态环境,纳入CLOB价差、实时流动性和突发新闻,以模拟财务回报评估模型,表1总结其填补的特征差距。
多元市场的定义和符号
为在 PolyBench 内规范评估框架,定义 Polymarket 生态核心组件:
事件:{E i } K i=1 是通过 Polymarket 的 Gamma API 获取的预测事件集,是关于未来现实事件的高级容器,明确相关市场的背景、范围和官方解决标准,如“谁将赢得 2026 年世界杯”。
市场:每个事件 E i 包含一个或多个二元市场 {M ij } N j=1 i ,是事件下可交易的具体命题,最终有明确的“是”或“否”结果,有唯一代币标识符、实时交易量和中央限价订单簿(CLOB)状态,如“法国将赢得 2026 年世界杯”。
事件解决:事件 E i 在时间 τ i 解决,即其所有市场 M ij 按官方规则确定结果 o ij ∈ {0, 1} ,o ij = 1 表示市场结果为“是”。
合约(份额):市场 M ij 的“是”合约是二元资产,o ij = 1 时支付 1,否则为 0,其收购成本由特定时间的市场流动性动态决定,PolyBench 模拟执行价格时按 CLOB 顺序吸收订单。
状态快照:PolyBench 在模拟历史环境中评估交易智能体,每个市场 M ij 在时间锚定的状态快照中评估,包含历史时间戳、事件元数据、CLOB 状态和预取的谷歌新闻上下文,防止回测时数据泄露。
交易信号:大语言模型智能体为快照生成的可操作输出,用标量置信度分数 c i ∈ [0.0, 1.0] 表示,c i 超过 0.6 时发出买入决策。
PolyBench
PolyBench旨在对大语言模型在Polymarket上的高级预测和市场交易能力进行以回报为导向、可扩展且自动化的评估,目标是达到或超越人类专业水平,下文将介绍其详情。
构建
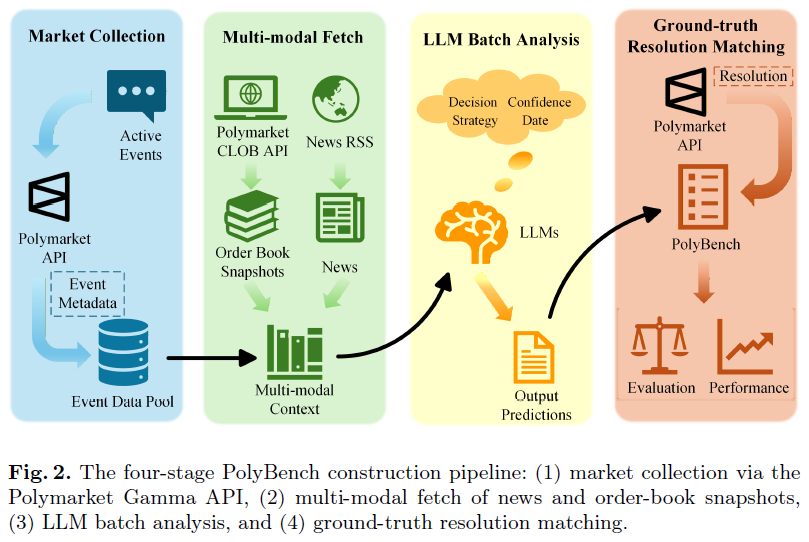
基准构建流程:通过 Polymarket 的 Gamma API 收集活跃事件元数据,背景运行器聚合多模态上下文,形成特定时间戳的市场历史快照,发送给 LLM 端点评估。
提示设计:为避免回测时数据泄漏,提示基于特定快照时间设定贝叶斯基线,包含事件信息、市场选项、新闻背景。系统指令有核心规则,如遵循市场规则、识别价值投注、分析市场微观结构等。
结构化输出与过滤:LLM 需返回格式化 JSON 负载,包含推理叙述和行动决策。若未识别正预期价值交易或信心不足,决策将被丢弃,可明确跳过事件。
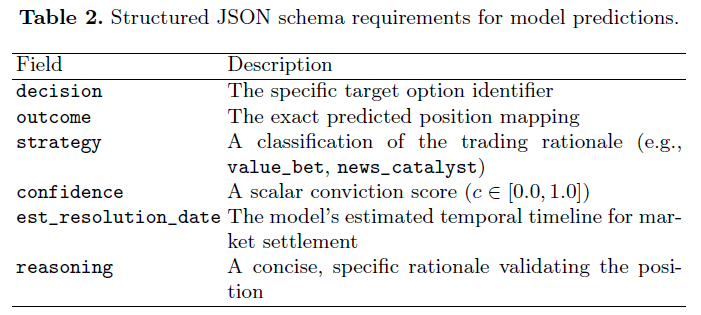
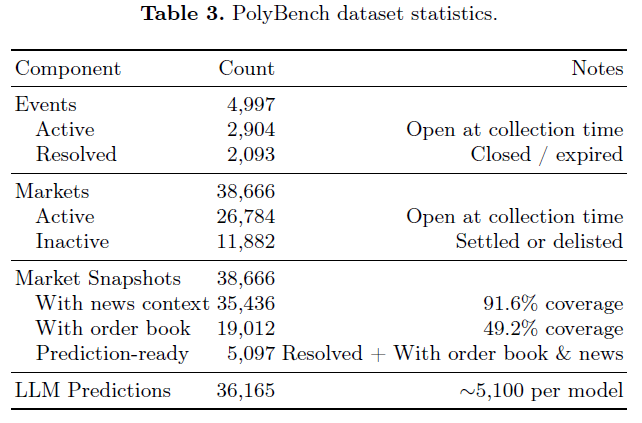
数据集统计:数据收集管道形成评估框架,PolyBench 数据集涵盖 2026 年 2 月 6 日至 12 日的金融事件、快照和 LLM 预测,最新市场解决日期为 2 月 21 日,未解决市场使数据集可用于未来纵向评估。
评估
研究不采用传统模型准确性评估及恰当评分规则,因预测有概率随机性且缺乏可靠概率参考,而是将模型置信度纳入经济回报计算。
PolyBench 面向实际市场交易,允许智能体跳过不利市场,不纳入绩效指标计算。
评估指标:
方向准确性:计算非跳过预测中正确识别市场结果的比例。
置信加权回报(CWR):考虑正确性和风险校准,按置信度分配预算模拟交易,计算净收益与总投资资本之比。
补充指标:
年化百分比收益率(APY):归一化 CWR 以考虑资金机会成本。
夏普比率:评估风险调整后的投资组合绩效。
时间分辨率误差:衡量模型预测市场解决时间的误差。
实验
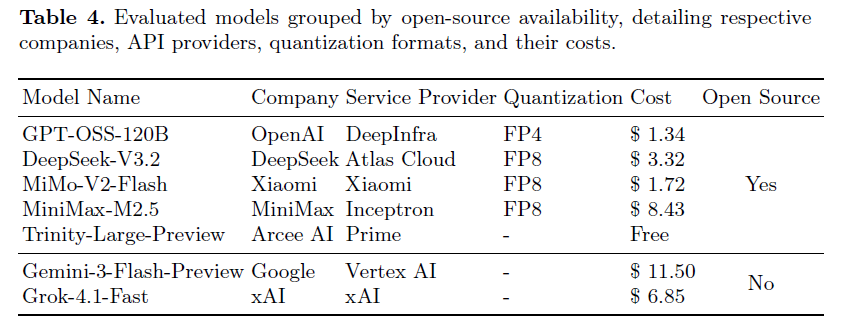
介绍PolyBench评估框架的实证结果,该框架评估七种先进LLM,基于金融快照共进行36,165次预测。表4总结评估模型,涵盖发布公司、API服务商、推理量化情况、5097个市场预测成本及开源状态,所有模型知识截止日期在基准测试前。
整体表现
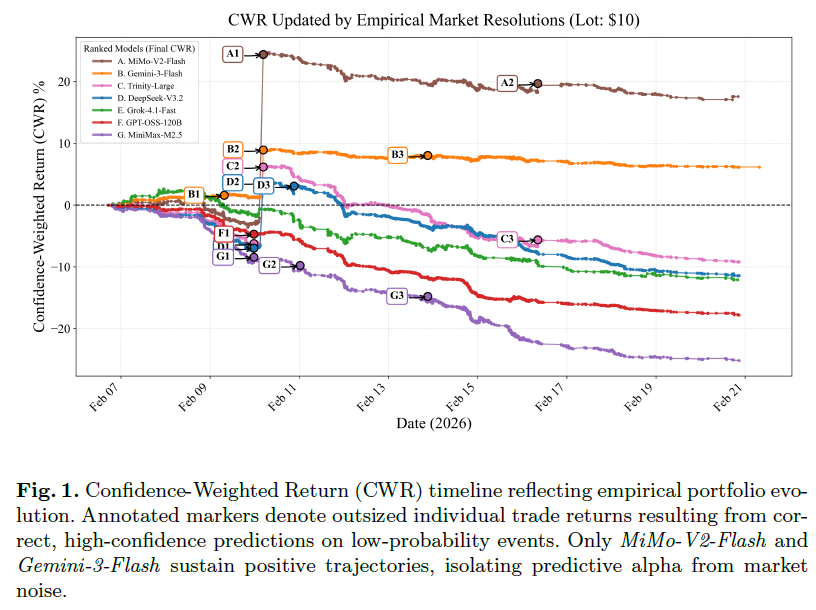
采用第4节指标严格评估大语言模型(LLM)金融能力与预测准确性,区分非置信加权回报(Non - CWR)和置信加权回报(CWR)。多数模型CWR高于Non - CWR,显示元认知能力,后续讨论用CWR指标。仅MiMo - V2 - Flash和Gemini - 3 - Flash获正绝对回报,开源的MiMo - V2 - Flash净盈利表现更优。
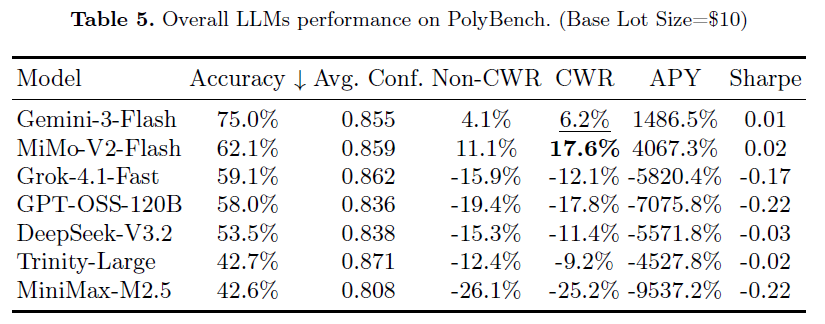
图1展示2026年2月6日至21日CWR走势,标注点为低概率成功预测带来的超高回报。
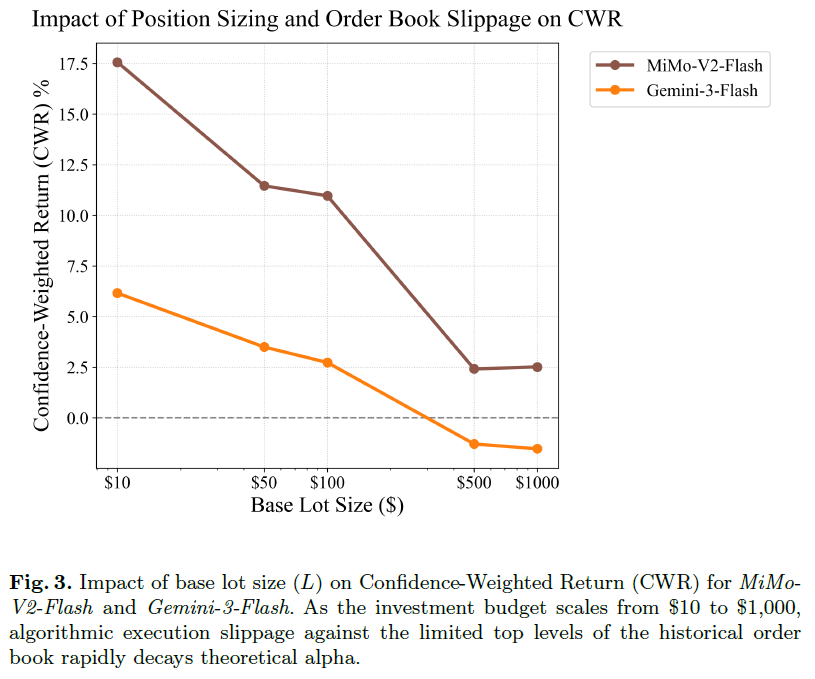
PolyBench真实执行环境中,仓位规模影响可实现回报。模拟最大基础交易规模至1000美元。
图3显示两优模型CWR随基础交易规模变化情况。小资金分配时可获理论收益,规模增大至1000美元,模型盈利能力骤降,MiMo - V2 - Flash在500美元前较有韧性。结果表明去中心化预测市场中,理论预测优势受市场深度限制。
领域专业知识和错误
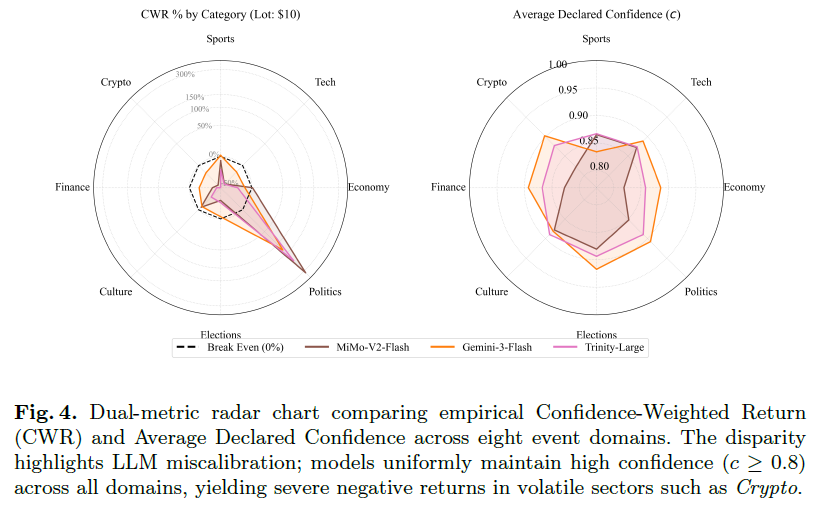
不同主题领域带来不同分析挑战。图4展示三个顶级模型在PolyBench八个主要事件类别中的CWR表现和平均声明置信度。结果显示严重校准错误:模型不论领域复杂度,都保持高置信度(0.8 ≤ c ≤ 0.9)。在政治领域,高置信度带来稳健收益;在加密等投机性高波动领域,高置信度有害,模型在维持过度自信时遭受重大负回报,说明历史文本不足以预测价格波动。
策略运用与指令治理
自主金融部署注重指令遵循,表6展示策略利用、条件绩效和执行纪律。多数大语言模型常用价值投注和新闻催化剂策略,Gemini - 3Flash和DeepSeek - V3.2策略更多样,使用稳定收益策略超20%。
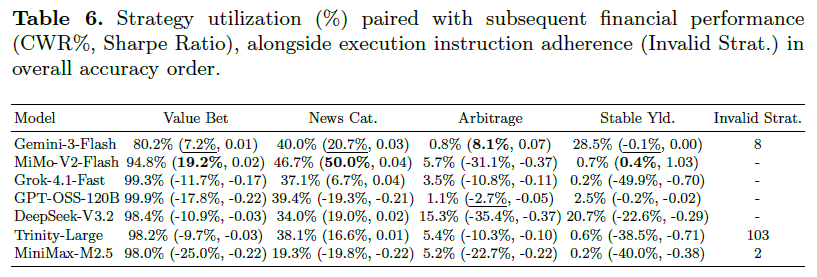
按策略执行的表现体现模型战略能力,MiMo - V2 - Flash用新闻催化剂和价值投注获显著收益,Gemini - 3 - Flash在多领域获正回报。
遵循指令不保证盈利,极端幻觉与负回报相关,完美执行也未必产生阿尔法收益。开源的MiMo - V2 - Flash结合零幻觉纪律和精准预测能力,获最高累计加权收益率,说明金融可行性需严格治理和强大概率推理。
总结
本文提出 PolyBench,首个大规模、无污染基准,用于在实时去中心化预测市场评估大语言模型(LLMs)交易能力,结合市场快照、CLOB 状态和新闻流,提供财务评估标准。对 7 个先进 LLMs 评估,仅 MiMo - V2 - Flash(17.6% CWR)和 Gemini - 3 - Flash(6.2% CWR)获正回报,其余 5 个虽信心高但亏损。
研究发现:
1)LLMs 有隐式元认知,对正确预测信心更高;
2)领域能力不均,政治领域有优势,加密等投机领域校准差;
3)遵循指令必要但非盈利充分条件,订单簿滑点会侵蚀大订单回报。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
