Seedance 2.0论文首曝解读|碾压Sora,字节Seed团队藏的王炸终于舍得放论文了!
🔥 Seedance 2.0 已在豆包、火山引擎平台正式上线。
你还在为生成的视频「运动僵硬、音画不同步、无法理解复杂指令」而头疼吗?当你想用一张图、一段音频来驱动视频创作时,是不是发现市面上的模型要么功能不全,要么质量堪忧?
想象一下,你给AI一张蒙娜丽莎的画像,并告诉它:“让她伸手拿起桌上的可乐喝一口,然后一个牛仔走进来把可乐拿走。” 大部分模型要么直接“罢工”,要么生成一堆无法直视的“恐怖片”画面。视频生成的复杂性与可控性,成了横亘在创意与落地之间最大的鸿沟。
今天,由字节跳动Seed团队带来的 Seedance 2.0,正式宣告了这一鸿沟的弥合。它不仅仅是一个简单的升级迭代,而是一场从「生成短视频片段」到「原生支持丰富多模态控制信号的高稳健视频合成」的范式革命。读完本文,你将彻底理解为何它能在一系列残酷的量化评测中,横扫所有主流竞品,在三大任务(T2V/I2V/R2V)的所有维度上登顶第一。
❓ 视频生成的“不可能三角”:质量、控制、多模态
长久以来,视频生成模型似乎陷入一个“不可能三角”:视觉质量高、运动流畅的模型,往往可控性差,难以精确遵循复杂指令;支持多模态参考输入的模型,又常常在生成质量上大打折扣,运动扭曲、画面崩坏屡见不鲜。
痛点一:运动崩塌与物理失实。要求生成一个“双人花样滑冰的慢动作特写”,结果人物肢体扭曲、旋转动作反物理,镜头语言混乱,毫无美感可言。
痛点二:多模态控制“图不对文”。上传一张主体图片,并输入一段复杂的动作描述文案,模型要么无视图片主体,要么只理解了文案的只言片语,生成内容与预期大相径庭。
痛点三:音画“各玩各的”。生成的音频与画面节奏脱节,唇形对不上,音效与动作错位,整体体验割裂,距离“专业级视听作品”相去甚远。
这些痛点,本质上是因为模型缺乏对真实世界复杂性的统一建模能力。而Seedance 2.0的野心,正是要一举攻克这些难题。
🚀 硬核拆解:Seedance 2.0 如何统一多模态世界?
Seedance 2.0 的核心,在于其统一、高效、大规模的多模态音视频联合生成架构。简单说,它不再将文本、图像、音频、视频视为割裂的输入,而是在一个统一的框架下进行联合建模与生成。这带来了三大核心能力的跃升。
💡 核心跃升一:对“真实世界复杂性”的建模
之前的模型生成复杂交互(如多人打斗、体育竞技)时,经常出现主体变形、运动不合理的情况。Seedance 2.0 通过增强的运动建模与物理规律理解,显著改善了这一点。
技术显微镜:模型在潜在空间(Latent Space)中更好地建模了时间连贯性和物体间的物理约束。例如,在生成“竹叶被剑气震飞”的场景时,模型不仅需要生成竹叶飞散的视觉轨迹,还要确保其加速度、旋转符合空气动力学,并且与剑客挥剑的动作在时空上精确关联。这背后是海量高质量视频数据与更强大的时空注意力机制共同作用的结果。
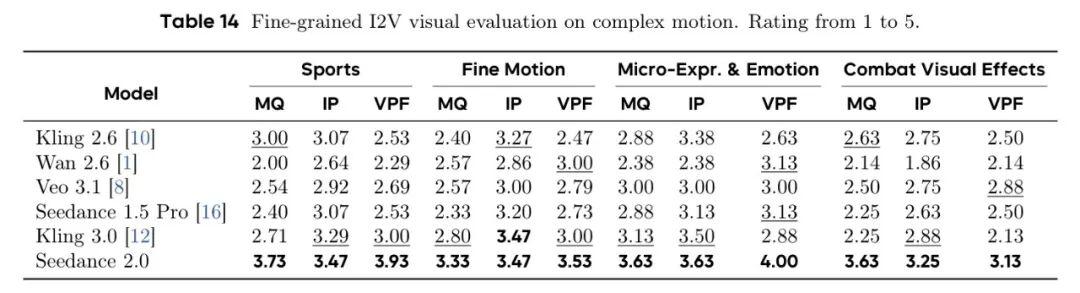
效果直观体现:在评测中,Seedance 2.0 在“复杂运动场景”和“物理规律”的细粒度评估中全面领先。例如,在“战斗视觉效果”(Combat Visual Effects)的运动质量(MQ)指标上,它以 3.63分 遥遥领先于Kling 3.0和自家前代Seedance 1.5 Pro的 2.25分,差距高达1.38分。
💡 核心跃升二:前所未有的多模态控制力
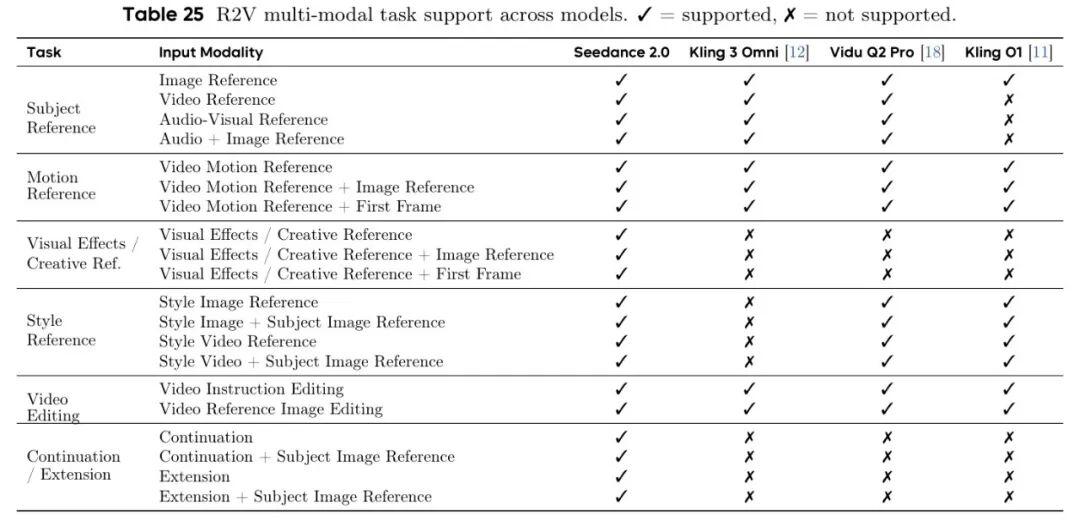
这是Seedance 2.0最颠覆的地方。它原生支持文本、图像、音频、视频四种模态的任意组合作为输入参考,实现了目前业界最全面的多模态内容参考与编辑能力套件。
1. 复杂指令理解与执行:面对“新实体(尺寸关系)”、“复合多指令”、“程度副词”这类刁钻任务,Seedance 2.0展现出了惊人的指令遵循精度。
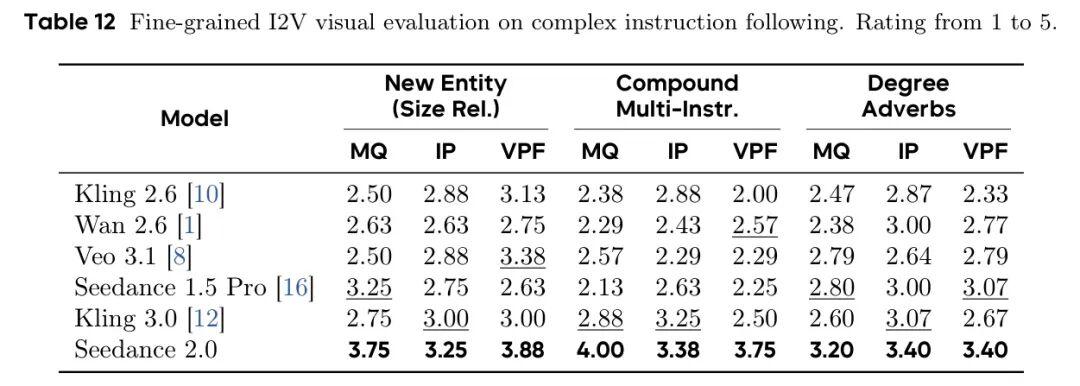
设计直觉:这就好比一个顶尖的导演,不仅能听懂“给主角一个特写”这种简单指令,更能理解“模仿参考视频A中前3秒的运镜节奏,结合参考图片B的色彩风格,生成一个角色C在雨中回眸的慢镜头,背景音乐要悲伤的小提琴曲”这样复杂的、多模态交织的“导演脚本”。Seedance 2.0通过其统一的多模态编码器,将不同模态的信息映射到同一个语义空间进行深度融合理解。
2. 全面的R2V(参考到视频)能力:它支持主体参考、运动参考、风格参考、视频编辑、续写、扩展六大任务。一张图、一段视频,都能成为你视频创作的“素材库”。
💡 核心跃升三:高保真音视频同步生成
Seedance 2.0集成了双通道音频(Binaural Audio)技术的升级音频模块,能同步生成具有空间感的沉浸式声音。它不只是“配上”一段音乐或音效,而是实现了音轨与视觉动作在时域上的精确对齐。
实战思考:这意味着生成一个“剑客挥剑,斩断竹竿”的镜头时,你可以听到剑刃破空的呼啸声、竹竿断裂的清脆声、以及断裂竹竿掉落在泥土上的闷响,这些声音不仅层次分明,而且与画面中剑的轨迹、竹竿断裂的瞬间严丝合缝。这种同步性在快节奏对话和复杂动作场景中至关重要。
💡 互动时刻:你认为这种级别的音画同步,最可能首先颠覆哪个行业?是短视频内容创作,还是游戏CG制作?欢迎在评论区分享你的高见!
📊 数据说话:一场全方位的“屠杀式”领先
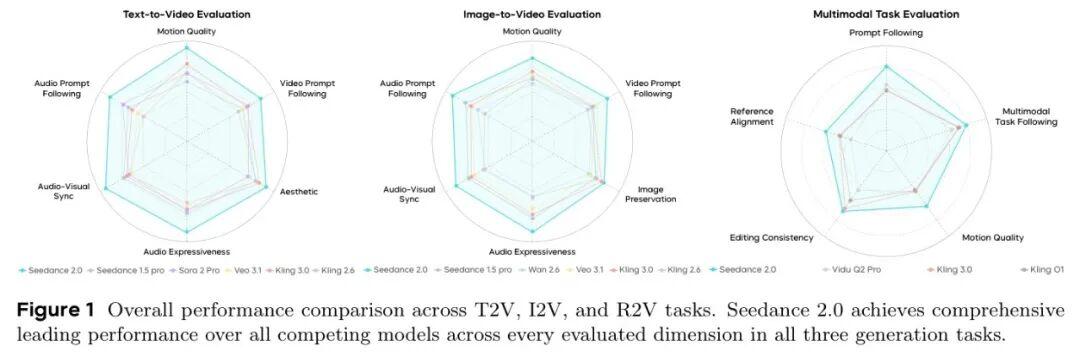
说一千道一万,不如数据来得直观。Seedance 2.0 在自家构建的全面评估基准 SeedVideoBench 2.0 上,与包括 Sora 2 Pro、Veo 3.1、Kling 系列等所有主流商业模型进行了正面较量。结果如何?我们直接看雷达图。
🏆 T2V(文本到视频):六边形战士的诞生
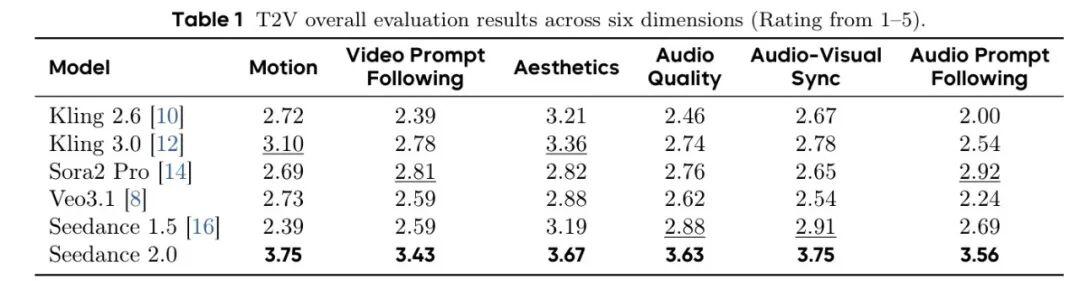
在文本到视频的6个核心维度(运动、视频提示遵循、美学、音频质量、音画同步、音频提示遵循)上,Seedance 2.0 实现了“全满分”制霸。
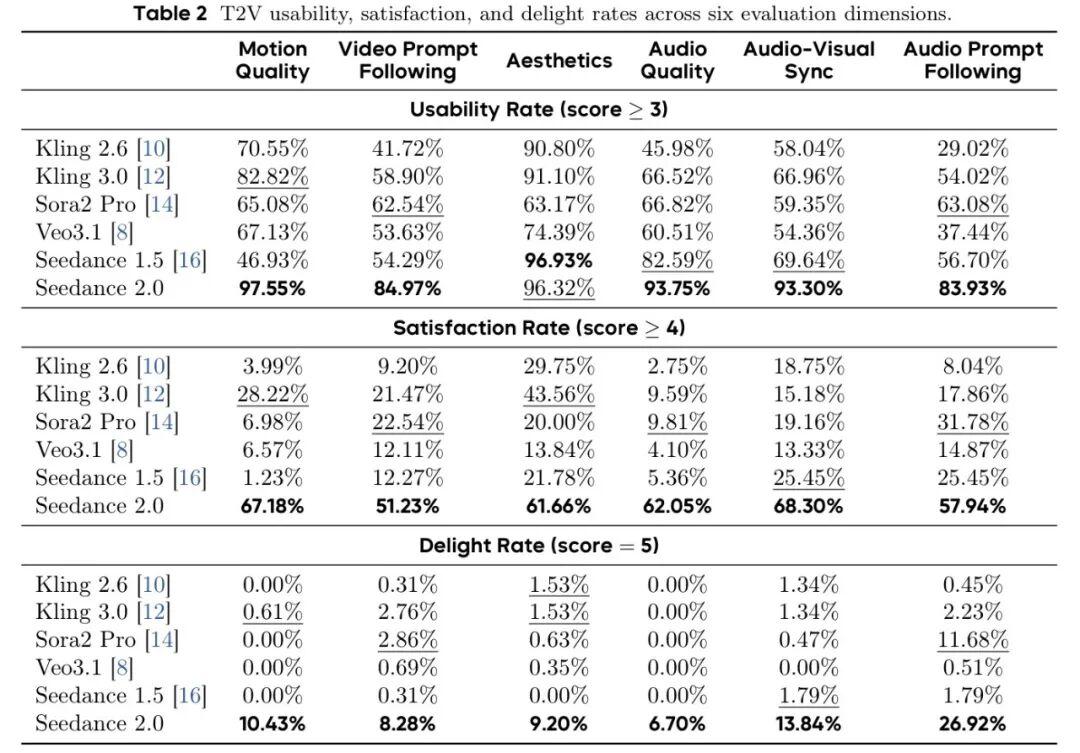
更可怕的是在 用户体验 层面。Seedance 2.0是唯一一个在所有维度上可用性(得分≥3)均超过83%的模型,在运动质量上甚至达到97.55%。这意味着,几乎每一次生成,它的基础运动都是可用的。
细粒度能力剖析:
- • 运动质量:在30个细粒度类别(如剪辑节奏、构图、多实体交互)中,Seedance 2.0在29个类别中排名第一。在“多实体特征匹配”上获得了恐怖的 4.43分(满分5分)。
- • 视频提示遵循:在“反现实指令”和“情感与表达”类别中,分别获得 4.29分 和 4.00分,展示了其对抽象和情感化指令的深度理解。
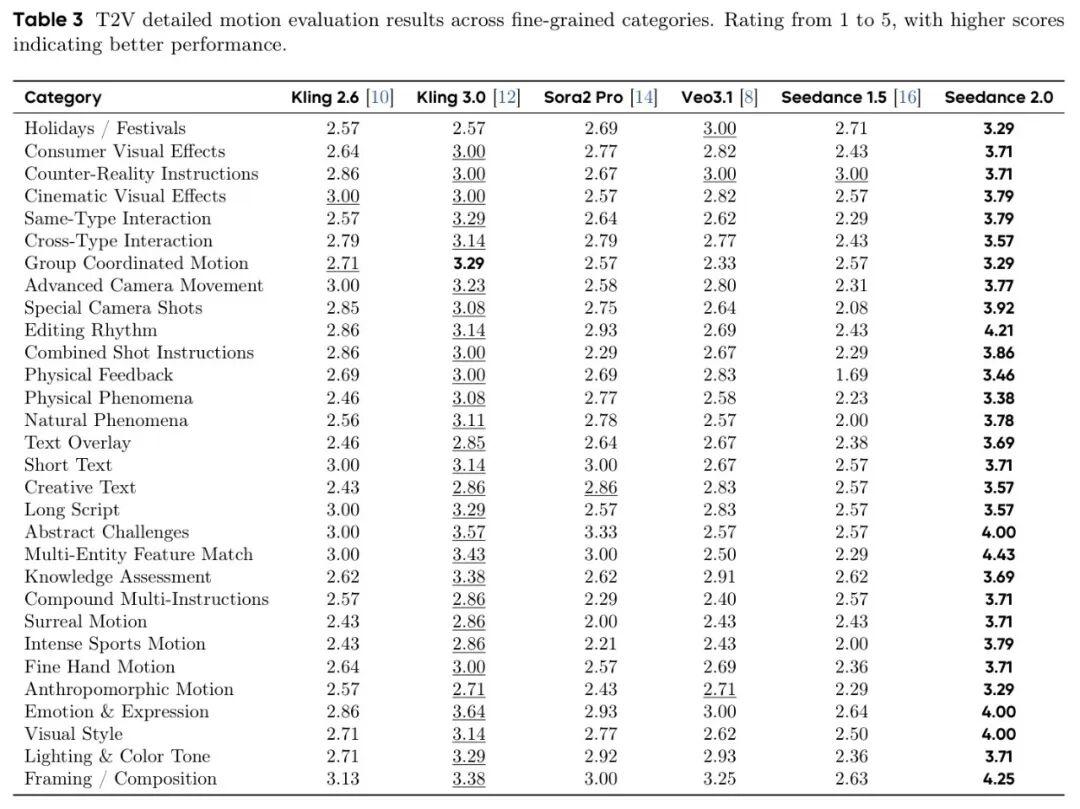
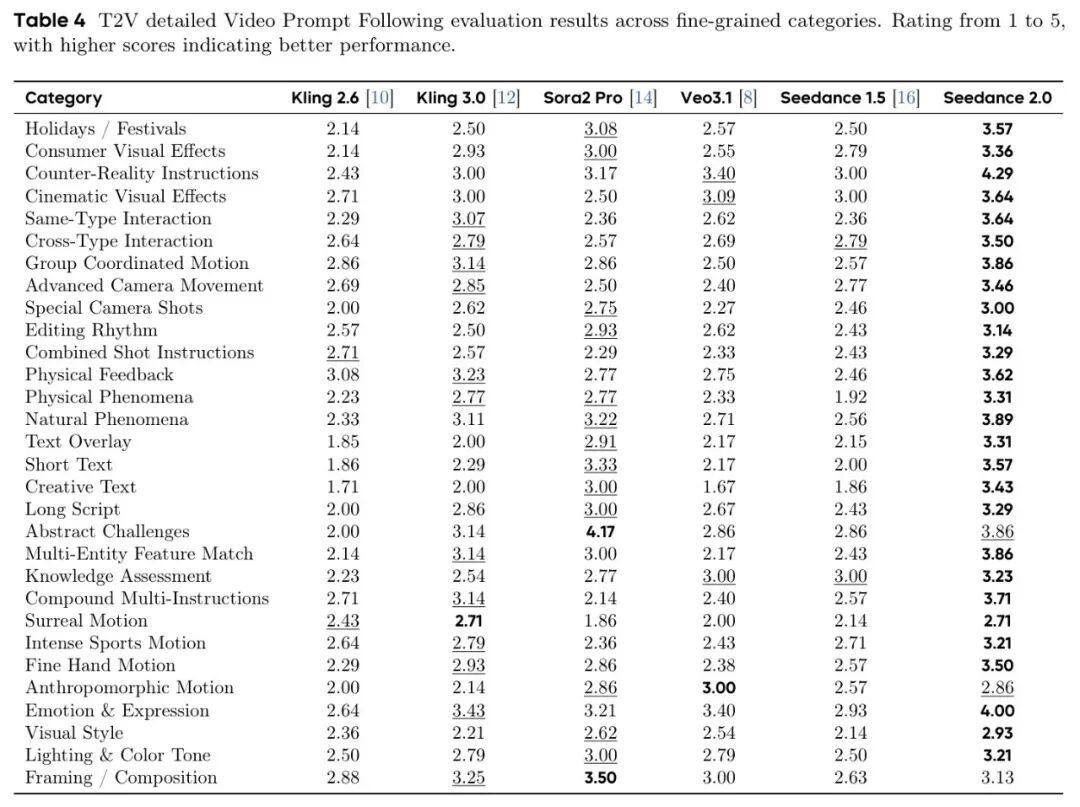
🏆 I2V(图像到视频):不仅是“动起来”,更是“演得好”
图像到视频任务更考验模型在给定视觉约束下的创造能力。Seedance 2.0 不仅在 运动质量(MQ)、图像保真度(IP) 上领先,更在 视频提示跟随(VPF) 上展现了绝对统治力。
在“复杂交互”场景中,对于“跨类型交互”(如人与物体互动),其视觉合理性(VPF)达到了 4.00分 的满分水平。在“创意生成”任务中,对于“视觉效果(转换)”类指令,其综合表现全面领先。
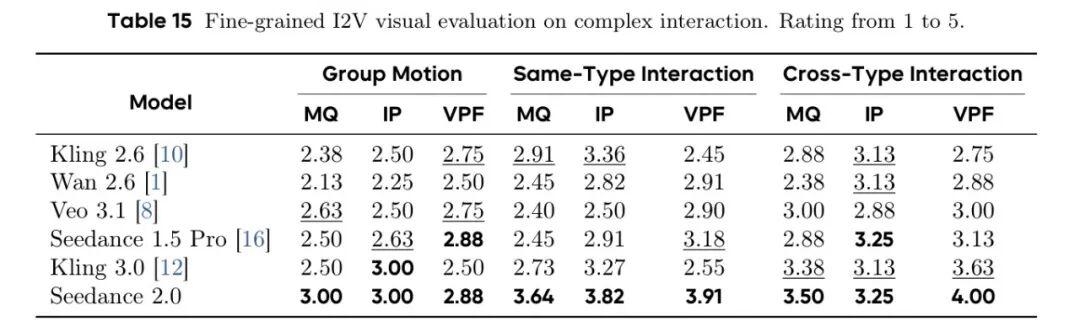
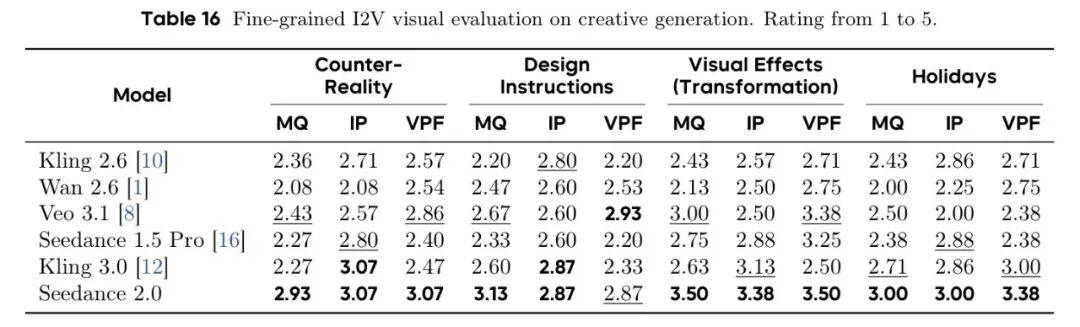
音频维度的降维打击:
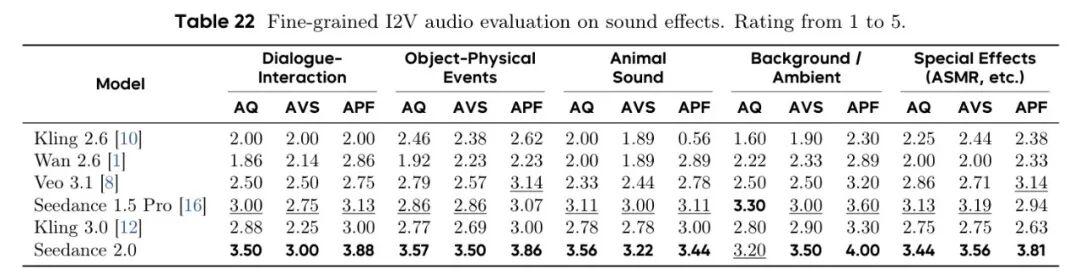
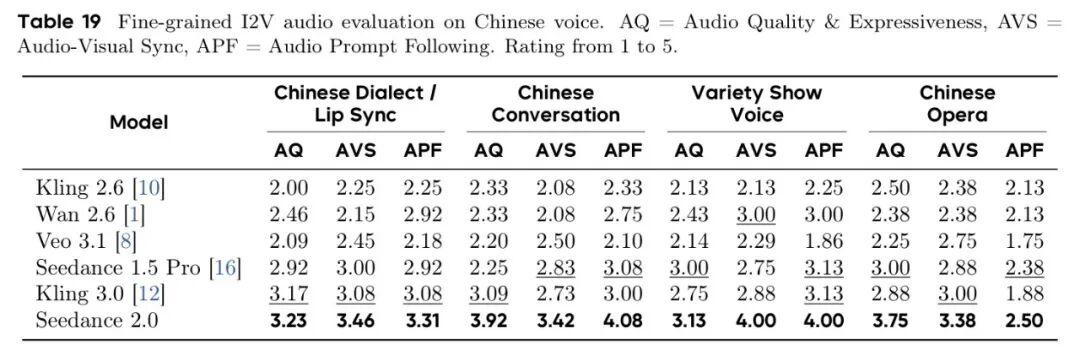
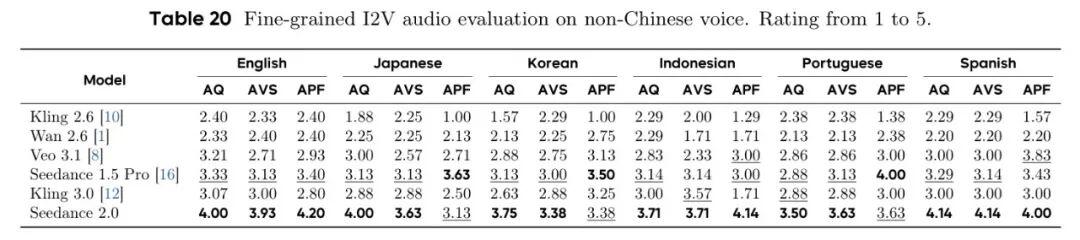
在I2V任务中生成配套音频是极高难度的挑战。Seedance 2.0在 中文语音(如方言、对话、戏曲)和 非中文语音(涵盖英、日、韩等六种语言)的评估中,在全部三个指标(音频质量AQ、音画同步AVS、音频提示跟随APF)上取得所有最高分。尤其在中文对话的音频质量上,以 3.92分 领先第二名Kling 3.0多达 0.83分。
🏆 R2V(参考到视频):多模态控制的终极考验
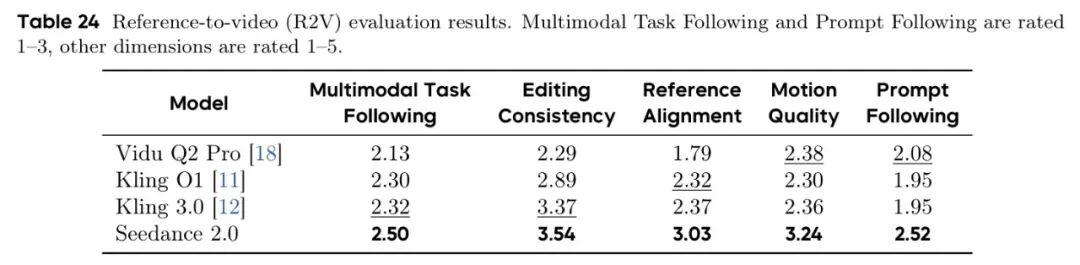
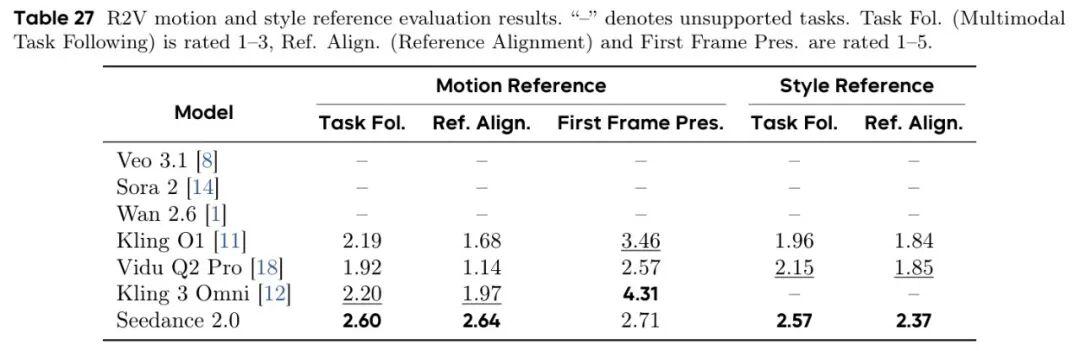
这是最能体现Seedance 2.0“统一多模态”架构优势的战场。在 多模态任务跟随、编辑一致性、参考对齐、运动质量、提示遵循 五个维度上,它全部排名第一。
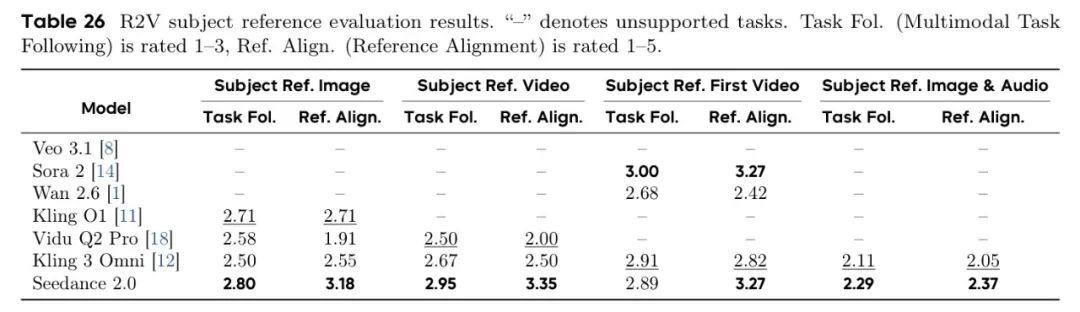
- • 主体参考:在基于图像的主体参考任务中,其参考对齐度得分 3.18,大幅领先第二名的2.71和第三名的1.91。
- • 运动/风格参考:在运动参考的任务遵循和参考对齐上,分别以 2.60 和 2.64 分领先,而竞品均低于2.0分。
- • 视频编辑与续写:在视频编辑任务中,虽然在任务遵循上略逊于Kling O1(2.20 vs 2.29),但在更关键的编辑一致性(3.75) 和参考对齐(3.79) 上大幅领先,意味着它编辑得更精准、更少破坏原内容。更重要的是,它是目前唯一被评估支持视频续写功能的模型。
🔬 消融实验与场景化深度分析
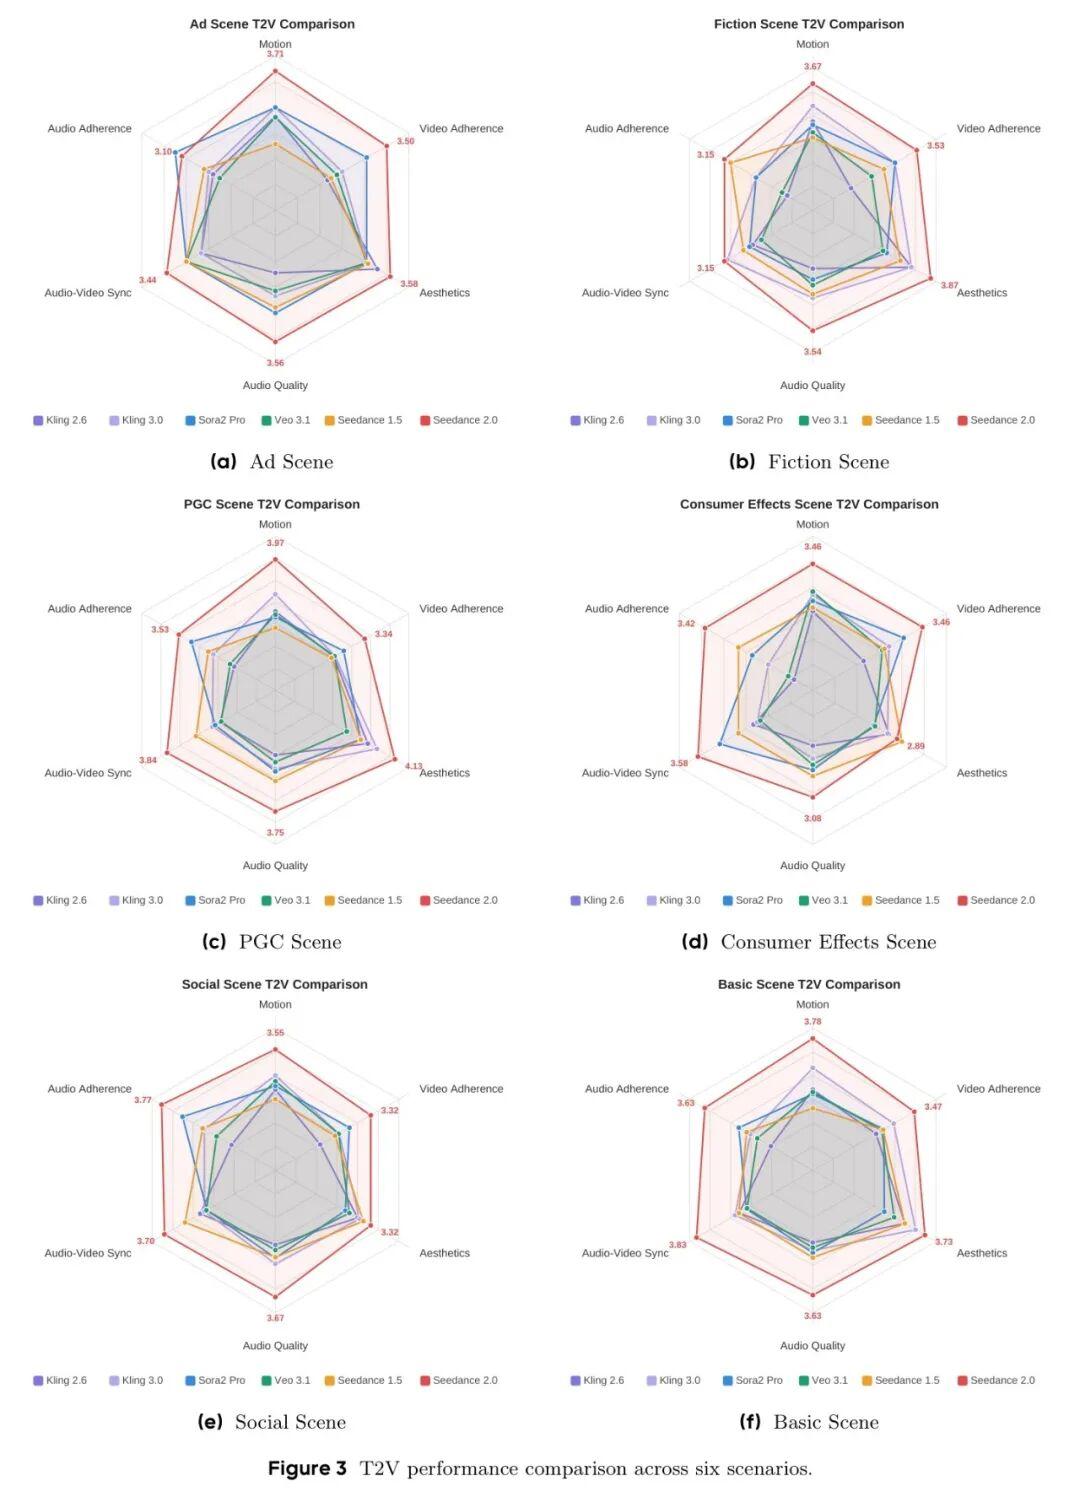
除了横向对比,Seedance 2.0 也针对不同应用场景进行了深度优化。雷达图显示,在广告、虚构、PGC(专业生成内容)、消费者特效、社交、基础六大场景下,Seedance 2.0 在运动、视频遵循、美学、音频质量、音画同步、音频遵循六个维度上,几乎都保持着最外圈的多边形,证明了其强大的跨场景鲁棒性。
可视化结果见证实力:
光有数据不够,我们直接看它生成的内容。在以下三个场景中,Seedance 2.0 展现出了惊人的叙事能力和细节表现力。
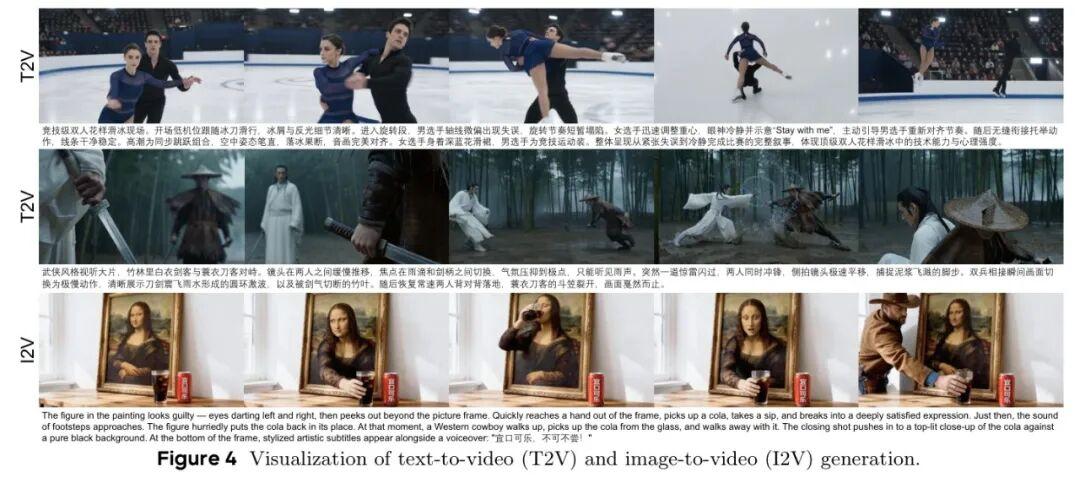
第一行(T2V):竞技级双人花样滑冰。从低机位跟拍,到跳跃旋转时的小失误与调整,再到最终完美落冰,整个序列运动流畅、物理合理,镜头语言专业。
第二行(T2V):武侠风格大片。剑客对峙时的紧张感、慢动作冲锋时竹叶飞溅的细节,动态与静态节奏把控精准。
第三行(I2V):蒙娜丽莎“活”了过来,伸手取可乐喝,随后牛仔闯入将可乐拿走。这个例子完美诠释了什么是“基于图像的复杂叙事生成”,它不仅让静态画中人产生了合理且生动的运动,还编排了一个充满故事性的小情节。
⚖️ 客观评价:优势与挑战并存
尽管成绩单如此耀眼,但论文也诚实地指出了Seedance 2.0当前的局限性:
- 视频扩展(Video Extension)是其相对短板。在与Veo 3.1的对比中,虽然Seedance 2.0支持更灵活的输入(可扩展任意上传视频),但在扩展任务的任务遵循(1.93 vs 2.78)和参考对齐(3.28 vs 3.44)上仍落后于专注于自身视频扩展的Veo 3.1。
- 极复杂物理模拟与多主体长期一致性仍有提升空间。在涉及非常精细的物理现象(如流体、复杂碰撞)和需要多个主体在长时间序列中保持绝对一致的场景中,模型偶尔仍会出现不合理或不一致的情况。
- 计算开销。如此强大的多模态统一模型,其计算需求必然不低。虽然团队提供了“快速版本”(Fast Version)以应对低延迟场景,但如何进一步优化推理效率,仍是工程上的重要课题。
🌟 总结与展望:视频生成进入“强控制”时代
Seedance 2.0 的发布,标志着视频生成技术正式从“炫技式生成”迈入“生产力驱动”的强控制时代。它的核心贡献在于:
- • 一个统一架构:真正将文本、图像、音频、视频在多模态层面统一理解与生成。
- • 一套全面能力:覆盖了从基础生成到参考控制、编辑、续写的完整创意工作流。
- • 一次性能飞跃:在几乎所有量化评估维度上,对现有SOTA模型实现了全面超越。
它不仅仅是一个更好的视频生成工具,更是一个多模态创意引擎的雏形。对于内容创作者、广告从业者、影视特效团队而言,这意味着创作门槛的极大降低和想象空间的极大拓展。
🤔 深度思考:你认为Seedance 2.0所代表的“强可控多模态视频生成”技术,最可能率先在哪个领域引爆革命?是彻底改变短视频内容生产格局,还是成为下一代游戏/影视制作的标配工具?欢迎在评论区留下你的真知灼见!
💝 支持原创:如果这篇近5000字的深度解读帮你看清了视频生成技术的未来,点赞+在看就是对我最好的支持!也请分享给你身边关注AI技术发展的伙伴!
🔔 关注提醒:设为星标,第一时间获取最硬核的AI技术解读!
#AI技术 #视频生成 #多模态AI #Seedance2 #AIGC #技术干货 #论文解读
参考
Seedance 2.0: Advancing Video Generation for World Complexity