理想汽车发布Switch-KD|跨模态知识迁移新范式,精度暴涨3.6分
想让你的0.5B小模型性能直逼3B大模型,却总被“知识蒸馏”的跨模态鸿沟卡住脖子?因为99%的蒸馏努力都错了方向——它们试图把视觉和语言知识分开“喂”给学生,结果导致知识迁移支离破碎。今天要解读的Switch-KD,用一招“视觉切换”的奇思妙想,在统一的文本概率空间内完成了多模态知识的无缝迁移,让0.5B学生模型在10项基准上平均反超3.6分,而且无需改动任何模型架构。
读完本文,你将彻底掌握这项“借脑看世界”的蒸馏黑科技,理解它如何实现隐式视觉对齐和动态logits筛选,为你的轻量化模型部署打开新思路。
❓ 核心痛点:为什么传统蒸馏在VLMs上失灵了?
视觉语言模型(VLMs)如LLaVA、Qwen-VL的强大有目共睹,但其动辄数十亿的参数量,让移动端和边缘设备的部署成了奢望。知识蒸馏(KD)本是救星——让大模型(教师)教小模型(学生)。在纯文本领域,KD已非常成熟。
然而,一旦涉及视觉和语言双模态,传统KD就立刻“水土不服”。问题根源在于 “知识表达的场所”不统一。
在VLMs中,多模态知识(看到的图像+理解的文本)最终融合在语言空间里,体现为模型对下一个词预测的概率分布(logits)。但以往的蒸馏方法是怎么做的呢?
- • Align-KD:试图对齐教师和学生模型中,语言模型对视觉特征的注意力图。这相当于在教“如何看”,但和最终的“如何说”(文本生成)是割裂的。
- • LLaVA-KD:强制学生模型生成的视觉特征token与其logits保持一致。这更像是一种自省式的约束,而非直接从教师那里学习跨模态的关联。
它们的共同问题是:采用了模态分离的监督。视觉管视觉,语言管语言,就像让两个老师分别教学生画画和作文,却无法保证他画出的画能写出匹配的文章。这种割裂的监督,忽视了视觉与语言在VLMs内部深刻的耦合关系,导致蒸馏效率低下,学生模型学到的多模态知识是碎片化的。
那么,有没有一种方法,能在一个统一的、天然的融合空间里进行蒸馏呢?有的,这个空间就是文本概率空间(Text Probability Space)。Switch-KD的核心洞见正在于此:既然知识最终在这里融合,那就应该直接在这里传承。
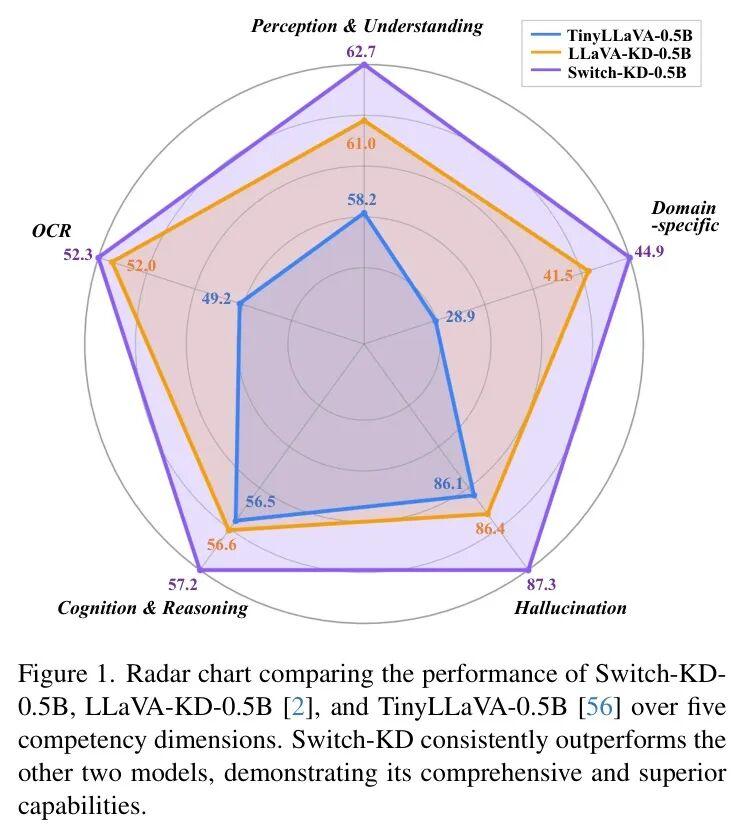
在深入细节前,我们先直观感受一下Switch-KD的成果。下图展示了0.5B参数的Switch-KD模型与两个强劲基线(LLaVA-KD-0.5B和TinyLLaVA-0.5B)在五个核心能力维度的雷达图对比。可以看到,Switch-KD在每一个维度上都实现了全面包围,尤其是在“幻觉控制”(Hallucination)和“认知推理”(Cognition & Reasoning)上优势明显,证明其学到的知识更扎实、更可靠。
🏗️ 架构解析:Switch-KD如何实现“视觉切换”?
Switch-KD的整个框架非常精妙,它只包含两个核心组件,却解决了根本问题。我们先通过下面的整体架构图一览全貌,再逐一拆解。
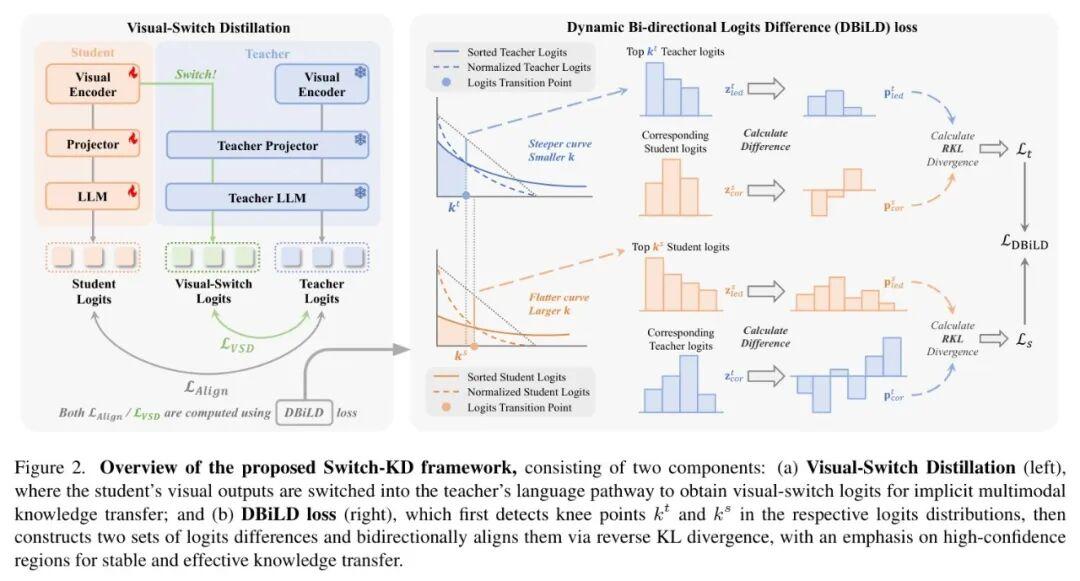
如图所示,整个框架包含一个冻结的教师模型 和一个待训练的学生模型 ,两者结构相同,均包含视觉编码器(V)、投影层(P)和大语言模型(LLM)。
框架的核心是两条并行的蒸馏路径,它们都在同一个目标上发力:让学生模型的输出概率分布向教师看齐。总损失函数为:
其中 是标准的自回归语言建模损失(让学生学会生成),而 和 就是我们要重点讲解的两条蒸馏路径对应的损失。
💡 核心创新一:视觉切换蒸馏(Visual-Switch Distillation)
这是Switch-KD得名的由来,也是最富想象力的一环。它包含两条路径:
- 标准对齐路径(Standard Alignment Path):这条路是常规操作。输入同一张图片和文本,让教师和学生分别走完自己的全套流程(视觉编码→投影→LLM),得到两组logits: 和 。然后,用一个损失函数 去拉近这两组分布。这条路主要传递整体的、语言侧的知识。
- 视觉切换路径(Visual-Switch Path):这才是精髓! 我们不走学生自己的LLM了,而是玩一个“移花接木”:把学生视觉编码器 输出的视觉特征,直接“喂”给教师模型的投影层和LLM( 和 )。
这样得到一组新的logits:,我们称之为“视觉切换logits”。它代表了**“教师的脑子”** 对**“学生的眼睛”** 所看到内容的解读。
接下来是关键:我们让这组 去逼近教师原本的logits ,损失函数为 。
这个设计的直觉简直太妙了! 你可以把它想象成:让一位大师(教师)戴着学徒(学生)的眼镜去看世界,然后要求大师看到后的描述(),必须和他自己用惯用眼镜看到后的描述()保持一致。为了满足这个要求,学徒就必须不断调整自己的“眼镜”(视觉编码器 ),直到它产生的视觉特征能够被大师的“大脑”完美理解。
这样一来,视觉知识(如何编码图像)的迁移,被隐式地、自然地融合在了对统一文本概率分布的拉近过程中。学生不仅学到了“看到什么”,更学到了“如何将看到的与语言联系起来”,这才是多模态知识的精髓。
💡 核心创新二:动态双向对数差损失(DBiLD Loss)
有了好的蒸馏路径,还需要好的“度量衡”来判断分布是否接近。传统KD直接用KL散度对齐所有logits,但LLM的logits分布有个特点:长尾效应。即少数几个token概率很高,后面拖着成千上万个概率极低的尾巴。强迫学生去匹配教师的所有长尾分布,不仅低效,还可能引入噪声。
已有的BiLD损失通过双向对齐Top-K个logits的差异来解决,但K是固定的。Switch-KD更进一步,提出了动态双向对数差(DBiLD) 损失,它包含两个对称的部分:
- • 教师引导蒸馏:从教师的logits分布中,动态地找出信息丰富区域和长尾区域的“拐点”(使用Kneedle算法),以这个点作为 。只取教师前 个最重要的logits,并计算这些logits两两之间的差值,形成一个“相对重要性”分布。然后让学生对应位置的logits差值分布,通过反向KL散度(RKL) 去匹配它。RKL的特点是,它会重点关注教师高置信度(概率大)的区域,让学生在这些关键决策上学得更像。
- • 学生引导蒸馏:对称地,也从学生的logits分布动态找出拐点 ,取出学生自己最自信的前 个logits,让教师对应的logits差值分布去匹配学生的这个分布。
这个双向动态设计的好处是?
- 动态:适应不同样本、不同模型的分布差异,精准捕捉信息区。
- 双向:既让学生学习教师的强项(教师引导),也让教师验证学生的自信点是否合理(学生引导),形成闭环。
- 聚焦:通过RKL和对数差,聚焦于高置信度token之间的相对关系,而非绝对值,这使得知识迁移更稳定、更关注语义结构。
这个DBiLD损失,被同时用于 和 ,确保两条路径上的分布对齐都是高质量、高精度的。
💡 思考:这套“视觉切换+动态对齐”的组合拳,是不是比单纯对齐特征或注意力更优雅?它把复杂的多模态对齐问题,转化为了在统一空间内的概率分布匹配问题。
🏆 实验验证:数据证明一切
理论再美,也需要数据支撑。Switch-KD在10个主流多模态基准上进行了全面测试,结果堪称碾压。
SOTA对比:全面领先,以小博大
首先看与当前最主流VLMs的对比。下表涵盖了从感知、推理、OCR到抗幻觉等全方位能力。其中Avg7和Avg10是两个综合平均分,最具代表性。
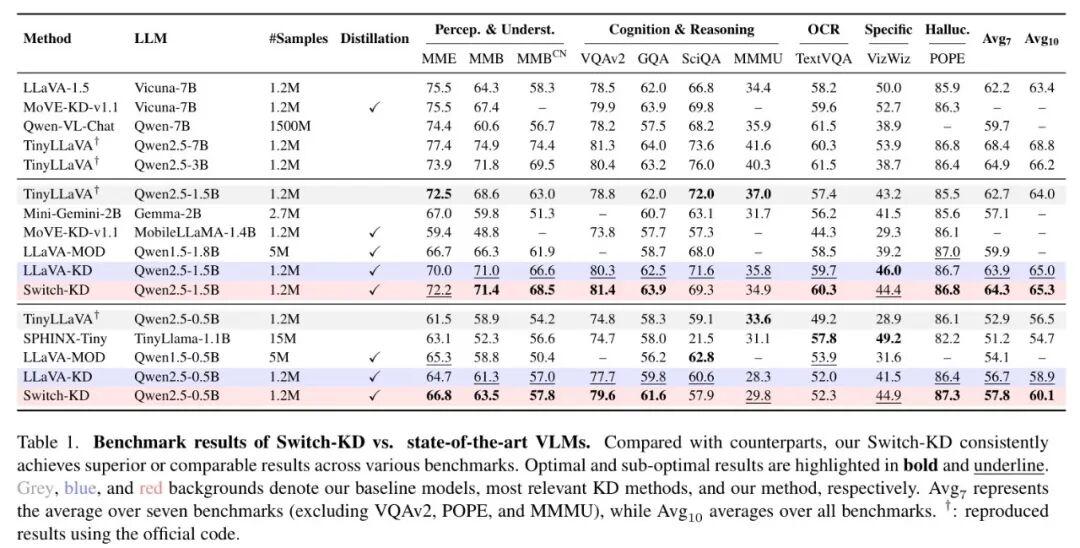
看几个震撼的结论:
- • 1.5B的Switch-KD,性能堪比3B模型! Switch-KD-1.5B的Avg10得分64.5,与TinyLLaVA-3B的64.9几乎持平,参数量却少了一半。
- • 远超其他蒸馏方法:同样是1.5B,Switch-KD比LLaVA-KD和LLaVA-MoD分别高出0.4和4.4个点(Avg7)。在0.5B级别,优势更大。
- • 数据效率极高:Switch-KD-0.5B的Avg7比SPHINX-Tiny高4.0分,而训练数据量仅为后者的八分之一。
这充分证明了统一概率空间蒸馏的高效性。知识迁移的“路径损耗”被降到了最低。
消融实验:每一个设计都不可或缺
论文通过大量消融实验,像解剖麻雀一样验证了每个组件的有效性。
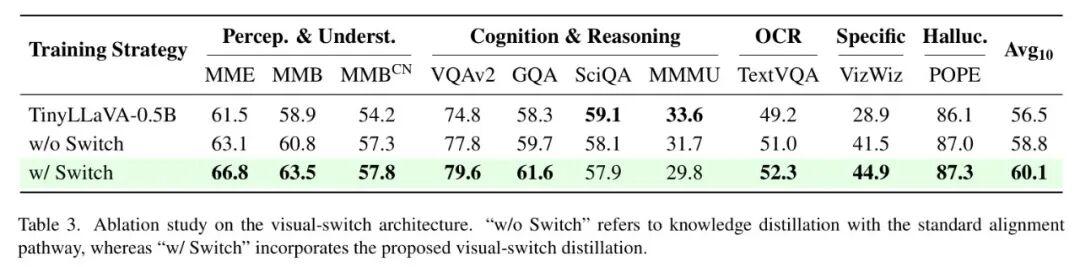
1. 视觉切换机制有多重要?
直接看图,移除切换机制(w/o Switch)后,模型性能全面下降,尤其是VizWiz(面向视障人士的真实场景)任务暴跌3.4分。这说明视觉切换路径对于迁移教师在困难视觉条件下的鲁棒性至关重要。
2. DBiLD损失是不是更好?
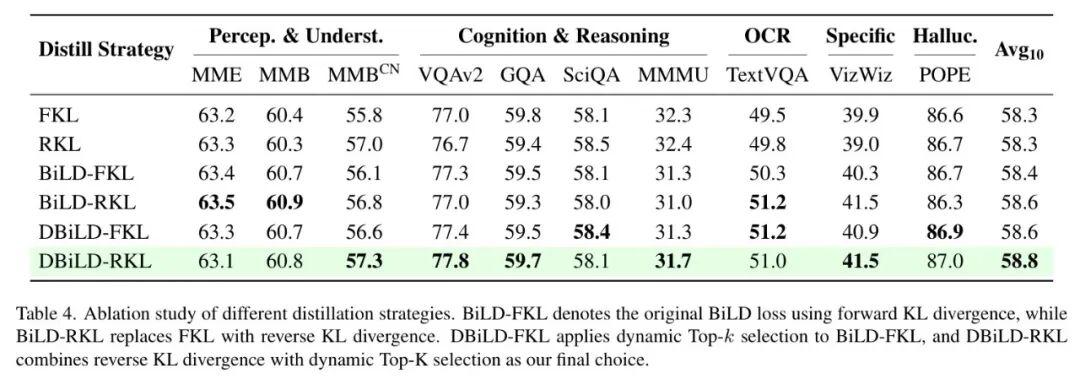
作者对比了多种损失函数,从传统的FKL、RKL,到双向的BiLD,再到动态的DBiLD。结果清晰表明,DBiLD-RKL(动态+反向KL)的组合效果最佳,比基础FKL高出0.5分。动态选择与反向KL的聚焦效应功不可没。
3. 应该在哪个训练阶段蒸馏?
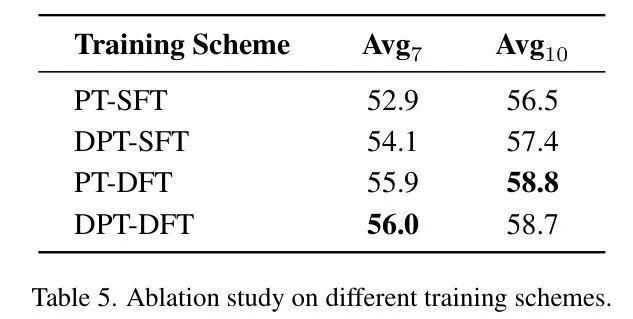
实验发现,在预训练(PT)阶段加入蒸馏收益有限,而在指令微调(DFT)阶段进行蒸馏收益巨大(提升2.3分)。这符合直觉:在模型已经具备基础对齐能力后,再模仿教师的“高级思维”更有效。Switch-KD采用了高效的PT-DFT两阶段模式。
4. 教师模型越大越好吗?
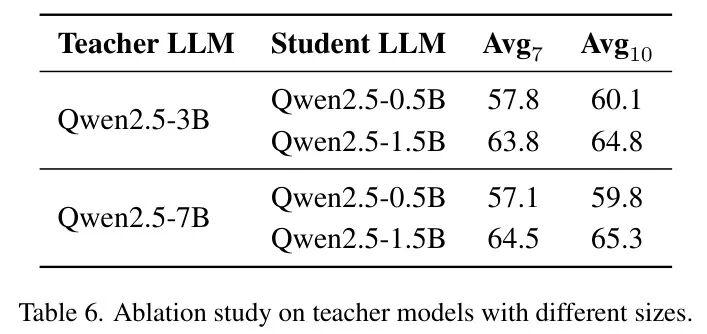
通常是的,但也有极限。当学生是1.5B时,教师从3B增大到7B,学生性能继续提升。但当学生只有0.5B时,用7B教师反而效果微降。这说明 “教”和“学”要匹配,学生容量太小,可能无法完全吸收超大教师的全部知识。
可视化对比:注意力告诉我们真相
最后,我们通过最直观的热力图来看看Switch-KD学到了什么。下图对比了不同方法下,模型对同一张图像的注意力聚焦区域。
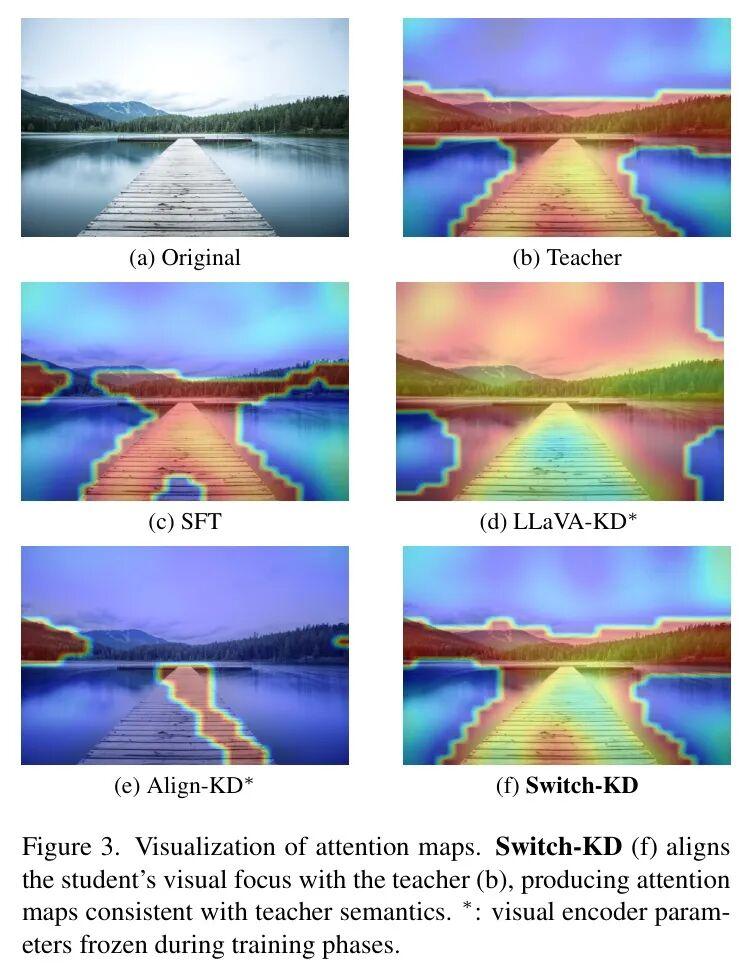
可以看到,仅用SFT微调(c)的模型注意力分散。其他蒸馏方法(d,e)有所改善,但只有Switch-KD(f)的注意力图与教师(b)高度一致,都聚焦在木栈道、水面和山体等语义关键区域。这生动地证明,通过视觉切换路径,学生真正学会了 “像老师一样去看”。
🤔 互动时间:看到这里,你觉得这种“统一概率空间蒸馏”的思路,除了VLMs,还能扩展到其他多模态任务(如音频-语言)上吗?欢迎在评论区分享你的见解!
⚖️ 客观评价与未来展望
Switch-KD无疑为VLM的轻量化部署提供了一套强大且优雅的解决方案。但其仍有可改进之处:
- 架构依赖:目前要求师生模型结构相似(尤其是投影层和词汇表),这限制了其在异构模型间蒸馏的灵活性。未来可能需要引入适配器(Adapter)来解耦这一限制。
- 计算开销:虽然推理时学生模型很轻量,但训练时需要同时运行教师模型的两条前向路径(标准+视觉切换),计算成本仍不可忽视。
- 潜力挖掘:当前工作主要聚焦于蒸馏的“有效性”,未来可以进一步探索其“可解释性”,例如可视化分析视觉切换路径究竟传递了何种类型的视觉知识。
🌟 总结与行动号召
回顾全文,Switch-KD的成功源于两个根本性突破:
- 范式转变:从“多模态分离监督”转向 “统一文本概率空间蒸馏” ,找到了知识融合与传承的天然场所。
- 机制创新:通过 “视觉切换” 实现隐式视觉对齐,通过 “动态双向对数差” 实现精准分布匹配。
这套方法不仅显著提升了小模型性能,其思想更启示我们:解决复杂问题(多模态对齐)有时需要跳出固有框架,到更高层次的抽象空间(概率分布)中去寻找答案。
🌟 最后互动:你认为Switch-KD这项技术,最快会落地在哪个实际场景?是手机端的视觉助手、嵌入式设备的视觉质检,还是其他领域?欢迎在评论区留下你的观点!
💝 如果这篇硬核解读让你有所收获,请务必点个「赞」和「在看」,支持原创技术深度内容!
🔄 分享给你身边正在为模型轻量化发愁的同事或伙伴,一起探讨AI部署的最前沿。
#AI技术 #深度学习 #模型压缩 #知识蒸馏 #多模态大模型 #论文解读
参考
Switch-KD: Visual-Switch Knowledge Distillation for Vision-Language Models