VLMs能看懂K线吗?多周期K线图数据集与标准化评估框架
“Do VLMs Truly "Read" Candlesticks? A Multi-Scale Benchmark for Visual Stock Price Forecasting”
本研究构建多周期K线图数据集与标准化评估框架,以检验视觉语言模型(VLMs)利用多尺度视觉市场信号的能力。
实验表明,XGBoost稳定性和平均排名能力优,部分VLMs在特定领域有潜力:Claude-sonnet-45(thinking)预测价格方向和收益排名能力强,整体表现最佳。Qwen方向预测平衡且排名能力强。Gemini2.5-flash方向预测最平衡。
【 扫描文末二维码加入星球获取论文 】
摘要
VLMs 可以基于K线进行股价预测,但现有基准难以评估其对K线股价的理解。一是无法分离 VLMs 对视觉股价输入的理解,不清楚视觉输入是否提升预测表现及 VLMs 是否真懂K线模式。二是现有数据集和评估围绕单期或表格输入,难以系统评估 VLMs 整合短期和长期视觉市场动态的能力。
本文为此构建多尺度K线数据集和标准化评估框架,结合混淆矩阵诊断和信息系数时间序列指标,以 XGBoost 为基线。实验表明多数 VLMs 仅在持续涨跌条件下表现好,常见市场场景预测能力弱,还存在预测偏差和对预测期限敏感度低的问题,显示其精确时间推理存在局限。
简介
人工智能发展下,VLM在金融尤其是股价预测有潜力,基于K线图预测是其金融应用关键,但现有评估基准难测其对股价信息的真实理解。
然而,主流多模态数据集难判断模型是理解图表还是依赖文本信号,且缺严格消融实验。忽视多时间尺度分析方法,限制对VLM能力的综合评估。
本研究构建含日、周K线图及预测目标的数据集样本,消除多模态混淆偏差。采用多维评估框架,引入二维混淆矩阵分析。进行细粒度分析,为理解多模态预测机制和优化交易策略提供支持。
相关工作
传统股价预测方法
股票价格预测是金融研究核心。传统统计模型(如 ARIMA)适用于短期预测,难处理复杂非线性关系。机器学习方法(XGBoost、LightGBM)通过特征工程提升性能,但易过拟合。深度学习带来新可能,ARIMA 有趋势预测作用,混合 ARIMA - LSTM 更优。图像法将 K 线图作视觉输入,CNN 可增强学习、挖掘隐藏模式,但现有方法需数据或图像结构化处理,无法像人类交易员直接从 K 线图提取有效信息预测。
图像应用与挑战
近年来金融图像广泛用于预测任务,但现有研究多采用复杂多模态数据集,阻碍能力归因分析。典型研究将图像与多信息源结合,如Karadaş等纳入推文指标、Xu等提供多种数据、Huang等用金融知识结合图像、Prado等编码烛台图。虽准确率高,但无法确定性能源于视觉理解还是文本信息,且大多缺乏分离模态贡献的消融实验,视觉理解能力成“黑箱”。
多时间尺度分析方法
多时间尺度分析是技术分析核心方法。经典理论如道氏理论区分不同趋势,艾略特波浪理论描绘嵌套结构。现代系统采用多周期确认机制。深度学习中有多尺度建模,但主要针对表格数据。现有研究缺乏对视觉语言模型(VLMs)多周期图表视觉整合的系统评估,且未明确模型是否真正学会分层推理。
数据集
本文构建多尺度 candlestick 图表数据集,原始市场数据来自 TuShare(中国 A 股 HS300 成分股 2015 年 1 月 - 2025 年 7 月数据)和 Yahoo Finance(同期美国 S&P500 指数成分股数据)。
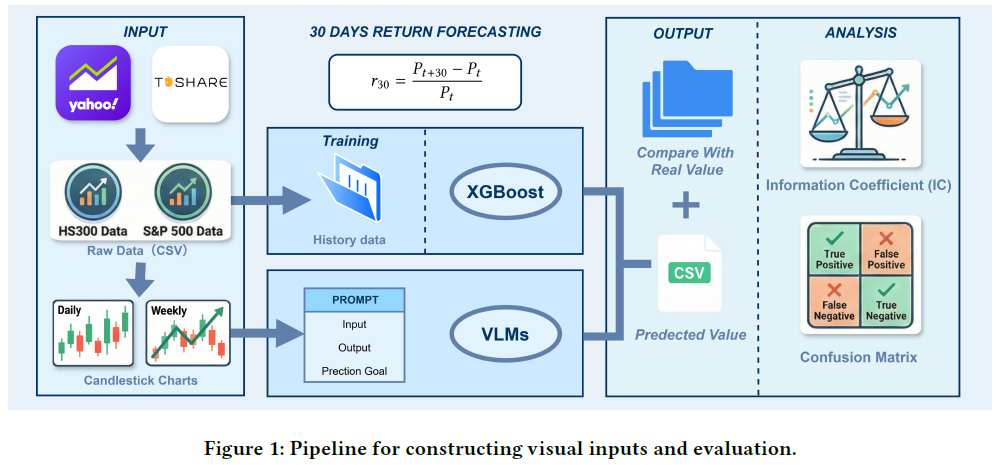
基于历史 OHLCV 记录构建的多周期 candlestick 图表数据集用于 VLM 实验,相同数据经处理形成数值模态用于数值实验。
数据访问遵循数据提供商服务条款,用于学术非商业研究,仅含公开市场信息,无个人敏感数据。
原始市场数据(OHLCV)
原始 OHLCV 时间序列仅做最小预处理,以保留市场动态、避免早期引入特定偏差,视觉和数值表征的模态相关处理后续分述。以收盘价序列定义未来收益为目标变量,重点关注 30 日远期收益。
所有原始 OHLCV 记录及对应未来收益值汇总成统一 CSV 文件,作为后续分析评估的通用数值数据源。
视觉模态数据处理
为构建数据集视觉模态,按统一确定流程从原始OHLCV时间序列生成多时间尺度的K线,步骤为:重构配置参数与数据形成股票专属数据框。计算多频率K线数据及移动平均线。选指定频率数据可视化。按预设截止日期截断时间序列。显示K线最多 50 个。渲染并保存为 PNG 图像。图表含K线、移动平均线和成交量子图,表头有股票符号、时间框架和截止日期。不同时间尺度市场模式有别,如某股日、周K线分别呈上升、下降趋势,其 30 天实际未来回报为负。
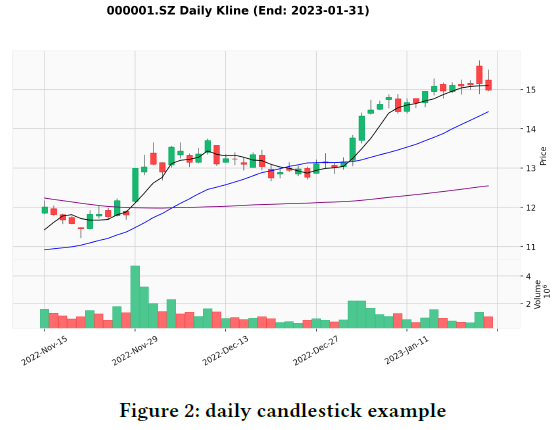
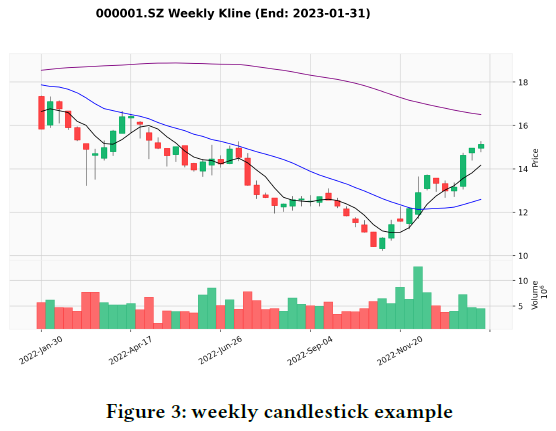
生成的K线按层次目录结构组织,顶层按截止日期索引,二层为股票代码,各股票目录下按不同时间频率分开存储,便于多时间尺度分析。
评估30天回报预测时,按30天间隔采样K线,此策略简化输入与结果的时间关系,方便评估。虽非必要,但更合理,短间隔会增加成本、引入冗余和强相关性。
该数据组织和采样策略构建了结构化、可扩展、可解释的视觉输入管道,平衡多方面因素,为后续基于VLM的评估提供稳定基础。
数值时间序列数据处理
除视觉模态外,构建数值时间序列输入支持基线模型,确保跨模态公平比较。数值特征与视觉数据的截止日期和未来回报标签严格对齐。
数据统计
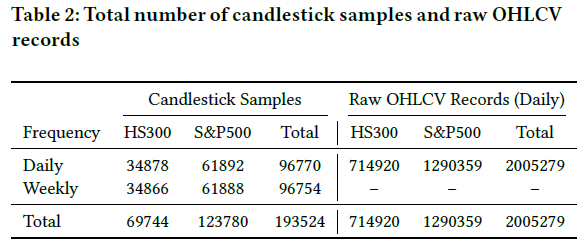
2015 - 2025年历史股票数据构建同期K线图,选HS300指数300只、S&P500指数500只成分股,生成32个截止日期的日、周K线图,表2总结数据集统计信息。
与现有数据集的比较
表3对比本数据集与用于时间序列或金融预测的代表性数据集。现有数据集多关注文本和数值信号,如FNSPID整合新闻文本与高频价格序列,TimeMMD提供含非图表数据图像输入的通用时间序列基准,均无K线且不支持技术图表结构推理。FinMultiTime是唯一含K线图像的数据集,但将其作辅助输入,不评估模型对图表结构的视觉理解和跨尺度一致性。
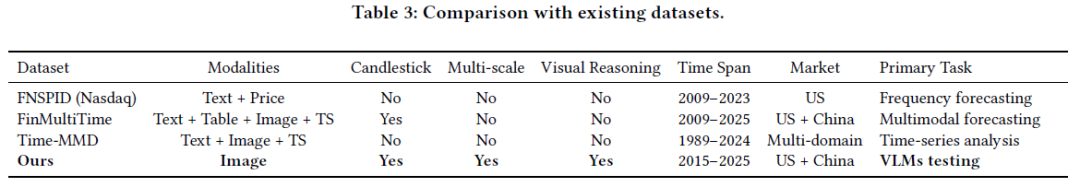
本数据集将K线作为一级视觉输入,支持多尺度K线表示,旨在评估视觉语言模型对金融图表的推理能力,是首个以多尺度K线视觉推理为主要评估目标的数据集。
基准测试任务
任务定义
研究将股票趋势预测定义为基于K线图可视化分析的收益回归预测问题。
输入:每个样本包含同一股票同一日期的日K线图和周K线图,用于区分“趋势内回调”与“趋势反转”,测试VLM整合视觉与文本信息的能力。
输出:连续值预测 r^∈[−0.5,1.0] 对应预期未来收益,选回归而非分类的原因包括保留完整信息、与分类评估兼容、贴近投资决策场景,范围覆盖超99%实际情况,允许 r^=0 表示“趋势不明”。
预测目标:计算30天远期收益率 r30,30天窗口处于技术分析有效“最佳区间”。
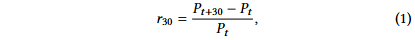
提示工程
将抽象回归预测任务转化为视觉分析指令,设计结构化提示。
角色定义与任务说明:定义模型为“股票趋势分析师”评估“价格波动幅度”,强调无偏,以两期K线为输入,按公式定义 30 天未来回报。
多维分析框架:采用多维技术分析框架预测 30 天股票回报,包括分解K线、分析移动平均线、进行成交量分析、检测拐点及关联不同时间信号。
输出约束与少样本学习:规定输出格式为[-0.5, 1.0]内的数值,保留三位小数并加标签,无额外文本。避免系统偏差,依据技术信号预测。提供少样本示例辅助校准。
评估指标
混淆矩阵:在股价预测中,TP、TN、FP、FN 有明确含义,TP 率反映捕捉上涨机会能力,FP 率反映误判率,还有准确率、召回率、精准率、特异度、F1 等指标,具体公式见 5.1.2。
IC(信息系数):衡量预测值与实际回报的线性相关性,均值 IC 体现平均预测能力,中位数 IC 体现预测稳定性,ICIR 衡量风险调整后的预测能力,显著 IC 比例体现预测有效性频率。Rank IC 用斯皮尔曼等级相关,更抗异常值,Rank ICIR 等与 IC 类似,适用于评估相对强度判断能力。
“偷看”实验
实验选取同产品线不同发布日期的 GPT4o - 2024 - 05 - 13 和 GPT4o - 2024 - 1120 两模型,在 2024 年 5 月 14 日至 11 月 19 日预测 30 天未来回报,以实际结果评估。两模型 IC 等指标相近,无后发布模型显著优于先发布模型的“偷看”模式,表明所选 VLMs 未用发布后实际股票数据提升预测表现,为结果可解释可靠性提供初步实证。
实验结果
研究测试窗口为2023.01.01 - 2025.01.01,多数模型以HS300为股票池评估,在标普500指数也测试过的模型用括号标记以体现跨市场验证。
分类性能分析
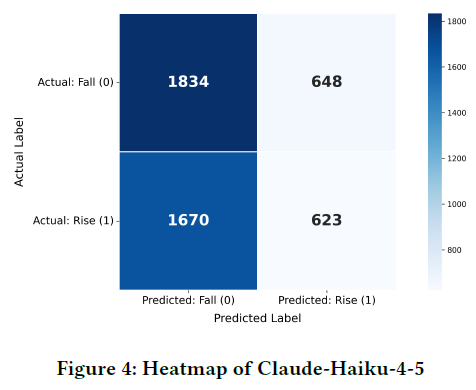
表4左部分呈现所有模型的混淆矩阵统计,图4展示最佳模型Claude-haiku-4-5的混淆矩阵热图。
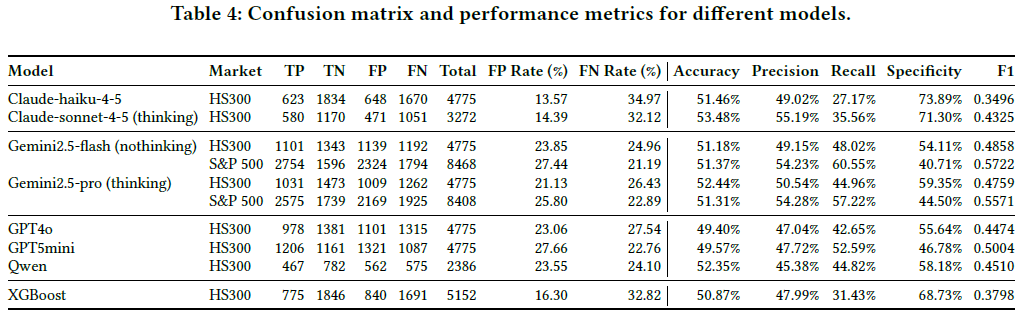
基于混淆矩阵可计算准确率、精度、召回率、特异性和F1分数,表4右部分展示各模型在这些指标上的表现,并给出相关计算公式。
不同模型契合不同投资理念,Claude-Haiku高精度适合保守策略,GPT5mini高召回适合激进策略,模型选择应匹配风险偏好而非追求通用优化。
预测偏差分析
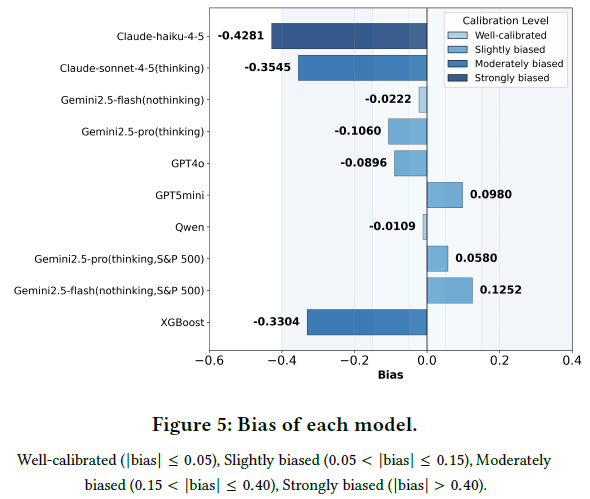
模型校准评估预测与真实分布的一致性,采用分布偏差(Bas)为校准指标,正偏差表示模型高估上涨概率,负偏差表示低估。图 5 展示各模型偏差值与校准等级。不同架构模型偏差差异大,传统机器学习和大语言模型有不同偏好,原因待究。利用这种异质性构建集成系统,通过互补偏差抵消来提升金融预测的稳健性。
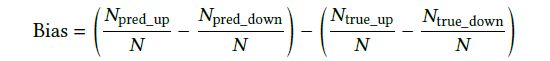
信息系数分析
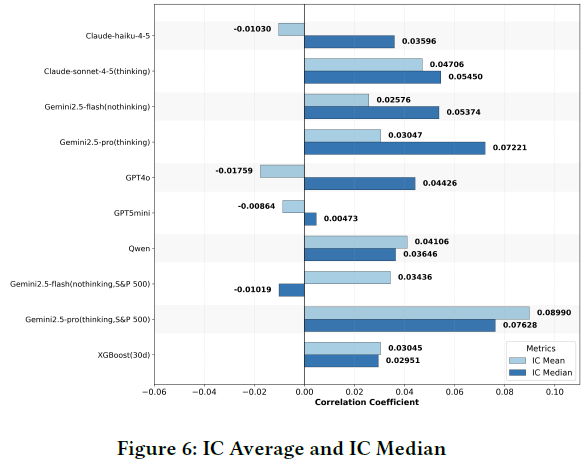
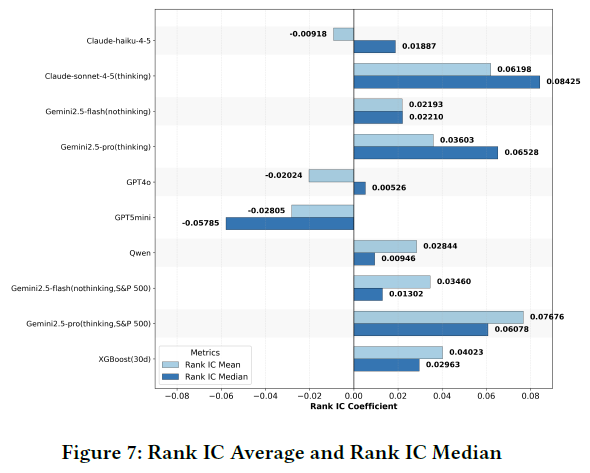
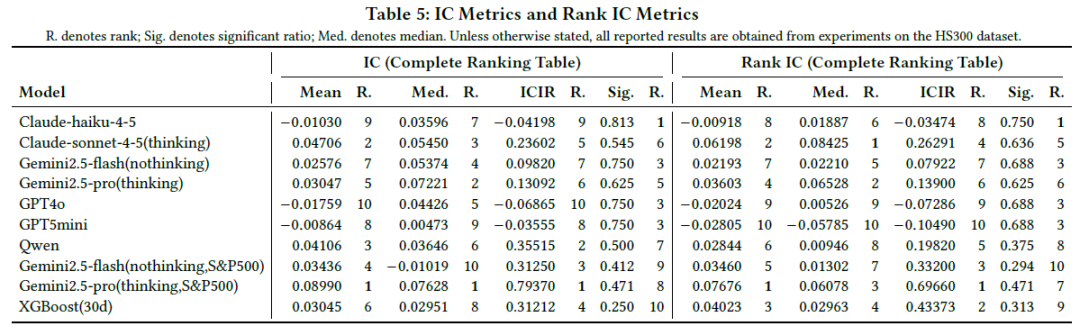
信息系数(IC)衡量预测与实际回报的相关性,是评估预测能力的核心指标,与注重方向判断的准确率不同,它反映模型预测回报幅度的能力,对投资组合优化和风险管理很重要。图6、图7和表5展示了不同模型的IC和Rank IC系列指标。
极端条件下的性能
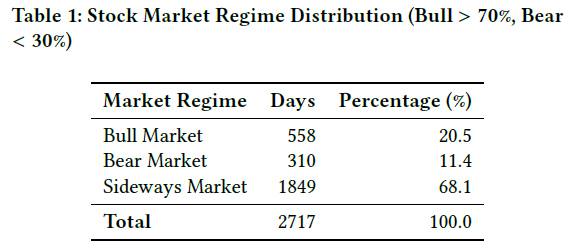
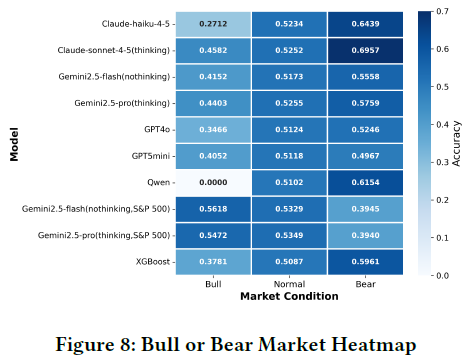
牛熊市场表现:交易日中,涨股比例>70%为牛市,跌股比例>70%为熊市。正常市场各模型表现差异不大(50.9%-52.6%),极端市场有分歧,各模型在熊市准确率更高,更擅识别下行风险,Qwen因测试期无牛市实例表现为零,这种不对称能力为投资者选模型提供依据。
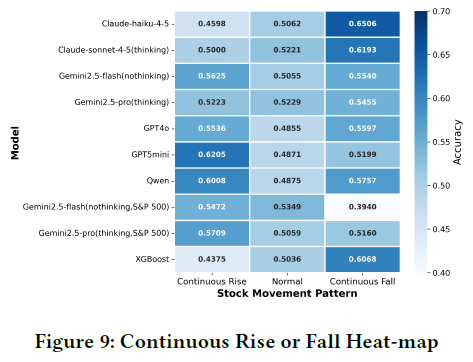
极端股票案例分析:测试期内,个股涨日比例>70%为连续涨,跌日比例>70%为连续跌。各模型对极端股票预测准确率不同,Claude - Haiku识别下跌股表现最优,GPT5mini捕捉上涨趋势能力强,XGBoost对上涨股预测准确率最低(43.8%),这种差异为构建模型投资组合策略提供基础。
时间敏感性分析
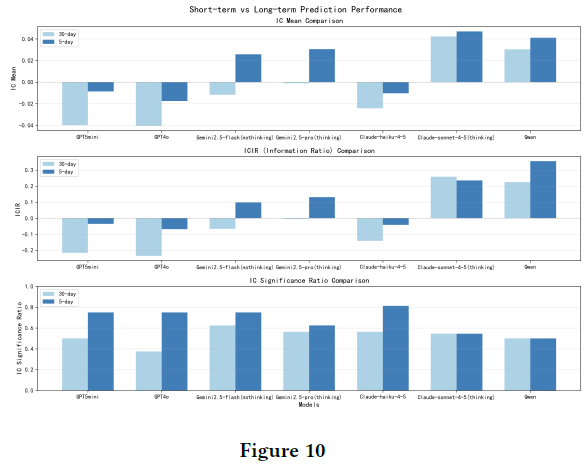
IC分析显示,虽模型被要求预测30天回报,但与5天实际回报相关性更高,表明当前VLMs主要捕捉短期市场信号,存在长期预测的根本局限。如Claude-Sonnet-4-5的5天IC为0.047(ICIR:0.236),30天IC为0.042(ICIR:0.258)。这或因VLMs擅抓训练数据中的短期技术模式,难进行长期基本面推理和处理累积不确定性。VLMs更适合作为短期交易信号辅助工具,而非长期投资决策主要支撑。
讨论
多尺度K线分析结合结构基本面与动态价格行动,但存在延迟问题,虽滞后确认周期,仍优于表格数据。
经验显示,视觉语言模型(VLMs)比XGBoost有更高IC/Rank IC显著性、更高中位数IC,预测更稳定、尾风险失败少且优化空间大。
原因在于视觉表征有结构优势,表格格式以数值向量编码序列,需纯统计发现时间规则。K线将领域结构外化为视觉语法,VLMs可转移视觉先验,规避表格模型的稀疏数据约束,体现架构对齐差异。
总结
本研究构建多周期K线图数据集与标准化评估框架,以检验视觉语言模型(VLMs)利用多尺度视觉市场信号的能力。该数据集解决现有数据集复杂度过高、多周期尺度重视不足的问题,构建最小数据集,样本含日、周K线图及对应目标值,保持市场趋势、个股行为模式多样性与样本分布均衡。研究测试7种商用VLMs,基于混淆矩阵和IC系列指标评估。
实验表明,XGBoost稳定性和平均排名能力优,部分VLMs在特定领域有潜力:Claude-sonnet-45(thinking)预测价格方向和收益排名能力强,整体表现最佳。Qwen方向预测平衡且排名能力强。Gemini2.5-flash方向预测最平衡。未来将在该数据集上评估更多金融概念,优化模型训练,深入研究VLMs对K线图的理解。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
