腾讯发布HY-World 2.0|10分钟生成3D世界,开源SOTA来了
还在为无法从一张图或一句话生成可交互的3D世界而头疼吗?HY-World 2.0 来了!它不仅将生成与重建两大3D任务首次在开源世界统一,更用一套四阶段流水线,让AI从“想象”到“构建”3D世界的效率与质量双双刷新SOTA。今天,我们带你彻底拆解这个“多模态世界模型”的硬核内核,看看它如何仅凭文本或单图,就为你打造一个可漫步、可交互的沉浸式三维空间。
图:HY-World 2.0框架从文本/图像生成3D世界、进行世界重建、并赋能机器人仿真、游戏开发等广泛下游应用
❓ 核心痛点:为什么3D世界生成与重建如此之难?
想象一下,你给AI一段文字描述:“一座雪山下的静谧小屋”,它能否立刻为你生成一个可以走进去、环顾四周、甚至“触摸”墙壁的3D场景?或者,你拍了一段室内视频,能否快速重建出一个精确的、带物理碰撞的3D模型?这背后是两大长期割裂的挑战:
- 生成与重建的“分水岭”:传统方法要么专注于从文本/单图生成惊艳但几何可能失真的3D内容,要么执着于从多视图重建精确但缺乏想象力的3D结构。一个天马行空,一个脚踏实地,难以兼得。
- “Sparse输入”的扩展难题:从一张图或一句话出发,要补全360度无死角的整个世界信息,如同管中窥豹。现有方法要么视野狭窄,要么生成的新视角彼此矛盾,无法拼凑成一个连贯、一致的3D整体。
- 效率与质量的失衡:高质量3D生成动辄需要数小时甚至更久;而快速重建又往往在细节和保真度上妥协。如何实现高质量与高效率的平衡,是落地应用的关键瓶颈。
HY-World 2.0的野心,正是要一举攻克这三座大山。它不再将生成与重建视为两个独立任务,而是设计了一套四阶段系统化流水线,让它们协同工作,最终输出一个高保真、可导航、甚至支持物理交互的3D高斯溅射(3DGS)世界。
那么,这套流水线究竟是如何运转的?我们马上进入核心原理的深度拆解。
🏗️ 原理拆解:四阶段流水线,从想象到可交互世界
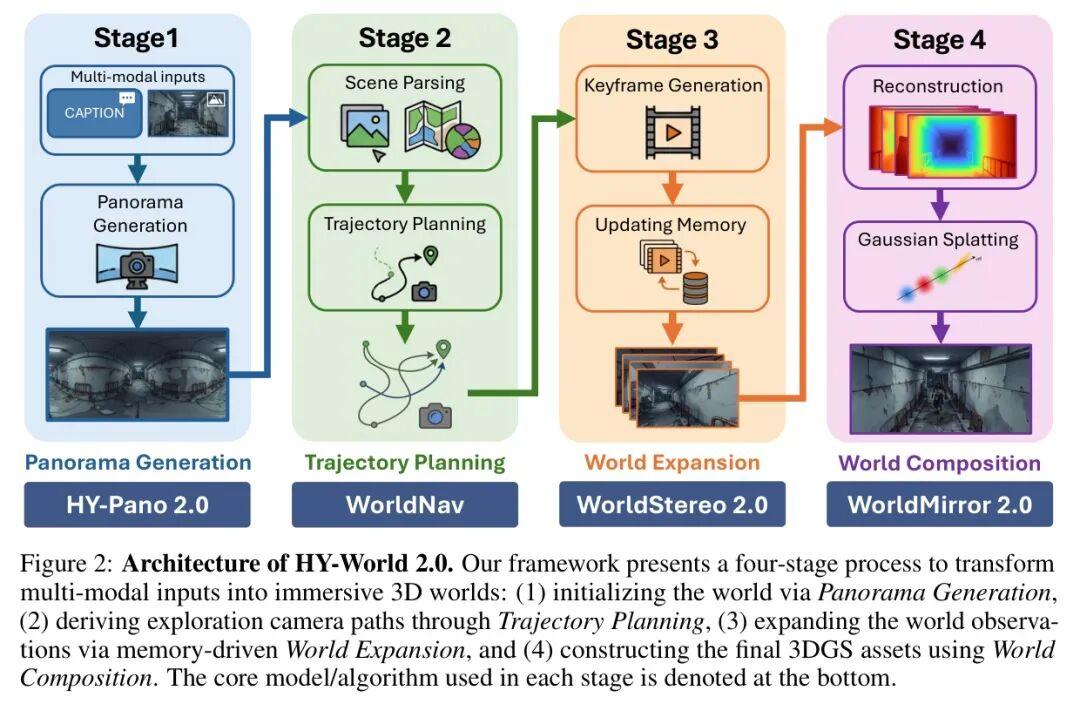
如图所示,HY-World 2.0的工作流清晰分为四个阶段,如同一位3D世界的“建筑师”:
- • 阶段一(全景生成):HY-Pano 2.0将你的文字或图片,转化为一幅高保真的360度全景图,作为世界的“蓝图”。
- • 阶段二(轨迹规划):WorldNav系统解析这张“蓝图”,智能规划出多条无碰撞、覆盖全局的相机运动轨迹,相当于决定好“勘探队”的行走路线。
- • 阶段三(世界扩展):WorldStereo 2.0沿着规划好的路线,生成一系列高保真、多视角一致的关键帧图像,如同拍下沿途所有重要角度的照片。
- • 阶段四(世界合成):WorldMirror 2.0利用这些关键帧,重建出精确的3D几何(点云),并优化为最终的3D高斯溅射场景,完成从“照片”到“实景模型”的构建。
下面,我们来逐一拆解每个阶段的“黑科技”。
💡 阶段一:HY-Pano 2.0 - 从任意输入到无缝全景
传统方法从单张透视图像生成全景图,严重依赖精确的相机参数(如焦距、视野),一旦参数不准或缺失,投影就会失真。HY-Pano 2.0抛弃了这种“硬对齐”思路,转而采用一种隐式学习的策略。
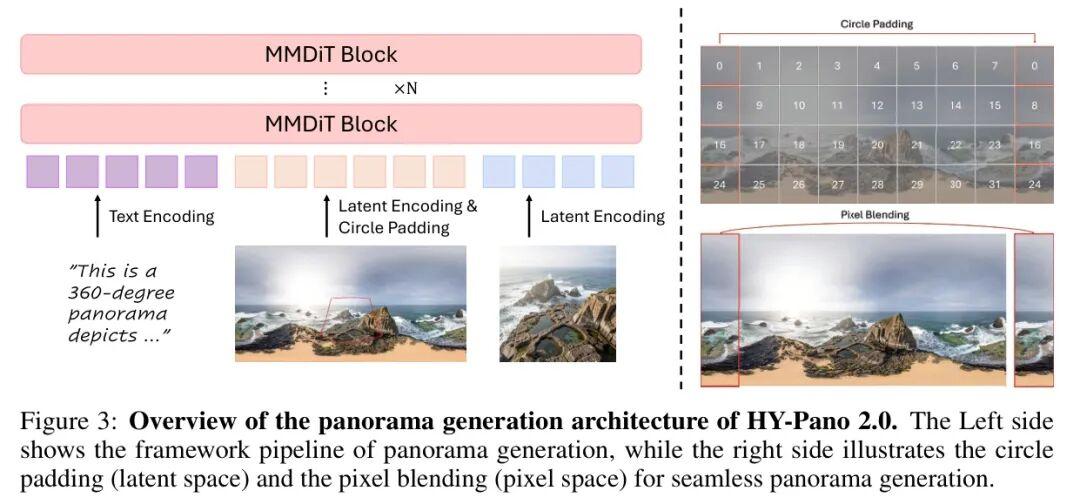
它的核心是一个多模态扩散Transformer(MMDiT)。模型将输入图像(或文本编码)和全景噪声图都在潜空间(Latent Space) 中进行表示并拼接。Transformer的强大注意力机制能够自主学习从透视特征到全景特征的映射关系,无需任何显式的几何标定。这就好比一位经验丰富的画家,看到一张局部素描,就能在脑海中自动补全整个环形壁画的结构。
为了解决全景图左右边缘的接缝问题,HY-Pano 2.0在潜空间编码阶段采用了圆形填充(Circular Padding),强制模型学习周期性的边界条件;在像素空间解码阶段,又进行了像素融合(Pixel Fusion),平滑边缘过渡。这两招结合,确保了生成的全景图在接缝处天衣无缝。
💡 阶段二:WorldNav - 像游戏AI一样规划探索路径
有了全景“蓝图”,下一步就是规划如何“探索”这个世界。目标是为第三阶段生成尽可能多、且信息量最大的新视角。WorldNav不再使用随机或简单的路径,而是像一个智能游戏AI,进行了多模态场景解析。
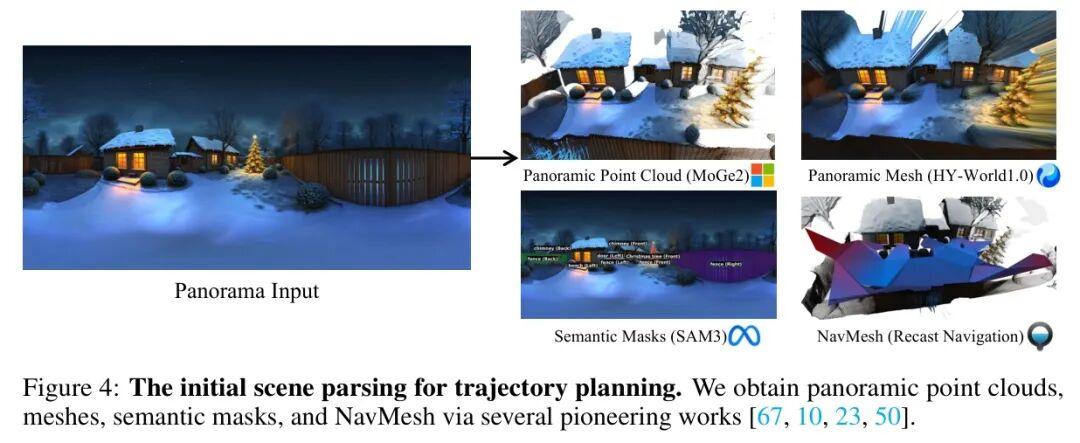
首先,它利用MoGe2等先进工具,从全景图中提取出全景点云和粗糙网格,理解基础几何。同时,用SAM3分割出语义掩码(识别物体),并用Recast Navigation生成导航网格(NavMesh),明确哪里可以走、哪里有障碍。基于这些丰富的结构化信息,WorldNav设计了五种各司其职的轨迹:
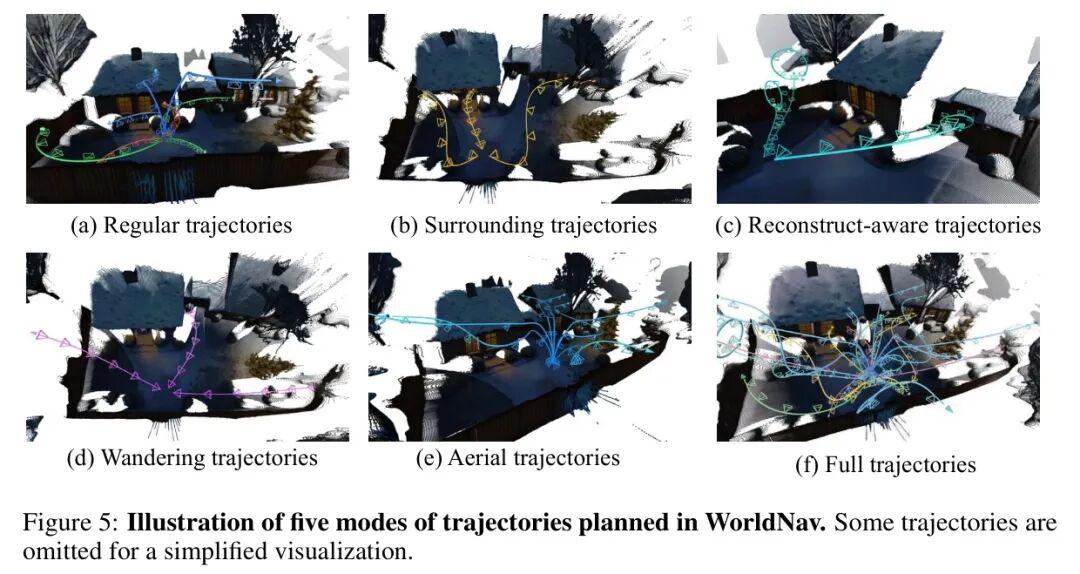
- • 常规轨迹:扩展基础视野,打破固定视角。
- • 环绕轨迹:围绕重要物体(如汽车、房屋)旋转,获取其多角度细节。
- • 重建感知轨迹:主动探测并前往当前几何缺失或模糊的区域进行“补拍”。
- • 漫游轨迹:向场景深处和边界探索,覆盖远距离环境。
- • 空中轨迹:提供俯视的鸟瞰视角,消除高空盲区。
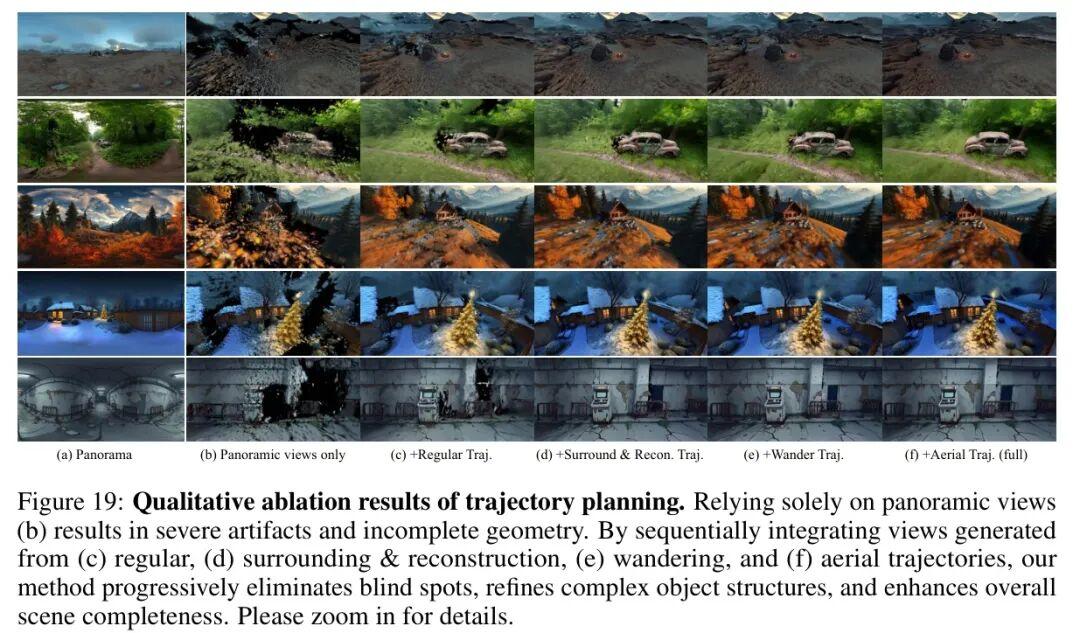
这五种轨迹的协同作用,效果是立竿见影的。从下图的消融实验可以清晰看到,随着更多类型的轨迹被加入,重建出的3D场景完整性显著提升,盲区和伪影被逐步消除。
💡 阶段三:WorldStereo 2.0 - 带“记忆”的关键帧生成器
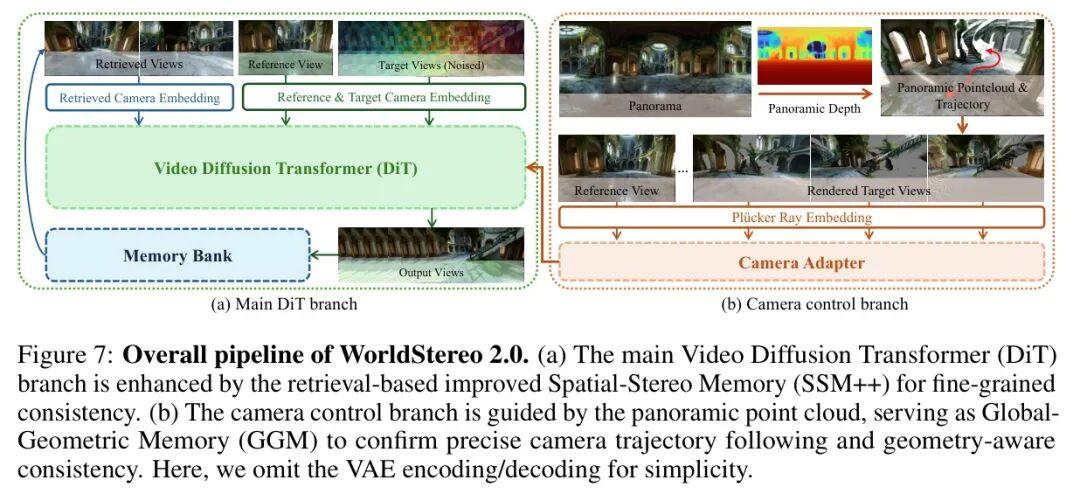
这是连接2D生成与3D重建最关键的桥梁。它的任务是根据规划好的相机轨迹,生成一系列高质量、且在多条轨迹间保持视觉一致性的关键帧图像。为此,WorldStereo 2.0进行了三大核心升级。
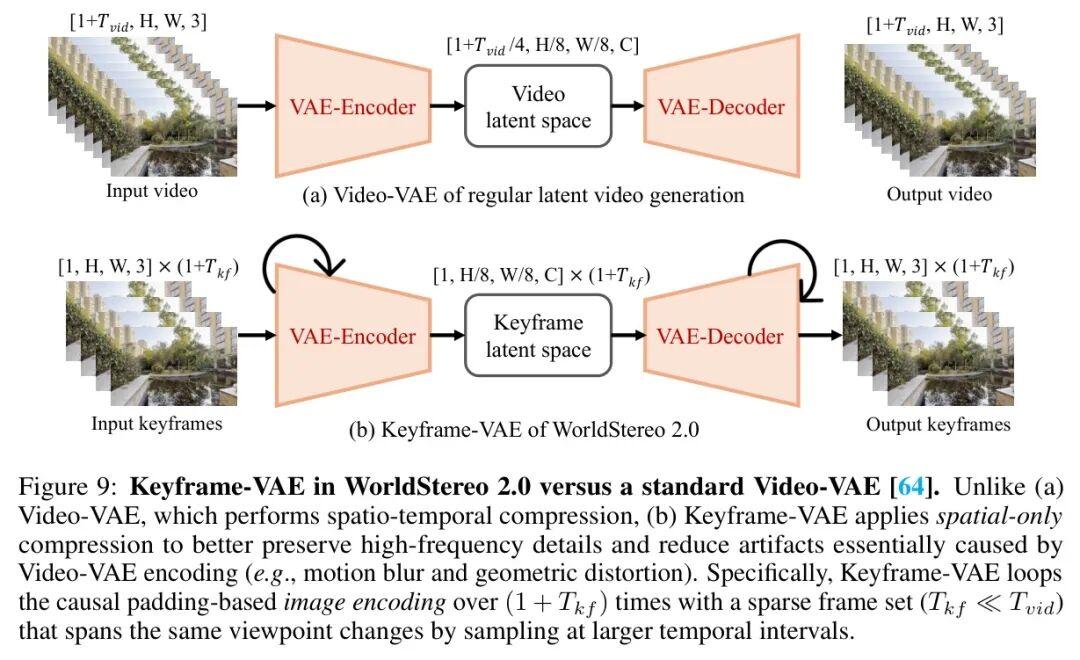
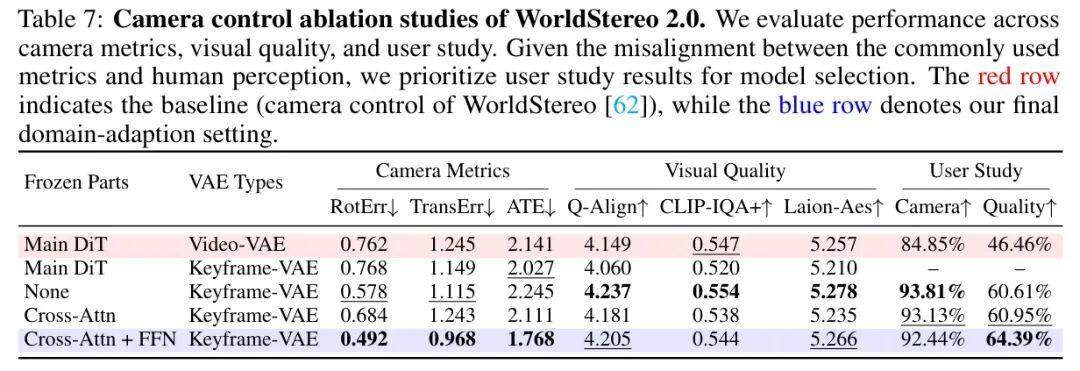
首先,它放弃了传统的Video-VAE。传统方法对视频进行时空压缩,容易导致运动模糊和细节丢失。WorldStereo 2.0创新地使用了Keyframe-VAE,只对稀疏采样的关键帧进行空间压缩,最大限度保留了每一帧的纹理和几何高频信息。
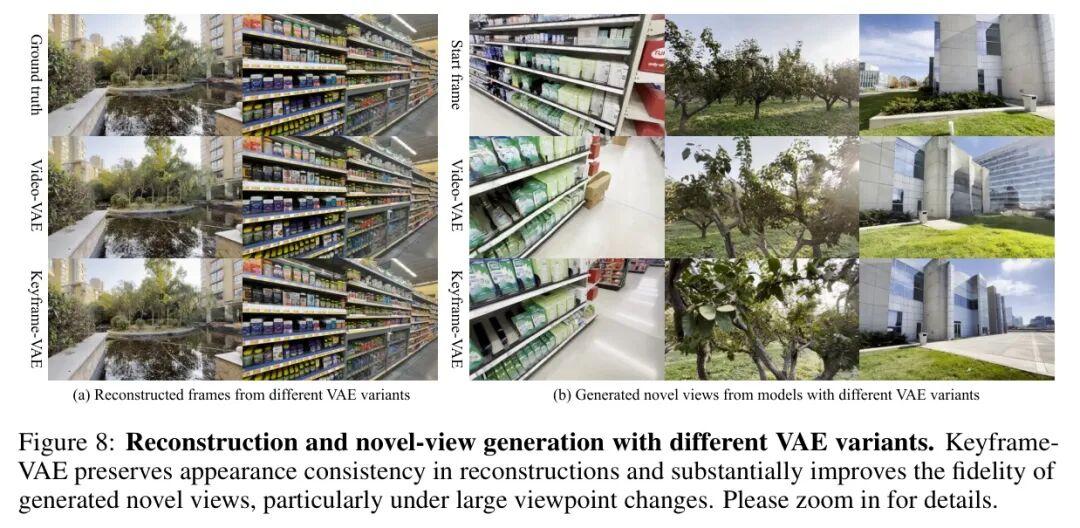
从对比图可以直观看出,Keyframe-VAE重建的图像和新视角生成质量都明显更高。
其次,它引入了强大的“记忆”机制。为了确保在不同时间、不同轨迹下生成的图像属于同一个连贯的世界,模型需要“记住”之前看过/生成过什么。WorldStereo 2.0配备了双重记忆:
- • 全局几何记忆(GGM):利用阶段一得到的全景点云作为全局3D参考,指导生成过程保持大尺度几何结构一致。
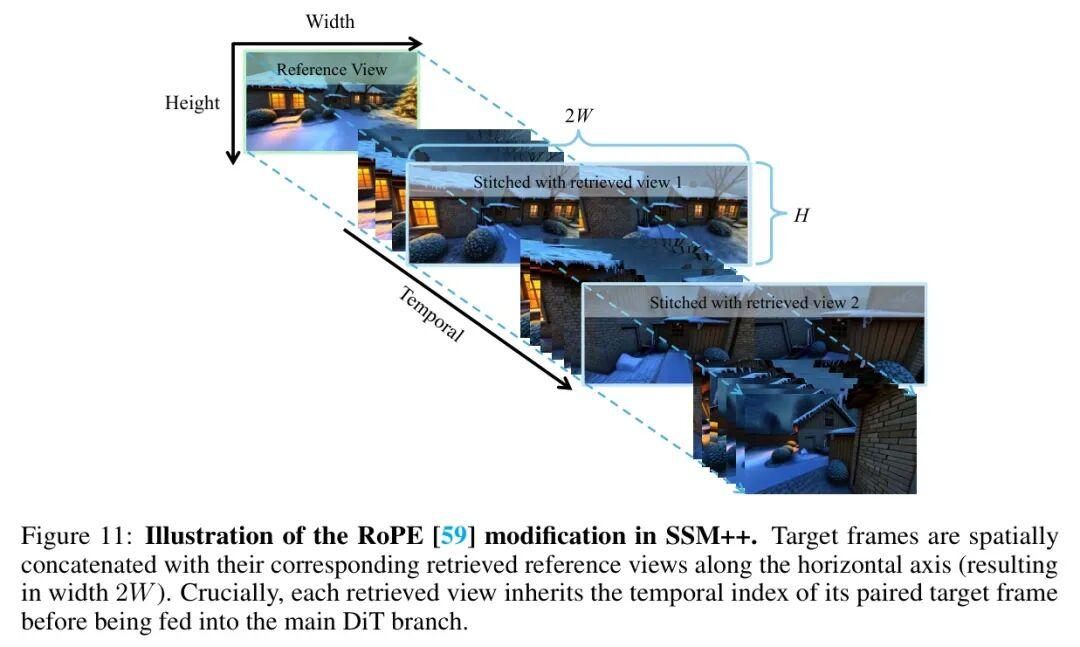
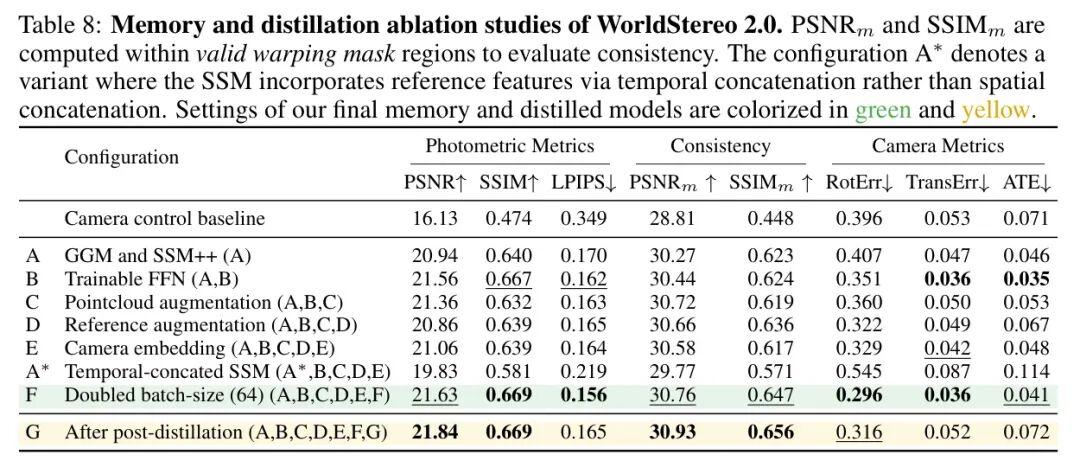
- • 增强的空间-立体记忆(SSM++):在生成当前帧时,主动从“记忆库”中检索最相关的历史帧,通过一种创新的空间拼接方式输入模型,提供细粒度的纹理和细节参考。
SSM++中对RoPE位置编码的修改非常巧妙,它通过将检索帧与目标帧水平拼接,并共享时间索引,让模型能自然地理解两者间的空间对应关系。
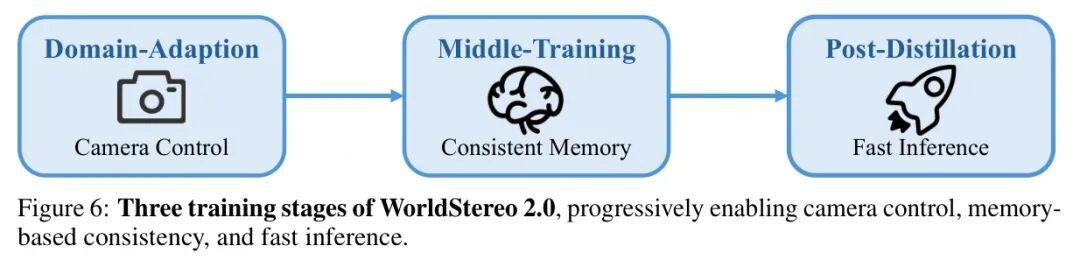
最后,通过知识蒸馏实现快速推理。如此强大的模型如何保证效率?作者在训练的最后阶段使用了分布匹配蒸馏(DMD),将模型蒸馏成一个仅需4步推理的轻量版本,在几乎不损失质量的前提下极大提升了生成速度。
💡 实战思考:这种“关键帧+记忆”的范式,是否为你解决长视频生成中的一致性难题提供了新思路?欢迎在评论区分享你的见解。
💡 阶段四:WorldMirror 2.0 - 统一且高效的多任务3D重建器
这是将2D关键帧“凝固”成3D世界的最后一步。WorldMirror 2.0是一个统一的前馈模型,能同时预测深度、法线、点云、相机参数等多种3D信息。相比前代,它在分辨率泛化、几何一致性和推理效率上取得了飞跃。
1. 归一化位置编码(Normalized RoPE):解决分辨率泛化魔咒
传统Transformer的位置编码(如RoPE)使用绝对位置索引,在训练分辨率外推理时性能会暴跌。WorldMirror 2.0将位置坐标归一化到[-1, 1]区间,将外推问题转化为内插问题。
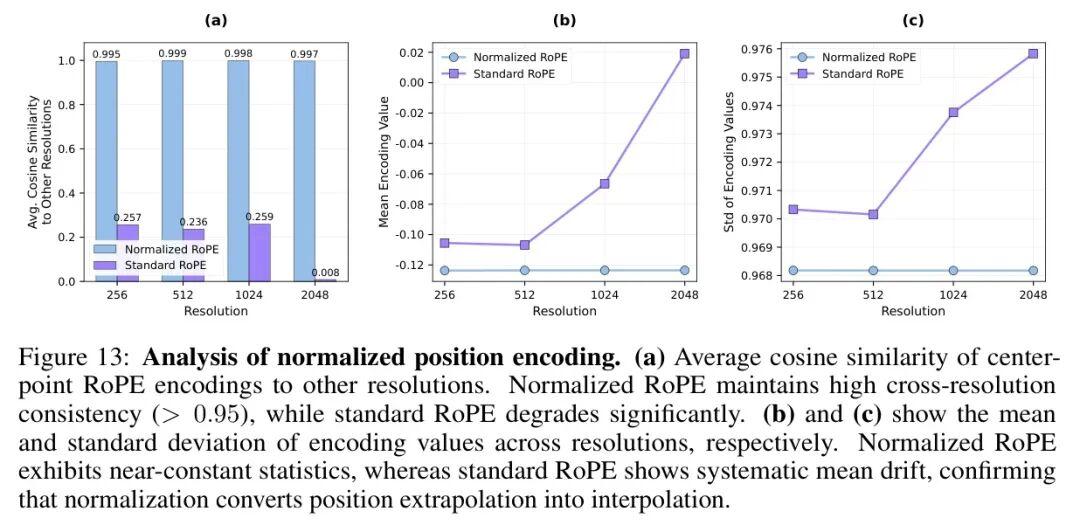
如上图所示,归一化RoPE在不同分辨率下的编码值保持稳定,从而支持模型灵活应对各种输入尺寸,在高分辨率下性能依然强劲。
2. 深度-法线联合监督:让几何更一致
作者创新地增加了深度到法线的损失函数。模型预测的深度图可以通过反投影和求导“推导”出表面法线,这个推导出的法线会被要求与模型直接预测的法线保持一致。这种循环监督极大地增强了深度估计的几何合理性。
3. 极致的推理效率优化
为了处理海量视角(如256视图),WorldMirror 2.0集成了BF16混合精度、Token/帧序列并行(SP)和全分片数据并行(FSDP) 三大策略,使得在4张GPU上处理256视图成为可能,推理时间大幅降低。
拥有了强大的WorldMirror 2.0,世界合成的最后两步就水到渠成:
- • 点云扩展与深度对齐:利用WorldMirror 2.0预测关键帧的深度,并用全景几何进行引导和尺度对齐,融合成稠密的全局点云。
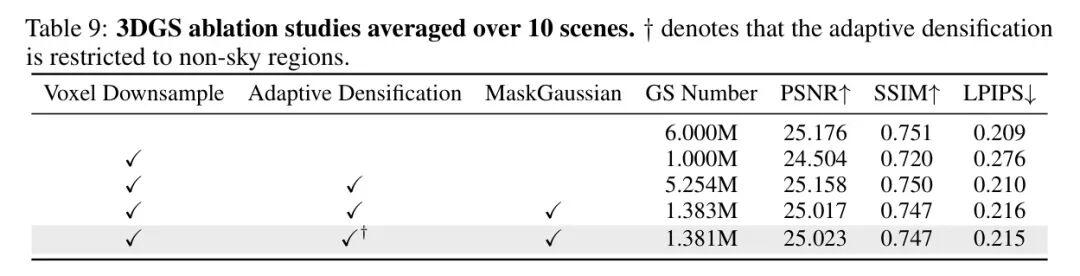
- • 3D高斯溅射(3DGS)优化:以上述点云初始化3DGS,并用生成的所有关键帧进行监督优化。这里还引入了MaskGaussian技术,自适应地剪枝冗余的高斯点,在提升渲染速度的同时抑制漂浮伪影。
至此,一个高保真、可交互的3D世界便诞生了。那么,这套组合拳的实际效果到底有多能打?我们必须用数据和对比来说话。
🏆 实验验证:全面领先,对标顶尖闭源模型
SOTA对比:生成与重建,双料冠军
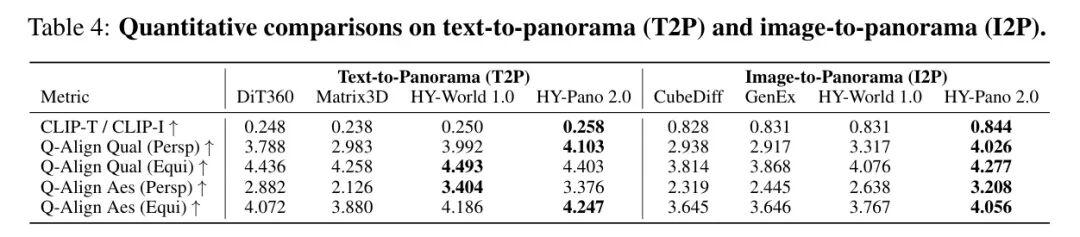
在全景图生成(T2P/I2P) 任务上,HY-Pano 2.0在CLIP对齐度、人类感知质量(Q-Align)等多项指标上全面领先。
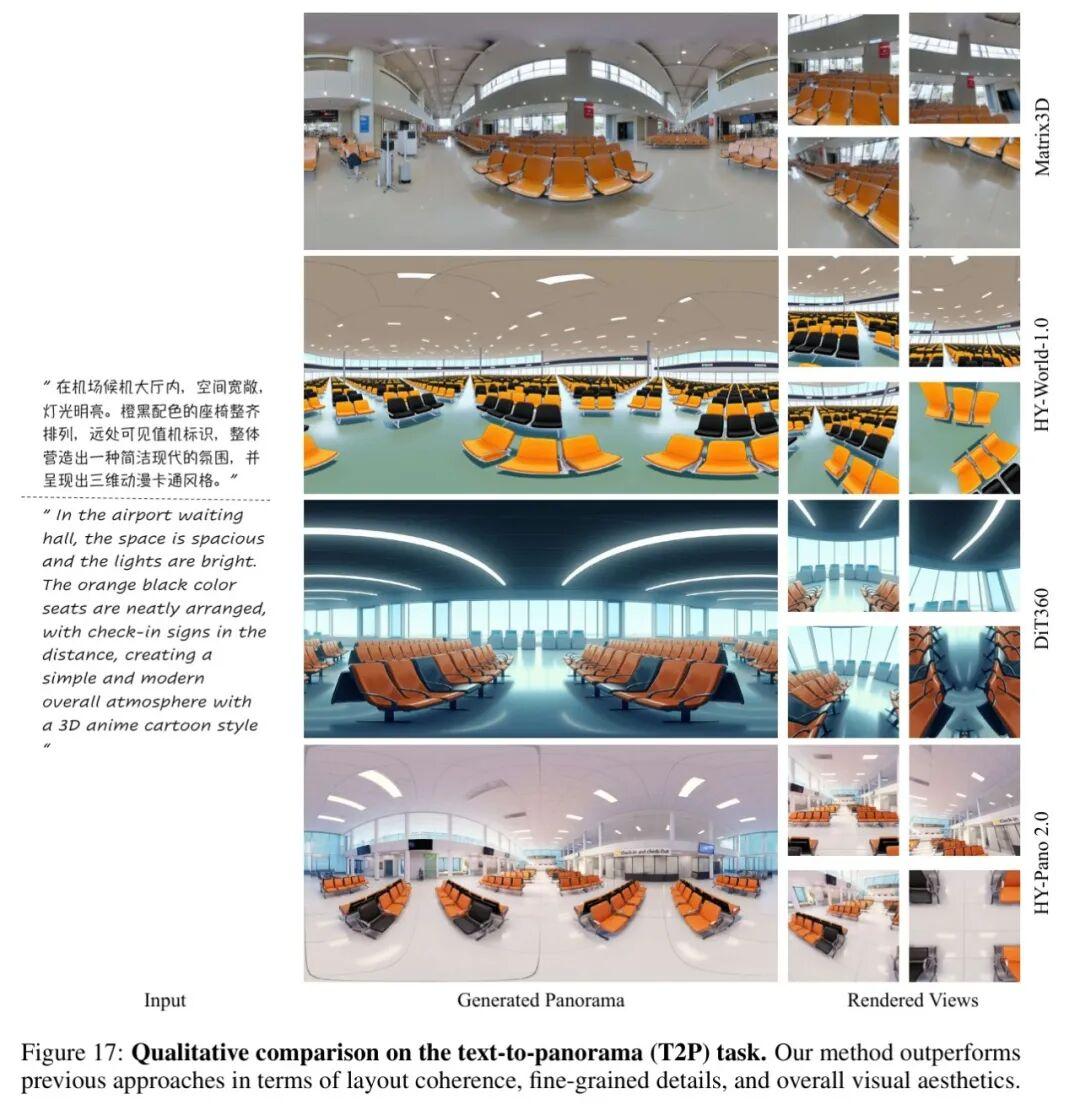
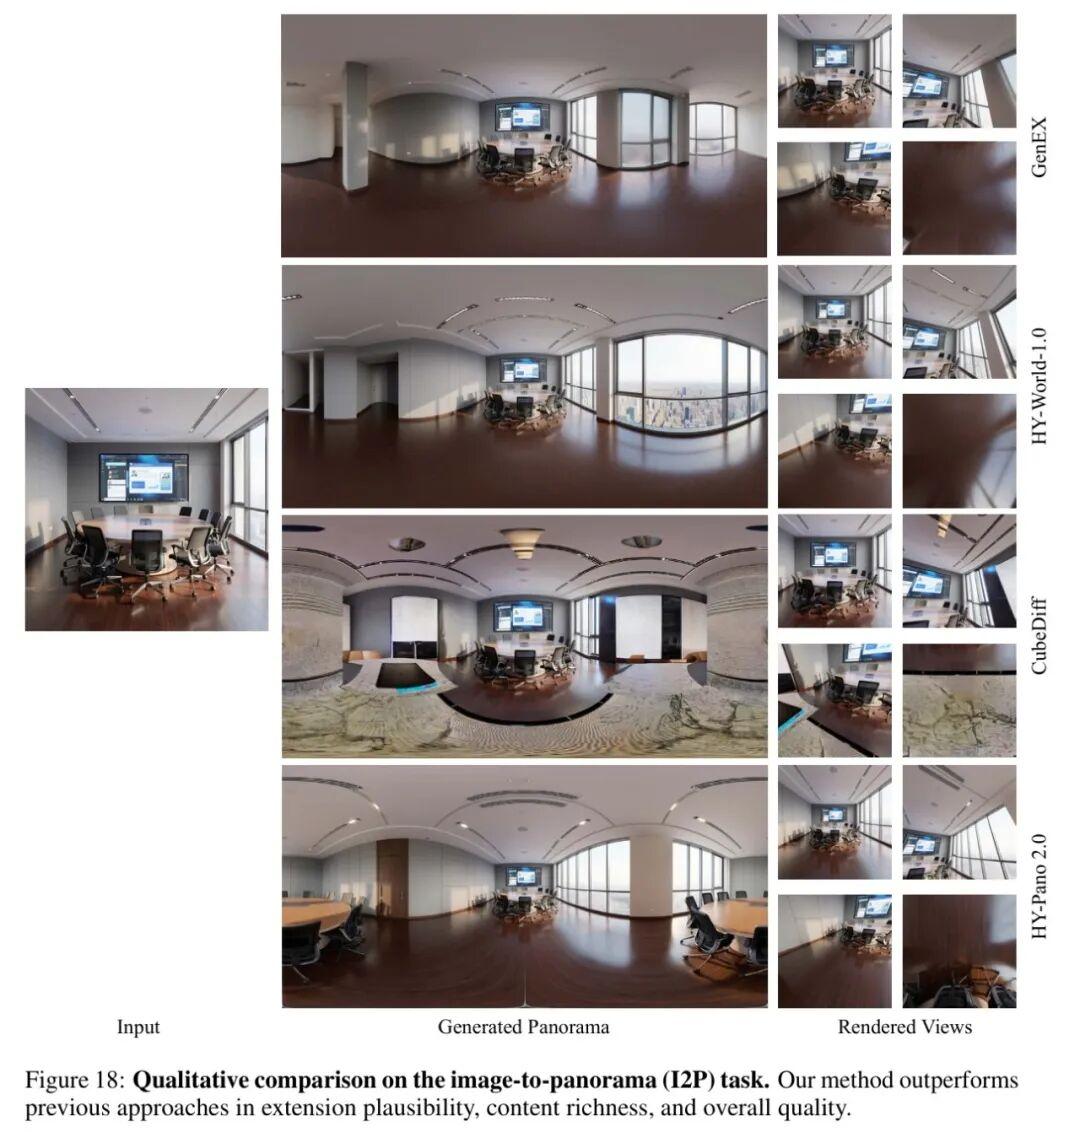
视觉对比更加直观。无论是根据文字生成仙侠场景,还是将单张会议室图像扩展为全景,HY-Pano 2.0在布局合理性、细节丰富度和风格一致性上都远超基线模型。
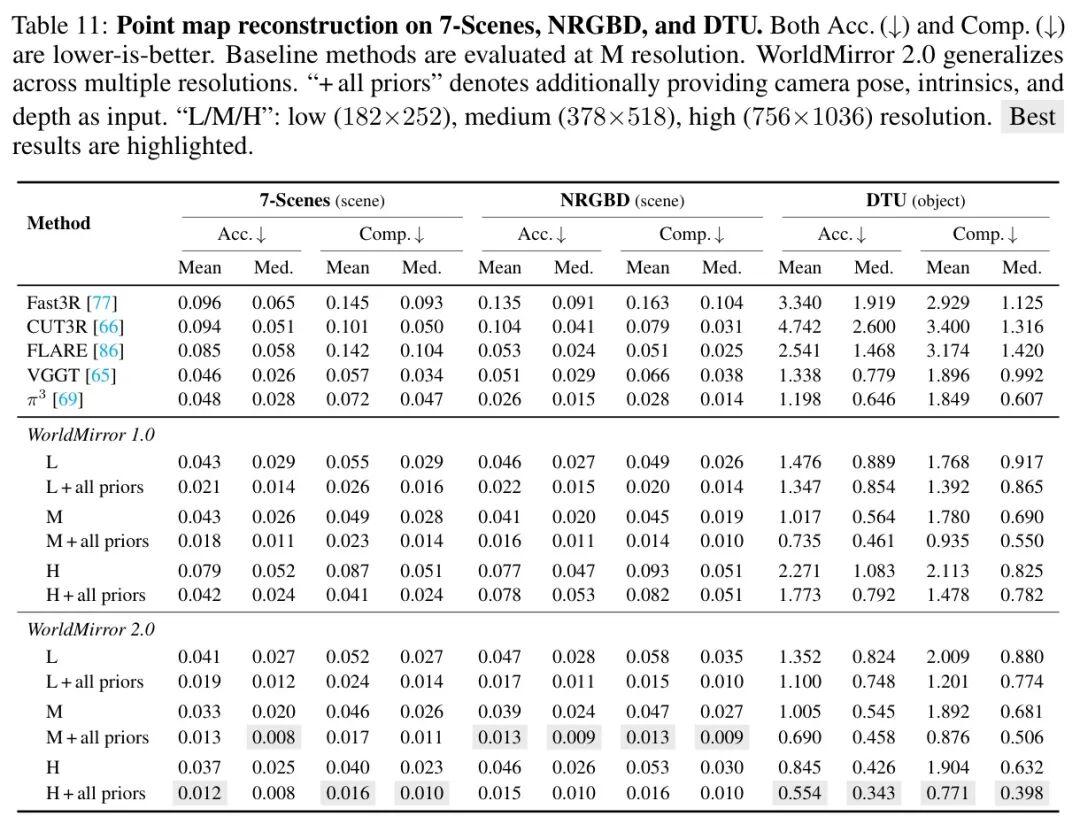
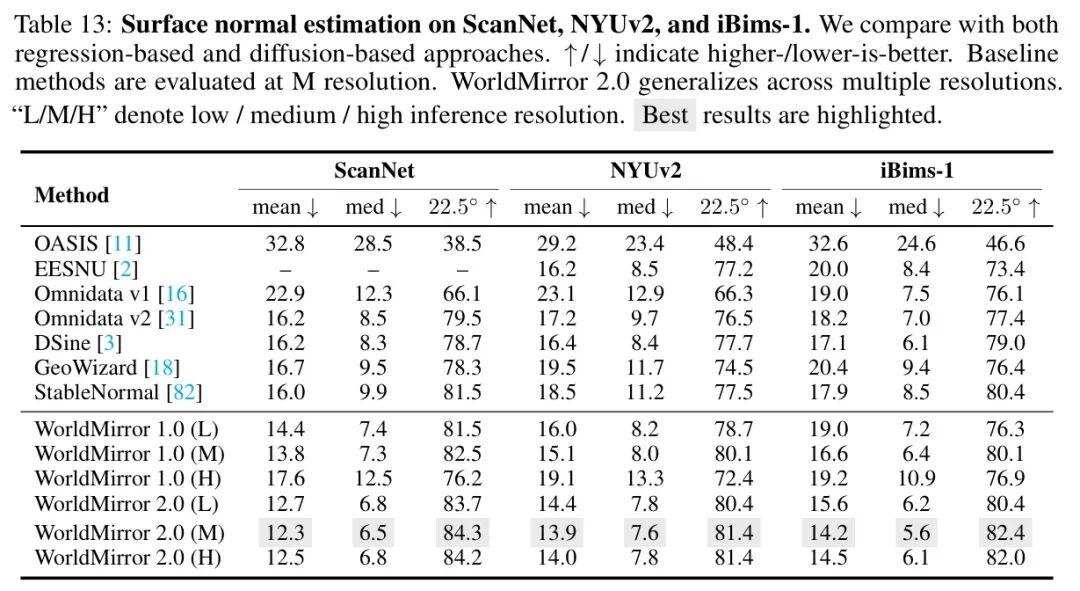
在世界重建的各项任务中,升级后的WorldMirror 2.0更是展现了统治级的表现。无论是在点云重建精度、相机位姿估计,还是表面法线估计等任务上,它在多个标准数据集(如7-Scenes, DTU, ScanNet)上均取得了最佳成绩,并且在高分辨率下性能依然稳定,充分验证了归一化位置编码的威力。
消融实验:每个组件都至关重要
论文通过大量消融实验,证明了每个创新设计的价值。例如,在WorldStereo 2.0中,Keyframe-VAE和记忆机制(GGM+SSM++) 的引入,对生成质量、一致性以及相机控制精度都有巨大提升。
在世界合成的3DGS阶段,MaskGaussian模块在几乎不损失视觉质量(PSNR仅下降0.14)的前提下,将高斯点数量减少了73.7%,显著提升了渲染效率。
最终效果:生成可交互的沉浸式世界
经过完整的四阶段流水线,HY-World 2.0最终产出的是令人惊叹的成果。它不仅能生成逼真的3D场景,更能输出带物理碰撞的网格,支持虚拟角色在其中实时探索与交互。
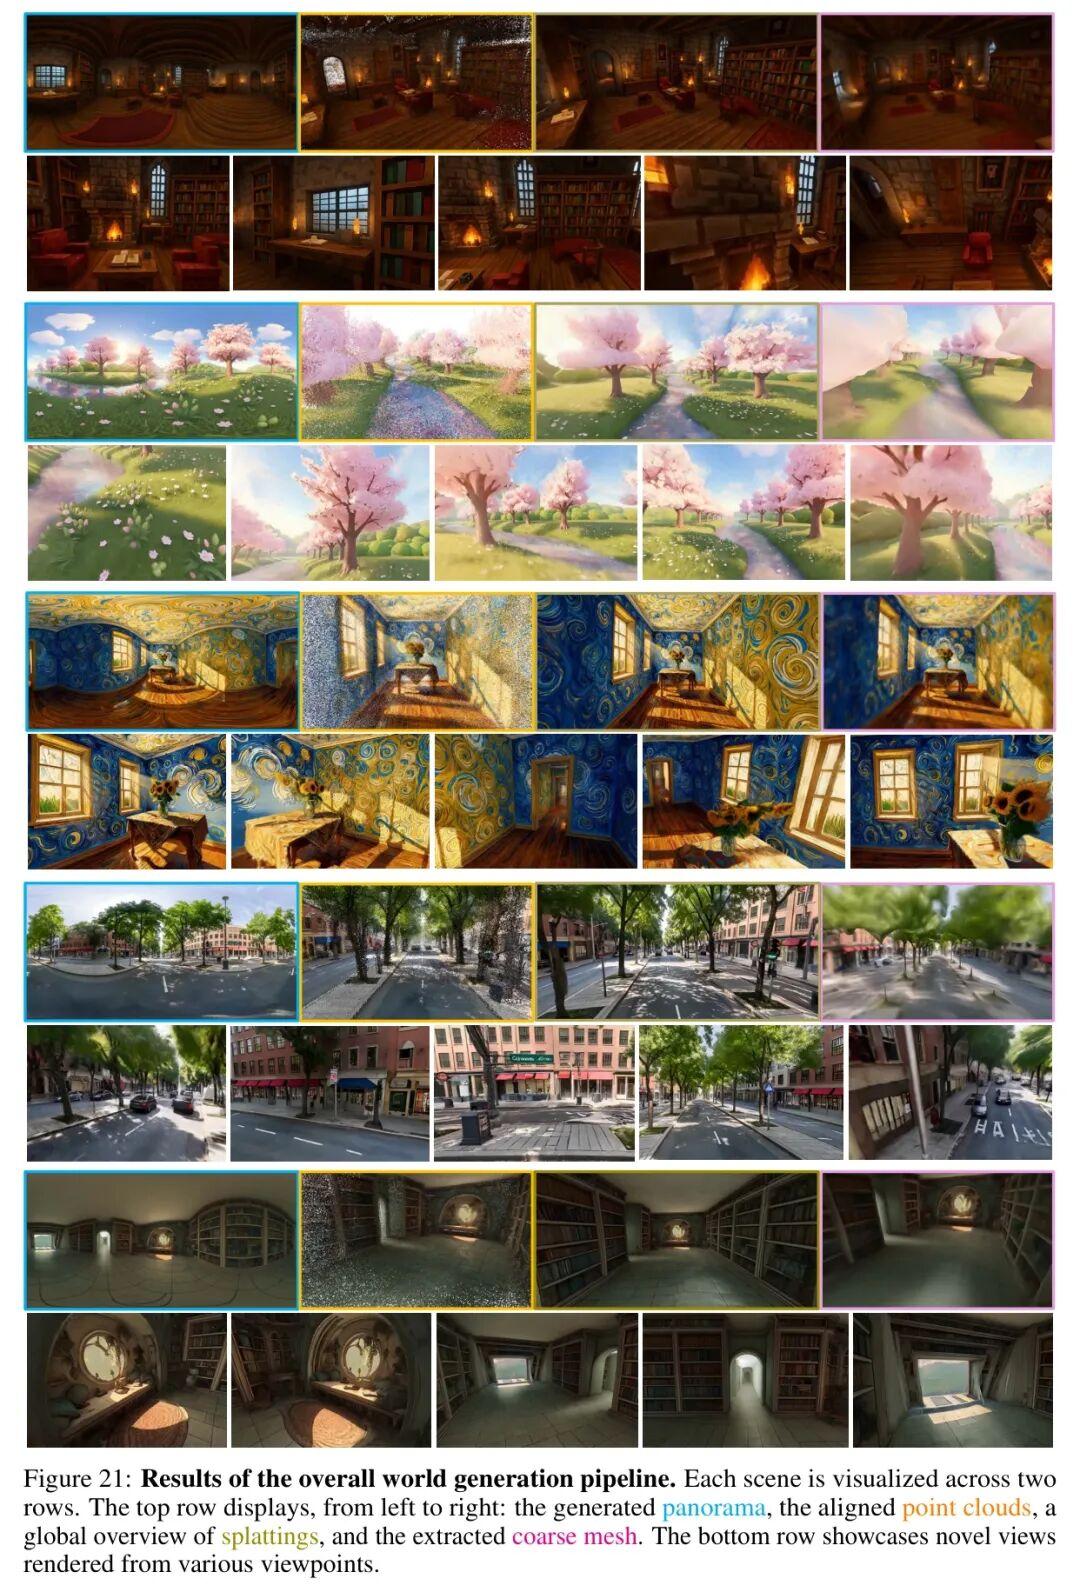
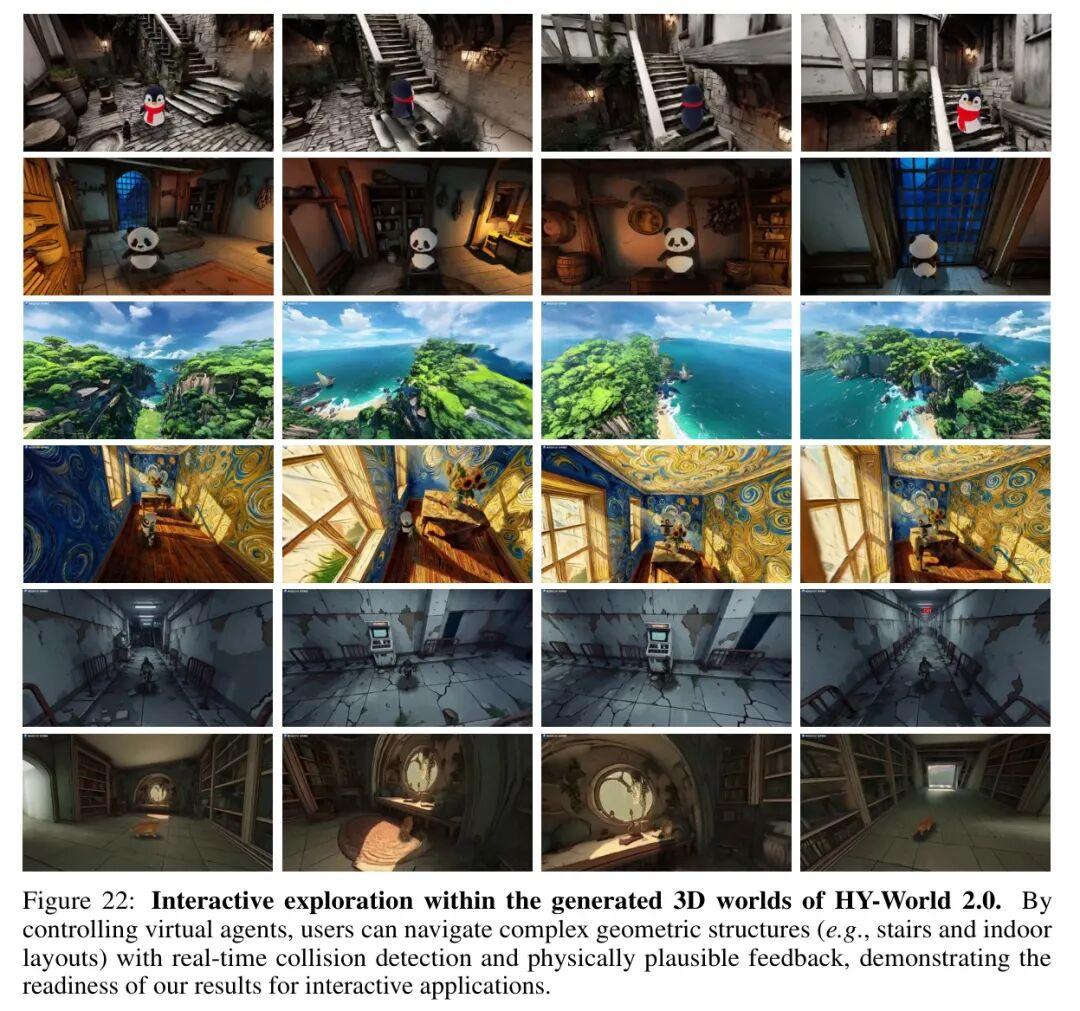
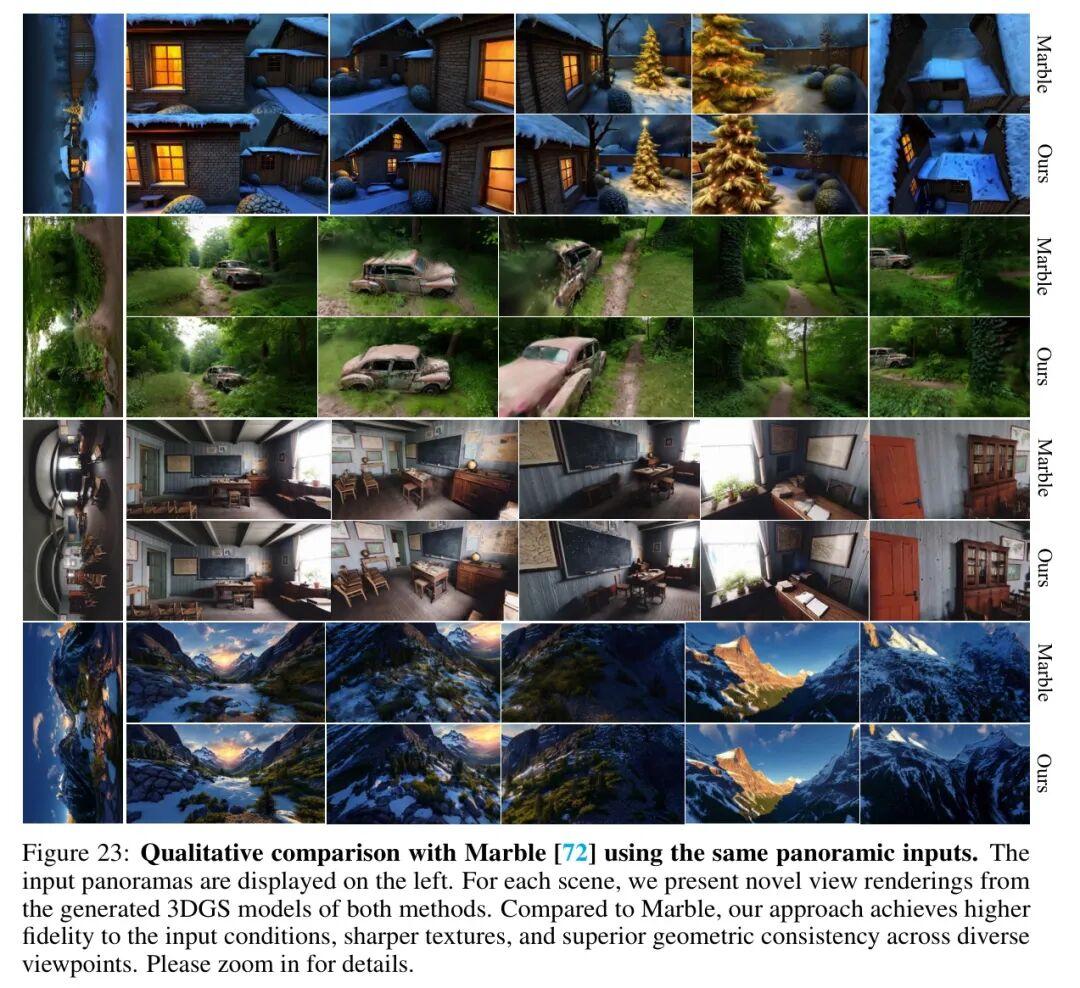
更重要的是,与当前顶尖的闭源模型Marble相比,HY-World 2.0在对输入条件的保真度和新视角下的细节一致性上表现更优。
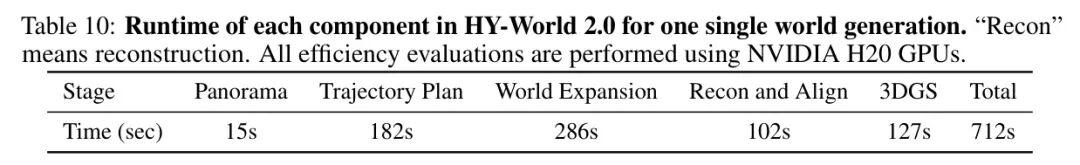
在效率方面,整个系统在NVIDIA H20 GPU上端到端生成一个世界仅需约10分钟,其中包含了全景生成、轨迹规划、世界扩展和3DGS优化等所有步骤,达到了实用级的速度。
⚖️ 客观评价
优势总结:
- 开创性统一框架:首次在开源领域系统化统一了3D世界生成与重建,范式意义重大。
- 模块化创新密集:从归一化RoPE、Keyframe-VAE到双重记忆机制,每个阶段都有扎实的技术突破。
- 效果与效率兼顾:在实现SOTA级生成质量的同时,通过蒸馏、并行等优化将效率提升至实用水平。
- 产出可直接使用:最终输出的3DGS场景带物理网格,可直接用于游戏、VR、仿真等下游应用。
局限性讨论:
- • 系统复杂性:四阶段流水线较长,依赖多个子模型,部署和维护的门槛相对较高。
- • 场景尺度限制:当前方法更适合房间、建筑等中尺度场景的生成与重建,对于超大开放世界(如整座城市)的扩展能力有待验证。
- • 纹理风格控制:虽然保真度高,但用户对生成世界的艺术风格(如油画感、像素风)进行细粒度控制的能力可能有限。
🌟 价值升华与行动号召
HY-World 2.0不仅仅是一篇论文的成果,它更是向通用3D世界模型迈进的重要里程碑。它告诉我们,通过系统性的框架设计,生成与重建可以不再是互斥的选择,而是相辅相成的力量。它所提供的开源代码与模型,无疑将极大加速3D生成、机器人仿真、数字孪生等领域的研究与应用。
回顾核心收获:
- • 一个框架:统一生成与重建的多模态世界模型框架。
- • 两重记忆:全局几何记忆与局部立体记忆,攻克多视角一致性难题。
- • 三大创新:归一化位置编码(泛化)、Keyframe-VAE(保真)、深度-法线联合监督(一致)。
- • 四段流水:全景 → 规划 → 扩展 → 合成,清晰可靠的工业化流水线。
🤔 深度思考:你认为HY-World 2.0这项技术,最可能率先颠覆哪个应用场景?是游戏内容的自动化生产,是机器人训练仿真环境的大规模构建,还是虚拟现实社交空间的快速搭建?欢迎在评论区留下你的观点!
💝 支持原创:如果这篇近5000字的深度拆解帮你摸清了3D世界模型的前沿脉络,点赞+在看就是最好的支持!分享给你的技术伙伴,一起探讨AI构建世界的无限可能!
🔔 关注提醒:点击右上角···设为星标,第一时间获取最硬核的AI技术解读!
#AI技术 #深度学习 #3D生成 #世界模型 #神经渲染 #论文解读
参考
HY-World 2.0: A Multi-Modal World Model for Reconstructing, Generating, and Simulating 3D Worlds