阿里巴巴发布R²-Write|过程Reward监督反思修订,开放写作SOTA
🔥 当你的AI写作助手像个“无脑码字员”,只会堆砌文字却不懂深度修改时,你正在错过让内容质量飞跃的关键一步。为什么在数学推理上表现惊艳的深度思考模型,一到写作任务就“哑火”? 一篇新研究揭示了根源,并给出了颠覆性的解决方案:让AI学会像人类一样“反思与修订”。读完本文,你将彻底掌握如何让模型拥有“作家级”的自我审查能力,告别肤浅输出。
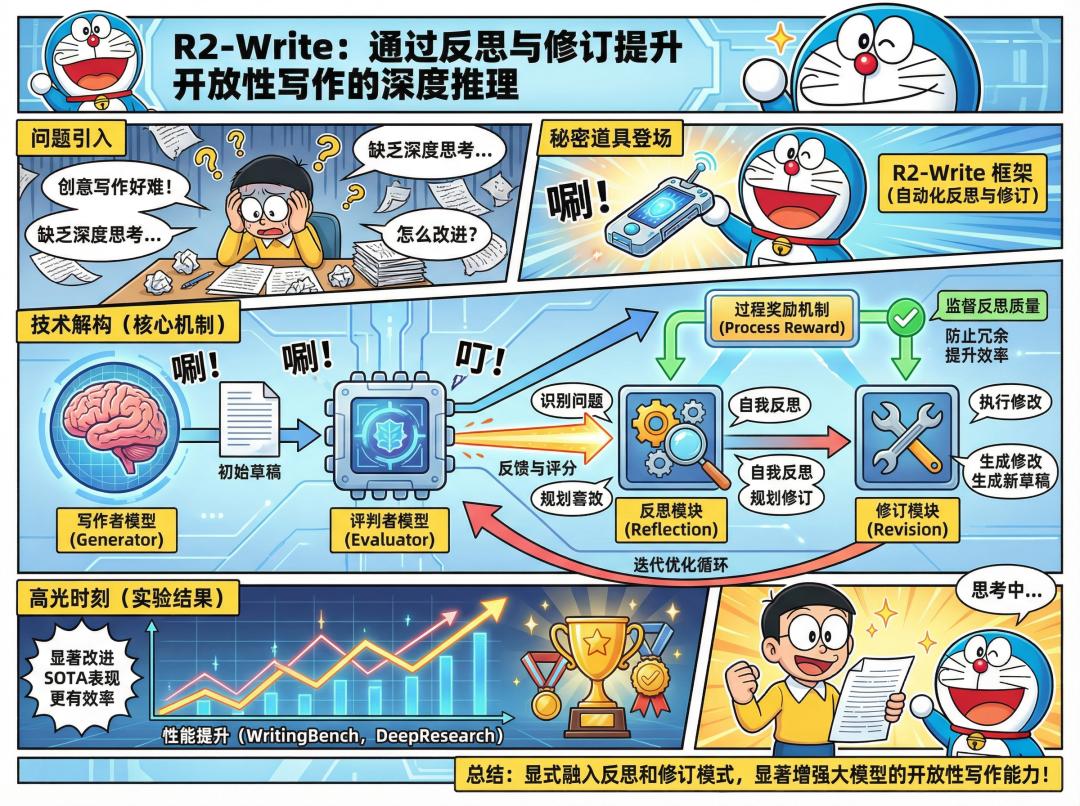
图:论文核心内容漫画解读
一张漫画胜千言——快速把握论文全貌!接下来,我们深入拆解这项让AI写作“开窍”的技术。
你是否曾对AI生成的报告、小说或方案感到一丝“塑料感”?它似乎什么都说了,却又什么都没说透。问题不在于模型不够大,而在于它缺乏深度写作的核心:批判性反思与迭代修订。
❓ 深度推理在写作上“失灵”了?核心痛点直击
深度推理凭借“思维链”在数学、代码等可验证任务上大放异彩,性能提升动辄超过100%。但当我们将同样的期待投向开放式写作——创意故事、深度报告、商业文案——结果却令人失望。
数据说话:如表1所示,在创意写作基准WritingBench和HelloBench上,即便启用“思考”模式,主流模型(如Qwen3系列)的提升也仅在10%-40% 之间。相比之下,在数学基准MATH 500和AIME 25上,提升幅度轻松超过100%,甚至达到200%以上。巨大的差距表明,当前的深度推理范式在写作任务上“水土不服”。
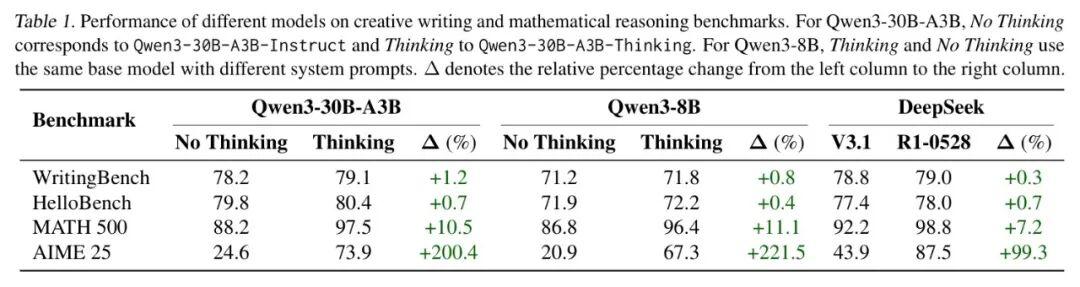
表:深度推理在写作任务上的提升远低于数学任务
根源在于“思维模式”的缺失。为了深挖原因,研究者对模型的“思考轨迹”进行了精细解剖。他们定义了五种核心推理模式:子目标设定、总结、回溯、逆向推理和验证。
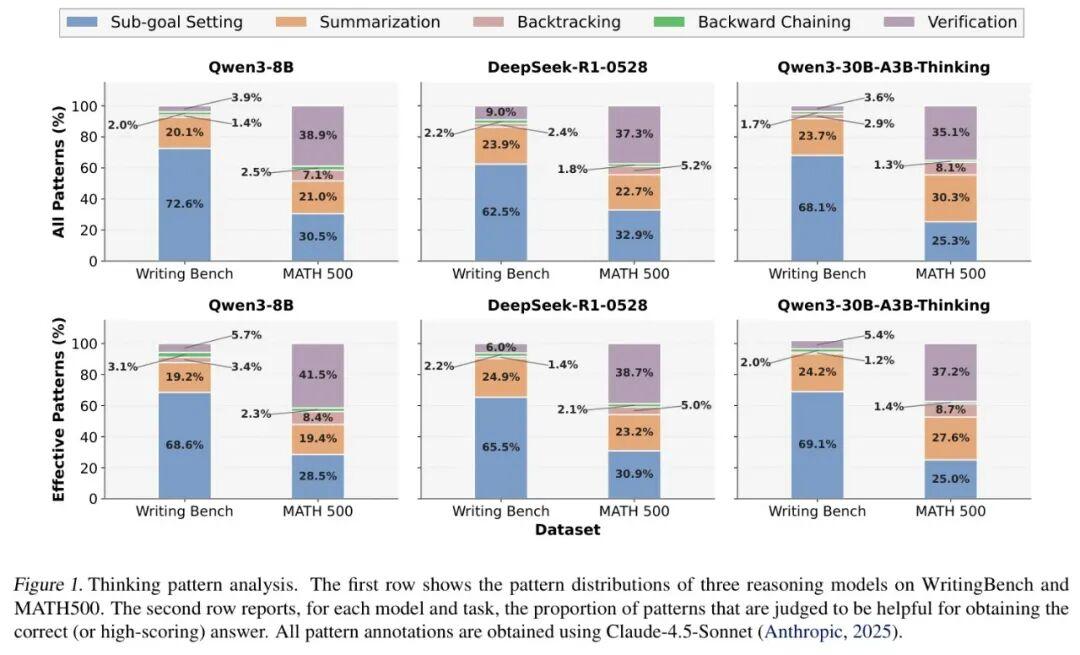
图:数学任务依赖“验证”与“回溯”,而写作任务中这两者几乎缺席
如图1所示,在数学任务中,“答案验证”和“回溯” 是帮助模型获得正确答案的绝对主力。然而,在写作任务中,模型几乎只使用“子目标设定”(类似列大纲),而关键的“验证”和“回溯”模式几乎不存在。
这意味着什么? 当前的AI写作,就像一个学生只列了作文提纲就开始埋头狂写,却从不回头检查逻辑是否自洽、事实是否准确、表达是否优美。它缺乏识别自身缺陷并主动修正的元认知能力。这正是AI写作陷入瓶颈的症结所在。
但为什么99%的优化尝试都失败了?关键就在于,我们过去只教模型“怎么写”,却没教它“怎么改”。
🚀 原理拆解:R²-Write如何教会AI“自我修订”?
R²-Write的核心思想直白而有力:既然现有模型的思考中缺少“反思-修订”模式,那我们就人工为它构建富含这类模式的高质量训练数据,并通过强化学习中的“过程奖励”机制,确保模型学会高效、精准地使用这些模式。
整个框架是一个精密的系统工程,分为三大阶段,其全景架构如图2所示。
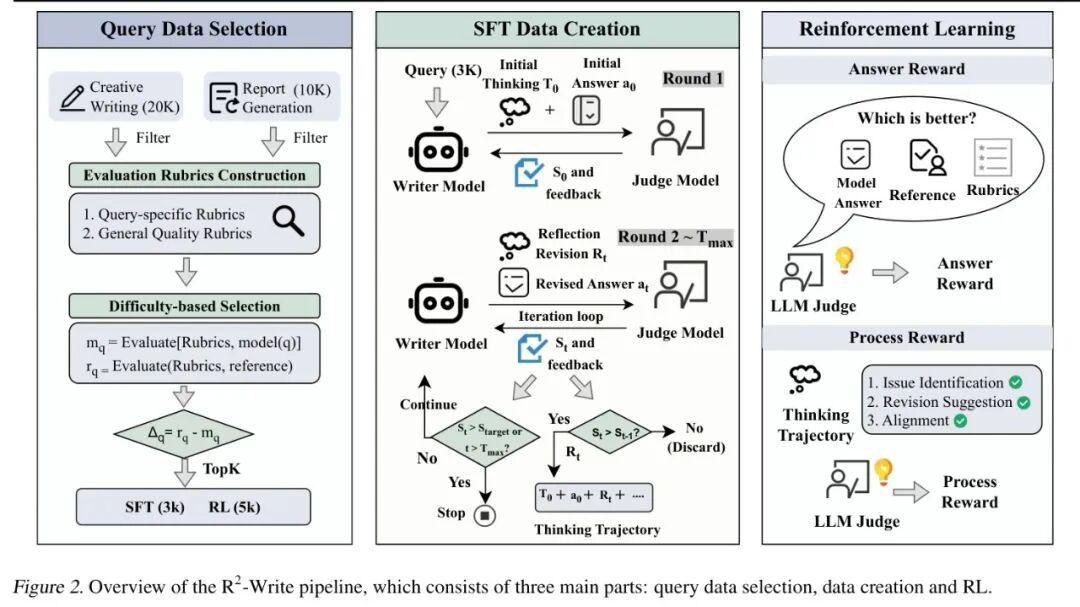
图:R²-Write完整训练流水线,涵盖数据构建、SFT与强化学习
💡 阶段一:数据构建 —— 制造“反思教科书”
首先,需要为模型编写一本专用的“反思教科书”。R²-Write通过一个自动化、迭代的“作者-评判者”协作流程来合成数据。
- 筛选难题:从创意写作(5183条)和报告生成(2728条)数据集中,筛选出对当前模型来说最具挑战性的查询。如图4所示,这些数据覆盖艺术、金融、科研、媒体等多个领域,确保多样性。
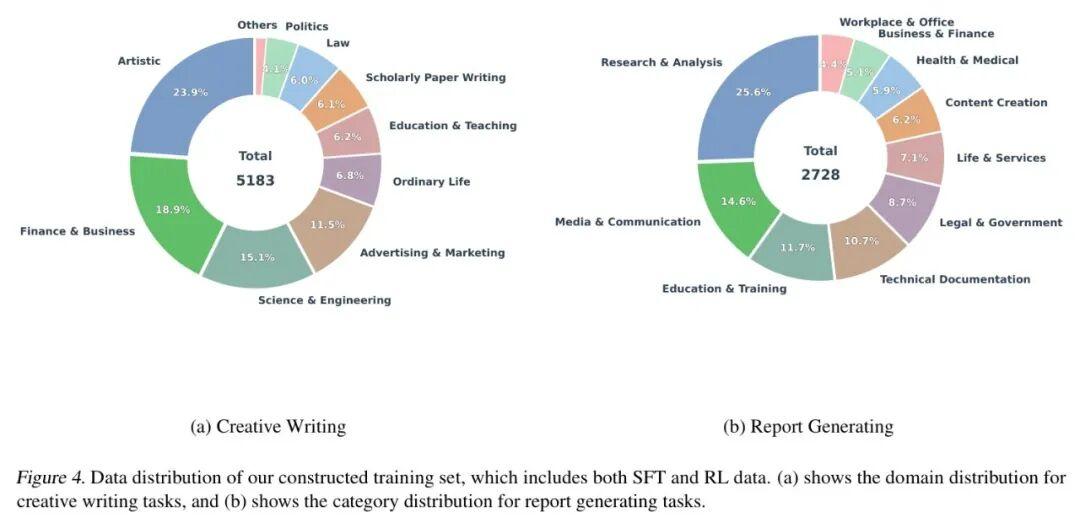
图:训练数据集的领域与类别分布
- 建立评估标准:为每个查询生成精细化的评分标准。如图10和图11所示,这包括查询特定标准(检查是否覆盖用户所有要求)和通用质量标准(评估清晰度、深度、创造性等)。
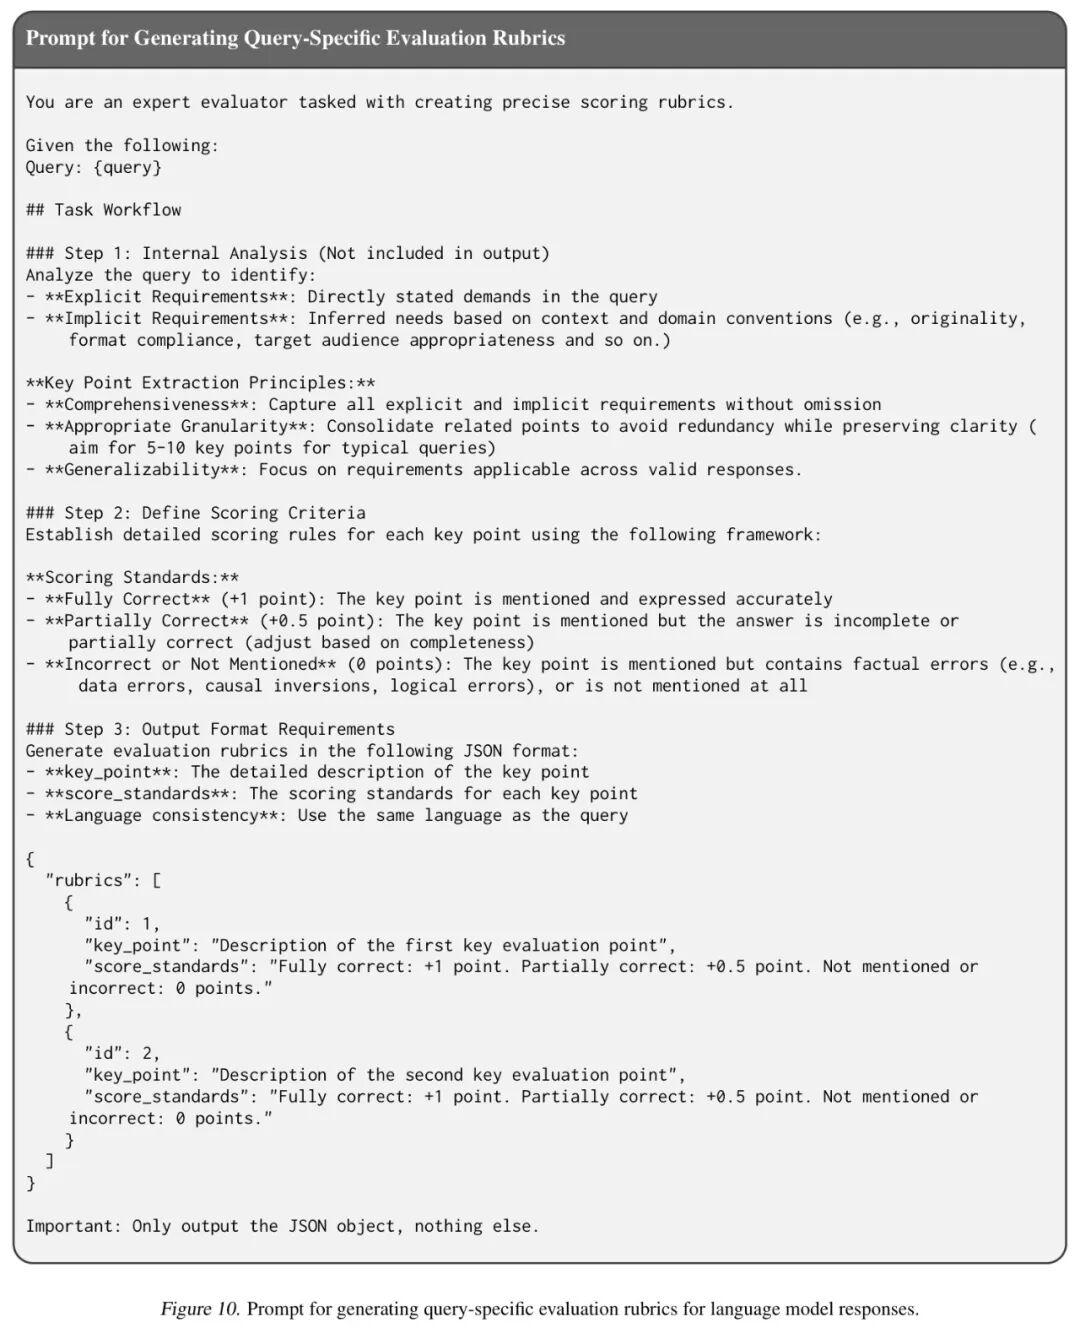
图:构建查询特定评估准则的提示模板
- 迭代式反思数据生成:这是核心。如图12和图13的提示模板所指导,“作者”模型生成初稿,“评判者”模型根据标准给出评分和反馈。然后,“作者”需要将外部反馈内化为自己的思考,生成一个“反思-修订”片段(例如:“等等,我注意到这里的时间安排有冲突…”),并据此修改文章。此过程反复进行,直到评分达标。最终,包含多轮反思过程和最终优化答案的完整“思考轨迹” 被记录下来,作为训练数据。
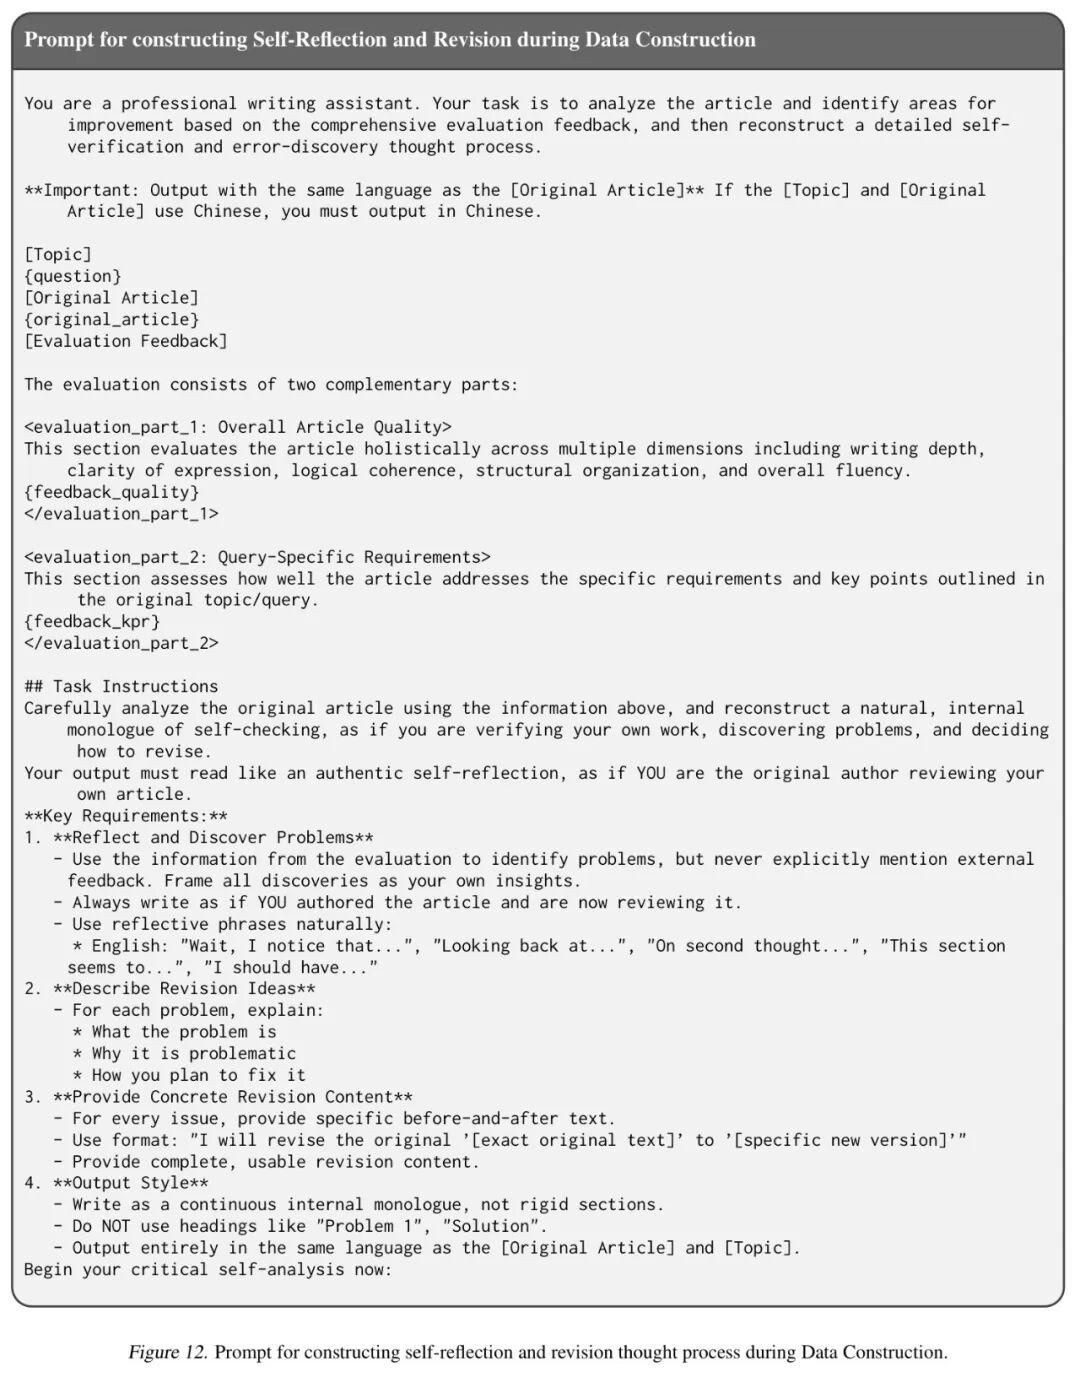
图:引导模型进行自我反思与修订的提示设计
💡 实战思考:这个过程巧妙地模拟了人类写作的修改过程,并将“反思”这一内部心理活动,外化为可被模型学习和模仿的显式文本模式。
💡 阶段二:监督微调 —— 学习“反思模式”
获得高质量的“反思教科书”后,通过标准的监督微调(SFT)让基础模型(如Qwen3-8B)学习这些数据。模型由此初步掌握了在写作中进行“自我批评”和“修改”的模式语言。
💡 阶段三:强化学习与过程奖励 —— 优化“反思效率”
SFT让模型“学会”了反思,但它可能滥用反思,生成冗长、无效的思考过程。因此,R²-Write引入了强化学习(RL)阶段,并设计了革命性的过程奖励机制。
传统RL的局限:通常只根据最终答案的质量给予奖励。这就像只根据考试分数评价学生,不关心他的解题步骤是否简洁优美,可能导致模型生成又臭又长的思考来“碰运气”。
过程奖励的精髓:R²-Write在奖励函数中增加了一个专门评估“思考过程”的组件。如图17和图18的提示模板所示,它要求另一个大语言模型从思考轨迹中提取每一个“反思-修订”片段,并从三个维度打分:
- 问题识别有效性:发现的是真问题还是无病呻吟?
- 修订建议质量:提出的修改方案是否合理?
- 执行对齐度:最终的答案是否真的落实了修改?
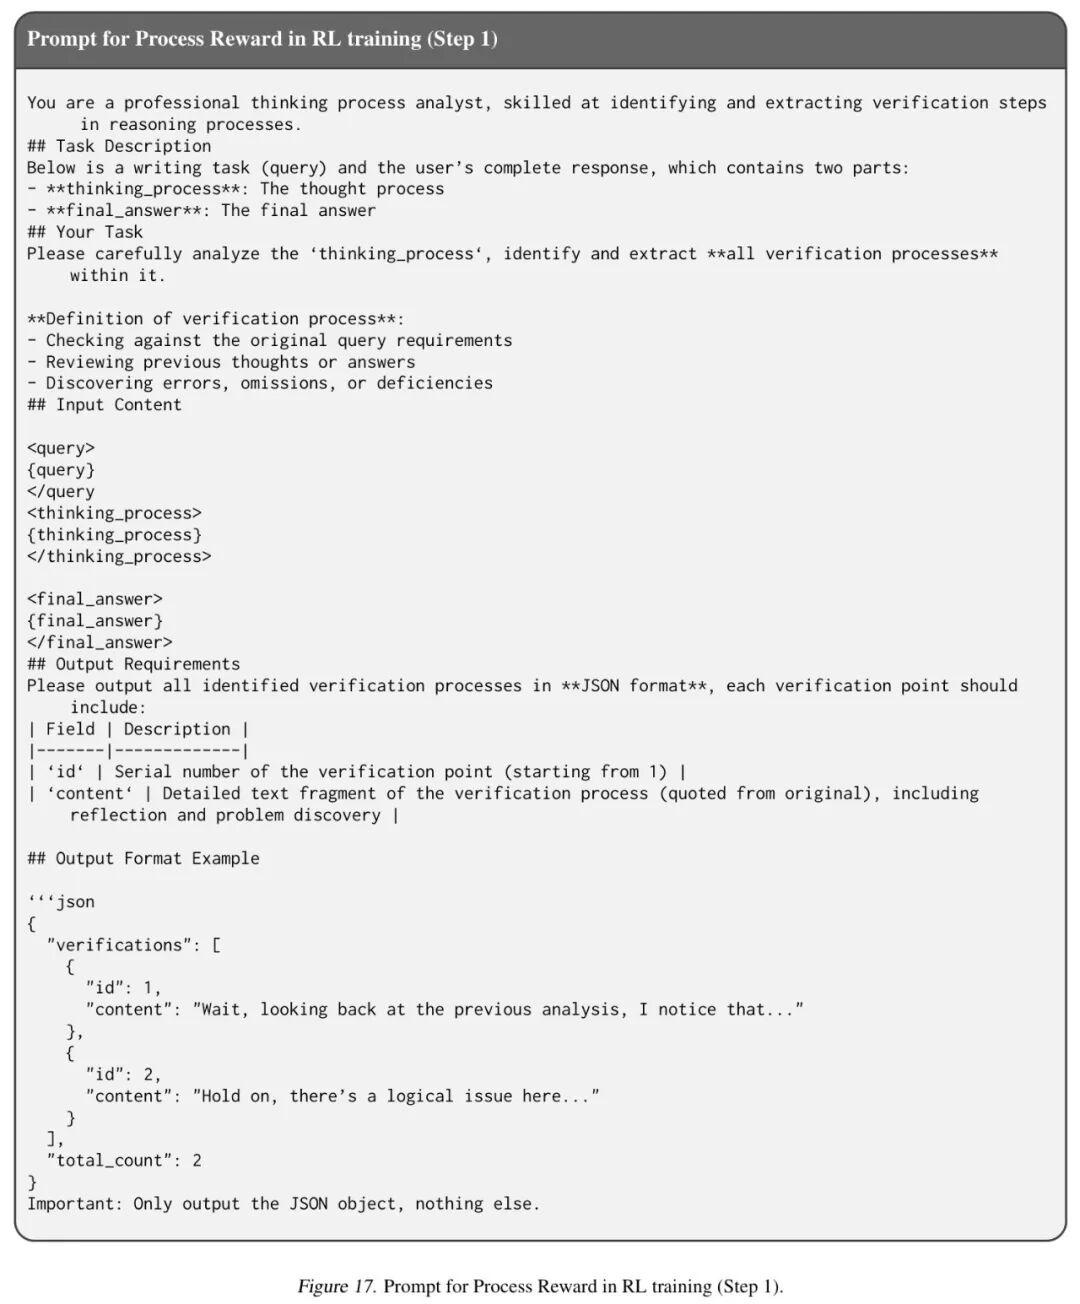
图:评估思考过程中验证步骤质量的提示设计
总奖励由答案奖励和过程奖励加权组成:
其中 是答案奖励, 是过程奖励, 是权重。关键设计:仅当答案本身合格()时,过程奖励才被计入。这防止了模型“用漂亮的思考过程生成一个跑题的答案”来骗取奖励。
效果立竿见影:如图7所示,引入过程奖励后(右侧曲线),模型在训练中生成的响应长度显著下降(均值从6465降至更低),说明它学会了做更精准、高效的反思,砍掉了冗余思考。而基线方法(左侧曲线)的响应长度则越来越长。
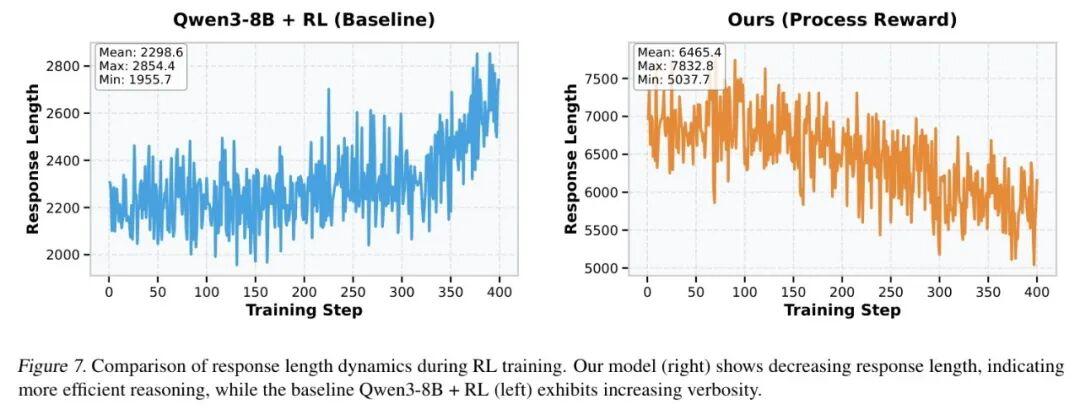
图:过程奖励机制有效控制了思考长度,提升了推理效率
同时,从图6的训练曲线可以看到,总奖励、答案奖励和过程奖励三者同步稳健上升,证明模型在优化思考过程的同时,确实输出了更优质的答案。
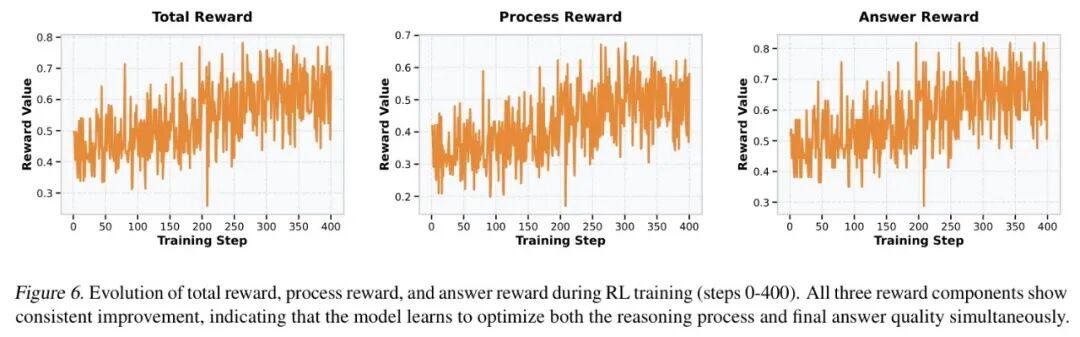
图:强化学习训练中,总奖励、过程奖励、答案奖励同步提升
这个“过程奖励”设计,堪称点睛之笔。它确保了模型不仅“会反思”,而且懂得“精炼地反思”。
你在自己的项目中,是否也曾苦恼于如何设计奖励函数来引导模型产生更结构化的中间输出?欢迎在评论区分享你的经验或困惑!
📊 实验验证:数据证明“反思”的力量
理论再美,也需要数据支撑。R²-Write在多个高难度写作基准上接受了严格检验。
🏆 SOTA对比:全面领先,优势显著
如表2所示,在Writing Bench、Deepresearch Gym和DiscoX三个数据集上,Qwen3-8B + R²-Write-SFT + RLₚ 的组合,在Score、质量、流畅度等多个指标上,全面超越了包括GPT-5、Gemini-2.5-Pro等顶级闭源模型,以及众多开源SFT和RL基线方法。
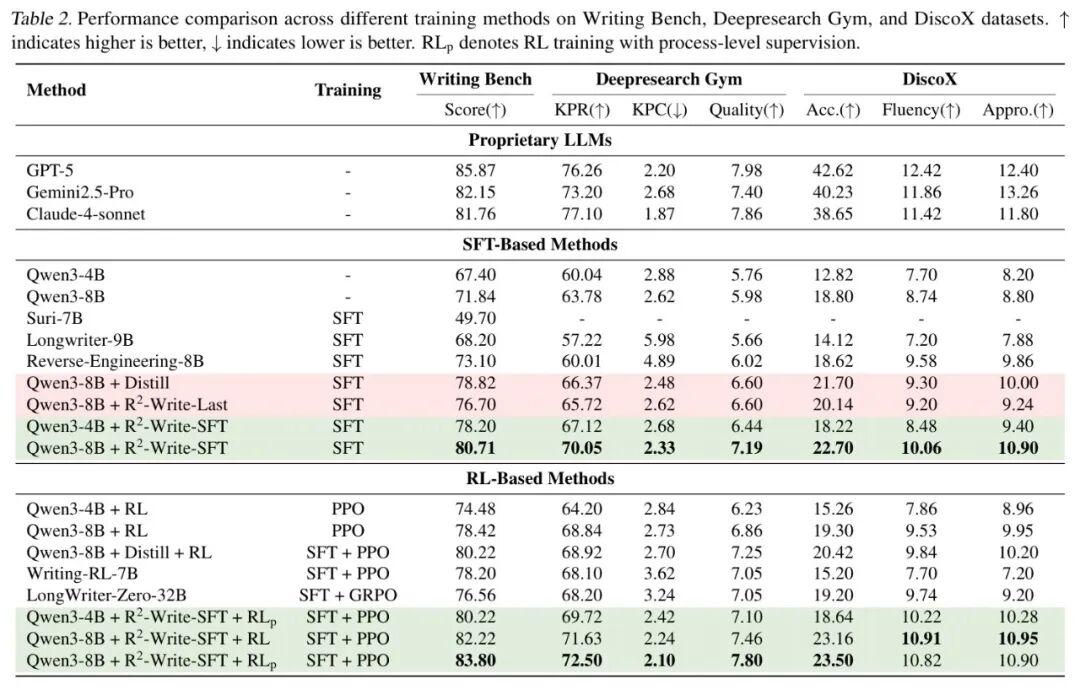
表:R²-Write在多数据集、多指标上显著优于专有模型及各类基线方法
更全面的结果如表11所示,在HelloBench和DeepresearchBench上,R²-Write同样取得了最佳的综合评分,证明了其强大的泛化能力。
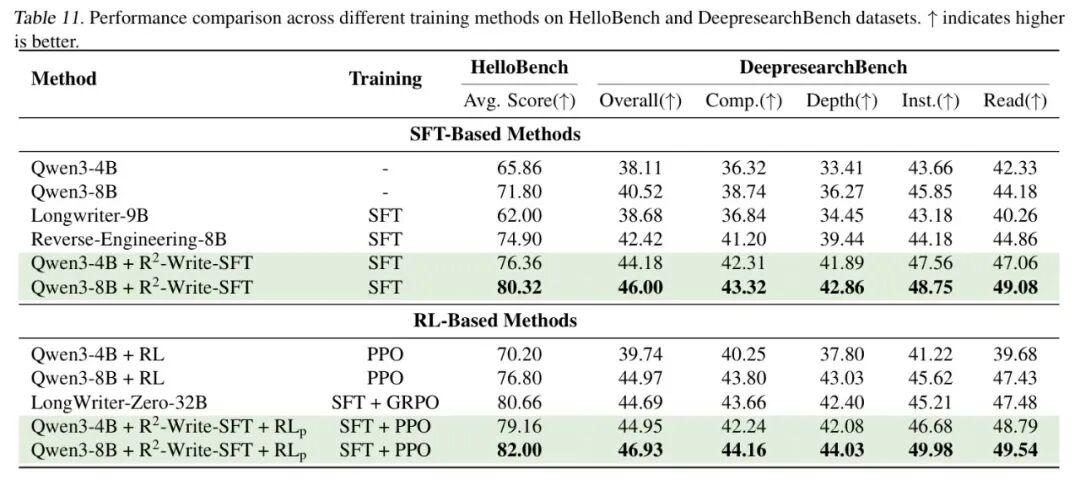
表:在HelloBench和DeepresearchBench上,R²-Write训练策略效果最优
结论震撼:一个经过R²-Write训练的8B参数模型,在写作能力上可以超越或比肩参数量大得多的顶级专有模型。这充分证明了“反思-修订”模式注入的有效性,它显著放大了模型的内在潜力。
🔬 消融实验:每个组件都不可或缺
为了剥离“知识蒸馏”的影响,研究者做了关键消融实验(表3):对比“直接从教师模型蒸馏答案”和“使用R²-Write的完整思考轨迹进行SFT”。结果后者显著优于前者,平均提升超过10%。这铁证如山:性能提升主要归功于反思模式本身,而非教师模型知识的简单转移。
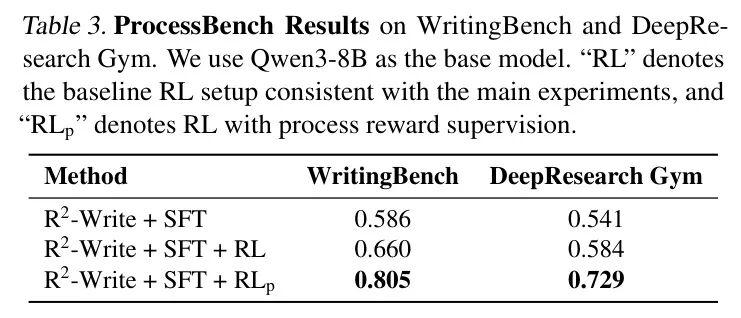
表:引入过程奖励监督(RL_p)带来了最显著的性能提升
表3进一步显示,在SFT基础上引入标准RL提升有限,但引入带有过程奖励的RL(RL_p)则带来了质的飞跃(如在WritingBench上从0.660提升至0.805)。这再次凸显了过程奖励监督的核心价值。
表6则验证了奖励函数和RL算法的选择:基于高质量参考答案的成对比较奖励,结合PPO算法,取得了最佳效果。
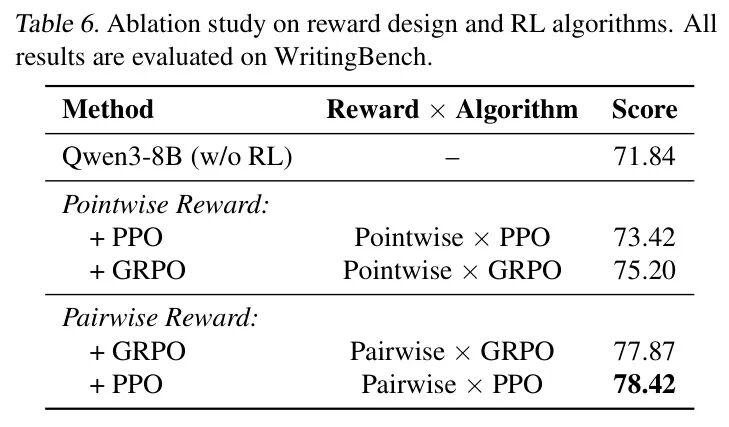
表:成对奖励结合PPO算法效果最佳
🔍 深入分析:反思具体修了什么?
那么,模型学会的反思,具体在修正哪些问题呢?研究者将改进点分为三类(表4):
- 需求对齐:补全用户明确要求但遗漏的内容。
- 事实与逻辑修正:纠正数据、引用错误或逻辑矛盾。
- 质量提升:增强表达的清晰度、连贯性、深度和创造性。
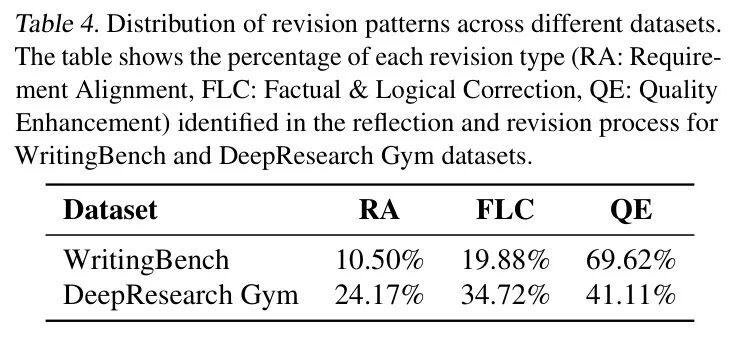
表:反思-修订模式主要带来“质量提升”,在深度研究任务中“事实修正”占比更高
结果显示,质量提升占据了改进的大部分(在WritingBench中占69.62%),这与人类写作标准高度一致。而在DeepResearch Gym这类需要严谨引用材料的任务中,事实与逻辑修正的比例明显更高。这说明模型学会了“因地制宜”地反思。
生动的案例:图8展示了一个活动策划案的七轮迭代反思,每一轮都精准定位一个问题(如时间冲突、预算不合理、KPI缺失),并进行针对性修改,最终将平均分从6.6提升到了9.4。
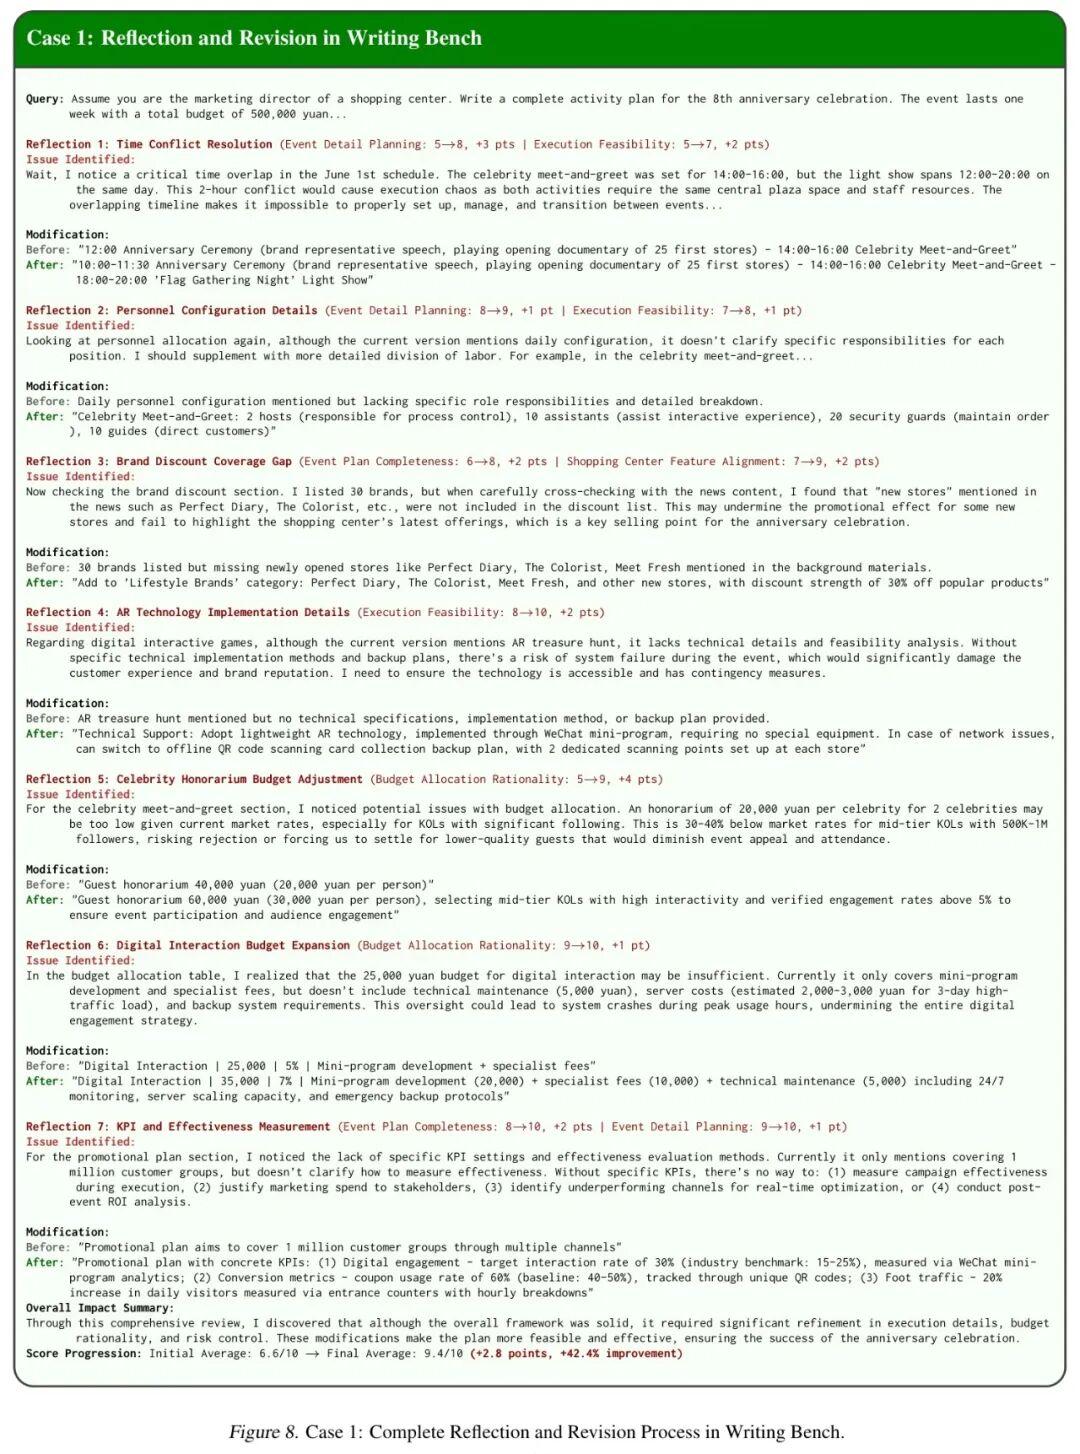
图:通过多轮结构化反思与修订,系统性提升写作质量
图9则展示了对“COVID疫苗是否危险”这一科学报告的修订,模型通过反思,逐条核对并驳斥了来源材料中的错误数据,使报告更加严谨、有说服力。
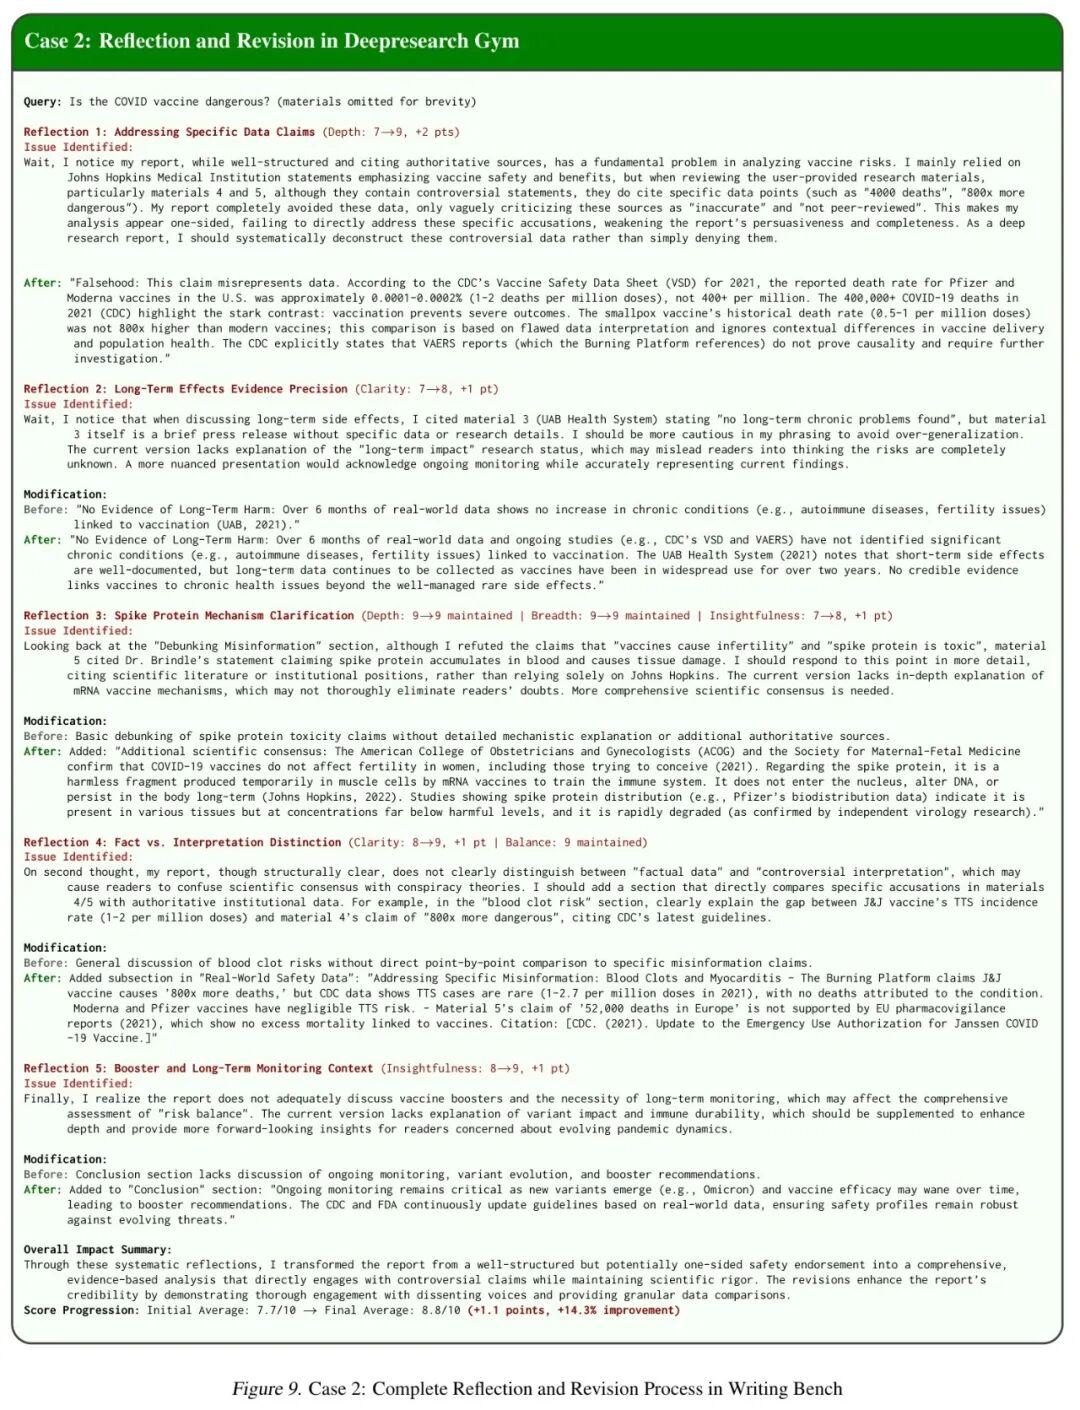
图:在学术写作中,反思机制帮助模型进行基于证据的批判性分析
⚖️ 客观评价与未来展望
优势与价值:
- 范式创新:首次系统地将“反思-修订”作为可学习、可优化的显式模式引入AI写作,解决了深度推理在开放域的关键瓶颈。
- 效果显著:以较小参数量实现写作能力的跨越式提升,为打造高效、专业的写作AI提供了清晰路径。
- 通用性保持:如表5所示,R²-Write训练并未损害模型在数学(AIME25)和通用知识(MMLU-Pro)上的能力,证明了其安全性。
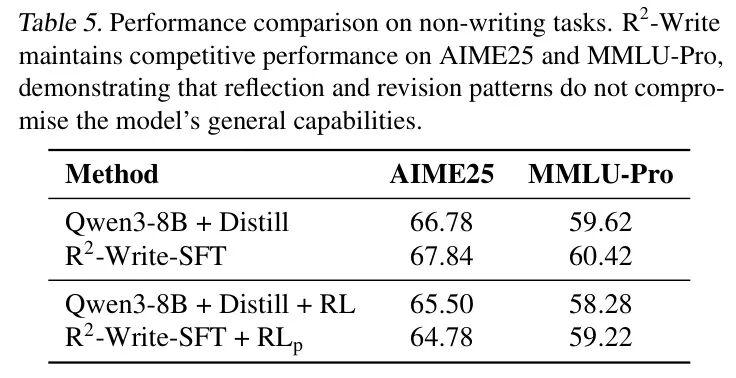
表:R²-Write训练未损害模型在非写作任务上的通用能力
计算成本考量:如表10所示,构建高质量数据、进行RL训练确实需要投入(主要是RL训练的GPU时长),但这对于获得专业级写作能力来说是值得的投资。未来可通过算法优化进一步降低成本。
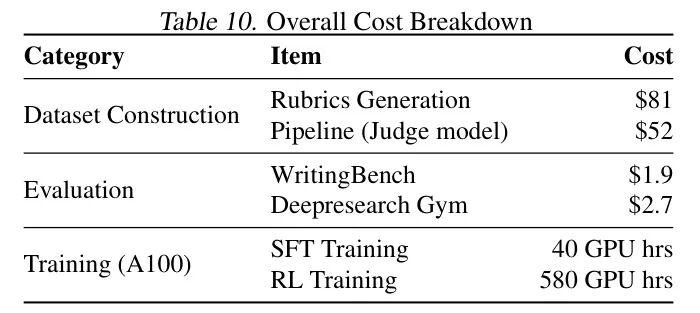
表:模型训练与评估的总体成本分析
局限与展望:
- • 领域依赖:目前框架依赖于为特定任务构建的评估标准,未来可探索更通用、可迁移的反思模式。
- • 评判者偏差:过程奖励依赖于另一个LLM作为评判者,可能存在偏见。结合人类反馈或更鲁棒的评估模型是改进方向。
- • 应用拓展:此框架极有可能推广到代码审查、设计稿迭代、策略报告优化等任何需要迭代改进的创造性任务中。
🌟 价值升华 + 行动号召
R²-Write为我们清晰地指明了下一代AI写作乃至创造性AI的发展方向:从“一次生成”走向“迭代优化”,从“模仿形式”走向“掌握精髓”。
它告诉我们,AI的“智能”不仅体现在生成内容的广度上,更体现在对自身产出的深度审视与修正能力上。这或许是迈向更通用、更可靠AI的关键一步。
读完本文,你的三大收获:
- 洞悉瓶颈:明白了当前AI写作模型缺乏深度反思能力是其质量上限的核心制约。
- 掌握方法:深入理解了通过数据合成与过程奖励,系统性为模型注入“反思-修订”模式的全套方法论。
- 看清趋势:看到了AI从“内容生成器”向“创意协作者”演进的一条具体技术路径。
🤔 深度思考:你认为R²-Write这项“反思与修订”技术,最可能率先颠覆哪个具体的AI应用场景?是自动生成并优化营销文案?是辅助学生反复修改论文?还是成为小说家的“第一读者”和编辑?欢迎在评论区留下你的观点!
💝 支持原创:如果这篇近5000字的深度技术解读对你有所启发,点赞+在看就是最好的支持!分享给你的技术伙伴或内容创作团队,一起探讨AI写作的未来!
🔔 关注提醒:设为星标,第一时间获取更多颠覆性的AI技术深度解读!
#AI技术 #深度学习 #AI写作 #模型优化 #R²Write #论文解读 #AIGC
参考
R²-Write: Reflection and Revision for Open-Ended Writing with Deep Reasoning