Meta发布Tempo|6B干翻GPT-4o,长视频理解新SOTA
盯着长达一小时的监控录像,只为找那关键的3秒;快进看完一部电影,却要回答关于某个一闪而过道具的细节问题——这就是当前AI在长视频理解中面临的尴尬:要么算力爆炸,要么信息丢失。
但今天,一项名为 Tempo 的技术彻底改变了游戏规则。它像一位拥有“时间管理超能力”的AI导演,能将1小时的视频智能压缩到极致,仅用平均每帧4-6个视觉令牌(token),就在多个长视频理解基准测试中击败了GPT-4o和Gemini 1.5 Pro等巨头。
更惊人的是,这项突破来自一个总参数量仅60亿(6B) 的紧凑模型。它究竟如何做到的?关键在于一个革命性的设计:让小型视觉语言模型(SVLM)充当“智能压缩器”,在理解问题(Query)的指导下,动态分配宝贵的计算资源。
如果你正在为多模态大模型的上下文窗口限制而头疼,或苦于长视频处理的高昂成本,那么接下来的深度解析,将为你打开一扇全新的大门。
❓ 核心痛点:为什么长视频成了AI的“阿喀琉斯之踵”?
多模态大模型(MLLM)在图像和短视频上风光无限,但一旦面对长达数十分钟甚至一小时的视频,立刻“原形毕露”。核心矛盾在于:海量连续的视频帧与LLM有限的上下文窗口之间,存在无法调和的结构性冲突。
现有解法无外乎两种,但都代价惨重:
- 稀疏采样:像跳着看书一样跳过大量帧。风险是极可能错过回答问题的关键瞬间,比如监控中一闪而过的人脸、教学视频里某个关键操作步骤。
- 均匀压缩:对所有帧进行无差别的池化或令牌合并。后果是细粒度证据被模糊,同时在不重要的背景上浪费了大量宝贵的表征带宽。
本质上,这些方法都是“盲目”的。它们在还不知道用户要问什么之前,就武断地丢弃或模糊了信息。就像一个不知道考试重点的学生,胡乱划掉了课本上的内容,结果恰好删掉了考点。
那么,是否存在一种方法,能像人类一样,根据“问题”智能决定视频的“观看节奏”:对关键部分慢放细看,对冗余部分快速略过?
Tempo给出的答案是:当然可以,而且要让模型自己学会做这个决策。
🏗️ 架构解析:Tempo的三级火箭
Tempo的核心理念非常巧妙:将视觉令牌的削减,视为一个早期的、基于问题(Query)的跨模态语义蒸馏过程。 它不再把压缩当作单纯的视觉操作,而是让压缩过程本身就能理解用户意图。
整个系统是一个清晰的两级架构,我们通过下面的全景图来一览其貌。
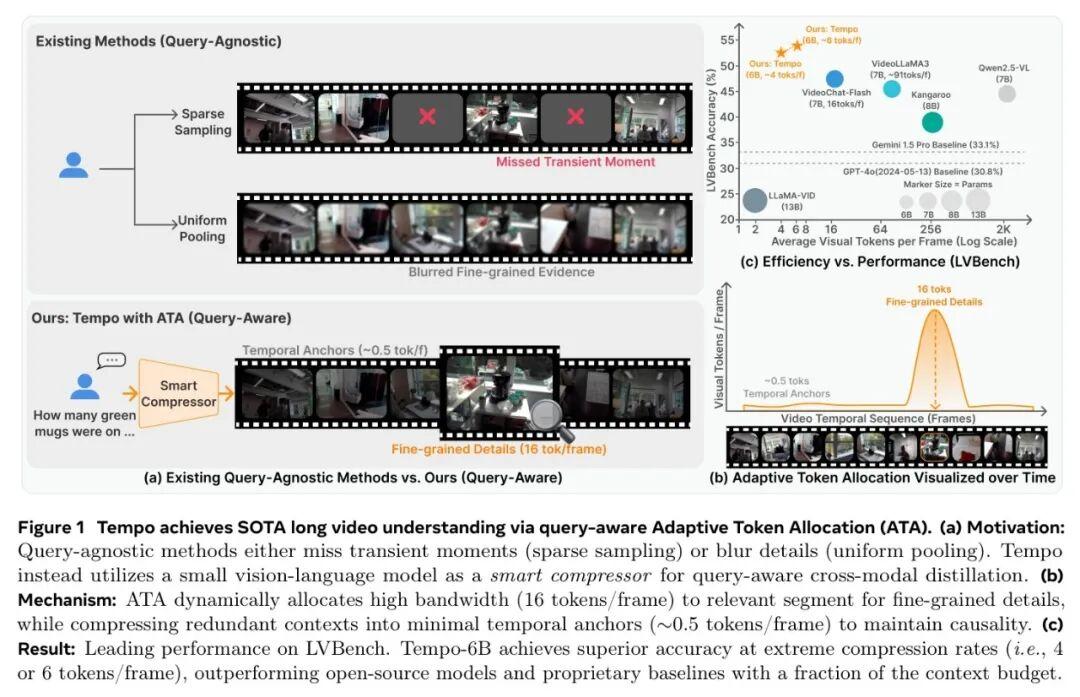
如图所示,Tempo的工作流程可以概括为“局部压缩,全局理解”:
- 局部压缩器(The Local Compressor):一个小型视觉语言模型(SVLM),负责处理视频片段。它的任务是在用户问题的指导下,将一段视频片段(如8帧)压缩成一组固定数量的“记忆令牌”。
- 推理专用旁路(Inference-Only Bypass):这是Tempo的“智能调度中心”。它在压缩过程中,并行计算当前片段与问题的“相关性分数”,并根据全局预算,动态决定该保留多少记忆令牌。
- 全局解码器(The Global Decoder):一个大语言模型(LLM),接收所有经过智能压缩和筛选后的片段记忆令牌,结合问题,最终生成答案。
这个框架的精妙之处在于端到端。压缩器和理解器被统一训练,压缩的目标直接服务于最终的回答任务。下面,我们深入最核心的“智能调度”机制。
💡 自适应令牌分配(ATA):预算的智能管家
ATA是Tempo在推理时强制执行令牌预算的无训练、零开销策略。它的目标是:在固定的总令牌预算(如8K)内,为N个视频片段动态分配额度,让重要的片段多“说话”,不重要的片段少“占地方”。
它依靠SVLM的两个固有超能力来实现:
1. 零样本相关性先验
现代多模态基础模型在预训练中已经学会了判断图文是否相关。Tempo巧妙地通过一个指令提示,在压缩过程中“悄无声息”地引出这个能力:“在压缩前,请准确回答‘是’或‘否’:该片段是否与问题相关?” 模型在生成答案前的隐藏状态,就蕴含了相关性分数 。
这个过程是 复杂度的,无需额外计算。相关性分数 通过一个简单的公式从模型权重中提取:
令 为模型回答二元问题前的最终隐藏状态, 和 分别是词汇“是”和“否”对应的输出层权重向量,则相关性概率为:
其中 是sigmoid函数。这个分数和压缩表示在同一轮前向传播中同时获得,几乎没有延迟。
2. 语义前置现象
研究人员发现一个经验规律:在SVLM的因果注意力机制下,最重要的语义信息会自然集中在最早生成的几个记忆令牌中。这就像写摘要时,总是把核心观点放在第一句。因此,压缩片段时,简单地从头部开始截取所需数量的令牌,就能最大程度保留关键信息。
基于以上两点,ATA的工作流程如下:
- • 计算分数:为每个片段获得相关性分数 。
- • 分配预算:将分数归一化后,线性映射到令牌预算区间 。这里 (如4)是最小时间锚点,确保即使最不相关的片段也有一个基本表示,以维持视频的时间因果顺序,防止模型“失忆”。
- • 头部截断:对每个片段,只保留其记忆令牌序列的前 个。由于语义前置,这几乎是最优的压缩方式。
这个动态过程的结果就是:关键片段可能分配到高达每帧16个令牌的“高带宽”,用于保留细节;而冗余背景则被压缩到每帧仅0.5个令牌的“低带宽”,仅作为时间线上的锚点存在。
🔄 渐进式训练:从看图说话到理解长片
为了让一个6B的模型掌握如此复杂的技能,Tempo采用了一套精心设计的四阶段渐进式训练课程:
- 阶段0(模态对齐):冻结SVLM和LLM,只训练连接它们的投影层。目标是让两者“说同一种语言”。
- 阶段1(预训练):解冻整个模型,在数百万图像、视频、文本数据上进行训练,初步建立多模态理解能力。
- 阶段2(有监督微调-SFT):使用更高质量、多样化的指令数据,训练模型遵循复杂指令并进行时空推理。
- 阶段3(长上下文SFT):关键一步! 冻结SVLM压缩器,只微调LLM。但这次,喂给LLM的是经过压缩的、更长的视频序列(最多384帧)。这专门扩展LLM处理长时序依赖的能力,而不破坏已学到的压缩对齐。
这套课程确保了模型能力平稳、扎实地增长,从处理静态图像,逐步过渡到理解超长视频。
🏆 实验验证:数据不说谎,效率与性能兼得
理论再美,也需要实验的检验。Tempo在多个权威的长视频基准测试中接受了挑战。
首先,我们来看它与其他最先进模型的直接对比。
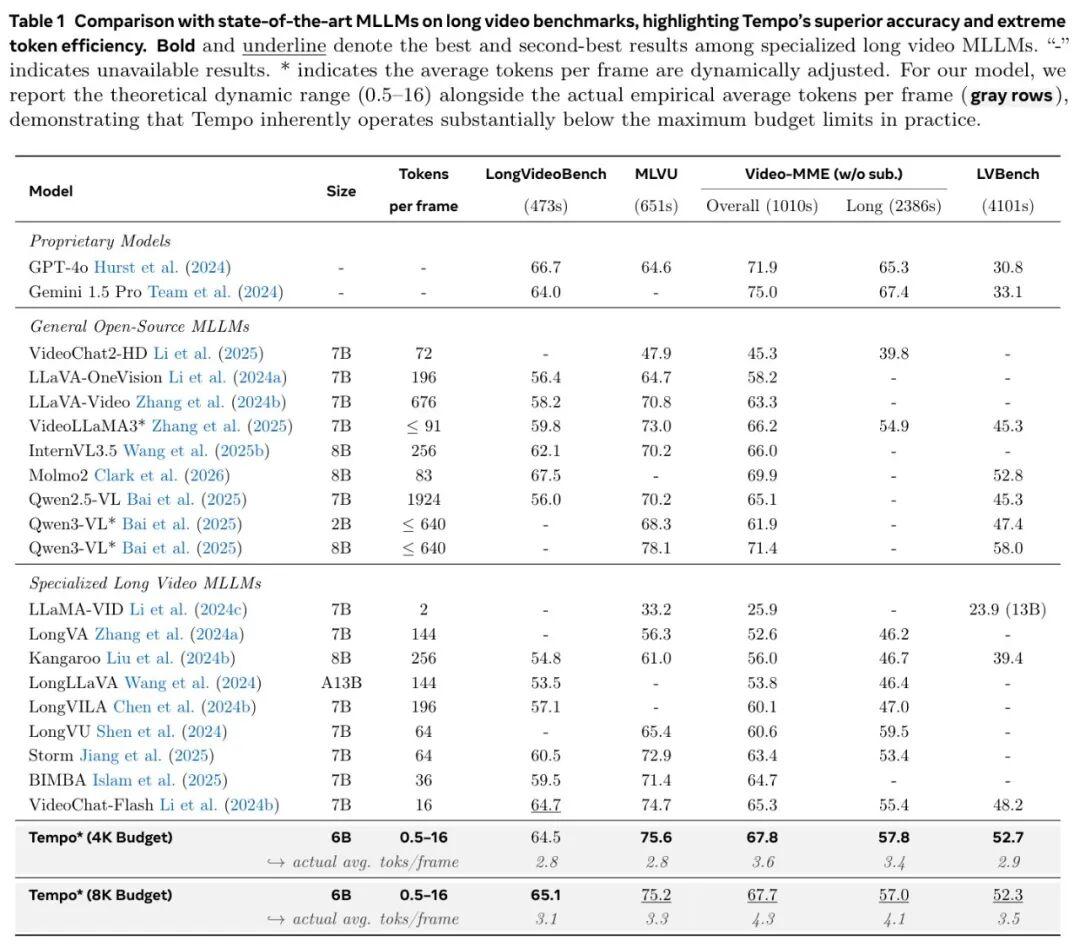
这张表信息量巨大:
- • 全面领先:在MLVU、Video-MME (Long) 和 LVBench 三个核心长视频基准上,Tempo(6B)的性能均位列第一或第二。
- • 碾压级效率:注意“Tokens per frame”一列。开源模型普遍在16-32之间,而Tempo的预算范围是0.5-16,实际平均每帧仅需4-6个令牌。这意味着它用不到1/5的输入成本,达到了更好的效果。
- • 超越闭源巨头:在最具挑战性的超长视频基准LVBench(平均超1小时)上,Tempo在8K预算下得到52.3分,显著高于GPT-4o(30.8)和Gemini 1.5 Pro(33.1)。这证明盲目将大量原始帧塞给大模型是低效的,智能压缩才是王道。
更有趣的是“少即是多”现象:在LVBench上,4K预算(52.7)的性能甚至略优于8K预算(52.3)。这说明更严格的预算迫使模型必须做更精准的过滤,反而提升了信息密度,缓解了“中间丢失”问题。
🔬 消融实验:每一个设计都至关重要
为了验证Tempo每个组件的必要性,研究人员进行了系统的消融研究。
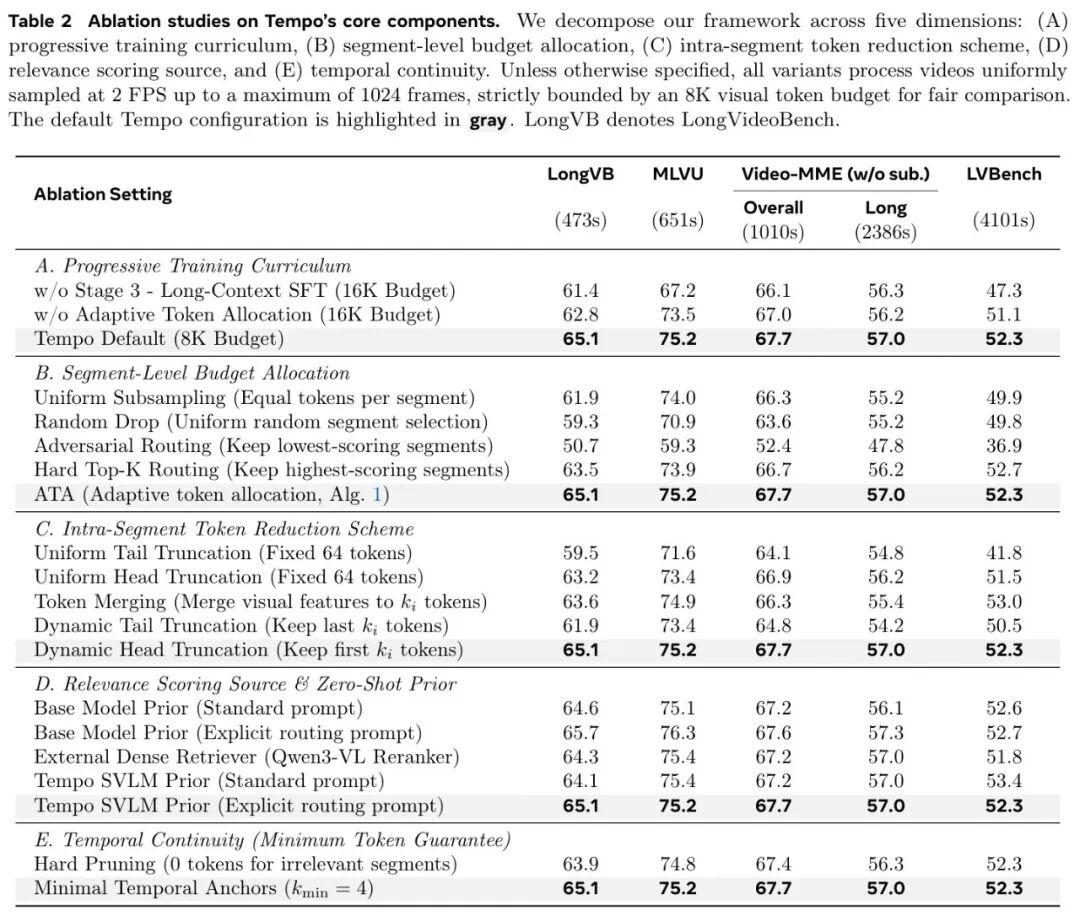
从上表可以得出几个关键结论:
- • 渐进式训练(A)是基石:没有最后的长上下文微调阶段,模型无法掌握处理长序列的能力(LVBench从52.3跌至47.3)。
- • 动态分配(B)远胜静态:使用对抗性(保留最不相关片段)或随机丢弃令牌的方法,性能急剧下降。证明了ATA相关性分数的准确性。
- • 头部截断(C)是最优选择:对比尾部截断,头部截断在所有数据集上表现更好,直接证实了“语义前置”假设的有效性。
- • 时间锚点(E)不可或缺:将不相关片段的令牌数压到0(硬剪枝),会破坏时间连续性,性能显著受损。保留最小锚点是维持故事线的关键。
📈 缩放行为:理解不同任务的“胃口”
最后,Tempo的扩展性分析也极具启发性。模型性能如何随着可用帧数和令牌预算变化?
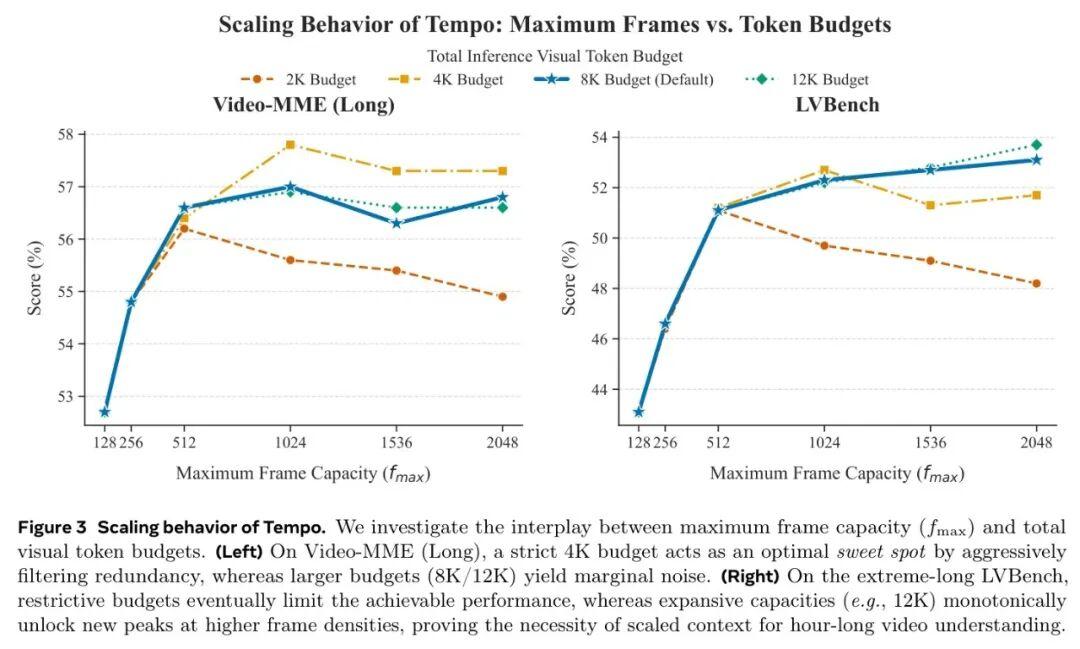
这张图揭示了资源分配的智慧:
- • 标准长视频(如Video-MME Long):在4K令牌预算、1024帧时达到性能峰值。继续增加预算(8K/12K)收益甚微。这说明对于30-60分钟的视频,4K预算已足够模型捕捉核心语义,多余的预算可能只是引入了噪声。
- • 超长视频(如LVBench):情况不同。随着帧数增加,更高的预算(12K)能持续带来性能提升。这意味着理解超过1小时的复杂叙事,确实需要更大的上下文容量来容纳更多线索。
- • 关键洞察:即便如此,在实际运行中,Tempo的ATA机制通常会将LVBench视频的实际令牌消耗压缩到远低于分配的8K或12K预算。这证明:真正的效率来自于按需分配,而非贪婪地填满所有可用空间。
⚖️ 客观评价与未来展望
当然,Tempo并非完美。它的局限性在于其零样本相关性先验虽然强大,但仍有提升空间。未来可以通过强化学习等方式,直接针对最终答案的准确性来优化压缩器的路由策略,可能带来进一步增益。
此外,当前的压缩是“一次性”的。面对多轮对话,如果用户的问题焦点转移,系统需要重新处理原始视频。一个更未来的方向是分层压缩,将持久的全局上下文与可按需调取的细节分离开,让LLM充当主动的查询代理,指挥压缩器在需要时对特定时刻进行深度蒸馏。
🌟 价值总结与行动号召
回顾Tempo的突破,它给我们带来了三个核心启示:
- 小模型有大智慧:通过精巧的架构设计(SVLM作压缩器),6B模型也能解决需要极大上下文窗口的难题。
- 意图驱动效率:长视频理解的瓶颈不是计算力不够,而是资源分配不智能。让问题指导压缩,是突破窗口限制的关键。
- 少即是多:更严格的、动态的预算约束,往往能逼出模型更高的信息提炼能力,从而提升性能。
这项技术为视频摘要、长视频问答、安防监控回溯、教育视频分析等众多场景,提供了全新的高效解决方案。它告诉我们,通往更强大AI的道路,不一定是堆砌更大的模型和更多的数据,而是进行更智能的设计和调度。
🤔 深度思考:你认为Tempo这种“问题感知的智能压缩”思想,除了视频,还能应用到哪些存在“信息过载”与“计算瓶颈”的AI场景(例如,超长文本、高分辨率图像分析、多传感器融合)?欢迎在评论区分享你的洞见!
💝 支持原创:如果这篇硬核解读让你对高效多模态AI有了新的认识,点赞+在看就是最好的支持!也请分享给你身边正在钻研AI效率优化的伙伴。
🔔 关注提醒:关注我们,持续获取最前沿、最深度的AI模型解读与技术干货!
#AI技术 #深度学习 #模型压缩 #多模态大模型 #论文解读 #效率优化
参考
Tempo