MemGuard-Alpha:通过成员推理和跨模型分歧来检测和过滤LLM金融预测记忆污染信号
“MemGuard-Alpha: Detecting and Filtering Memorization-Contaminated Signals in LLM-Based Financial Forecasting via Membership Inference and Cross-Model Disagreement”
金融分析中,大语言模型(LLMs)能力强大,在定向预测、收益预测和提取情绪等任务上优于传统方法,学术发表和行业应用增长迅速。
现有研究存在理论和实证方法困境,LLMs可能因记忆训练期交易信号结果而非分析市场行为得出高质量指标,出现“缩放悖论”。
本文提出MemGuard-Alpha框架,含两种新算法:一是MemGuard综合评分(MCS),结合五种MIA方法和时间临近特征,得出统一污染概率;二是跨模型记忆分歧(CMMD),利用多LLMs训练截止日期差异分离记忆驱动信号和真实分析推理信号。
评估显示,CMMD夏普比率达4.11,较未过滤信号提升49%;干净模型信号日均回报14.48基点,是受污染信号的7倍;信号准确性与污染分析呈现交叉模式,表明记忆会牺牲泛化能力提升表面准确性。
【 扫描文末二维码加入星球获取论文 】
摘要
大语言模型(LLMs)用于金融预测和生成阿尔法信号流行,但存在记忆历史数据导致过拟合和前瞻偏差问题,影响定量策略有效性。此前研究用MIA识别该问题并提出补救措施,但无实时交易环境下零成本信号过滤方法。
本文提出MemGuard-Alpha框架,含两种新算法:一是MemGuard综合评分(MCS),结合五种MIA方法和时间临近特征,得出统一污染概率;二是跨模型记忆分歧(CMMD),利用多LLMs训练截止日期差异分离记忆驱动信号和真实分析推理信号。
评估显示,CMMD夏普比率达4.11,较未过滤信号提升49%;干净模型信号日均回报14.48基点,是受污染信号的7倍;信号准确性与污染分析呈现交叉模式,表明记忆会牺牲泛化能力提升表面准确性。
简介
金融分析中,大语言模型(LLMs)能力强大,在定向预测、收益预测和提取情绪等任务上优于传统方法,学术发表和行业应用增长迅速。
现有研究存在理论和实证方法困境,LLMs可能因记忆训练期交易信号结果而非分析市场行为得出高质量指标,出现“缩放悖论”。
对2023-2025年164篇金融LLM研究的系统分析显示,各类偏差研究发生率均不超28%;从业者调查表明74%缺乏评估工具,50%认为缺乏工具和框架是减轻偏差的最大障碍。
FINSABER框架研究表明,评估方法有偏差时会夸大LLM衍生阿尔法的性能差异,消除偏差后差异消失,目前LLM未超越有效市场假说,此前阿尔法收益可能源于偏差而非市场无效。
已经提出了几种减轻前瞻性偏见的方法,每种方法都有重要的权衡。模型再训练方法有效但在前沿模型规模下成本高昂。匿名化方法会造成严重信息损失。推理时方法需为每个去学习目标训练模型对。
MemGuard-Alpha无需重新训练模型,不减少数据有用信息,可作为插件层集成到任何大语言模型中,框架包含MCS和CMMD两个新算法,用实际交易回报衡量去偏效果。
文本研究问题
RQ1:MIA 污染分数能否可靠检测大语言模型(LLM)金融预测是记忆还是生成,其检测能力是否受 MIA 算法、LLM 家族和参数规模影响。
RQ2:用污染分数过滤阿尔法信号能否提升样本外投资组合回报,新的 CMMD 算法是否优于简单设置阈值去除偏差。
RQ3:记忆导致的污染在不同模型规模、LLM 架构家族和最近训练数据年份上有何差异,大模型是否更易记忆金融信息。
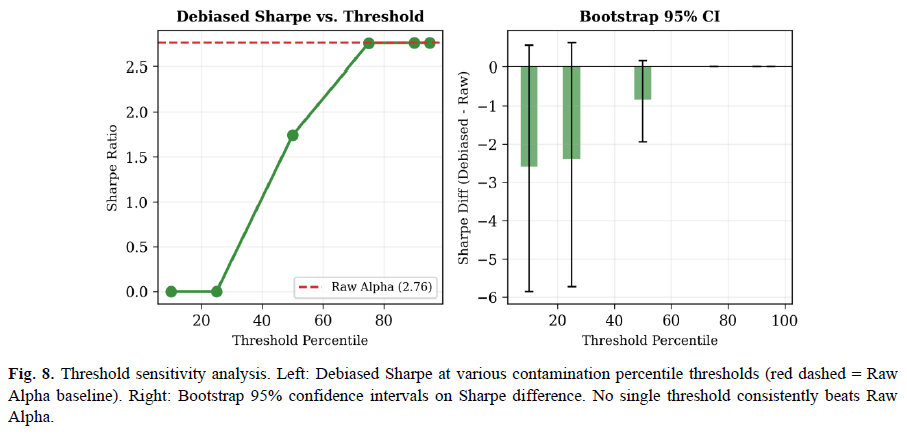
RQ4:去偏好处是否不受污染阈值选择影响,鲁棒性分析结果是否能证明使用无阈值 CMMD 算法合理。
本文主要贡献
提出 MemGuard 综合得分(MCS),结合 5 种 MIA 技术与时间接近度指标,Cohen’s d 达 18.57,远超最佳单一 MIA 技术。
提出跨模型记忆分歧(CMMD)去偏算法,使夏普比率提升 49%,干净信号日回报较污染信号增 7 倍。
首次在金融场景大规模验证基于 MIA 的记忆检测,涉及 7 模型、50 股票、42800 提示、5 种 MIA 技术和 5.5 年多市场数据。
发现信号准确率交叉现象,样本内准确率随污染水平上升而增加,样本外则下降,表明记忆会牺牲泛化性、虚增模型质量。
相关工作
金融LLM的前瞻性偏见
多项研究揭示金融大语言模型(LLMs)存在的问题:
Glasserman和Lin首次系统研究金融LLMs记忆问题,评估GPT情感分析的前瞻偏差;Lopez - Lira等证明GPT - 4o能准确记忆相关金融信息,且若模型记忆结果,其预测能力无法确定。Levy将研究拓展到数值推理问题;美联储研究表明LLMs宏观经济预测时时间感知模糊。Lee等发现LLMs存在多种偏差,如偏好大市值公司等;Cao等指出美国训练模型有“外国偏差”。这些结果表明金融LLMs的偏差问题是多维度的,需系统解决。
有效市场假说(EMH)表明,半强式版本下当前资产价格反映所有公开信息。若LSTM有预测能力,要么信息处理能力强,要么非法获取未来信息。“记忆”过去值会让LSTM有完美后见之明却假装提供预见,违背有效回测信息集假设。FINSABER框架显示控制偏差后LSTM的超额收益消失,与EMH预测一致,因此需识别和去除记忆污染信号。
多种偏差相互作用产生难以分解的复合效应。Kong等人发现金融应用中LLM有五种偏差且常共存,多数受访者认为现有工具检测偏差不足。MemGuard - Alpha框架可解决训练数据记忆导致的前瞻偏差问题。
相关研究不断增加,Magar和Schwartz证明记忆可人为夸大基准结果;Sarkar和Vafa实证表明预训练语言模型用于金融任务时有前瞻偏差;Yan和Tang开发DatedGPT防止时间信息泄露到网络规模语言模型。
LLM的成员推理攻击
成员推理攻击旨在判断信息是否在模型训练集中。Carlini等表明大语言模型比小模型更易记忆训练数据,且记忆多在低频序列;Shi等提出MinK% Prob确定语言模型记忆情况;Zhang等在此基础上开发Min - K++%。
可用参考模型方法比较目标模型和参考模型的损失,以分离模型特定记忆和通用语言能力。近期SoK指出多数MIA研究存在数据收集和分布偏移问题,可通过时间截断作为模型的真实情况来缓解。
Gao等首次将模型可解释性用于金融预测,用LAP分数证明过拟合会放大预测准确性,但未评估消除单个信号过拟合影响及评估整个投资组合过拟合总影响的方法。
MIA研究方法发展:早期用影子模型训练进行二元分类,近年多采用无参考或单参考方法,适用于金融场景,Duan等的SoK研究给出方法分类并强调实验设计关键选择,本文实验设时间截止日期确保成员/非成员区分的因果性。
MIA用于金融文档:记忆有不同粒度,包括具体数据点、整体趋势、统计关系等,本文三种方法分别检测不同粒度的记忆,损失法检测广泛熟悉度,Min - K%法针对特定实体记忆,参考模型区分模型知识和语言知识。
减少偏见的方法
现有缓解技术分三类:一是基于预防的方法,如 Time Machine GPT 等,限制训练数据时间范围,但扩展性差;二是基于匿名化的方法,如 entity-neutering 等,会降低输出信号质量且信息损失大。为此引入第四类推理时生成后信号过滤技术,对大语言模型输出进行污染评分并过滤,无需修改模型本身。
各类缓解方法各有取舍:理论预防(再训练)能最大程度防止前瞻行为,但增加计算成本和更新次数,对每日评估信号的对冲基金不具经济可行性,实时生成信号时或可行。匿名化成本低,但存在冲突,损失的信息往往多于去除的偏差。推理时方法(如Divergence Decoding)保留输入信息、修改输出分布,但需为每个目标领域和时间边界创建新模型对。
后生成过滤器是减轻记忆风险的替代方法,无计算开销,不拖慢推理流程,MIA评分可二遍进行,并行于不同模型和提示;改变预防记忆的思路,转向管理其对投资组合决策的影响,如同金融专业人士处理噪音和偏差,MemGuard-Alpha不防记忆,而是管理其对信号质量的负面影响。
本研究定位
MemGuard-Alpha独特之处在于结合检测与信号级过滤,无需修改模型,保留完整信息,提供投资组合级影响测量,跨多模型且有单模型时间感知。
MemGuard-Alpha
问题建模
M 是含 K 个自回归语言模型的集合,各模型有训练数据截止日期 c_k。对金融提示 x (关联股票代码 s 和日期 t),模型 m_k 生成 alpha 信号 α_k(x) 及置信度 γ_k(x) ,但 t < c_k 时 α_k(x) 可能是记忆而非推理。定义污染评分函数 ϕ(x,m_k) 量化记忆驱动可能。MemGuard-Alpha 分三阶段:(1)评分:用 MIA 方法计算 ϕ(x,m_k);(2)分区:将模型预测分为干净和受污染组;(3)交易:仅用干净共识信号构建投资组合。
数据源
研究使用三个数据集:一是 2019 年 1 月至 2024 年 6 月 50 只标普 100 成分股的每日 OHLCV 价格信息,涵盖多种市场行情;二是含 3100 条 2016 年前人工标注财经新闻语句的 Financial PhraseBank 语料库,作为“确定记忆”参考组;三是 2024 年 4 - 6 月按模型训练窗口模板收集的样本外控制提示,作为样本外对照组。
模型选择
评估7个分属4个架构家族的模型,CMMD中不同模型对同一提示的样本情况不同,如GPT-2家族样本内提示仅14.5%,TinyLlama和Phi-2约83%,Qwen模型92%,此梯度对RQ3很重要。
选7个模型基于三个标准:架构多样,涵盖4个家族;时间多样,有三个时间截点,便于同家族和不同家族模型比较;模型易获取,均为开放权重,可计算MIA分数所需的单字对数概率。
对7B Qwen模型进行4位量化以适应GPU内存,经对比量化和全精度Qwen 3B模型的MIA分数,证实量化影响可忽略。
MIA评分引擎
本文介绍五种记忆信息分析(MIA)方法:
损失(Loss):平均负对数似然,值越低表明文本在训练中越常见,计算简单高效。
Min-K% Prob:关注K%(K = 20)最低对数概率的标记,放大记忆信号。
Min-K%++:在Min - K%基础上对每个标记位置进行校准和z分数归一化,区分模型熟悉度和标记固有难度。
Zlib Ratio:模型损失与zlib压缩熵之比,区分复杂文本的真正记忆和简单文本的易预测性。
参考方法:目标模型损失与参考模型(GPT-2 base)损失之比,远低于1表明目标模型对文本更熟悉。
MemGuard综合评分(MCS)
无单一MIA方法在所有模型中占主导。MCS通过逻辑回归结合五种方法与时间接近性,
其中 τ (t, c k ) 归一化时间距离到 [ −1, 1],w、b 基于IS/OOS标签学习,MCS输出校准的 p(memorized | features)。
跨模型记忆差异(CMMD)
CMMD是核心算法,利用不同训练截止日期造成的记忆状态外生变化这一自然实验,对(股票代码s,日期t)观察K个不同污染程度模型的预测。
从理论上看,在无记忆偏差的原假设下,干净和受污染模型的平均信号相同;备择假设下,CMMD的差异δ(s, t)可估计记忆偏差,且中位数分割能使估计方差最小,是最有效的估计方法。
与固定阈值法相比,中位数分割法优势明显:一是能自动适应不同日期和股票的污染概率分布变化;二是可避免数据分区退化问题。
中位数分割法是学习/记忆的内在工具变量,利用模型训练截止日期的外生变化,将其转化为连续污染分数,再分割为两种离散处理,类似模糊回归断点设计,可将干净和受污染信号的差异归因于学习/记忆过程。
组合构建与评价
构建50只股票的日信号加权投资组合,考虑现实交易成本。每日股票持仓与策略信号成正比,收益计算公式为
TC为15个基点,换手率按股票信号平均绝对变化衡量。
比较六种策略:原始阿尔法、去偏阿尔法、CMMD、等权重买入持有、20日动量、随机策略。
通过夏普比率差异的自举置信区间(2000次重采样)评估统计显著性。
实验
算力
实验在RunPod云实例(NVIDIA GeForce RTX 5090 GPU)进行,用PyTorch 2.10.0 + CUDA 12.8。299,600 个提示 - 模型对的 MIA 评分约 4.5 小时,优化子集的 Alpha 生成约 6 小时,实验日志记录到 Weights & Biases 并按模型 checkpoint。7B Qwen 模型用 bitsandbytes 量化为 4 位以适配 GPU 内存。
提示词设计
三种提示类型探查不同记忆方面:价格回忆测事实记忆,如询问特定日期股票收盘价;情感提示测上下文记忆,如说明股价变动原因;前瞻性提示测预测记忆,如根据特定日期表现预测分析师预期。日期为 2019 - 2024 每五个交易日抽样。
Alpha信号生成
模型采用结构化提示,要求给出多空观点后做预测,产生60%看多、18%看空、22%中性信号,用特定参数生成数据。
为控制计算成本,按约每三天采样一次,共约5900个提示/模型,涉及93个交易日。
结构化提示分三部分,旨在减少过往情绪记忆影响、增加分析思考,但样本内准确率高于样本外,显示记忆影响决策。
每三天采样策略平衡处理时间与历史数据纳入,全流程处理约41300个提示 - 模型配对,93天涵盖不同市场状态,样本量可做MIA分离测试,但限制了投资组合层面的统计推断。
数据预处理和质量控制
价格数据质量控制:
用雅虎财经“调整后”收盘价做公司行动调整。
排除50只股票中收盘价缺失的交易日数据。
计算每只股票的前向一日回报率。
对每日回报率在0.5%和99.5%分位数进行缩尾处理。最终数据集涵盖2019年1月至2024年6月约1375个交易日。
MIA评分:
用模型原生分词器对文本提示进行分词。
超过512个标记的提示截断以适应小模型上下文窗口。
确定性计算五个MIA分数,确保可重复性。
结果
基于MIA的记忆检测(RQ1)
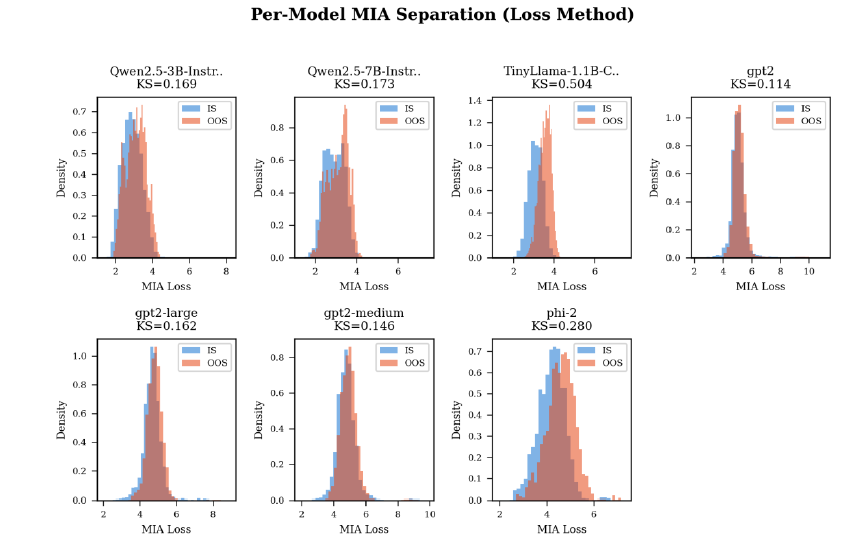
五种MIA方法在七个模型中均实现样本内和样本外提示的显著分离,图1展示了总体分布。
表3呈现34种有效模型-方法组合结果(排除GPT-2基础自引用组合),TinyLlama分离效果最强,GPT-2家族分离度随模型大小递增。34个KS检验p < 0.001,但四个t检验未达显著水平(p < 0.05)。
相关性分析显示mia_loss和mia_zlib高度相关,mia_ref提供独立信息。GPT-2家族MIA分离度单调增加,符合记忆缩放定律,大模型更易记忆金融提示中的低频独特信息。
TinyLlama虽仅11亿参数,但在金融记忆方面优于其他模型,表明训练数据质量和时效性比模型大小更重要。其训练数据涵盖83%测试提示,而GPT - 2仅14.5%,新模型易受基于记忆的前瞻偏差影响。
四个t检验中三个不显著,涉及Qwen模型家族和GPT - 2,Qwen架构的分词或注意力机制可能导致词汇概率分布不同,在基于损失和参考的MIA方法中仍有效。
MemGuard综合得分MCS的Cohen’s d达18.57,远高于单个方法。特征权重中时间接近性占主导,未知截止日期时MIA特征更重要。
d = 18.57结果显示,IS/OOS状态主要取决于训练截止日期,时间距离造成d = 17.8,占综合差异的96%,MIA特征贡献仅4%,各MIA方法独立估计d为0.39 - 1.37,大的综合d值主因是时间效应而非MIA方法。但在投资组合去偏背景下,二者重要性反转,时间距离为同日所有模型赋予相同污染分数,MIA特征为同日不同模型赋予不同分数,这是CMMD改善投资组合的基础,所以MIA特征对检测不重要,对CMMD投资组合增强至关重要。
投资组合表现(RQ2)
CMMD较Raw Alpha实现49%的夏普比率提升,较Debiased Alpha提升167%。信号 - 回报分解显示,干净模型信号日回报达14.48 bps,是受污染信号(2.13 bps)的7倍。
简单阈值去偏法(夏普比率1.54)表现不如Raw Alpha(2.76),阈值过滤会不分方向正确性去除高污染信号,CMMD用跨模型共识避免此问题。
CMMD与Raw Alpha的配对自助测试显示,夏普比率平均差异为+1.35(95% CI [-0.28, +3.12],p = 0.054),虽略超5%显著水平,但单边测试p = 0.027,信号 - 回报分解结果也支持CMMD机制,表明其改进经济上有意义,但需更长评估期获投资组合层面的明确统计确认。
需从经济角度看待 CMMD 表现:其清洁模型信号日均回报 14.48bps,年化毛回报率 36.5%,扣除 15bps 交易成本后净回报 43.2%,高于量化因子回报。但存在多个限制条件:一是 93 天测试期短,CMMD 夏普比率的自展置信区间大;二是测试处于 2019 - 2024 年疫情后强劲复苏及 AI 驱动行情,利于保留看涨信号的策略;三是等权重买入持有基准夏普比率达 5.6,该时期回报多源于市场贝塔而非阿尔法收益。
需特别考虑等权重买入持有策略跑赢等权重策略的情况。CMMD 是仅做多、按信号加权的策略,有大量净多头市场敞口,收益与市场贝塔相关。市场中性版本需对模型看好和看空的股票分别做多和做空,以去除市场贝塔影响、展现纯阿尔法收益,但操作复杂,本文未探讨。比较 CMMD 去偏贡献的正确基准是 CMMD 与原始阿尔法(二者市场贝塔敞口相同)而非 CMMD 与等权重买入持有(基于总回报)。同类比较中,CMMD 夏普比率 4.11,原始阿尔法为 2.76,经污染物过滤且扣除交易成本后,风险调整收益提升 49%。
分析发现简单去偏阿尔法策略(夏普比率1.54)表现显著逊于未过滤原始阿尔法策略(夏普比率2.76)。Bootstrap测试显示夏普比率差异为 -1.11,95%置信区间[-2.96,+0.42],p值0.91,无法拒绝简单去偏不能提升未过滤阿尔法的原假设。这并非多模型比较选择(MCS)未能检测到污染信号,而是检测污染信号与将其有效融入投资组合需不同算法。简单设置阈值去除高污染信号会破坏投资组合的信噪比,因高污染信号可能有正向作用。
信号精度与污染(RQ1/RQ2)
图5显示,随着污染水平上升,样本内(IS)和样本外(OOS)数据的信号准确性差异增大。样本内信号准确性随污染水平上升而增加(Q1的40.8%到Q5的52.5%),样本外则下降(Q2的47%到Q5的42%),在Q3出现交叉点,可据此用MIA污染分数区分记忆信号和非记忆信号。
该交叉模式可用统计学习理论中的偏差 - 方差权衡解释:低污染(Q1 - Q2)样本外信号源于模型的金融推理,偏差小但方差大;高污染(Q4 - Q5)样本内信号是模型结合记忆结果和金融推理得出,因记忆结果正确,样本内评估难发现偏差,但模型过度依赖记忆知识会导致预测性能下降。
用LLM生成交易策略进行回测时,研究者依据样本内曲线会认为LLM熟悉数据后准确率提升,但这是过拟合/记忆训练数据所致,实际部署时准确率会反转。样本外曲线显示过度熟悉历史数据会损害LLM预测质量,CMMD方法无需设定样本污染阈值。
尺度与时间效应(RQ3)
GPT-2 家族内,模型参数越多,分离度越大,表明大模型记忆更多。跨家族比较,TinyLlama(1.1B)虽仅比 GPT-2 Large(774M)大 1.4 倍,但分离度更强,说明训练数据时效性比模型大小更重要。Qwen 3B 和 7B 分离度相近,有饱和效应。近期训练的模型(TinyLlama、Phi-2)比旧模型(GPT-2 家族)IS/OOS 差异更大。
单模型信号分析
部分模型(TinyLlama、Qwen 3B、Phi-2)在训练数据内(IS)预测性能显著高于非训练数据(OOS),20-35 个百分点的差距表明预测能力因记忆被人为提高。
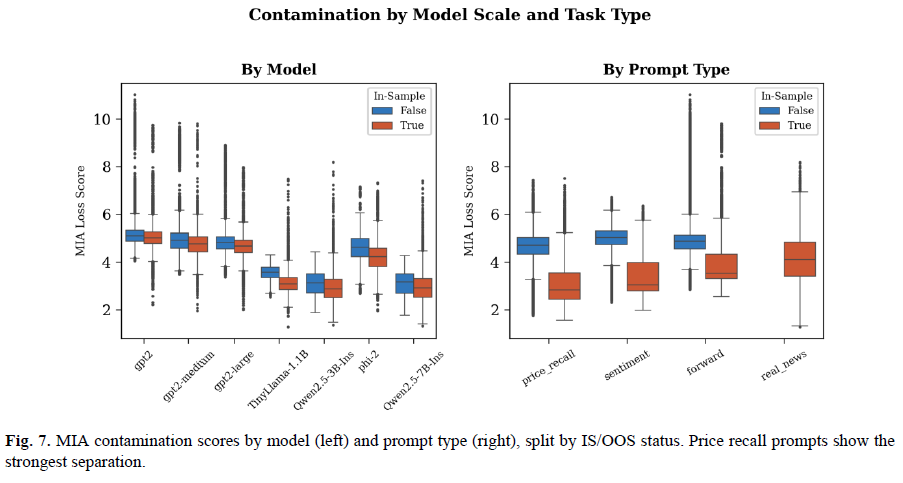
GPT-2 家族相反,IS 准确率比 OOS 低 10 个百分点,原因是 IS 集涵盖高市场波动期,OOS 处于低波动和牛市环境,说明应结合市场环境看待 IS-OOS 准确率差异。
Qwen 7B 模型规模最大,信号分布偏熊,IS 和 OOS 均产生负日平均回报,其看跌信号是反向的,可能与指令有关,剔除该模型时其他模型倾向看涨。
各模型信号分布多样,如 TinyLlama 最激进看涨,GPT-2 Base 最平衡。CMMD 中清洁组和污染组信号差异大,40.1%的股票-日期对信号分歧超 0.5,表明分组有意义。
跨股票结果显示,CMMD产生的回报非均匀分布。表现最佳的股票有特斯拉、高通等,最差的有耐克、英特尔等。高波动性和高新闻覆盖率的股票表现好,符合记忆假设,因有更多数据供模型训练;表现不佳的股票显示CMMD在市场条件差时创造阿尔法收益的局限性。
策略相关性分析
策略间回报相关性为理解 CMMD 机制提供洞见:CMMD 与 Raw Alpha 相关性高(0.984),保留其信号结构;LLM 策略与 EW Buy-Hold 相关性高(0.944、0.967),有显著市场 Beta 暴露;LLM 策略与 Momentum-20D 负相关(-0.54、-0.59),信号来源不同;随机策略有弱正相关(0.34、0.48),或因评估期市场上行。
CMMD 与 Raw Alpha 相关性高却实现 49% 的夏普比率提升,原因是该提升有条件:约 60% 股票-日期对中二者信号相同;约 40% 二者模型分歧时,CMMD 干净信号更准确,个体层面的条件改善带来组合层面夏普比率提升。
阈值鲁棒性(RQ4)
图8显示,简单基于百分位去偏本质上很脆弱:激进阈值(P10 – P25)会过滤所有信号(夏普比率为零),宽松阈值(P75 – P95)则不过滤(趋近原始阿尔法),无单一阈值能持续改进未过滤基线,这促使CMMD采用无阈值设计。
消融分析:MCS组件贡献
MCS组件贡献进行消融研究对比四种 MCS 变体:全六特征 MCS、仅 MIA 的 MCS、仅时间接近性的 MCS、单一最佳 MIA 方法。全 MCS 的 Cohen’s d 为 18.57,主要由时间接近性特征驱动;仅时间接近性变体的 d 为 17.8,达全 MCS 分离度的 96%;仅 MIA 变体的 d 在 0.39-1.37 之间;单一最佳方法的 d 在 0.19-1.37 之间。
检测任务主要依赖时间接近性,因其决定样本是否为样本内;去偏任务中 MIA 特征有额外价值,能捕捉时间接近性未体现的记忆强度,相同日期的相同股票的两个提示,时间接近性得分相同,但 MIA 得分可能不同,反映处理提示时记忆水平的真实差异。
对CMMD更大消融研究分析其集成模型数量,7模型集成夏普比率4.11,移除1个模型后6模型集成夏普比率3.72-4.28,显示CMMD对模型组合有一定敏感性,排除Qwen 7B表现优于预期;少于5模型集成方差增加,但最少模型测试时夏普比率仍超3.0;CMMD在至少5模型且至少2种截断时间周期时对模型选择较稳健。
讨论
发现重于预防的案例
本文围绕金融大语言模型(LLM)记忆处理展开讨论,介绍三种处理范式及CMMD方法优势:
时间再训练预防:如ChronoBERT、PiT - Inference,能产生纯净模型,但成本高、易过时,CMMD可事后处理,避免此权衡。
匿名化预防:如entity - neutering、BlindTrade,计算成本低但会破坏信号,CMMD能保留完整信息,在信号层面去偏。
检测与过滤(CMMD方法):将记忆视为LLM自然现象,在信号层面检测,不改变、不重训模型,不损失信息,能识别有用记忆,过滤污染信号。
为什么简单的去偏会失败
三种方法表明,使用基于阈值的过滤器去偏阿尔法(原始夏普比率 2.76;去偏过滤后 1.54)不如未过滤的原始阿尔法,这与去除记忆数据应提高准确性的假设相悖:
股票记忆情况异质,同一过滤器处理不同股票记忆问题不合理。
部分记忆信号偶然方向正确,过滤会剔除潜在盈利交易,CMMD 可加权评估。
激进过滤减少有效分散,使投资组合集中,CMMD 确保为每个股票日期对生成信号。
解释MCS特征权重
样本采集时间越近,被分类为MCS特征的可能性越大,这与数据收集方式有关。对于使用API模型且无时间元数据无法确定最佳截断点的部署,MIA是主要方法,仅用MIA时方法提供的污染信号值为d = 0.39 - 1.37。
连接到幻觉检测
金融记忆检测与幻觉检测相似,都区分记忆或幻觉响应与推理响应。研究表明早期层激活值可预测幻觉,MemGuard - Alpha用令牌概率分析检测非真实模型活动,跨域VAE解释性研究为检测模型不当行为提供通用框架。
检测记忆及解释模型功能的扩展方向:
对金融大语言模型进行SAE分析,确定记忆信息存储位置,通过特征消融识别影响记忆的输入特征。
用因果电路追踪分析模型使用记忆数据和进行分析推理时激活的神经网络路径,支持黑盒MIA方法并提供白盒机制见解。
借鉴幻觉检测技术,根据早期层激活识别模型基于记忆数据的预测,实现推理时记忆过滤。
实用部署指南
为将大语言模型(LLM)生成信号用于实盘交易系统,建议:1. 用不同截止点训练至少三个模型,每个模型至少有两个截止时间段;2. 用Min - K%法为每个信号计算MIA分数;3. 用CMMD替代阈值过滤;4. 监测图五模式诊断准确性和污染交叉情况;5. 使用LLM信号交易分析师重点覆盖的大盘股时要格外谨慎;6. 模型更新时更新污染情况。
计算成本和可扩展性
计算开销:MemGuard - Alpha 管道分三阶段,阶段 1(MIA 评分)开销大,约占生成成本 15%,使总管道开销约为未过滤 alpha 生成的 1.15 倍,且与模型和提示数量线性相关,可跨 GPU 并行;阶段 2(MCS 计算)和阶段 3(CMMD 分区)开销可忽略。
生产环境可扩展性:需考虑三方面,模型数量 5 - 10 个为宜;股票范围扩大成本线性增加但可利用 GPU 并行;MIA 分数有时间持久性,可缓存并定期刷新以降低成本。
闭源 API 模型适配:多数 API 无法获取逐词对数概率,可通过完成的对数概率近似损失评分、用提示文本计算 zlib 比率;API 兼容的 MCS 变体用损失和 zlib 特征可实现一定分离效果,已知截止日期时,时间接近特征也能提供强分离。
局限性
93个交易日样本有限,统计效力不足,需约250个交易日达80%效力。
模型参数仅7B,前沿70B+模型可能有不同记忆模式。
阿尔法信号用结构化提示而非微调模型。
MCS在评估数据上训练有过拟合风险,但因时间接近特征以确定性公式计算、CMMD中值分割为非参数操作而缓解;因GPT - 2模型提示覆盖不平衡,暂无法进行时间验证,后续将用k折交叉验证和向前滚动测试解决。
评估期(2019 - 2024)多为牛市,或有利保留牛市信号的策略。
总结
本文开发MemGuard-Alpha框架检测和过滤大语言模型金融数据预测中被记忆污染的信号,MCS和CMMD算法使未过滤信号夏普比率提高49%,MCS提供单一污染度量,CMMD能过滤记忆信息,清洁信号日回报约为污染信号的7倍。
四个实证结果支持结论:MIA可跨模型识别金融记忆;CMMD表现优于未过滤和阈值去偏信号;记忆在数据规模和时效性上有差异;简单阈值法不稳定,促使采用CMMD。信号准确性交叉表明记忆提升模型表面质量却损害泛化能力。
未来工作:通过API让CMMD接入更大语言模型,在更长时间和其他资产上验证,研究其与机制可解释性的关系,开发用于实时交易的在线自适应版本。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
