云端跑Qwen3,本地调用!算网Qwen3镜像上线
阿里的Qwen3,当前仍然是非常强的开源模型之一。
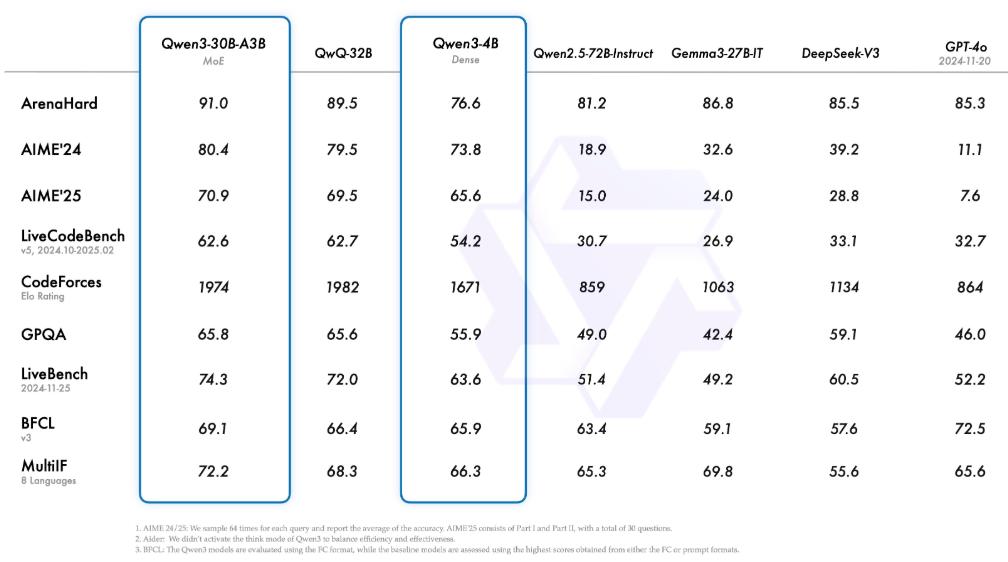
Qwen3-1.7B/4B/8B/14B/32B-Base 分别与 Qwen2.5-3B/7B/14B/32B/72B-Base 表现相当。
特别是在 STEM、编码和推理等领域,Qwen3 基础模型的表现甚至超过了更大规模的 Qwen2.5 模型。
Qwen3 支持 119 种语言和方言,具备强大的多语言指令跟随与翻译能力,而且模型的 Agent 和 代码能力得到了增强。
支持 128K tokens 的超长上下文窗口,并具备思考与非思考模式无缝切换的能力,被称为“混合推理模型”。对简单需求可低算力“秒回”答案,对复杂问题则可多步骤“深度思考”。
如果你想尝试开发智能客服与对话系统、电商等领域专属AI助手、RAG知识库系统、智能问答应用等,或者只是想在本地尝试大模型,又苦于没有能跑的电脑,快来算网部署一个吧。
Qwen3 8B 镜像已经上线算网,云端部署,本地调用,就跟自己电脑上跑一样。
首先打开官网:https://sumw.com.cn/,立即体验。
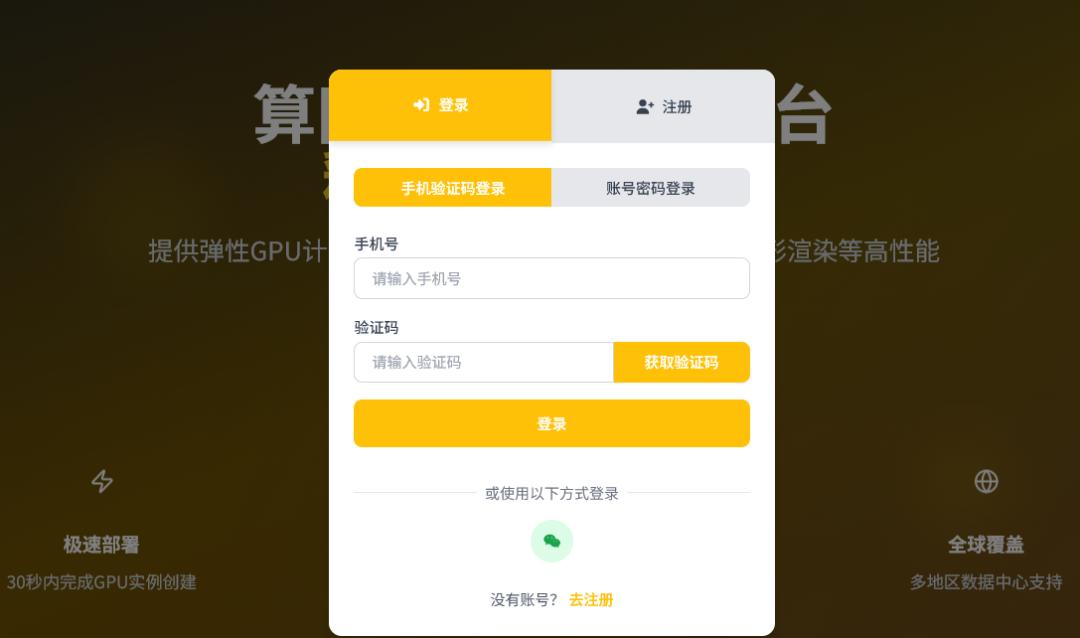
输入手机号,接收验证码登录。
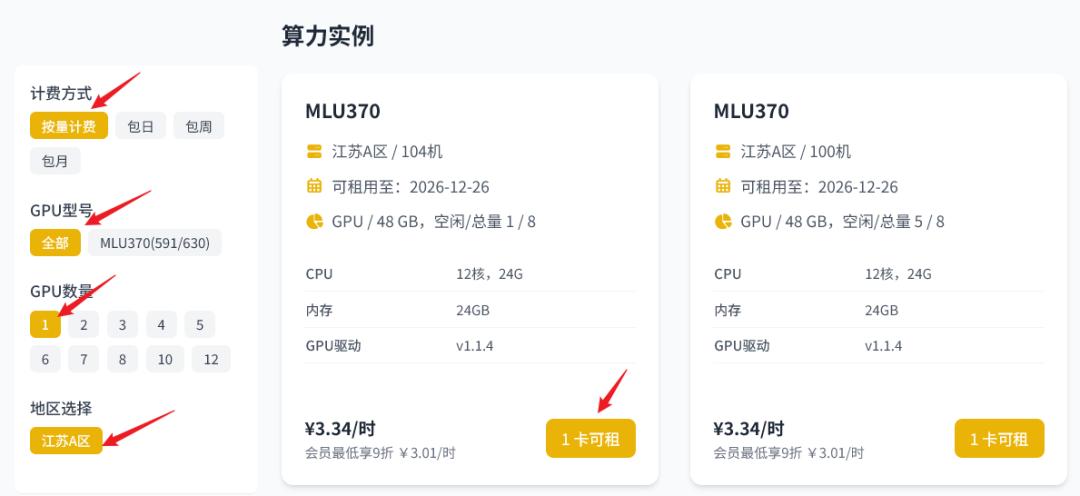
进入算力市场选择GPU。
下拉找到镜像,社区镜像,点击选择vllm-qwen3镜像,选择版本,确认租用。
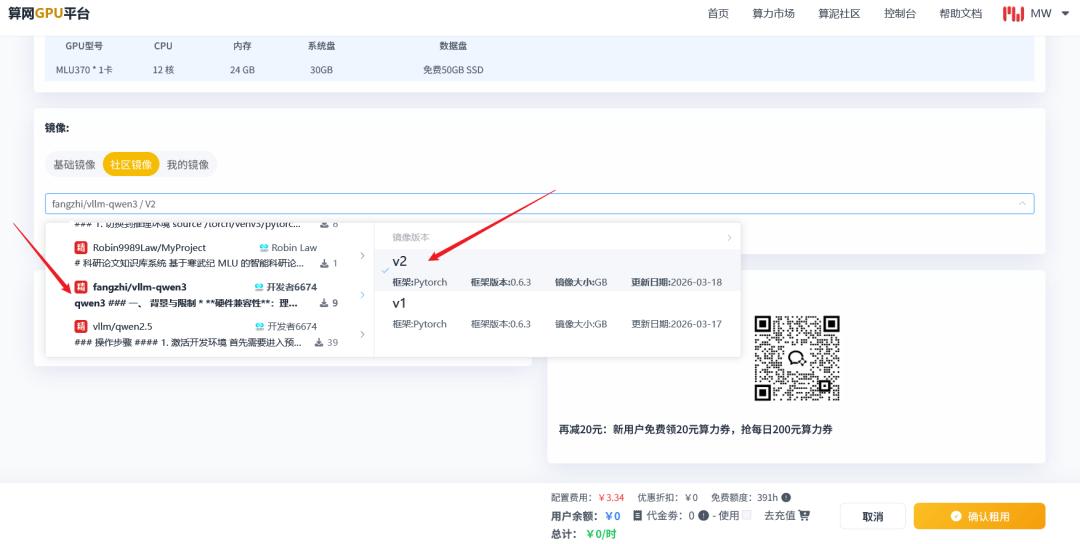
等待启动。
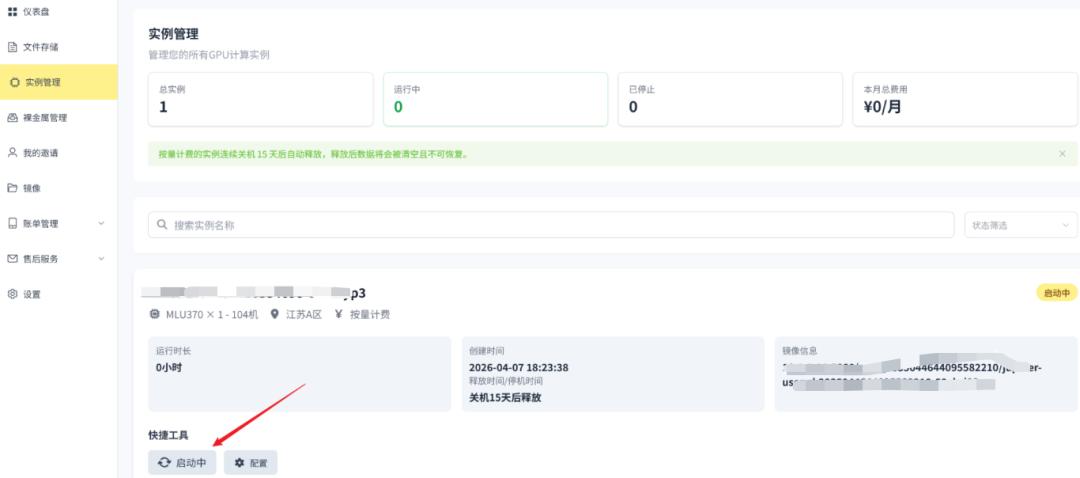
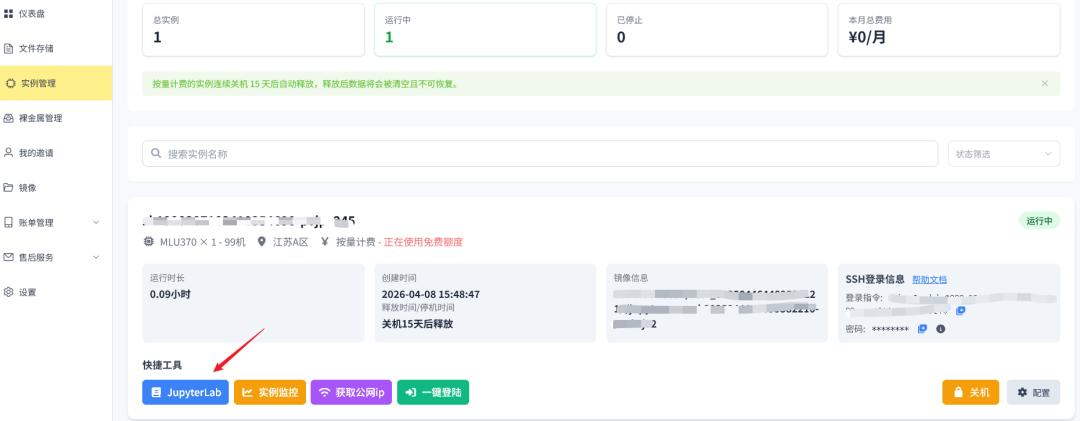
点击jupyterlab登录。
登录后界面是这样的。
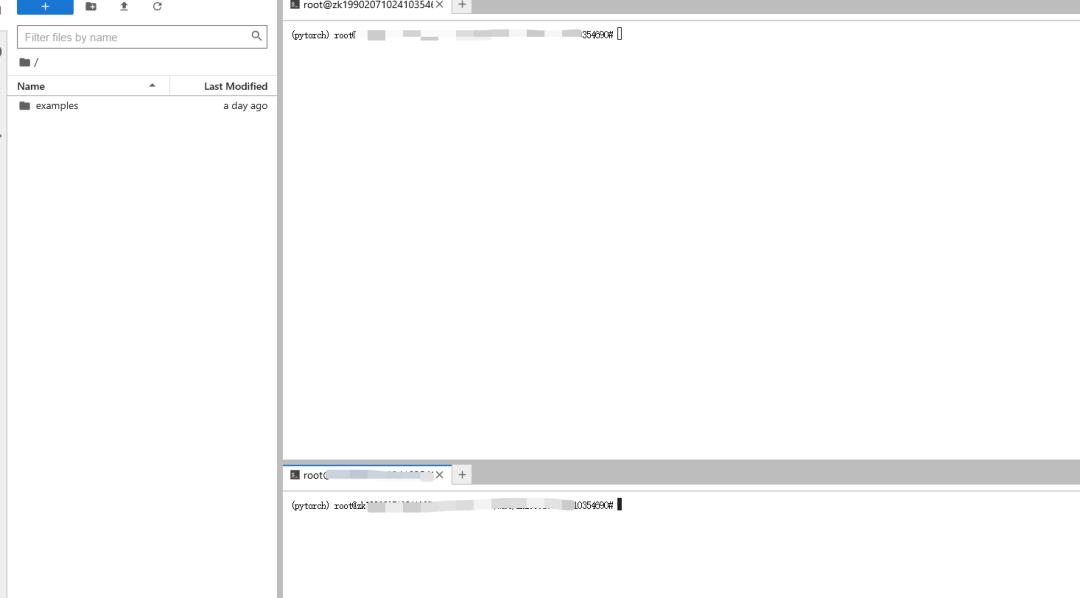
然后依次按照下列操作步骤完成,即可体验Qwen 3。
步骤 1:激活开发环境
首先进入预置的 Python 虚拟环境,执行以下命令:
source /torch/venv3/pytorch_infer/bin/activate
步骤 2:启动 vLLM 推理服务端
使用以下命令启动兼容 OpenAI 接口的服务,可根据自身硬件情况调整参数,命令如下:
python3 -m vllm.entrypoints.openai.api_server
--model ./Qwen3-8B
--served-model-name Qwen3-8B
--device mlu
--dtype float16
--host 0.0.0.0
--port 6006
--api-key hahahaha
--trust-remote-code
--max-model-len 10000
--block-size 10000
--max-seq-len-to-capture 10000
--gpu-memory-utilization 0.95
--disable-log-requests
关键参数说明:
--port 6006:服务监听端口,可自行修改,需保证后续调用时端口一致
--api-key:接口访问的鉴权密钥,可自行修改
--gpu-memory-utilization 0.95:MLU 显存占用率上限设置为 95%,可根据硬件情况调整
步骤 3:设置远程访问 (SSH 隧道)
由于模型运行在远程服务器,需要在本地电脑通过 SSH 隧道将服务器的 6006 端口映射到本地,才能实现本地访问。
带跳板机的指令格式:
ssh -L 6006:127.0.0.1:6006 -o ProxyCommand="ssh -p [跳板机端口] [跳板机用户]@[跳板机 IP] -W % h:% p" [目标机器用户]@[目标机器 IP]
使用示例(需根据自身服务器信息修改对应参数):
ssh -L 6006:127.0.0.1:6006 -o ProxyCommand="ssh -p 2202 admin@222.92.222.140 -W % h:% p" root@10.244.3.203
执行指令后,按提示依次输入跳板机和目标机器的密码,连接成功后,即可通过本地的 127.0.0.1:6006 地址访问远程模型服务。
步骤 4:本地 Python 调用示例
使用 OpenAI 官方 SDK 进行调用,完整代码如下:
from openai import OpenAI
初始化客户端,端口、api_key 需与服务启动命令中的配置完全一致
client = OpenAI(
base_url="http://127.0.0.1:6006/v1",
api_key="hahahaha"
)
创建对话请求,model 名称需与服务启动命令中的 --served-model-name 完全一致
completion = client.chat.completions.create (
model="Qwen3-8B",
messages=[
{"role": "user", "content": "你好"}
]
)
输出模型回复内容
print(completion.choices[0].message.content)
三、重要注意事项
端口一致性:启动命令使用的端口,必须与 Python 代码中 base_url 的端口完全一致(示例中为 6006,若修改端口需同步更新)
模型名称一致性:Python 代码中的 model 参数,必须与启动命令中的 --served-model-name 参数值完全一致
显存溢出处理:若服务启动失败,可尝试调小 --max-model-len 参数值,或降低 --gpu-memory-utilization 的数值
访问报错说明:若访问http://127.0.0.1:6006/v1出现 “URL 拼写可能存在错误,请检查” 的报错,通常是因为远程推理服务未成功启动、SSH 隧道未正常连接,或本地与服务端的端口配置不一致导致,需逐一排查上述配置项
快来试试吧。