成本降70%!清华、阿里通义带来智能体长程任务新解法
AI智能体面对需要多轮搜索与推理的复杂长程任务时,经常会上下文超载,出现遗忘或推理崩溃,这是当前制约AI发展的一大瓶颈。
全世界都在想办法解决AI智能体的长程记忆问题。
清华大学与阿里巴巴通义实验室的研究人员提出了新解法。
他们提出了自我记忆策略优化算法MemPO,赋予了大模型主动管理记忆的能力,在多目标复杂任务中实现了惊人的突破。智能体的准确率大幅飙升,消耗的计算资源降低了近七成。
智能体的长程失忆
人们对智能体能处理深度调研、数据分析、复杂代码编写等长程决策任务的期望越来越高。
当下最主流的智能体交互方式,是让智能体观察环境、进行思考、采取行动,然后将环境反馈附加到之前的交互历史中,作为下一次行动的提示词。
随着交互轮数的增加,上下文长度会呈线性爆炸式增长。
这样很快就会触及大模型有限的上下文窗口,还会带来极其昂贵的Token消耗。
智能体系统在实际业务中难以大规模部署,高昂的成本是核心阻碍因素。
冗长的上下文会,引发行“迷失在中间”现象,模型在处理超长文本时,会忽略掉夹在中间的关键信息,直接导致智能体的整体性能直线下跌。
为了解决这个问题,研究人员之前尝试为智能体引入记忆模块。
主流方案是构建一个外部知识库,利用检索增强生成(RAG)技术,在需要时检索相关的历史信息,并拼接到提示词中。
这种离线压缩记忆的方法,缺乏与智能体核心任务目标的联合优化。
外部检索完全基于文本向量的相似度,找出来的东西不一定是对解决问题最有用的。智能体依旧是被动地接受检索结果,没法发挥自身的能力去主动挑选和组织关键信息。
为了打破这种被动局面,研究团队重新定义了智能体的交互范式。
智能体不再是被动接收者,而是能够使用特殊的标签,自主提炼和重组历史信息。
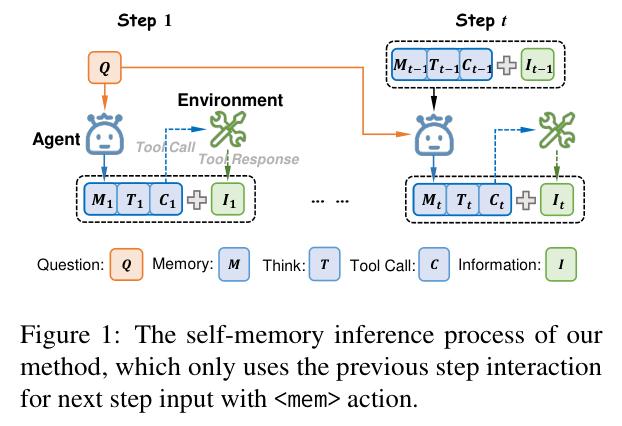
智能体在交互中会输出记忆、思考、工具调用三种具体动作。
在推导下一步操作时,模型彻底丢弃了早期的海量上下文,仅使用包含上一轮有效信息浓缩的记忆块作为输入。
这种将记忆管理内化为智能体自身能力的设计,为解决长程任务奠定了基础。
教会模型自己写备忘录
为了让智能体真正掌握提炼高质量记忆的技巧,研究团队将强化学习(RL)机制应用到了智能体记忆优化领域,但却面临着奖励分配的难题。
在常规的组相对策略优化(GRPO)强化学习算法中,模型通过对比一批候选轨迹的最终结果来调整自身策略。只要最终给出的答案正确且格式合规,整条轨迹上的所有输出步骤都会获得相同的奖励分数。
这种轨迹级别的全局奖励过于粗放。在一场耗时十几轮的交互中,如果最终答对了,模型根本无法分辨出到底是哪一轮生成的记忆起到了关键作用。针对记忆生成的反馈信号极度稀缺,无法有效指导模型留下最相关的破题线索。
针对这个痛点,研究团队专门设计了自我记忆策略优化算法(MemPO)。
这套算法打破了“吃大锅饭”的奖励机制,为记忆内容的生成,单独设计了一套细粒度的打分标准。
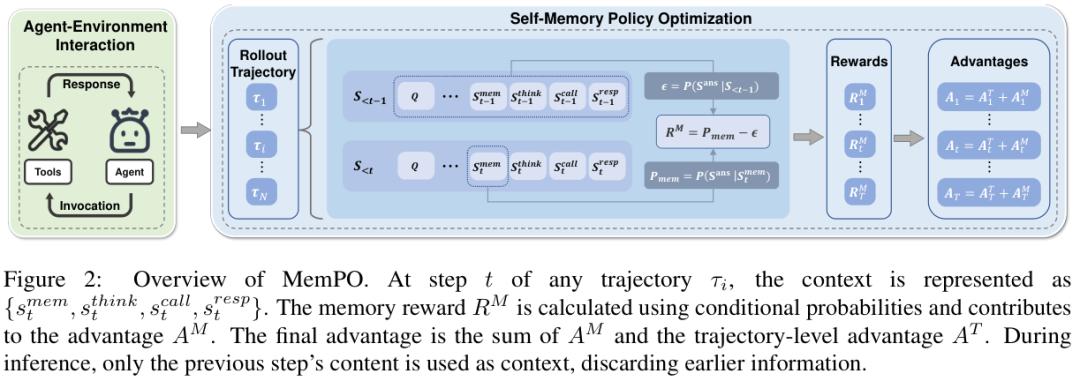
框架图可以发现,在任意轨迹的特定步骤中,上下文被精简为记忆、思考、工具调用和工具响应四部分。
算法在评估模型表现时,不仅会保留传统的轨迹级奖励,还会专门针对记忆部分计算一个独立的记忆奖励。
最终在更新模型策略时,属于记忆标签内的Token会同时接收到轨迹级和记忆级的双重奖励加持,普通的推理和工具调用Token则只依靠轨迹级奖励进行优化。
这种差异化的信度分配,有效地引导智能体将最核心的信息沉淀到记忆模块中。
用概率衡量记忆含金量
设计独立的记忆奖励听起来符合逻辑,具体该如何用数学语言去客观量化一段摘要的好坏。
研究人员回归到了语言模型的概率本质上找到了突破口。
大模型输出任何内容的底层逻辑都是基于前置上下文计算条件概率。
如果一段上下文中包含了足够多解决目标问题所需的关键信息,模型生成正确答案的概率必然会相对较高。
反过来推导,如果给定一段记忆,模型依据这段记忆生成标准答案的条件概率越大,就说明这段记忆保留的有效信息越丰富,对解决问题越有帮助。
MemPO算法直接将这种条件概率作为衡量记忆质量的定量指标。
每一轮交互产生的记忆都会被用来测试,看它多大程度上能提升最终正确答案的出现概率。
为了消除不同轨迹本身难易程度带来的偏差,算法还引入了基线偏置项进行校准,确保奖励信号真正反映了记忆浓缩历史信息的真实水平。
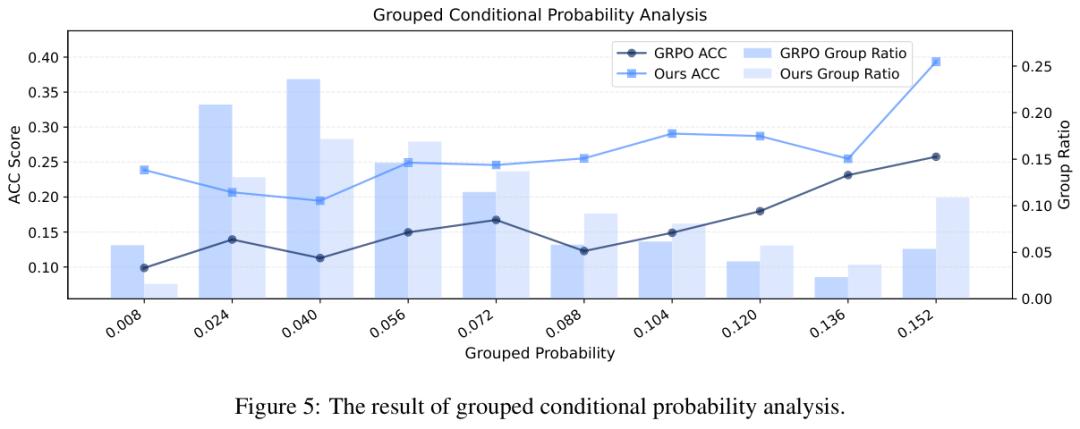
上图展示了带有记忆的模型,与采用普通强化学习算法的基线模型,在条件概率上的分布差异。
横轴代表条件概率的分组数值,柱状图反映了各个概率区间内记忆样本的占比。
采用新算法的模型在更高概率区间分布了更多的样本。
折线图的走势更是印证了这一设计思路,概率越高的分组对应的平均准确率确实更高,充分证明了通过概率来打分能够切实推动模型生成有助于解题的高质量记忆。
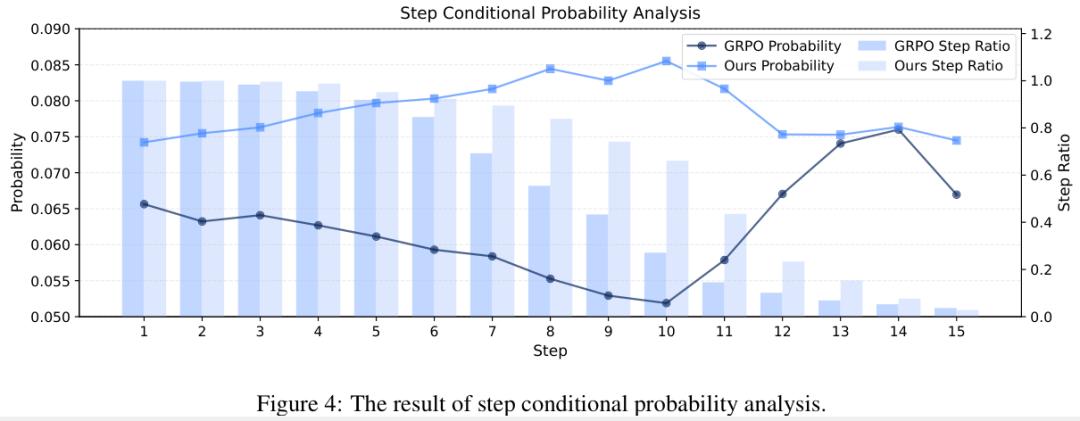
从随交互步骤变化的概率分析来看,包含10个检索目标的复杂任务前10步中,新算法对应的平均概率处于稳步上升状态。
智能体在这个阶段正在有效积累和组织有价值的线索。
在10步之后概率开始回落,符合实际业务逻辑,由于常规搜索大约10步就能完成,继续搜索通常意味着关键信息极难获取。
这种精准的步骤趋势反映了模型记忆组织的真实动态过程。
少花钱多办事的长程实测
为了检验新算法在真实复杂场景中的表现,研究团队构建了一个多目标任务测试集,要求智能体在问题中逐步挖掘线索,难度随着所需查找的目标数量成倍增加。
所有参与对比的方法统一采用了Qwen2.5系列的7B参数规模作为基础模型。
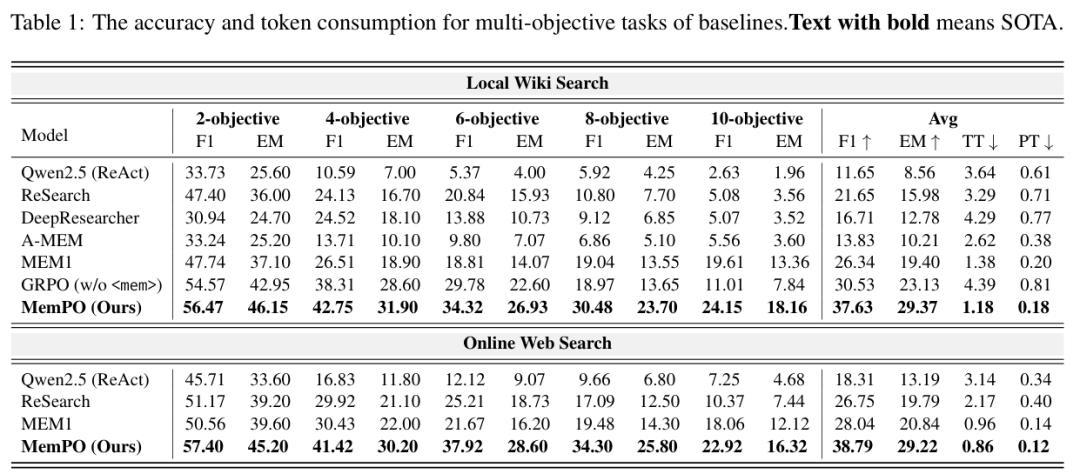
在精确度指标上,MemPO算法相较于基础模型取得了25.98的F1分数绝对增长,比之前最前沿的同类基线方案高出了7.1分。
即使面对难度远超训练集的包含10个目标的极限测试,智能体的表现依旧坚挺。不仅准确率高,它还极其省钱。
智能体解决单个问题消耗的总Token数,以及单步最高消耗Token数分别暴降了67.58%和73.12%。
在处理10目标任务时,传统智能体基线方法消耗的Token数量,大约是新算法的3倍,单步资源峰值更是高达5倍。
为了彻底摸清各种因素对最终结果的贡献度,研究人员剥离各个变量进行了消融测试。
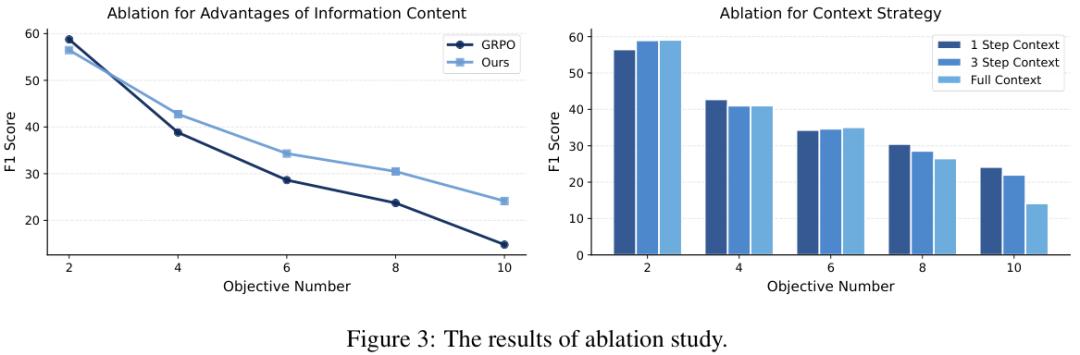
左侧图表显示,引入独立的记忆奖励信号让模型性能实现了肉眼可见的爬升。
右侧图表则显示,给智能体提供完整的历史上下文,在处理短任务时或许还有点帮助,一旦任务周期拉长,保留的交互步骤越多,智能体的性能衰减得越快。
海量的冗余信息不仅没有成为助力,反而稀释了模型的注意力,拖垮了推理能力。
这从侧面强有力地证明了由智能体自主浓缩单步记忆这种极简策略的前瞻性和必要性。
智能体与物理世界或网络环境的交互,是一场充满未知与噪声的长跑。
将记忆生成、逻辑推理和工具调用深度绑定,依靠严密的数学概率作为反馈尺度,智能体掌握了像人一样抓重要的记住的能力。
该研究目前也有一定局限。
评价机制受限于工具调用带来的信息量波动,在计算同一组内多条不同轨迹的相对分数时会产生些微偏差,研究人员在公式中加入的偏置项只能起到一定的缓冲作用。
想要让这项技术在现实业务流中落地生根,还需要在复杂的开放环境中接受进一步的打磨。
算力成本逐渐成为大模型普惠的阻力。
这种花小钱办大事的算法突破,一定会成为下一代高级智能体架构的标配方案。
参考资料:
https://arxiv.org/pdf/2603.00680
https://huggingface.co/collections/NewBeeKing/mempo
https://github.com/TheNewBeeKing/MemPO