上交大×OPPO综述Agent外部化:记忆・技能・协议・Harness大一统
今天和大家聊聊我们最新的综述,希望通过一篇文章融会贯通记忆、技能、协议和Harness等智能体领域关键的概念和能力,我们认为他们本质都是Agent外部化的一个维度,最终殊途同归。
我们联合了上海交大、中山大学、卡内基梅隆和OPPO研究院在内的十几位研究者,梳理了从2022年到2026年几乎所有重要的Agent研究,我们发现的一个被绝大多数人忽略的真相:
LLM Agent 的进步,已经不再主要靠更大的模型、更多的参数了。未来真正决定 AI 能力上限的,是 "外部化"—— 把原本需要模型内部解决的认知负担,系统地转移到外部的基础设施中。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这不是某个人的观点,这是整个行业正在发生的、但绝大多数人还没看清的范式转移。如果你现在还在天天等 GPT-6、等 Gemini 4,觉得只要模型足够大,所有问题都会迎刃而解,那你很可能会错过AI下一个时代最大的机会。
这里我们把这篇综述的核心观点讲透,告诉你什么是 "外部化",为什么它比大模型本身更重要,以及这个变化会给创业者、从业者和普通人带来什么样的机会。
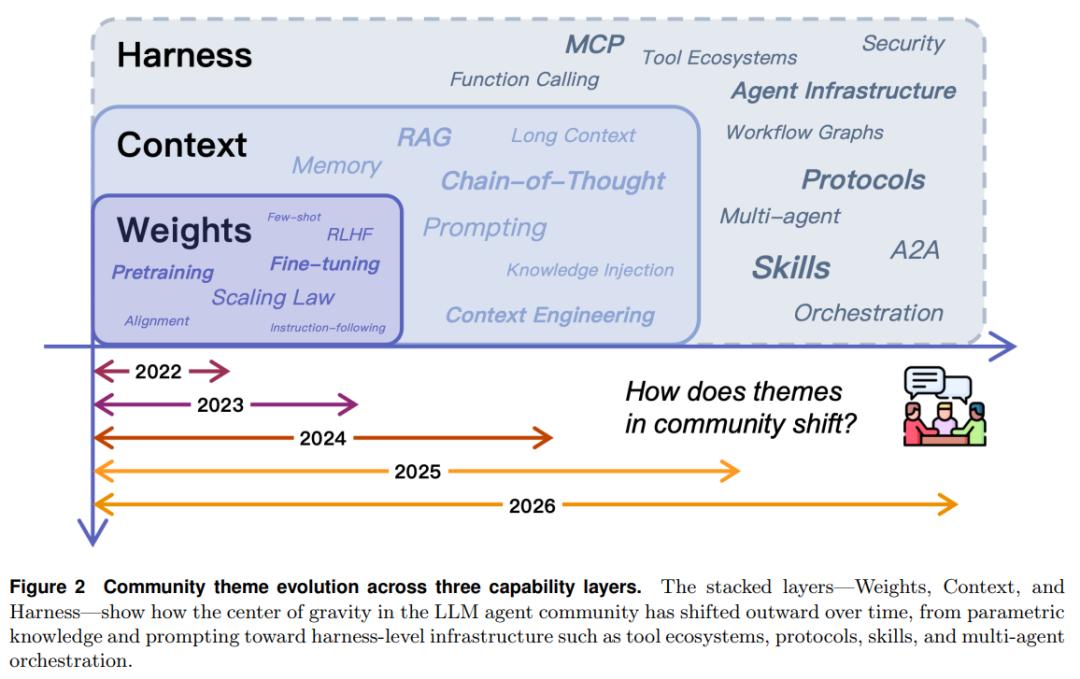
首先,我们先回顾一下 AI 能力演进的三个阶段。论文把它总结为:从权重时代,到上下文时代,再到现在的认知环境(Harness)时代。
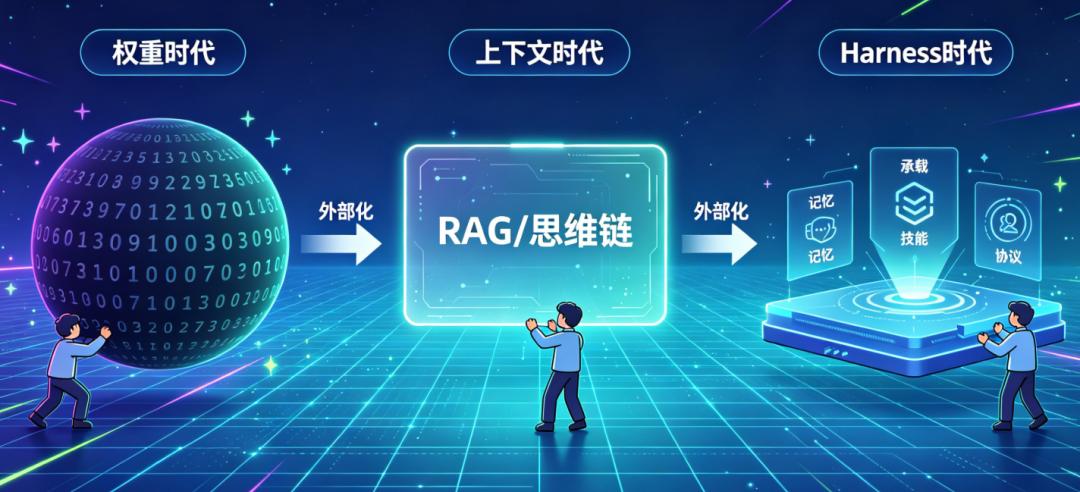
第一个阶段,权重时代,也就是 2022 年之前。那个时候所有人都相信,AI 的能力完全等于模型的参数。
你想让 AI 更聪明,唯一的办法就是堆更多的参数、喂更多的数据、花更多的钱训练。这个逻辑在当时是对的,因为所有的知识、推理、技能,都被压缩在模型的权重里面。
但很快大家就发现了问题:权重里的知识是静态的,更新一次要花几千万甚至几个亿;权重里的行为是黑箱的,你永远不知道它为什么会做出某个决定;权重里的能力是通用的,你没法让它专门学会你们公司的内部流程。
于是就进入了第二个阶段,上下文时代,也就是 2023 到 2024 年。这个阶段的核心逻辑是:能力不在权重里,而在上下文里。
你不用重新训练模型,只要把正确的信息放在提示词里,模型就能用它解决问题。
于是我们看到了 RAG,把外部文档检索进上下文;看到了思维链,把推理步骤写在上下文里;看到了工具调用,把工具的描述放在上下文里。
一时间,提示词工程师成了最火的职业,所有人都在研究怎么写更好的提示词。
但上下文时代也有它的天花板。首先,上下文窗口再大也是有限的,而且越长越贵,还会出现 "中间丢失" 的问题;其次,上下文是临时的,会话一结束,所有的状态都没了;
最重要的是,当任务变得越来越复杂,需要几十步、上百步的操作,需要跨会话、跨天的执行,纯靠提示词根本 hold 不住,很容易出错、跑偏、陷入死循环。
就在这个时候,整个行业进入了第三个阶段,也就是认知环境(Harness)时代。Harness 这个词,直译是 "马具",也可以翻译成 "认知脚手架" 或者 "运行时环境"。
它的核心思想就是:既然模型内部解决不好这些问题,那我们就把它们全部移到模型外面去。
这就是 "外部化" 的本质:把原本需要模型在脑子里完成的记忆、规划、协作、控制,全部变成外部的、显式的、可复用的、可管理的组件。
模型只需要做它最擅长的事情:基于给定的信息进行推理和判断。其他所有的脏活累活,都交给外部的基础设施。
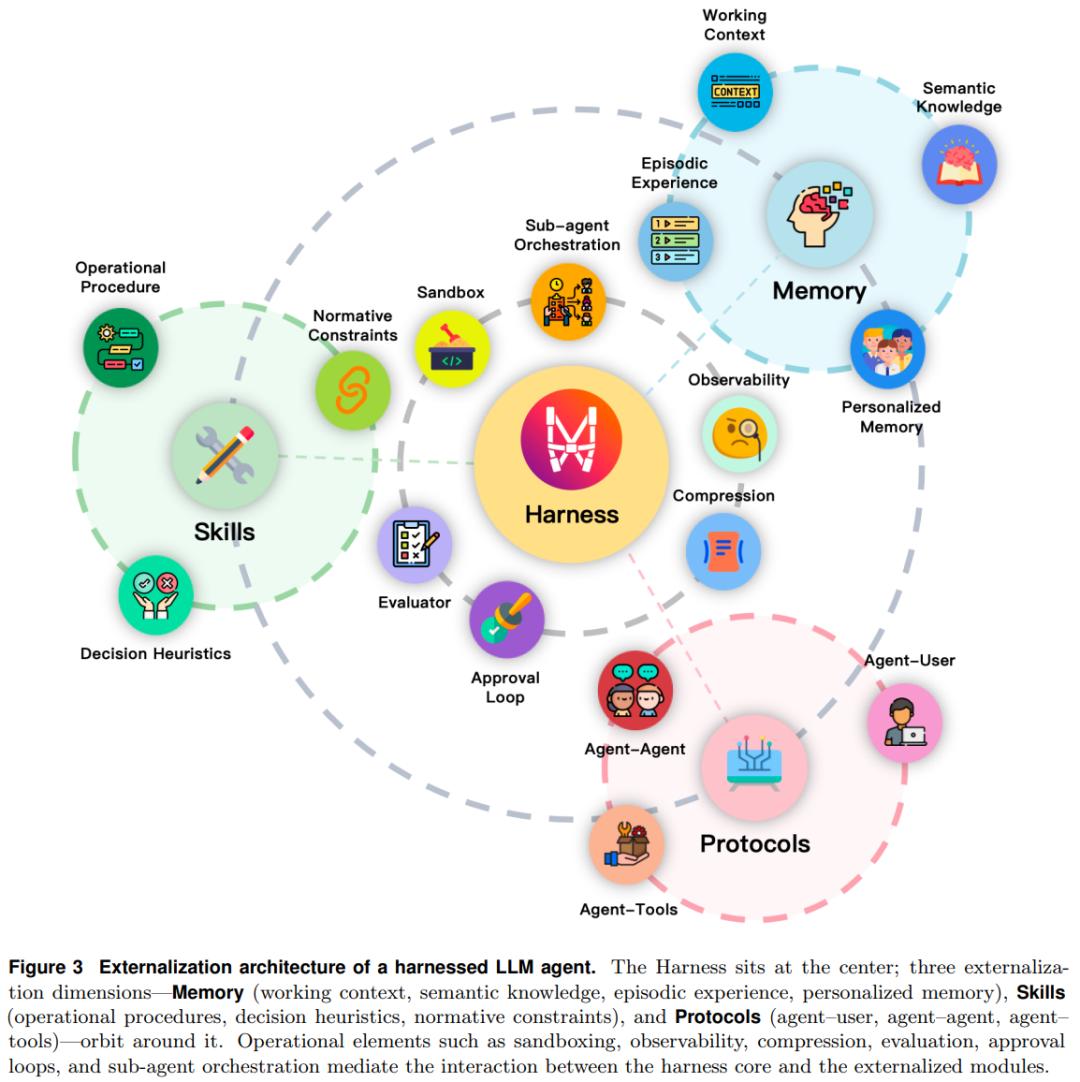
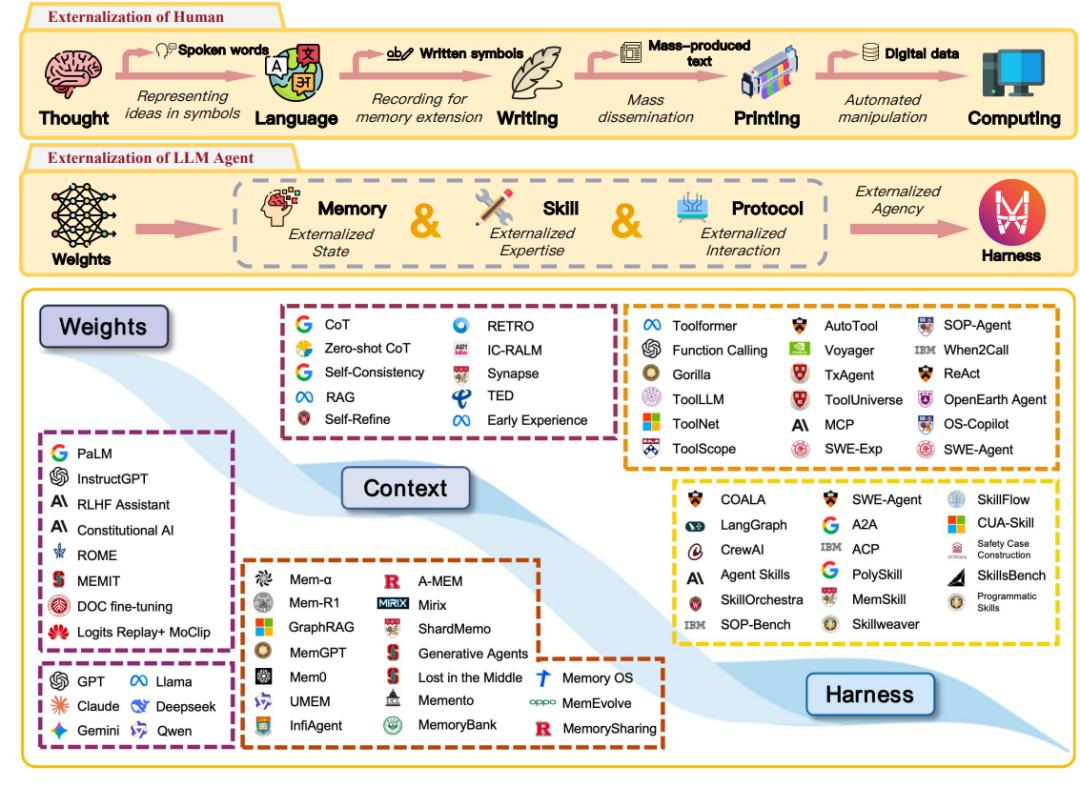
其实这个逻辑跟人类文明的进步是一致的,本质上就是一部认知外部化的历史。我们用语言把思想变成可分享的符号,用文字把记忆从大脑转移到纸张,用印刷让知识大规模传播,用计算机把计算和逻辑外包给机器。
每一次外部化,都没有让人类变笨,反而让我们能处理更复杂的问题。
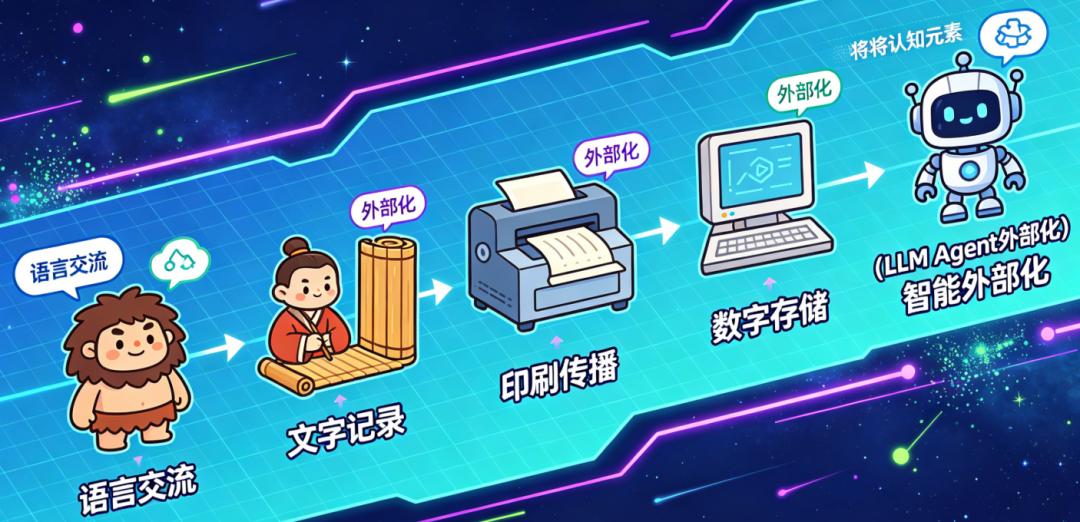
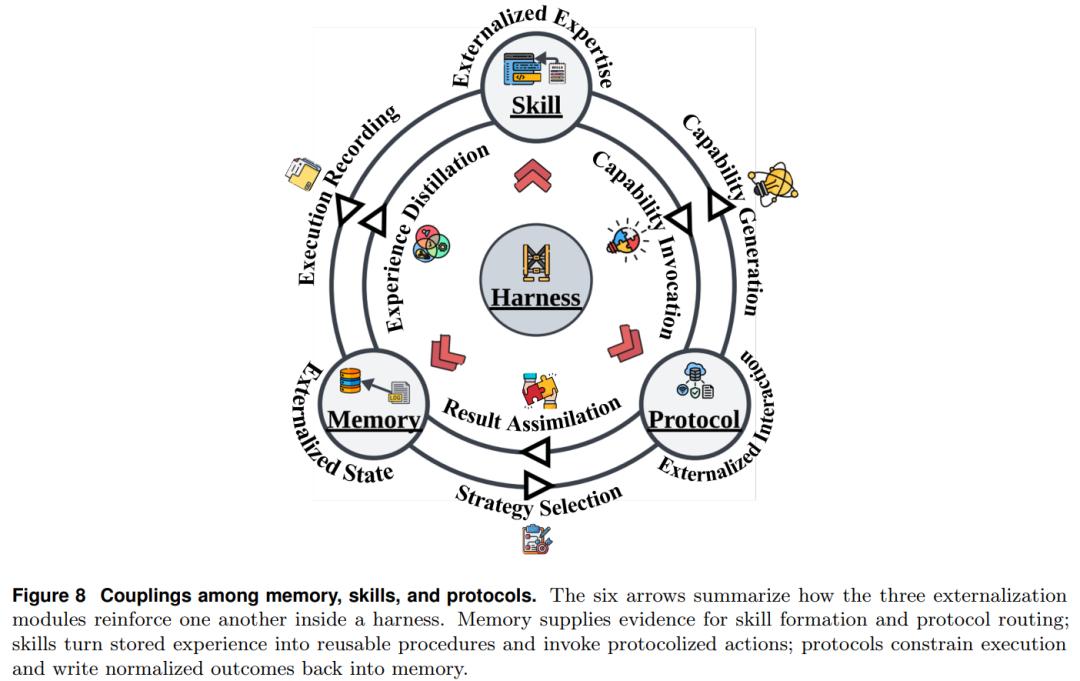
过去大家专注研究的三个独立技术方向Memory,Skill,Protocol,我们认为他们本质都是Agent某一个维度的外部化,最终殊途同归:
第一个,记忆外部化状态。它解决的是连续性问题。模型不用再把所有历史都记在脑子里,我们把工作上下文、过往经验、领域知识、用户偏好都存在外部的持久化存储里,需要的时候再精准检索。这就把一个困难的"回忆问题",变成了简单的"识别问题"。
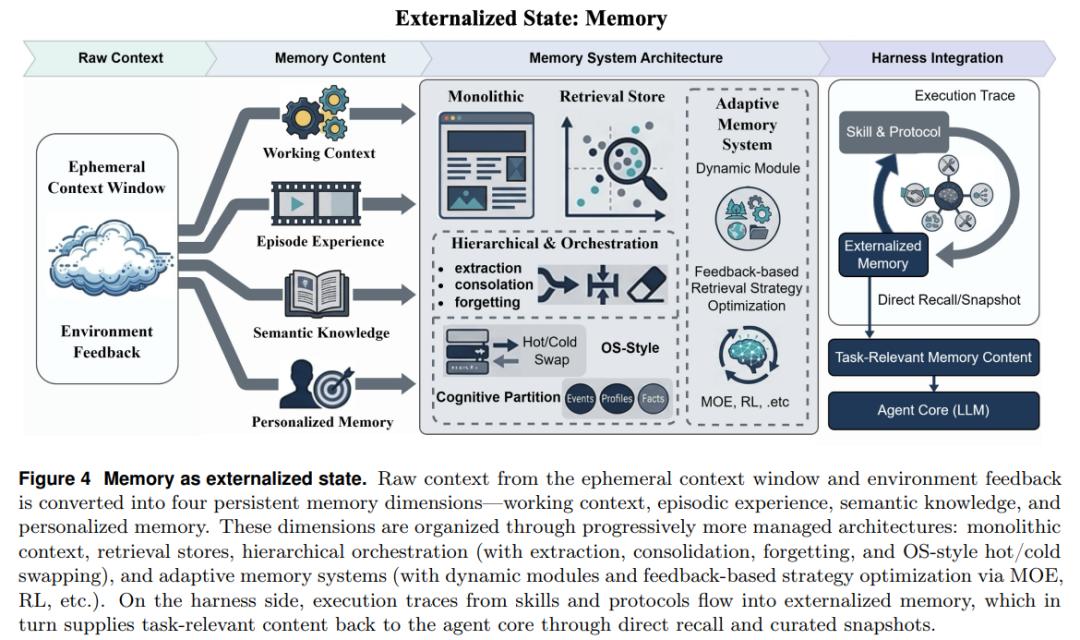
我们把外部化的记忆分成四层:
• 工作记忆:当前任务的中间状态,比如打开的文件、临时变量、执行到哪一步了
• 情景记忆:过去发生过的事情,比如上次做这个任务的时候哪里出错了
• 语义记忆:通用的知识和规则,比如你们公司的代码规范、项目的业务逻辑
• 个性化记忆:你的个人偏好和习惯,比如你喜欢用什么格式写报告,什么事情需要提前问你
第二个,技能外部化专业知识。它解决的是一致性问题。模型不用每次都从零开始重新发明工作流,我们把操作步骤、决策经验、规范约束都打包成可复用的技能包。这就把一个不稳定的"生成问题",变成了可靠的"组合问题"。
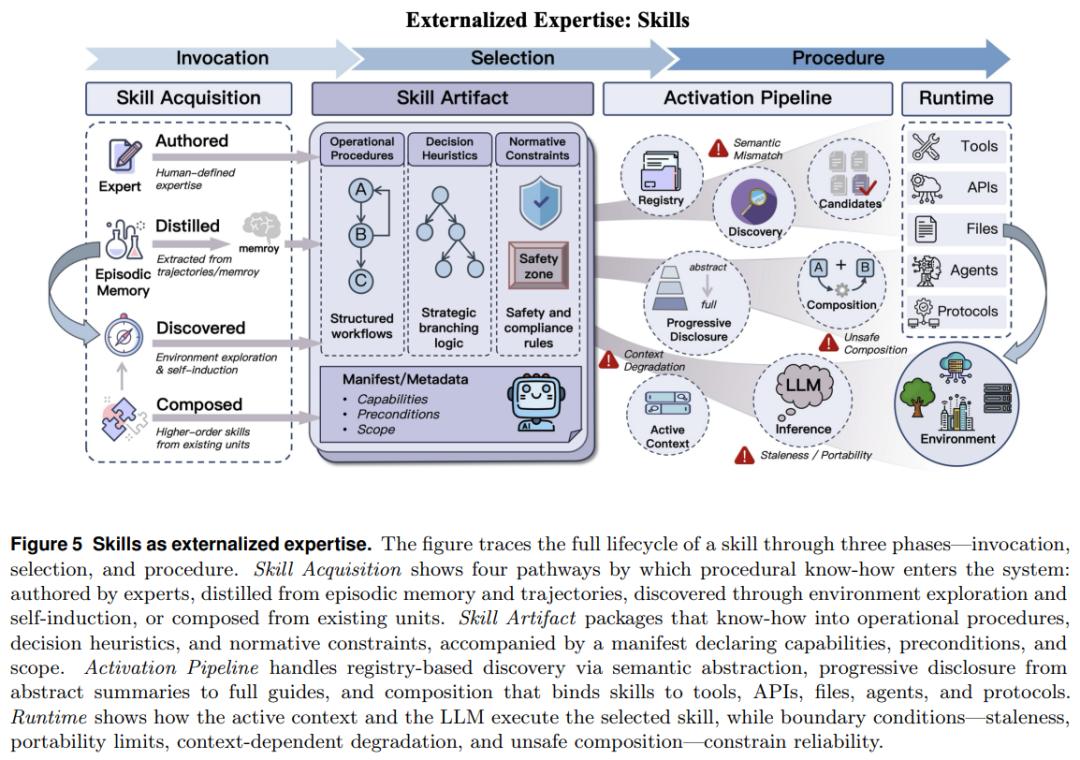
一个完整的技能,包含三个部分:
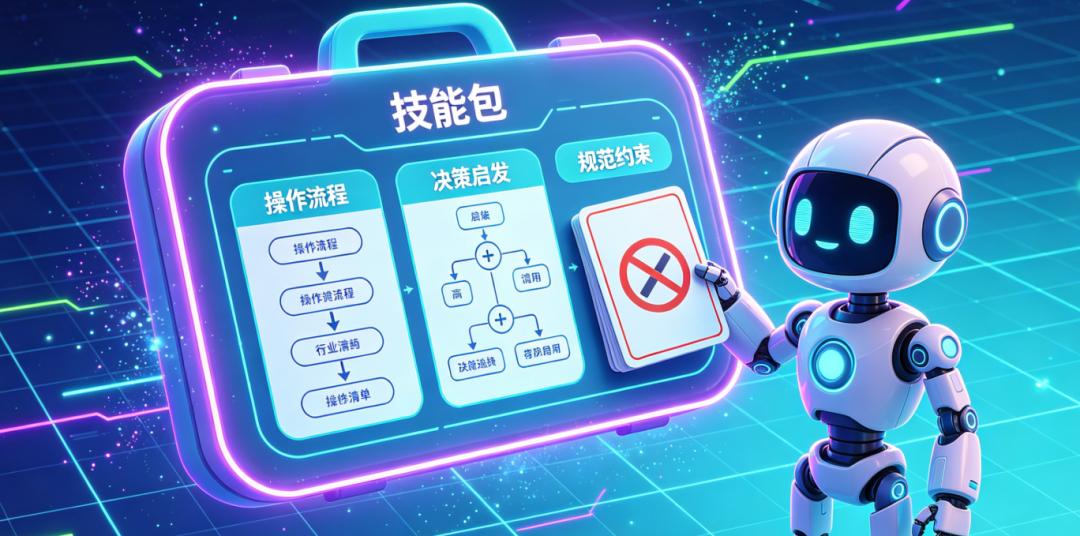
• 操作流程:先做什么,后做什么,有哪些步骤
• 决策启发:遇到分支的时候应该怎么选,什么情况优先做什么
• 规范约束:什么事情不能做,什么错误不能犯,需要满足什么标准
第三个,协议外部化交互结构。它解决的是协调性问题。模型不用再即兴发挥和工具、其他Agent、人类的沟通方式,我们用标准化的协议定义好调用格式、生命周期、权限边界。这就把一个脆弱的"即兴沟通问题",变成了规范的"契约执行问题"。
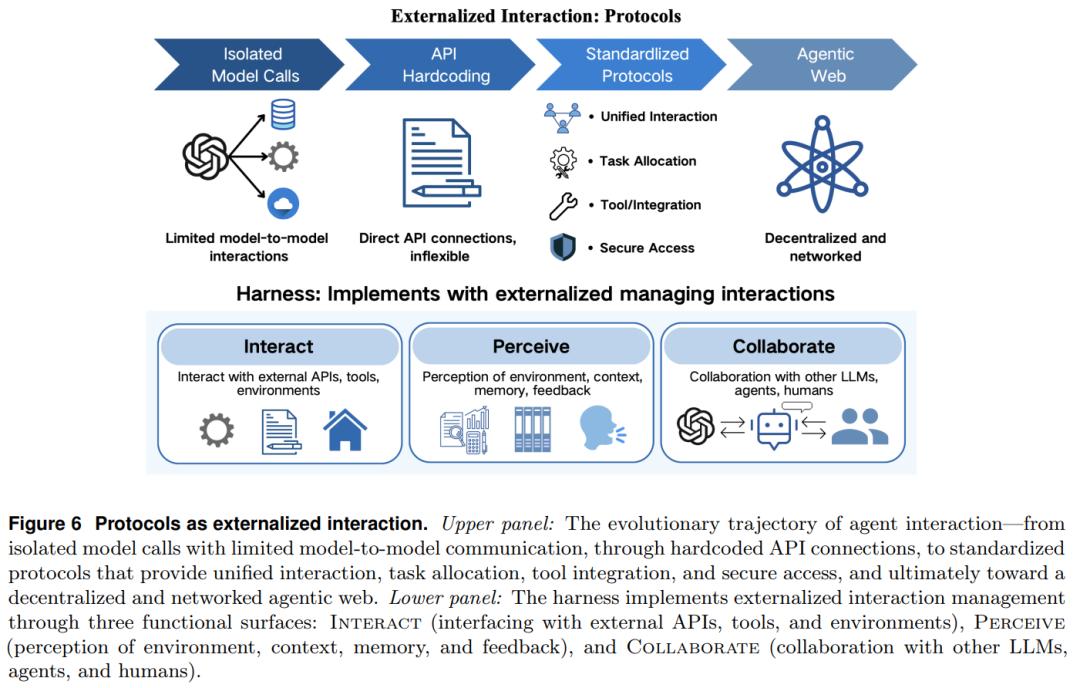
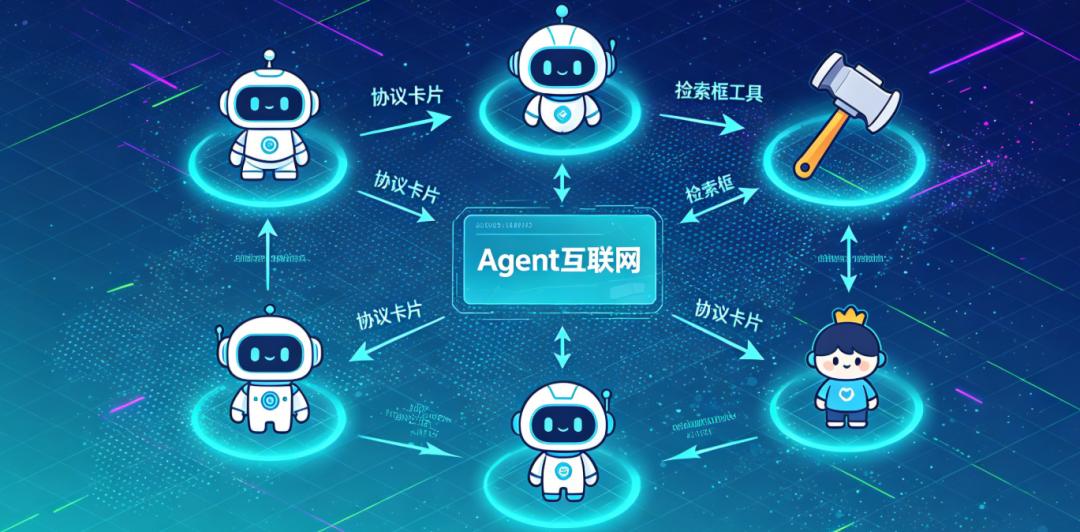
协议外部化定义了一套通用的规则,规定了 Agent 应该怎么发现能力、怎么调用工具、怎么互相委托任务、怎么交换状态、怎么管理权限。
未来会有 "Agent 互联网",所有的 Agent、工具、服务,都遵循统一的协议,可以自由地互相发现、互相调用、互相协作。
而把这三个维度统一起来,让它们真正协同工作的,就是关键的概念——Harness工程的来源。
很多人以为Harness就是胶水代码,就是把模型、记忆、工具拼在一起的脚手架。这个理解不准确。
Harness是Agent的"认知环境",是决定模型能看到什么、记住什么、能做什么、怎么被监控、怎么从错误中学习的那个核心系统。
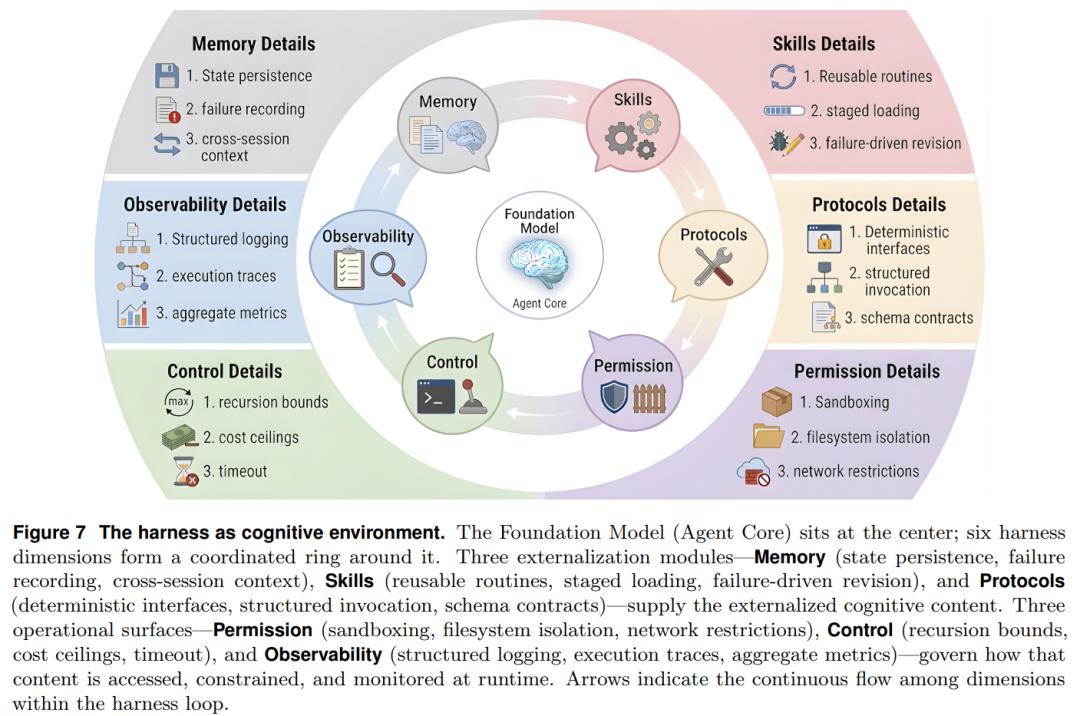
我们总结了 Harness 工程的六个核心维度:
• Agent循环和控制流:决定 Agent 怎么感知、怎么规划、怎么执行、怎么观察
• 沙箱和执行隔离:限制 Agent 能做什么,防止它破坏环境或者泄露数据
• 人类监督和审批门:在关键步骤插入人类干预,保证安全
• 可观测性和结构化反馈:记录 Agent 的所有行为,方便调试和改进
• 配置、权限和策略编码:定义不同用户、不同场景下的规则
• 上下文预算管理:合理分配有限的上下文窗口给记忆、技能和协议
最后,我们展望Agent未来发展方向,包括自我进化的Harness,跨Agent共享记忆、技能和协议基础设施,具身系统外部化等。
这篇综述的意义是把过去四年里所有零散的Agent研究,用"外部化"这一根线串了起来,给大家提供了一个系统级的分析框架。
建议读下我们的全文,相信会给你带来全新的视角。
参考资料
• Externalization in LLM Agents: A Unified Review of Memory, Skills, Protocols and Harness Engineering, https://arxiv.org/pdf/2604.08224.