OneSearch-V2,把搜索从 “死记硬背” 拉到 “深度思考”
说实话,我之前一直有个疑问:为什么端到端的生成式检索(Generative Retrieval,简称GR),明明比传统多阶段搜索架构效率更高、优化更彻底,落地之后却总逃不开“越搜越窄”“复杂需求听不懂”的魔咒?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
直到读完这篇OneSearch-V2的论文,我才明白:问题根本不在架构本身,而在模型的底层逻辑——它从一开始,就走偏了。
我们的搜索系统,一直在“偷懒”
先给不懂技术的你,用一句话讲清底层逻辑:
传统搜索就像“先去图书馆找所有相关的书,再一本本挑出你要的”,而生成式检索,是直接让一个读遍了所有书的图书管理员,把你最想要的那本直接递到你手里。OneSearch就是国内已经大规模落地的工业级生成式搜索框架,给电商平台带来了实打实的业务收益。
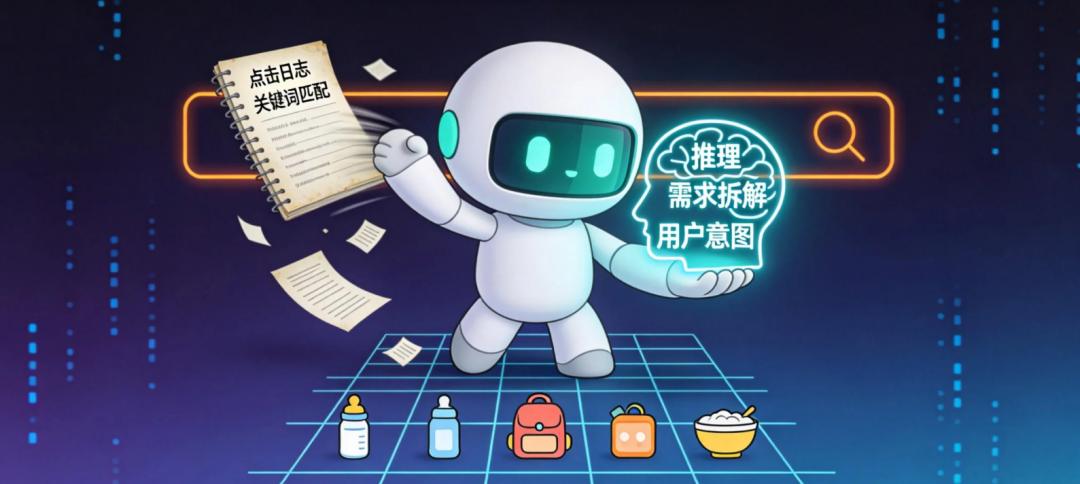
但它的初代版本,和市面上绝大多数搜索系统一样,一直在犯一个“偷懒”的错误:它宁愿花大量算力去拟合用户过去的点击日志,死记硬背“用户点过A,就会再点A”,却不愿意花功夫去理解,用户点击A的背后,到底藏着什么没说出口的需求。
这直接带来了三个行业级的顽疾:
一是复杂需求听不懂,只能做浅层的关键词匹配,就像你跟服务员说“不要辣、少盐、给老人吃的软一点”,它只听到了“菜”,给你上了一盘麻辣香锅;
二是潜在需求猜不到,只会照着历史记录“抄作业”,不会推理用户的真实诉求,你搜“婴儿辅食机”,它只会给你推你看过的同款,不会想到你可能还需要食品级的辅食碗、宝宝的分阶食谱;
三是越搜越窄,困在信息茧房里,为了冲高点击率,拼命给你推你之前喜欢的内容,结果你永远看不到新的选项,就像你总去一家餐馆吃番茄炒蛋,服务员天天给你上番茄炒蛋,哪怕你早就想试试新菜了。
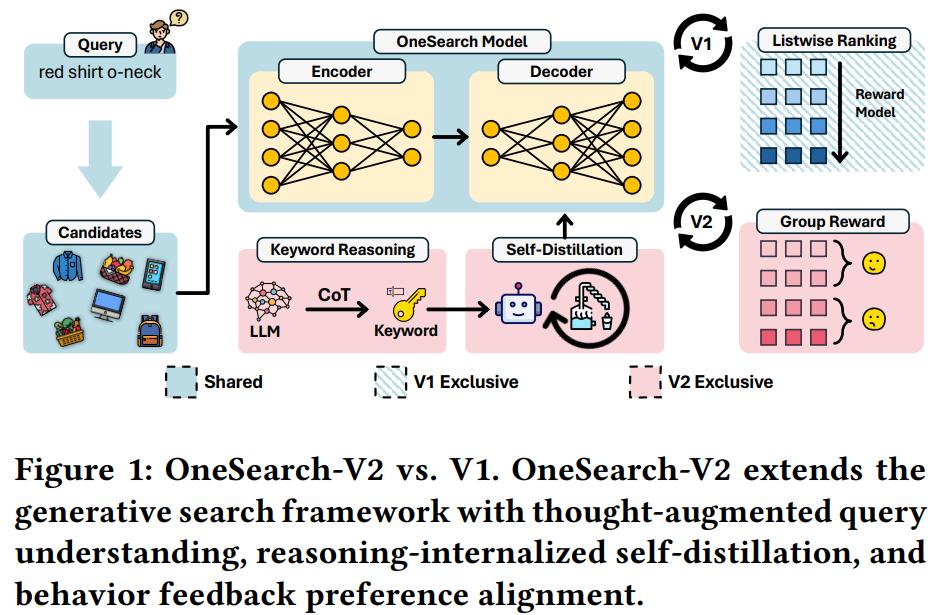
而OneSearch-V2的核心突破,就是彻底改掉了这个“偷懒”的毛病:把模型的核心目标,从“30%的拟合历史”,转向了“70%的推理本质”。
三个创新:踩中了人类认知的底层逻辑
说实话,我第一次看这三个创新点的时候,最惊喜的不是它用了多复杂的算法,而是它完全踩中了人类认知的底层规律——我们理解世界,从来不是靠死记硬背,而是靠拆解、推理、对齐。
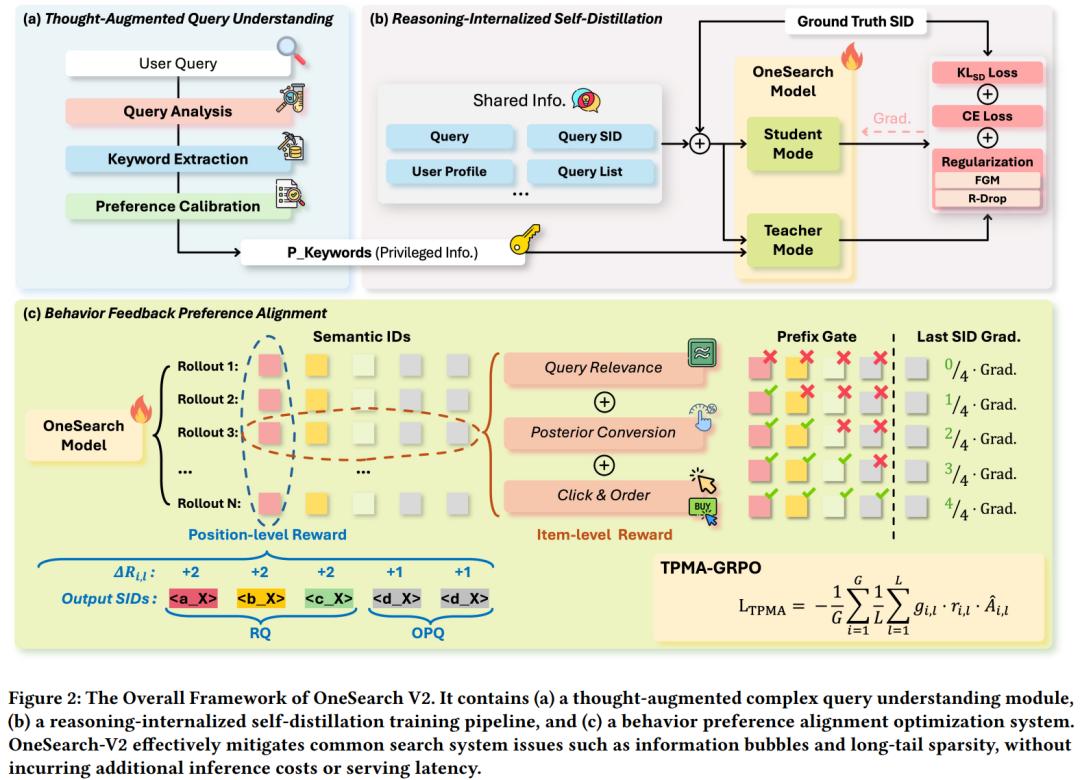
第一个创新,是思维增强的复杂查询理解模块。
你上学做阅读理解的时候,肯定不会看到关键词就直接答题,而是会先在脑子里拆解:这个问题的核心是什么?有没有隐藏的条件?出题人想考什么?
这个模块做的,就是一模一样的事。之前的搜索系统,是看到关键词就直接匹配商品,而它会先给用户的查询做一轮“思维拆解”:用户是谁?使用场景是什么?核心需求是什么?硬性要求是什么?
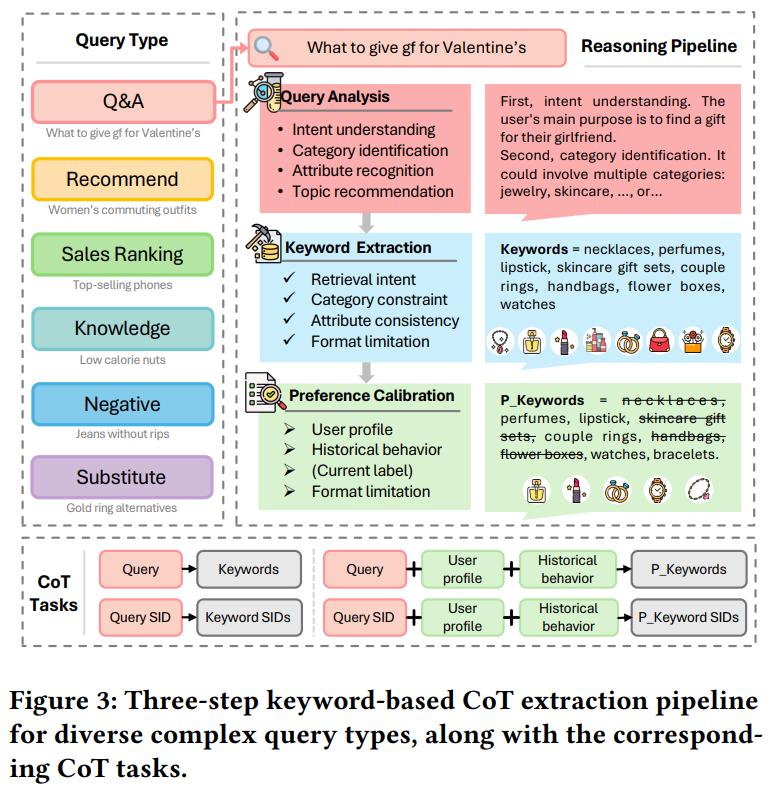
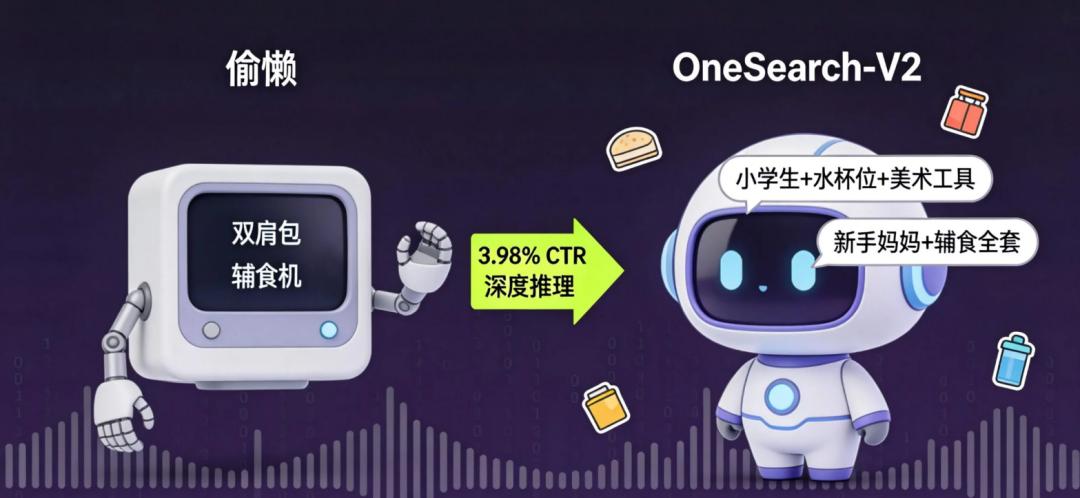
比如你搜“给刚上小学的孩子用的、能装水杯又能装美术工具的双肩包”,它不会只抓“双肩包”这个关键词,而是会拆解出“家长用户、小学生场景、核心需求是大容量分层、硬性要求是水杯位+美术工具收纳”,再去匹配对应的商品。
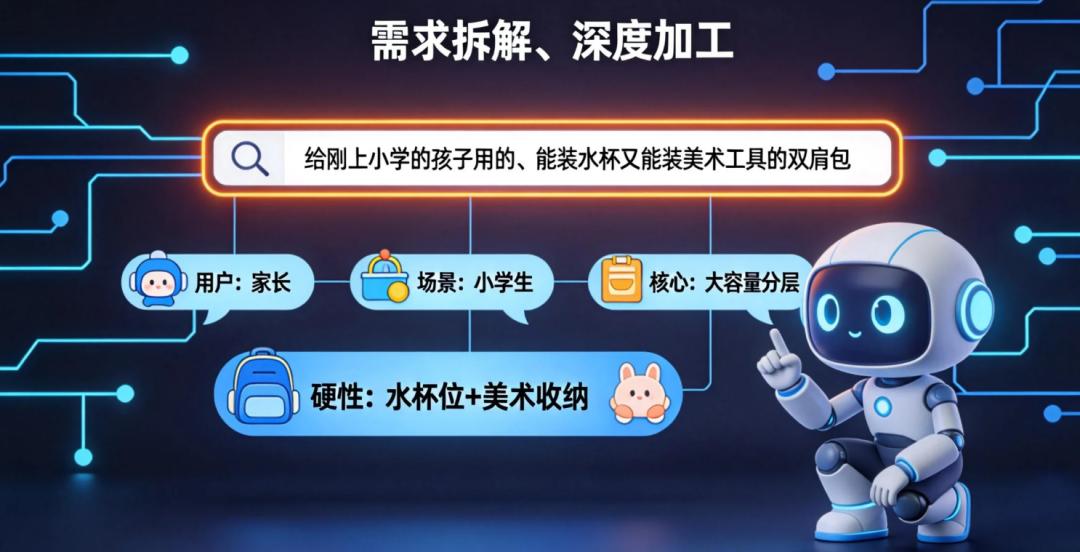
这刚好契合了认知心理学里的深度加工理论:对信息的加工层次越深,理解就越精准,而不是停留在浅层的关键词匹配。
第二个创新,是推理内化的自蒸馏训练管道,也是我认为最核心的突破。
先通俗解释什么是自蒸馏:就是大模型自己教自己,把自己从海量数据里“想明白”的深层逻辑,内化到自己的能力里,不用额外的人工标注。
之前的搜索模型,本质上是“原因论”的忠实信徒:因为你过去点过A,所以我未来要给你推A。它所有的训练,都是为了拟合过去的点击日志,就像一个死记硬背错题本的学生,只会背答案,不会懂解题思路。
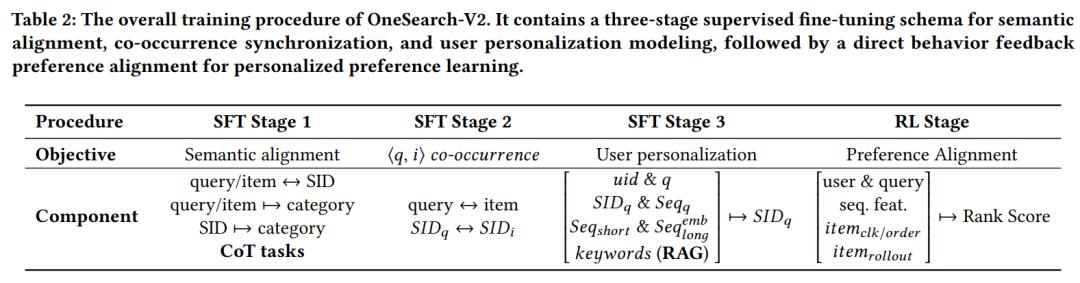
而OneSearch-V2的自蒸馏训练,完全转向了阿德勒心理学里的目的论:决定推荐结果的,不是用户过去的点击记录,而是用户行为背后的潜在目的。它通过隐式的上下文学习,从用户的历史行为里,推理出用户真正的、甚至自己都没意识到的需求,再把这个推理能力内化到模型里,而不是死记硬背表面的点击数据。
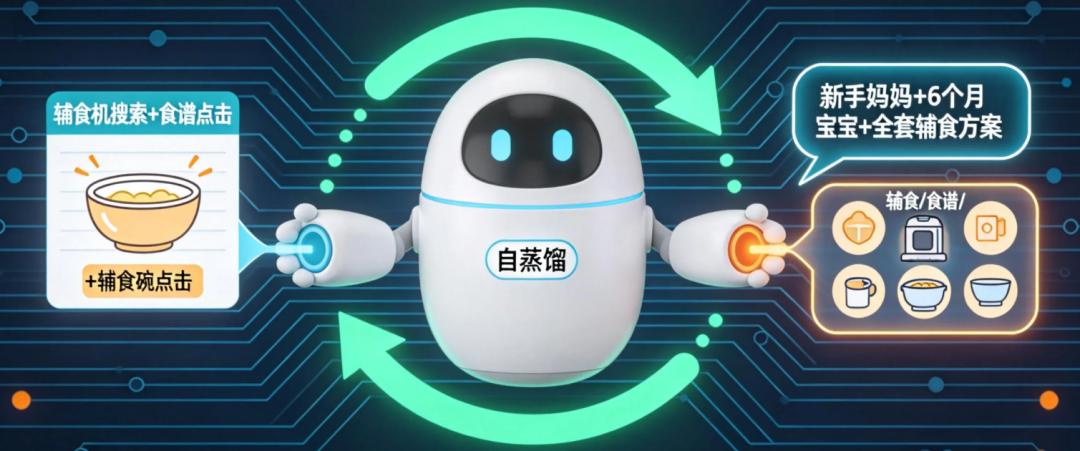
比如你搜了“婴儿辅食机”,又看了“6个月宝宝辅食食谱”,还点了“食品级硅胶辅食碗”,之前的模型只会给你推更多辅食机,而它会推理出“你是一个新手妈妈,宝宝刚到辅食阶段,核心需求是全套的、安全的辅食解决方案”,给你推荐更匹配的、甚至你自己都没想到的商品。
第三个创新,是行为偏好对齐优化系统。
这个模块解决的,是行业里最头疼的“奖励黑客”问题:模型为了冲高点击率这个KPI,会拼命给你推标题党、低价引流款,哪怕这些东西根本不符合你的需求,就像一个为了冲业绩的销售,只会给你推便宜的引流款,根本不管你是不是真的需要。
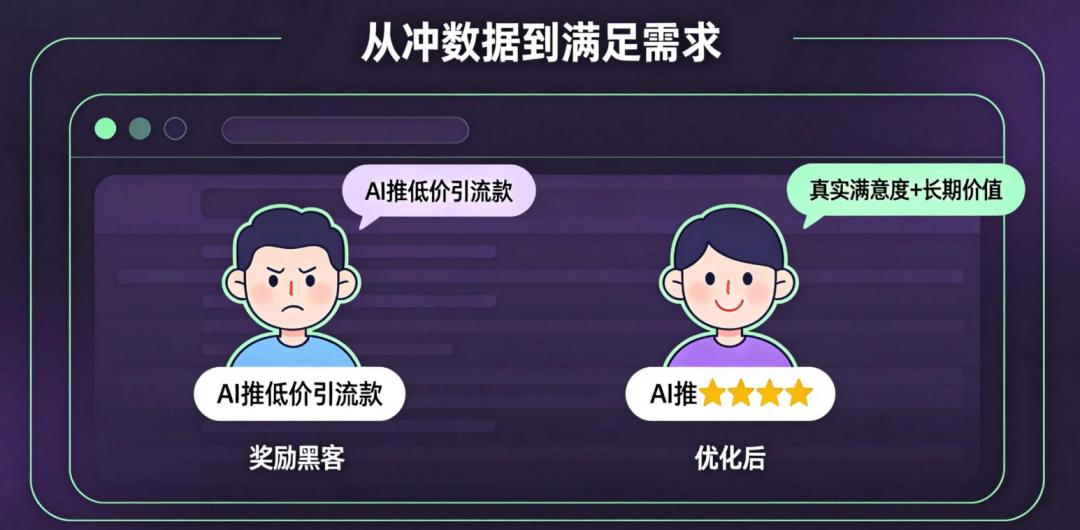
它做的事很简单:把模型的奖励目标,从单一的“点击率”,变成了“用户真实满意度+长期价值”,同时用用户的直接反馈,去对齐个人的真实偏好,而不是只看点击这个单一行为。
说白了,它终于让搜索系统从“为了数据而数据”,变回了“为了满足用户需求而存在”。
反常识的结果:效果涨了,速度却没慢
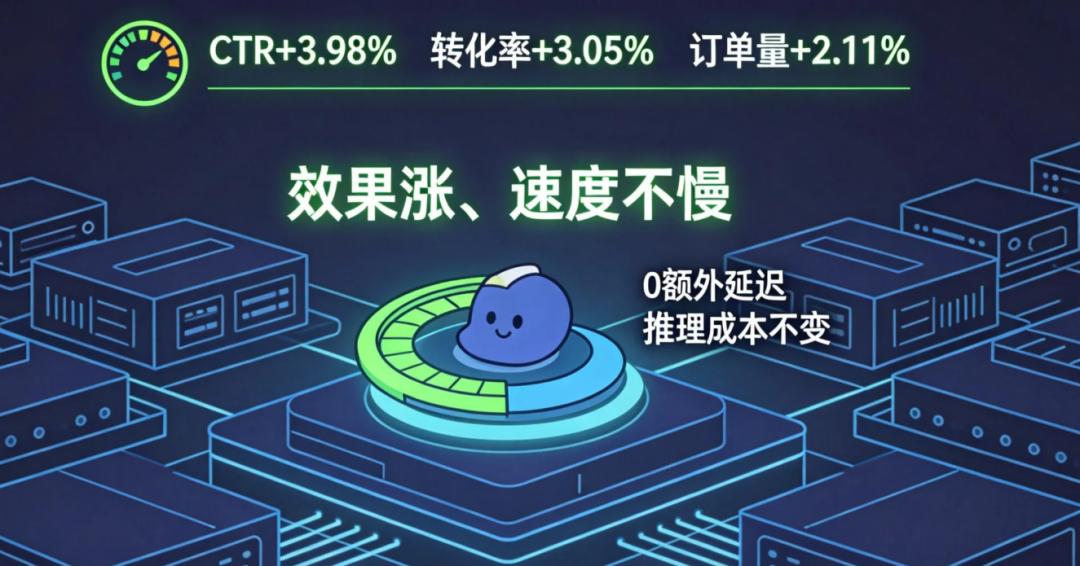
论文里的实验数据,最反常识的不是那串亮眼的业务增长,而是它做到了所有同行都很难做到的事:效果大幅提升,却没有增加任何推理成本和服务延迟。
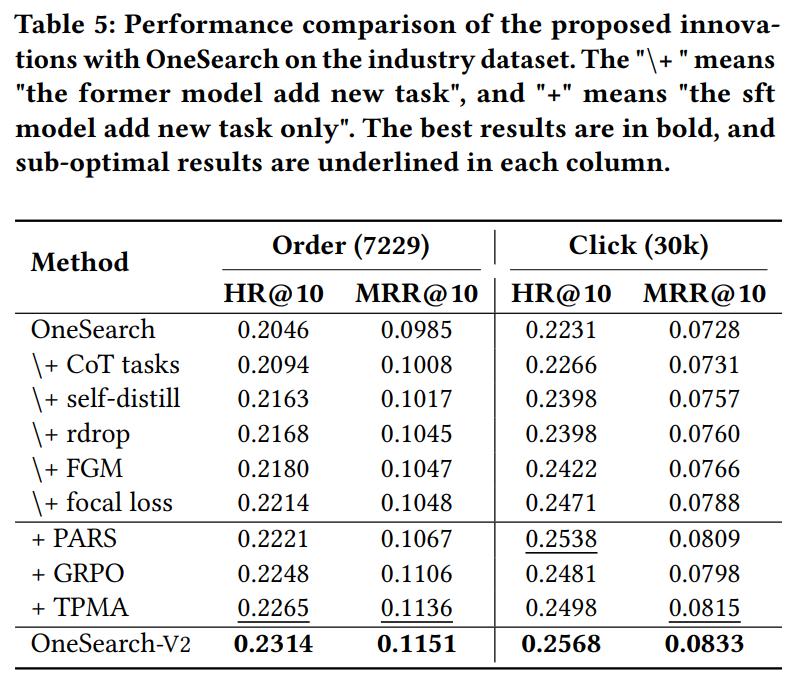
线上A/B测试的结果很直白:商品点击率提升3.98%,买家转化率提升3.05%,订单量提升2.11%。对于电商平台的大盘来说,转化率每提升0.1%都要付出巨大的努力,这个3.05%的提升,已经是量级的突破。
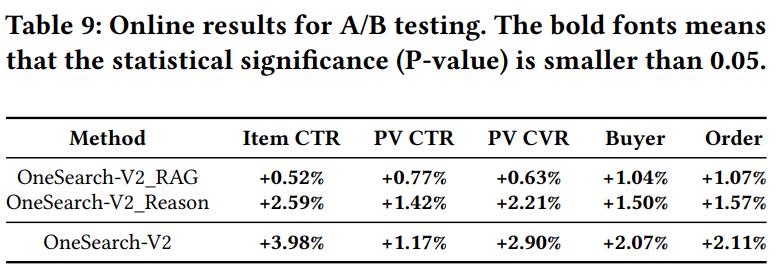
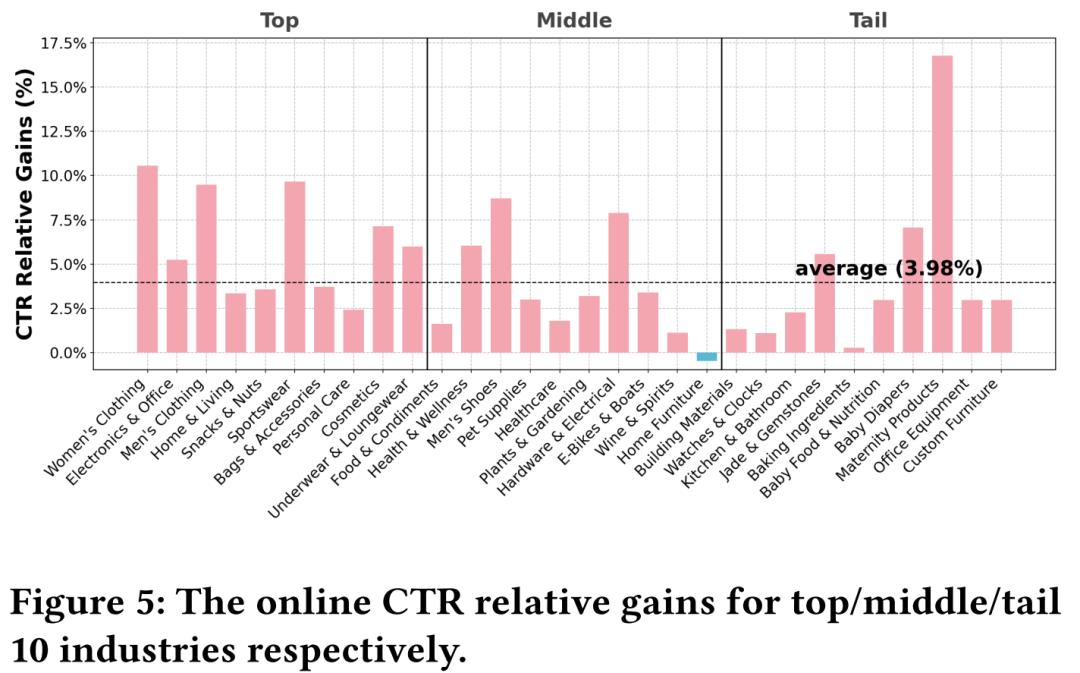
更重要的是,人工评估里,页面好评率提升1.65%,查询和商品的相关性提升1.37%,同时还有效缓解了信息茧房和长尾商品稀疏的问题。
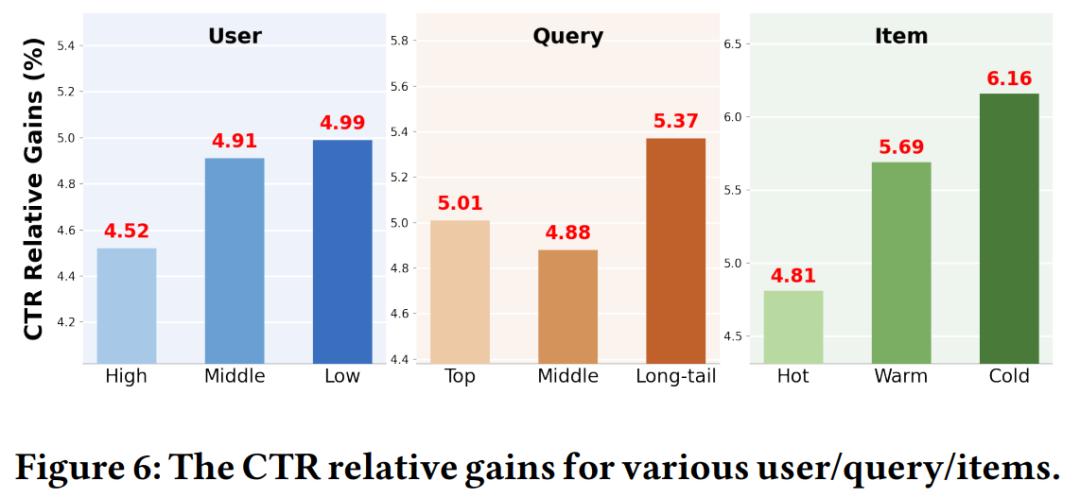
一般来说,给模型加了这么多深度推理的能力,必然会增加算力消耗,拖慢响应速度,就像你给电脑开了太多后台,必然会卡顿。但OneSearch-V2却做到了“做题速度没变,正确率却大幅提升”,这才是它能真正大规模落地的核心原因——工业级的技术,从来不是实验室里的空中楼阁,而是要在效果、成本、速度之间,找到最优的平衡。
核心思考:AI的终局,是懂“人”,而非记“事”
这篇论文给我最大的启发,从来不是算法有多精妙,而是它戳中了一个最朴素的道理:无论是AI,还是人,真正的成长,从来不是靠死记硬背过去的经验,而是靠深度的思考、对本质的理解,和对真实需求的对齐。
我们活在一个数据爆炸的时代,不管是AI,还是我们自己,都很容易陷入“经验主义”的陷阱:AI拟合过去的日志,我们依赖过去的经验,结果都困在了自己的信息茧房里。我们总以为,记住的东西越多,经验越丰富,就越厉害,却忘了,真正的智能,从来不是“记住了什么”,而是“能从已有的信息里,推理出什么”。
OneSearch-V2给整个行业提了一个醒:AI的发展,早就过了堆参数、堆数据的野蛮生长阶段。接下来的竞争,从来不是谁的模型更大,谁的训练数据更多,而是谁的模型,能真正读懂“人”——读懂用户没说出口的需求,读懂行为背后的本质,跳出历史数据的惯性,真正解决用户的问题。
说到底,所有的技术,最终都是为“人”服务的。能真正懂人的AI,才会有真正的未来。
参考资料
• OneSearch-V2: The Latent Reasoning Enhanced Self-distillation Generative Search Framework,https://arxiv.org/abs/2603.24422