谷歌发布VisionClaw|眼镜秒变AI管家,效率暴涨37%太优雅了
你是否也曾幻想过,只需一句话,眼前的智能眼镜就能自动完成记笔记、查商品、发邮件甚至关灯这些琐事?当AI Agent(智能体)遇上可穿戴设备,我们离科幻电影里的“隐形助手”还有多远?今天这篇文章,将为你深度拆解一项名为 VisionClaw 的突破性研究,它让智能眼镜从“被动问答机”进化成主动执行任务的“隐形管家”。
🤔 思考时刻:如果眼镜能自动帮你做事,你会首先让它处理什么任务?欢迎在评论区分享你的奇思妙想!
一项长达50天的真实部署研究显示,用户平均每天使用这个“隐形管家”超过20分钟,累计交互555次。更惊人的是,在受控实验中,这套系统能让任务完成速度提升13-37%,感知难度降低7-46%。
这背后,究竟是如何实现的?让我们先从最核心的痛点说起。
❓ 核心痛点:为什么我们需要“隐形管家”?
今天,我们的数字交互被“屏幕”牢牢捆绑。手机、电脑、平板,任何一个操作都需要你停下手中事,掏出设备,点开应用,手动操作。这个过程打断了你在现实世界的沉浸感,造成了巨大的认知切换成本。
而智能眼镜的早期形态,大多只是“挂在脸上的手机”,主打语音问答或简单信息显示。它们缺乏两个关键能力:
- 持续的情景感知:无法像人眼一样,持续、自然地理解你眼前正在发生什么。
- 自主的任务执行:听到“帮我查一下这个洗手液”,它只会念出搜索结果,而不会自动打开亚马逊,对比价格评分,然后添加到你的购物车。
这就像你请了一位管家,但他既看不见屋里的状况,也只会复述你的指令,而不去动手。VisionClaw要解决的,正是这个“感知与执行脱节”的根本问题。
为了量化研究这个问题,论文设定了四项极具代表性的日常任务,涵盖了从信息处理到物理控制的核心场景。
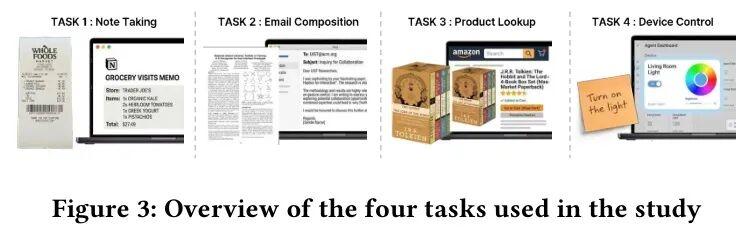
记笔记、写邮件、查商品、控设备——这几乎是我们每天都会遇到的数字世界“接口”任务。问题在于,我们总要在现实世界和数字界面之间笨拙地切换。VisionClaw的目标,就是抹平这个鸿沟。
那么,这个能“看见”并“动手”的智能管家,内部到底是如何运作的?下面,让我们进入最硬核的原理拆解。
🚀 原理拆解:三阶段闭环,让眼镜“长出手脚”
VisionClaw的核心创新,是构建了一个**“感知-决策-执行-反馈”** 的完整闭环。它不再是一个简单的问答模型,而是一个部署在智能眼镜上的自主任务执行系统。
我们通过一个具体例子来感受它的威力:你拿起一瓶Aesop洗手液,对眼镜说:“帮我看看这个在网上卖多少钱?”
传统智能眼镜:识别语音,调用搜索引擎API,返回文本结果:“Aesop洗手液在亚马逊售价约24.5美元,评分4.7星。” 然后,就没有然后了。
VisionClaw做了什么?请看它的完整工作流:
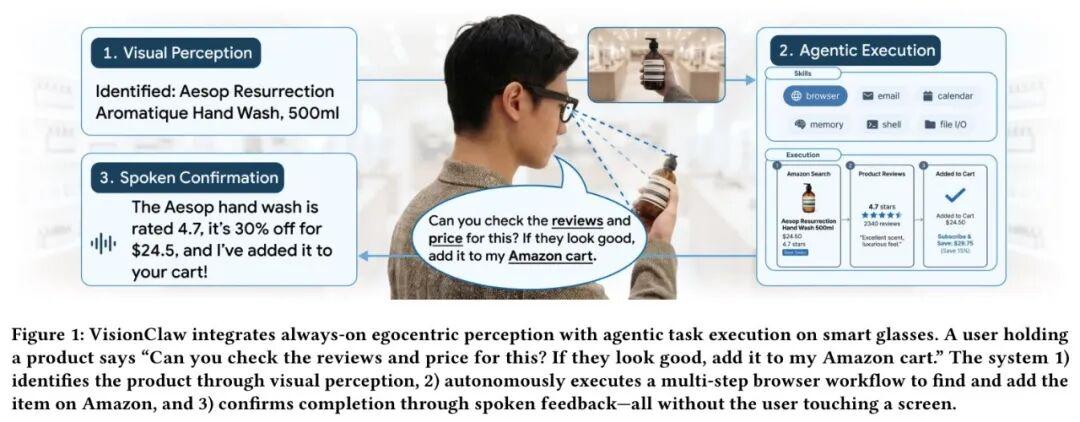
第一阶段:视觉感知
眼镜摄像头持续以约1帧/秒的速度捕捉你眼前的画面。当你拿起洗手液并提问时,系统不仅听到了问题,更“看见”了你手中的物体。多模态大模型Gemini Live同时处理音频和图像,准确理解了你“查询这个商品价格”的意图,并将“Aesop洗手液”作为关键上下文。
第二阶段:智能体执行
理解意图后,系统不会止步于回答。位于云端的OpenClaw智能体框架被唤醒。它就像一个数字世界的全能操作员,拥有调用浏览器、邮件、日历、文件系统等众多“技能”(工具)的权限。
在这个例子中,它会自动执行一连串操作:打开浏览器,访问亚马逊,搜索“Aesop洗手液”,找到对应商品,抓取价格($24.5)和评分(4.7星),然后——最关键的一步——模拟点击“加入购物车”。整个过程完全自动化,无需你触碰任何屏幕。
第三阶段:语音确认
任务执行完毕后,系统通过眼镜的扬声器,用语音向你反馈:“已找到Aesop洗手液,评分4.7星,价格24.5美元,并已加入你的亚马逊购物车。”
看到了吗? 从“被动告知”到“主动代办”,这是质的飞跃。这个闭环的核心,依赖于一套精密的端到端系统架构。
💡 核心架构:三层解耦,流式协同
为了在资源受限的眼镜上实现强大的持续感知与执行能力,VisionClaw采用了清晰的三层架构设计,将硬件、AI大脑和执行力解耦。
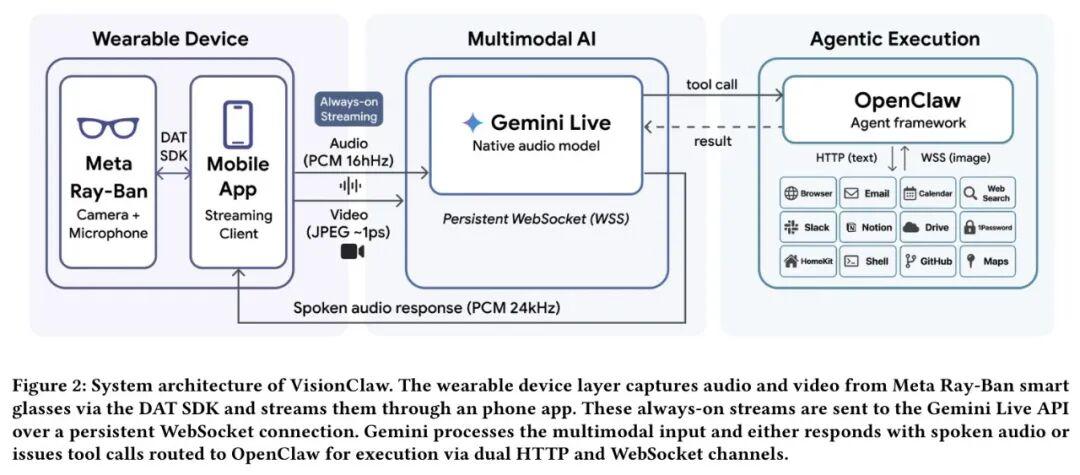
第一层:可穿戴设备层
这是系统的“感官”。基于Meta Ray-Ban智能眼镜,通过手机上的一个App作为中继,利用DAT SDK将眼镜摄像头捕捉的视频(JPEG格式,约1fps)和麦克风采集的音频(PCM,16kHz)进行低功耗、持续流式传输到云端。这里的“持续”是关键,它让系统拥有始终在线的上下文感知能力。
第二层:多模态AI层
这是系统的“大脑”。核心是谷歌的Gemini Live模型,它是一个原生支持音频输入的大模型。通过一个持久化的WebSocket连接,它接收来自设备的音视频流。它的核心职责是理解用户意图,并决定下一步动作:是直接语音回复,还是需要调用工具来执行任务?如果需要调用工具,它会生成结构化的“工具调用”指令。
第三层:智能体执行层
这是系统的“双手”。基于OpenClaw智能体框架,它专门负责与外部工具交互。当收到来自“大脑”的工具调用指令时(比如“搜索商品信息”),它会通过HTTP或WebSocket连接,调用对应的工具API(如浏览器自动化脚本),执行具体操作,并将结果返回。
这三层之间通过WebSocket实现低延迟、全双工的实时通信,确保了从感知到执行的流畅性。
💡 深度思考:这种“云端大脑+边缘感官”的模式,是否是未来所有可穿戴AI的必然选择?在延迟和隐私之间,应如何权衡?
理解了架构,一个关键问题浮现:如何让这个强大的系统“听话”,确保它只在需要时执行任务,而不是胡乱操作?这就引出了VisionClaw另一个精妙的设计——可配置的交互模式。
💡 动态模式切换:按需启用的“超能力”
VisionClaw并非时刻处于“全功率”状态。研究者设计了三种可配置的运行模式,以平衡功能、功耗和用户体验:
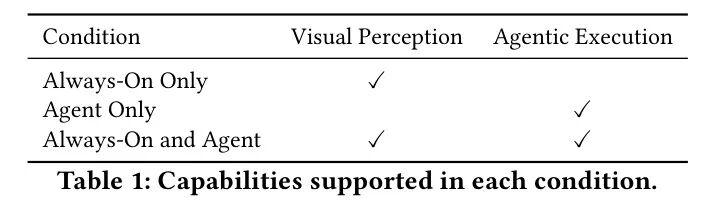
- 仅始终在线模式:只开启持续视觉感知。系统像一只安静的眼睛,不断观察和理解环境,但不会主动执行任务。适用于需要高度情境感知但无需操作的场景。
- 仅智能体模式:关闭持续视觉感知,只保留智能体执行能力。你需要明确用语音描述任务,系统才会行动。这更接近传统的语音助手,但执行力更强。
- 始终在线+智能体模式:功能完全体。既拥有持续的环境感知能力,也具备完整的任务执行权限。这是我们前面例子中展现的模式。
这种设计赋予了系统极大的灵活性。你可以根据场景切换模式:在办公室写邮件时用“完全体”;在户外散步时,可能切换到“仅感知”模式以节省电量;在需要高度专注时,甚至可以暂时关闭。
模式设计好了,但如何确保智能体在“动手”时准确无误、让人放心呢?这涉及到与AI交互中最令人头疼的“黑箱”问题。VisionClaw通过一套独特的提示词工程,巧妙地建立了人机信任。
💡 提示词玄机:给AI戴上“规则紧箍咒”
直接让一个强大的多模态模型去操作系统工具是危险的。它可能会误解指令、执行错误操作,或者陷入“自我推理”而不行动。为此,研究者在Gemini Live前放置了一个精心设计的“系统提示词”,堪称给AI戴上了“规则紧箍咒”。
这个提示词的核心原则是:你只是一个语音接口,唯一能做的就是调用“执行”工具,绝不能自行其是。
它规定了近乎“苛刻”的触发条件,只要用户请求涉及以下任何一点,就必须调用执行工具:
- • 发送消息
- • 搜索或查询信息
- • 涉及任何过去的信息(如“上周”、“之前”)
- • 要求记住某事
- • 要求创建、管理任何事物
- • 要求与应用程序或设备交互
最精妙的一条是: “如果用户提及任何过去的时间…你必须使用‘execute’。不要从对话上下文中回答这些问题。不要试图模拟记忆。”
这意味着,当用户问“我上周买的书到了吗?”,AI不会根据自己的对话历史去猜测,而是必须调用工具去查询真实的订单记录。这强制AI将一切基于现实世界的查询都转化为工具调用,确保了信息的真实性和可验证性。
此外,提示词还强制要求AI在执行任何操作前,必须进行“口头确认”(如“好的,我来查一下”)。这个简单的设计极大地提升了用户体验,让用户明确知道系统已接收指令并开始处理,而不是陷入沉默的等待或不确定性中。
这套组合拳下来,VisionClaw变成了一个严格遵守流程、行为可预测、执行可追溯的可靠助手。那么,在实际使用中,它到底有多靠谱?效率提升是否真实?用户真的愿意信任它吗?让我们用数据说话。
📊 实验验证:数据证明,体验征服
为了全面评估VisionClaw,研究者进行了两项研究:一项是受控的实验室对比实验,另一项是长期的真实世界部署研究。结果令人振奋。
🏆 效率与性能:肉眼可见的提升
在实验室中,12名参与者使用三种不同模式(始终在线+智能体、仅智能体、仅始终在线)完成了四项核心任务。结果清晰地表明,融合了感知与执行的“完全体”模式优势明显。
首先看任务完成时间,这是最硬的效率指标:
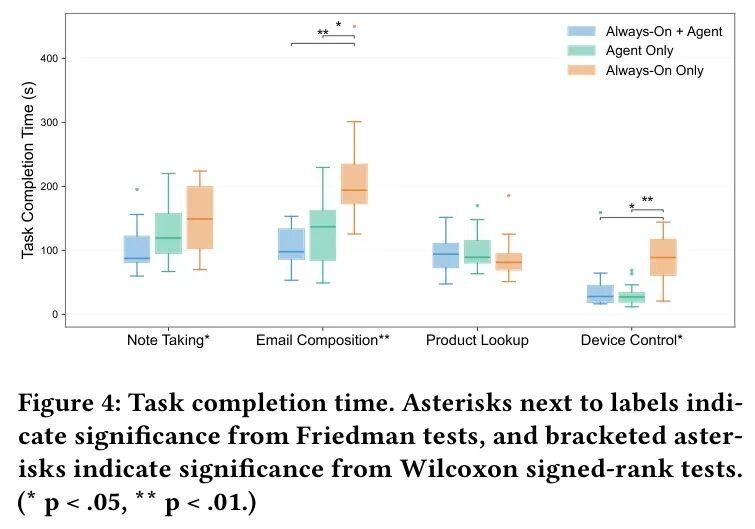
在“产品查询”任务中,“始终在线+智能体”模式比“仅智能体”模式快37%,比“仅始终在线”模式快13%。在“邮件撰写”任务中也表现出显著优势。这证明,视觉上下文的引入,极大地减少了用户描述任务所需的精力,让智能体能更快地理解并执行。
我们通过具体数据表格来感受这种差异:
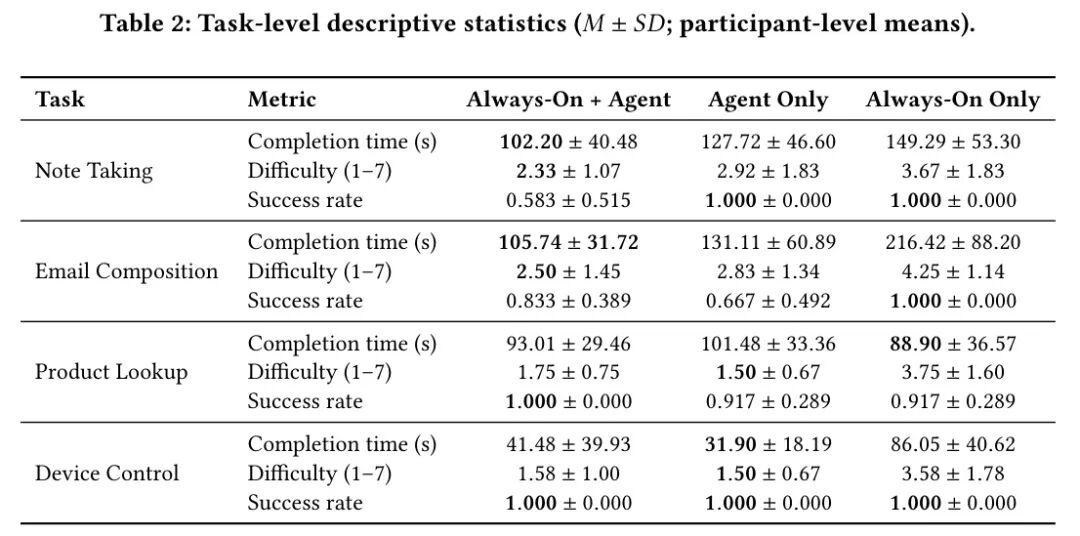
数据显示,“始终在线+智能体”模式在“记笔记”和“邮件撰写”任务中取得了100%的成功率,且主观难度评分最低。这意味着,它不仅做得快,而且做得准、做得轻松。
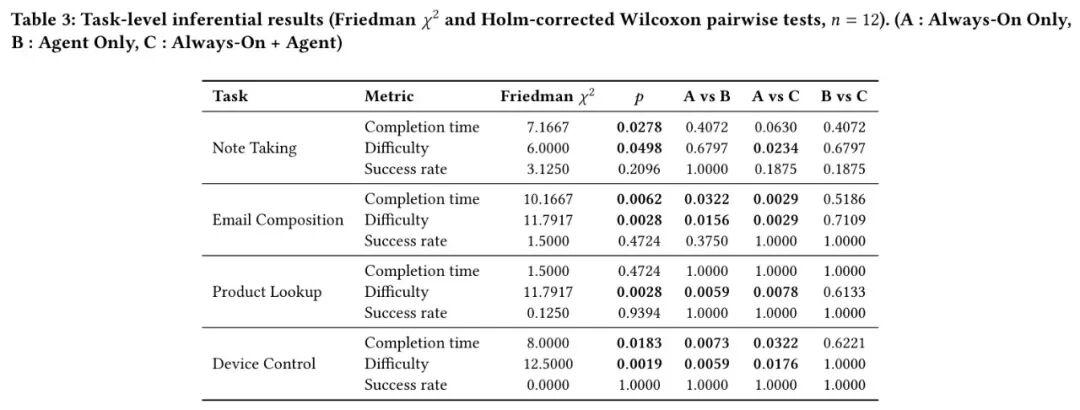
统计检验进一步确认了这些差异的显著性:
性能上去了,但用户的主观感受如何?让一个AI自动帮你操作,会不会感到失控、不安或挫败?
🔬 用户体验与信任:从数据到感受
研究者使用了NASA-TLX任务负荷量表和自定义问卷,全方位测量了用户的主观体验。
工作负荷显著降低:
NASA-TLX从心理需求、体力需求、时间压力、努力程度、挫败感和自我表现六个维度评估负荷。结果如下:
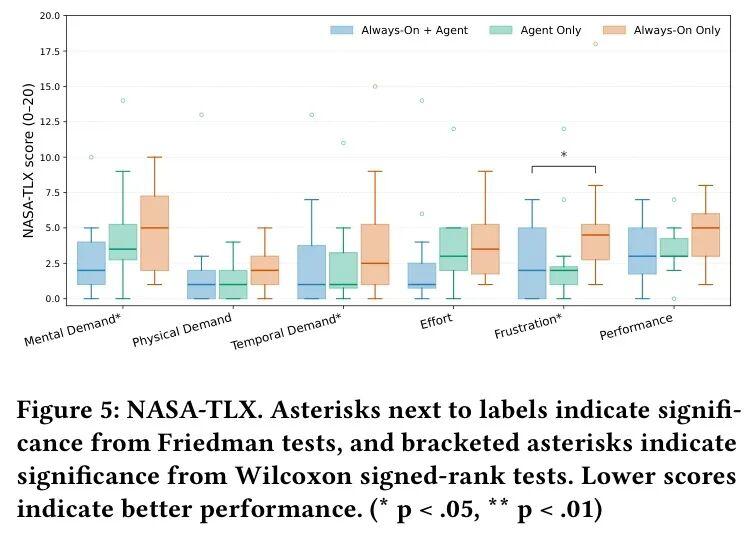
“始终在线+智能体”模式在心理需求、努力程度和挫败感三个维度的得分显著低于其他模式。这说明,当系统能“看见”并“代办”时,用户感到更省心、更轻松、更不容易烦躁。
主观体验全面占优:
在可靠性、信任度、易用性、有用性等维度的问卷调查中,“始终在线+智能体”模式也获得了最高的用户评分。
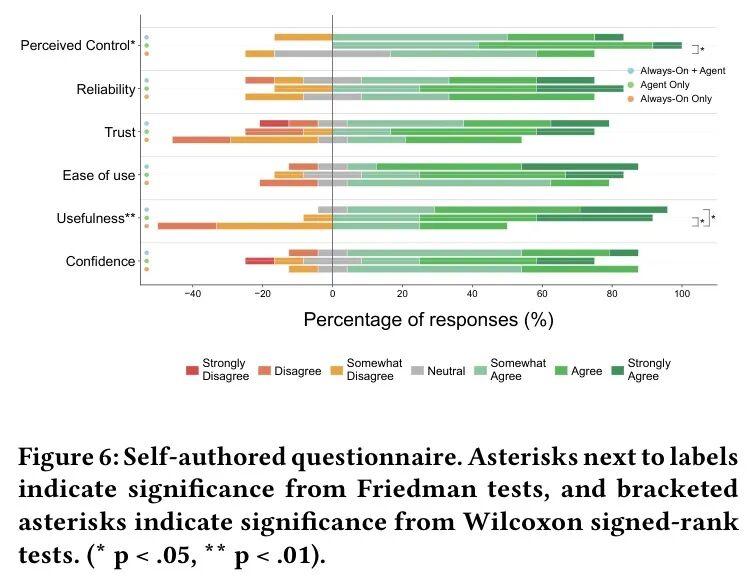
数据显示,用户在感知控制、易用性和信心上,对融合模式的评价明显更高。有趣的是,在信任度和可靠性上,“仅智能体”模式得分最高。这可能是因为纯执行模式更简单、更专注,用户对其行为边界有更明确的预期。
这些主观评分背后的统计显著性,进一步巩固了结论:
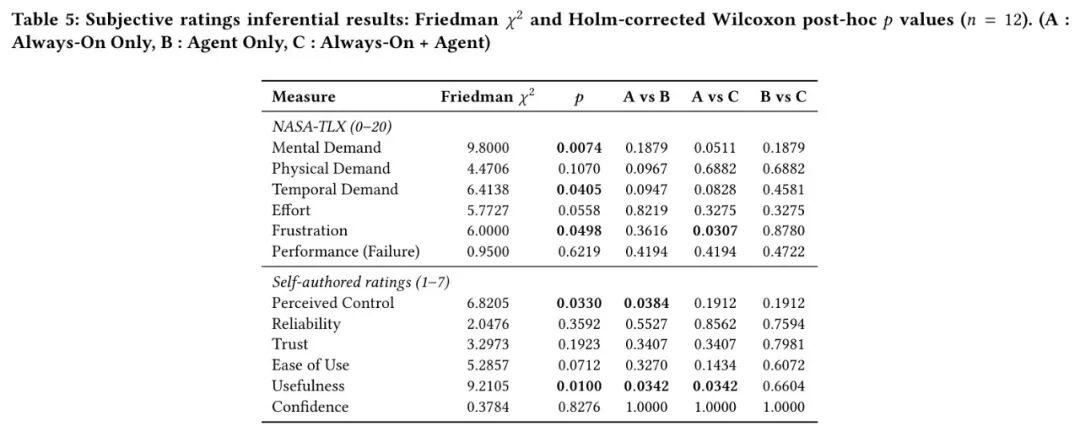
实验室数据证明了其短期有效性。但真正的考验在长期、无约束的真实世界。VisionClaw能融入日常生活吗?
🏆 长期部署:从“工具”到“习惯”
研究者进行了为期50天的自传式部署研究。4名用户在日常工作中自由使用系统,产生了555次交互,总时长约25.8小时,平均每人活跃13.8天。
研究发现了丰富的用户行为模式。首先,交互场景被归纳为六大类别:
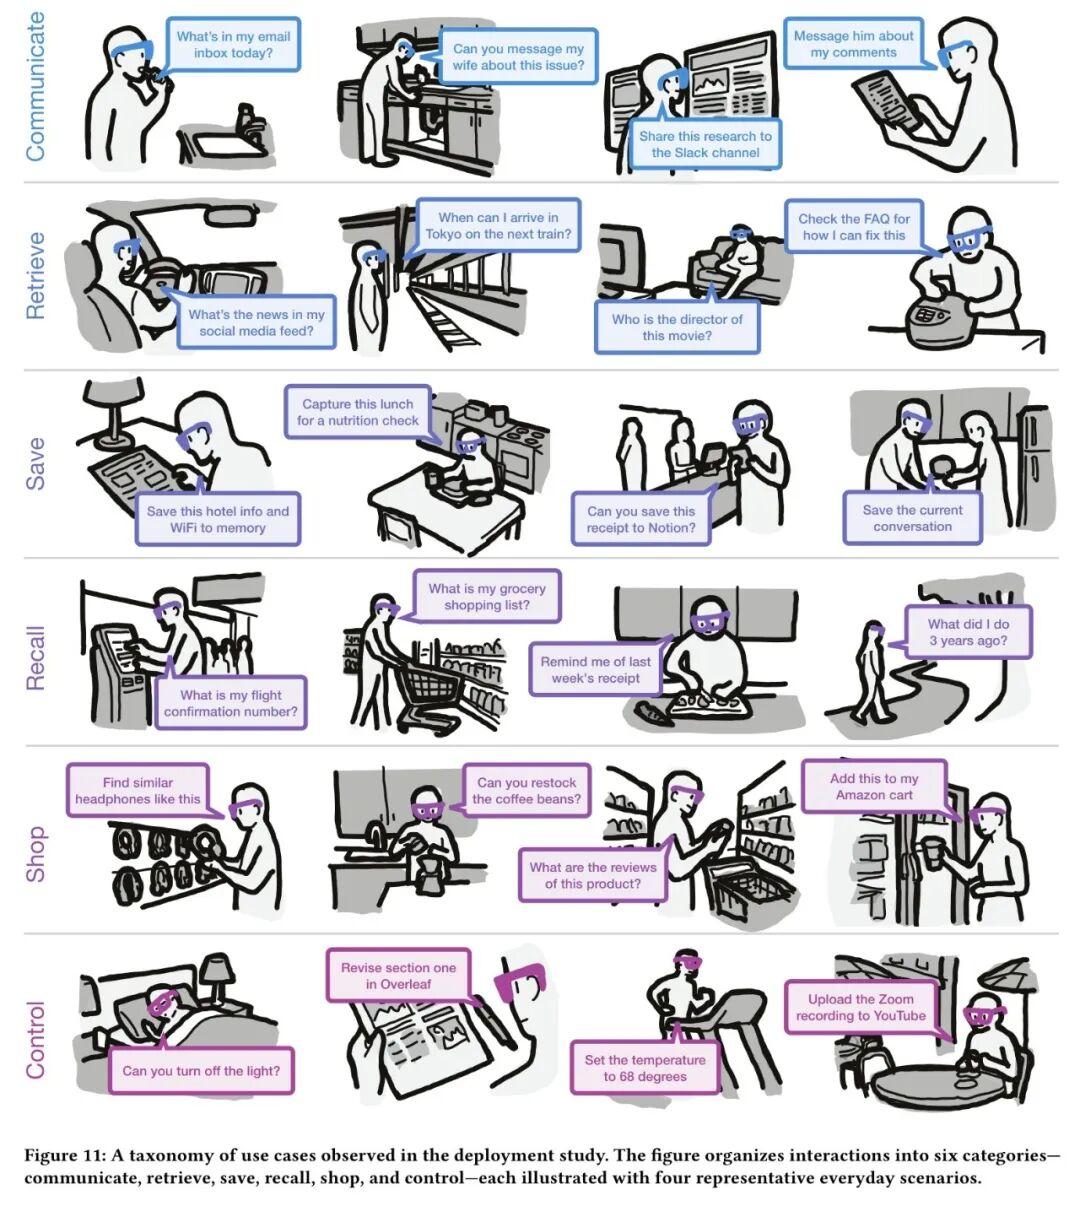
这些场景生动地展示了系统的实用性:从“把海报发到Slack”到“回忆上次在这家餐厅点了什么”,再到“关掉客厅的灯”。
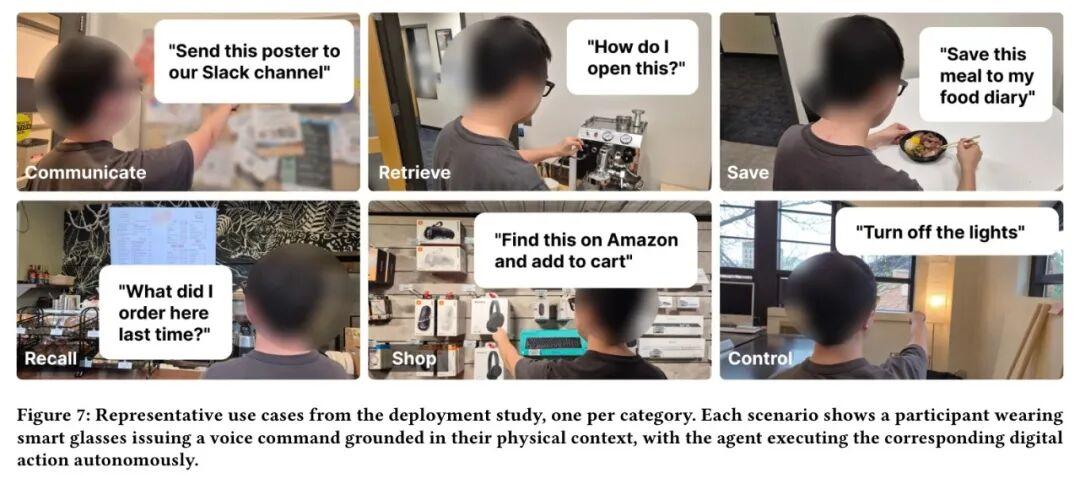
更深入的分析揭示了四种新兴的交互模式:
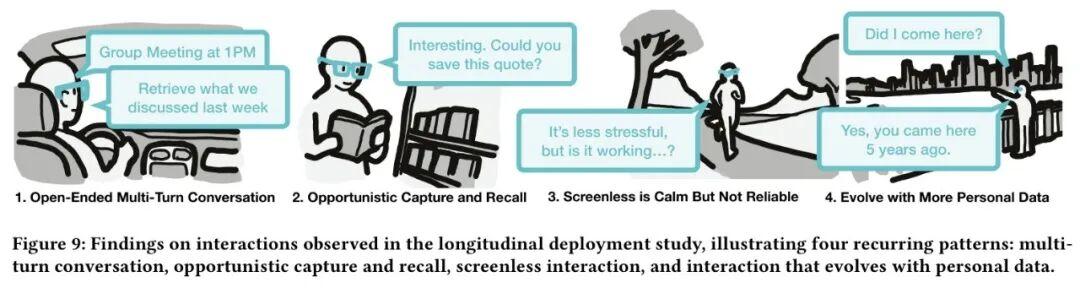
- 开放式多轮对话:用户在连续对话中处理复杂事务。
- 机会性捕捉:在看到某物时(如书中好句),立刻触发保存动作。
- 无屏幕交互的平静与不可靠:用户享受解放双手,但也对纯语音交互的准确性存疑。
- 随个人数据演进的交互:系统积累的用户历史,使得像“我上次在这里做了什么?”这样的问题成为可能。
使用日志的时间序列分析,则揭示了用户行为习惯:
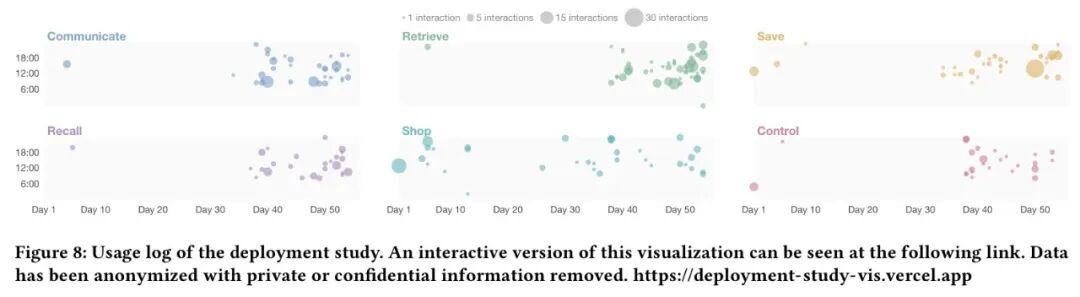
图表显示,“沟通”和“检索”类任务在早晨和中午更为频繁,而“控制”类任务则多发生在傍晚。这符合日常作息规律,也证明系统已自然融入用户的生活流。
⚖️ 客观评价:突破、局限与未来
VisionClaw无疑为可穿戴AI和具身智能开辟了一条新路径。它成功地将持续ego-centric感知与通用任务执行结合起来,实现了从“信息助手”到“行动代理”的范式转变。实验数据证明,它在提升效率、降低认知负荷和提供流畅体验方面具有显著优势。
然而,局限性同样清晰:
- 隐私与能耗:持续的视频流传输和云端处理,引发对隐私和电池续航的担忧。未来的工作必须在设备端轻量化感知模型上取得突破。
- 安全边界:赋予AI自动执行支付、发送消息等操作的能力,需要极其稳健的安全校验和用户确认机制,目前的提示词约束仅是第一步。
- 场景泛化:当前任务虽具代表性,但距离理解更复杂、模糊的用户意图(如“帮我处理一下这个烂摊子”)还有很远。
展望未来,这项技术正指向一个更沉浸、更主动的交互未来:
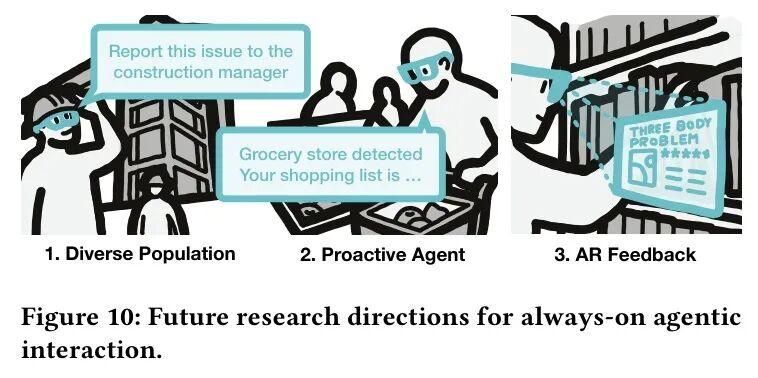
未来的智能眼镜助手,将能服务更广泛的人群,甚至能主动预判你的需求(比如路过超市时提醒你购物清单),并通过AR叠加信息的方式提供更直观的反馈。VisionClaw是迈向这个未来坚实的一步。
🌟 价值升华与行动号召
回顾全文,VisionClaw给我们带来的核心启发有三点:
- 范式创新:AI与可穿戴设备的结合,不应止于“移动的Siri”,而应迈向 “隐形的执行者” ,深度融合感知与行动。
- 设计哲学:通过模式切换和严格的提示词约束,可以在赋予AI强大能力的同时,保障可控性与用户体验,这是构建可信赖AI Agent的关键。
- 价值验证:真实的长期部署研究比单纯的实验室 benchmark 更有说服力,它揭示了技术如何真正融入并重塑人的行为模式。
这项研究让我们看到,脱离屏幕、自然交互的下一代计算范式,已经触手可及。当眼镜不仅能“看见”你的世界,还能“动手”改变它时,我们与数字世界的关系将被彻底重构。
🤔 深度思考:你认为,像VisionClaw这样的“隐形智能管家”,最可能率先在哪个领域或场景中引爆?是医疗辅助、工业巡检,还是每个人的日常生活?欢迎在评论区留下你的真知灼见!
💝 支持原创:如果这篇近5000字的深度解读让你对AI与可穿戴设备的未来有了新的憧憬,点赞+在看就是对我最大的鼓励!也请分享给你身边对AI、人机交互感兴趣的朋友,一起探讨未来!
🔔 关注提醒:想持续获取最前沿、最硬核的AI技术解读?别错过下一场思维盛宴!
#AI技术 #人机交互 #智能体 #可穿戴设备 #人工智能 #技术干货 #论文解读
参考
VisionClaw: Always-On AI Agents Through Smart Glasses