FinReporting:跨司法管辖区财务披露本地化报告生成的智能体工作流
“FinReporting: An AgenticWorkflow for Localized Reporting of Cross-Jurisdiction Financial Disclosures”
金融报告系统常用大语言模型提取和总结企业披露信息,但多为单市场设定,未考虑不同司法管辖区的结构差异,跨司法管辖区报告存在语义对齐和验证难题。
本文提出FinReporting,一种跨司法管辖区财务披露统一和本地化报告的智能体工作流,构建基于通用报告标准的规范金融本体,在美、日、中市场实施。经美、日、中年度报告评估,该系统在异构报告制度下提高了一致性和可靠性。
【 扫描文末二维码加入星球获取论文 】
摘要
金融报告系统常用大语言模型提取和总结企业披露信息,但多为单市场设定,未考虑不同司法管辖区的结构差异,跨司法管辖区报告存在语义对齐和验证难题。为此提出FinReporting,这是一种本地化跨司法管辖区财务报告的智能体工作流程,构建统一规范本体,将报告分解为可审计阶段,把大语言模型用作受约束的验证器。经美、日、中年度报告评估,该系统在异构报告制度下提高了一致性和可靠性。
简介
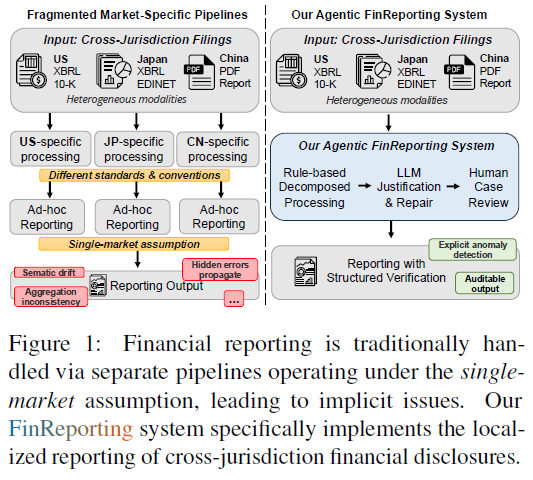
财务报表对投资者评估公司状况和业绩至关重要,LLMs 助力自动化定制财务报告,减轻阅读负担,便于决策。现有系统多基于单市场假设,对全球投资者不适用。投资者理解外国公司财报时面临两方面摩擦:不同司法管辖区金融基础设施差异大,投资者难正确解读;金融数据供应商人工提取和验证数据成本高、难扩展,小投资者获取受限。跨司法管辖区报告本地化不仅是翻译或格式转换,会计分类和汇总惯例差异会导致语义漂移和汇总不一致,可靠的本地化需支持结构化验证和修复。
本文提出FinReporting,是跨司法管辖区财务披露统一和本地化报告的智能体工作流,构建基于通用报告标准的规范金融本体,在美、日、中市场实施。操作上,将端到端本地化分解为可审计步骤,含文件获取、报表识别、提取、规范映射,且步骤间有结构化验证机制。展示交互式平台,可加载特定市场文件、查看提取报表、导出本地化财务报告,为下游应用提供可审计基础设施。
相关工作
金融自然语言处理(NLP)长期研究企业披露文本信号用于市场预测和风险评估;近年拓展至财务报告数值推理与问答,有FinQA等基准;同时提出金融导向基础模型与评估套件,如BloombergGPT等,以加强领域适配与能力测量。
现代金融披露系统采用 XBRL 实现机器可读报告,美国 SEC 提供相关结构化数据集。近期研究提出提取和结构化金融事实的管道,还有基于大语言模型的查询接口。但不同市场披露实践和标准不同,现有管道多基于单市场设置。FinReporting 则明确建模跨司法管辖区的异质性,将结构化验证嵌入报告流程,实现跨不同申报制度的可审计本地化。
FinReporting
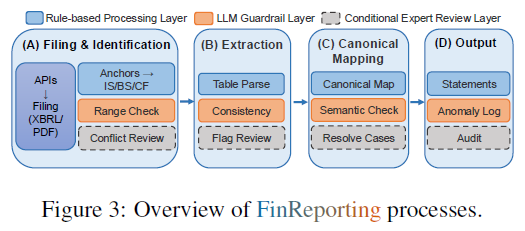
FinReporting是一种将财务报告划分为可审计步骤(文件获取、报表识别、提取、规范映射及输出)的智能体工作流,在步骤间插入结构化验证机制(LLM 论证和专家评审)保证中间输出质量。
系统采用三层处理设计:
①基于规则的确定性处理层生成可重现的初始结果;
②带严格护栏的 LLM 验证/修复层;
③针对高影响案例的轻量级人工评审层。
基于规则的处理层
文件获取和报表识别:根据不同管辖权,从XBRL-native市场(美/日)直接加载标记事实,从PDF-centric市场(中国)定位年报并检测核心报表页码范围,确定报表级上下文包。
提取:在XBRL-native市场按报告上下文选正确事实并导出;在PDF-centric市场进行文档分解、表格解析等,为提取项添加状态标签。
规范映射:借助全球金融本体将提取项映射到统一规范模式,实现跨市场语义对齐。
输出:输出统一规范模式下的本地化财务报表及记录异常和决策的异常日志与审计跟踪。
LLM护栏层
FinReporting将大语言模型(LLM)作为有界验证器而非自由形式提取器,防止未被检测的错误。在各阶段结合预定义约束与LLM推理,验证中间输出、有足够证据时提出修复方案并给出可追溯支持。验证器决策空间受限,有KEEP、REPAIR、NEED_REVIEW三种决策。仅在满足所有护栏条件时应用修复,否则系统转为NEED_REVIEW。所有决策记录证据和失败原因,确保最终局部声明逻辑连贯、语义忠实于源文件。
条件专家评审层
FinReporting支持对标记为NEED_REVIEW的特殊情况或检测到重大差异时进行针对性人工审核。审核人员检查系统提供的审计跟踪和证据片段以高效解决冲突。还提供结构化评估模板和消融式比较,以量化验证和修复对提取完整性和定位一致性的影响。
实验
实验设置
评估协议:评估 FinReporting 对年度报告核心财务报表字段的处理,系统为 18 个核心项目生成报告,有审计追踪和证据不足时的审核标记。
评估数据:按统一年度报告协议评估美、日、中市场非金融企业,数据来自美 SEC EDGAR、日 EDINET、中公开 PDF 年报。各市场设 20 家基线公司用于规则开发和标注,10 家挑战公司用于评估,共 90 家。标注经金融专家验证。
评估指标:设目标字段总数为 N,报告填充率(FR,非空输出字段比例)、冲突率(CR,需人工审核字段比例)和准确率(Acc,审核字段与人工标签对比)。
实证分析
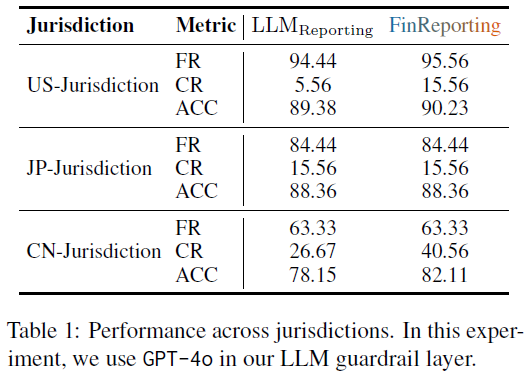
对比普通大语言模型报告流程:美、日、中三地两种方法表现为美国最强、日本稍低、中国最弱,这主要因源数据结构和标准化程度不同,美国数据机器可读性高、模式一致,日本标签和报告实践有差异,中国需从PDF报告提取和重构信息,噪声多、误差大。
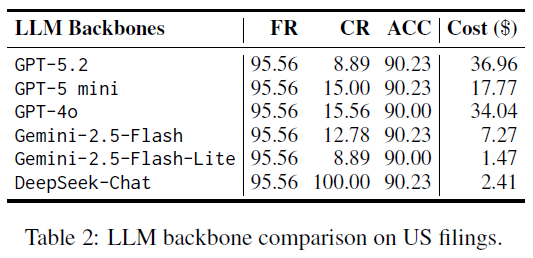
骨干大语言模型部署:美国司法管辖区下不同大语言模型整体填充率一致,说明覆盖率主要由任务流程决定;小而高效的骨干模型精度与强模型相当且成本低,适合生产部署。
示例应用
概览
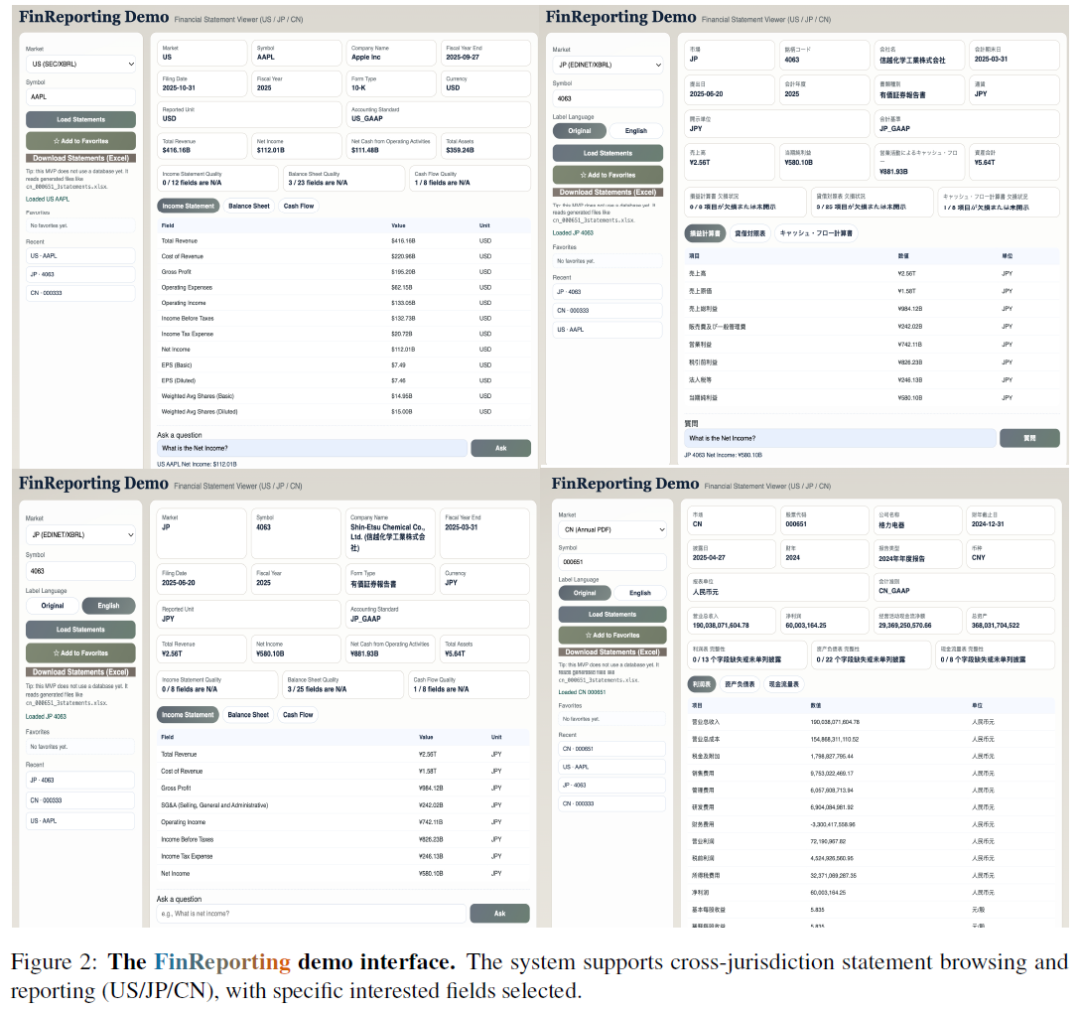
开发轻量级网页版演示系统,用于交互式探索FinReporting提取的财务报表,目标用户为金融分析师、跨市场投资者和金融NLP研究人员。用户选市场(美、日、中)和公司,界面以标签页展示损益表、资产负债表和现金流量表,各视图显示标准化元数据并突出关键指标。
统一模式和QA
提取输出按统一模式归一化,保留市场特定标签和单位,便于比较且不丢本地报告语义。演示提供高频指标模板式问答,QA 模块从归一化模式直接取值,可快速验证,无需扫描原始工作表。
质量和审计信号
审计性是主要设计目标,定义统一状态本体(OK、MISSING、PARSE_ERROR、NOT_APPLICABLE),当前版本中,美日适配器多实例化OK/MISSING,中国适配器通过PDF状态追踪激活PARSE_ERROR和NOT_APPLICABLE,有摘要指标报告缺失字段数量,界面支持下载结构化工作簿用于离线验证。
实现
原型为无数据库 Web 服务,直接读取批处理管道生成的结构化 Excel 工件以确保与实验结果一致。后端用 Python 实现,前端是轻量级静态页面,有市场列表、公司选择等 API 端点。演示可本地一键启动,也能通过 SSH 端口转发远程访问,便于可复现展示。
演示流程
典型会话流程:选市场和公司,查 IS/BS/CF 表及元数据,发核心指标 QA 提示,下载工作簿手动核对,强调可用性、明确质量信号及支持人工验证。
总结
FinReporting是一种跨司法管辖区财务报告的智能体工作流,通过规范文件、分解处理阶段解决全球财务分析实际难题。与自由形式的大语言模型提取管道不同,大语言模型作为受限验证器,证据不足时交由人工审查。该设计实现透明跨市场报告,发现异常,提供可扩展、可审计的基础设施,减少人工数据整理依赖,降低下游模型隐藏结构错误。未来将扩大司法管辖区覆盖、丰富规范本体、扩展验证范围、增强跨报表和跨周期及处理嘈杂PDF的鲁棒性。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
