浙大&美团SKILL0技术解读:Agent技能学进模型里,效果反超9.7%
浙大联合美团刚发了一篇Agent领域的重磅论文。现在所有Agent都在卷的技能检索,居然是限制模型能力的病根。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
看完我才发现,真正的自主Agent,也可以不带技能说明书。
一、整个Agent行业,都陷在了“拐杖依赖”的死胡同里
现在主流的Agent技能增强方案,就像你考驾照,全程副驾坐着个教练,每一步都给你念操作手册:“打左转向灯,踩离合,挂一档”。
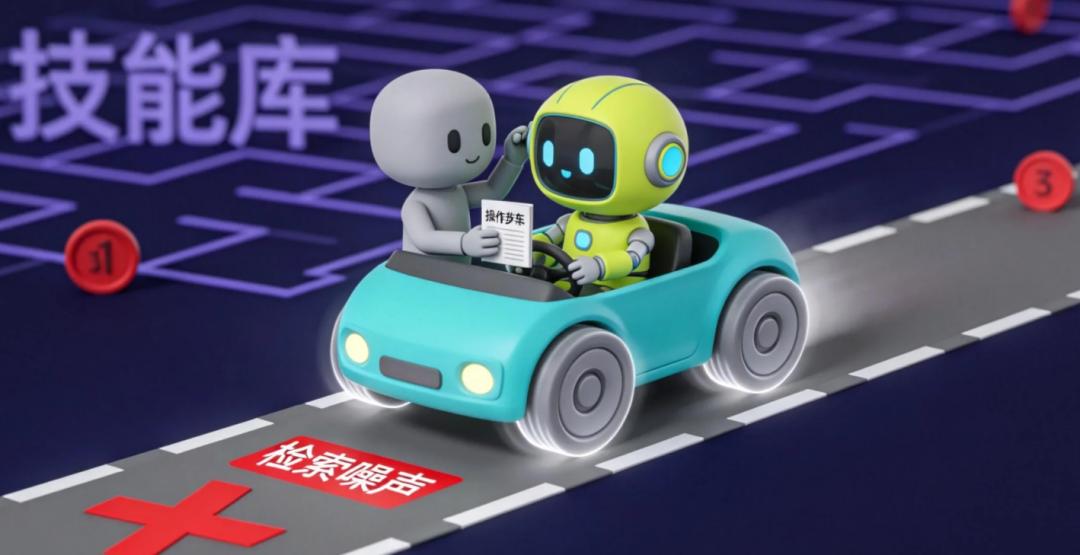
你能把车开走,但你根本没学会开车。教练一撤,你直接熄火。
这就是当下所有Agent方案的核心痛点,也是行业绕不开的三道坎:
第一,检索噪声致命。就像教练念错了步骤,你只会跟着错。检索到不相关的技能,会直接把模型的决策带偏,任务成功率直接跳水。
第二,token开销爆炸。每一步决策都要把技能手册塞进上下文,多轮对话下来,token成本滚雪球一样涨。比如行业标杆SkillRL,每步推理要花2.2k token,普通团队根本扛不住规模化落地的成本。
第三,也是最致命的:模型根本没学会技能,只是在照本宣科。
能力全在上下文的技能说明书里,根本没刻进模型参数里。推理的时候一撤技能,模型直接打回原形,和零基础的零样本模型没区别。
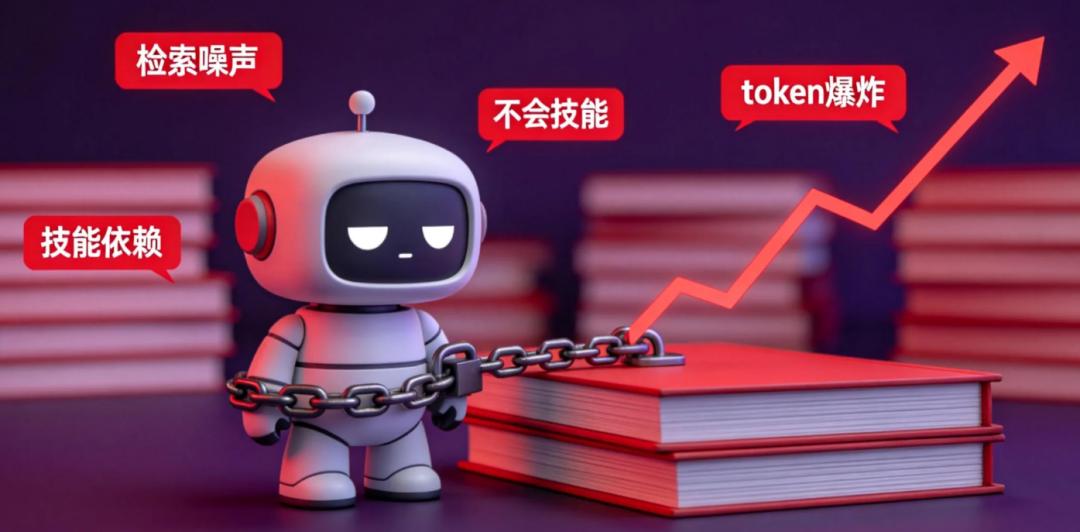
现在整个Agent行业,都陷在了“技能库越做越大,检索越做越复杂,模型却越来越离不开拐杖”的怪圈里。
而这篇SKILL0论文,直接把这个拐杖扔了,还让模型跑得更快更远。
二、SKILL0的核心创新:把技能从“说明书”变成“教学脚手架”
SKILL0的核心逻辑,完全复刻了人类学技能的完整过程:从照着说明书做,到慢慢熟练,最后不用想就能自主完成。
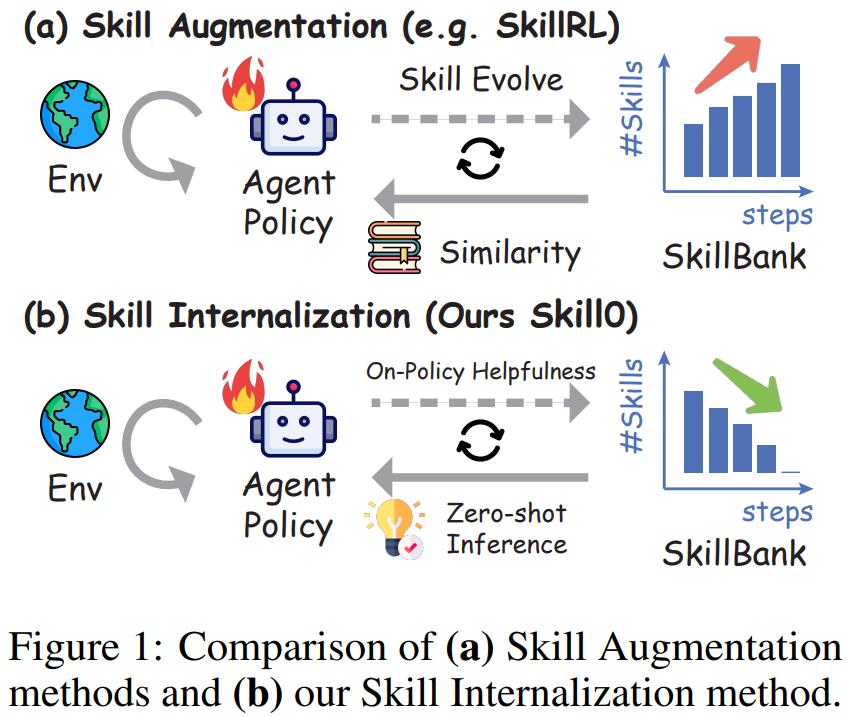
它的核心口号只有一句话:Skills at training, zero at inference. 训练带满技能,推理零技能依赖。
我把它的核心创新,拆解成三个关键点:
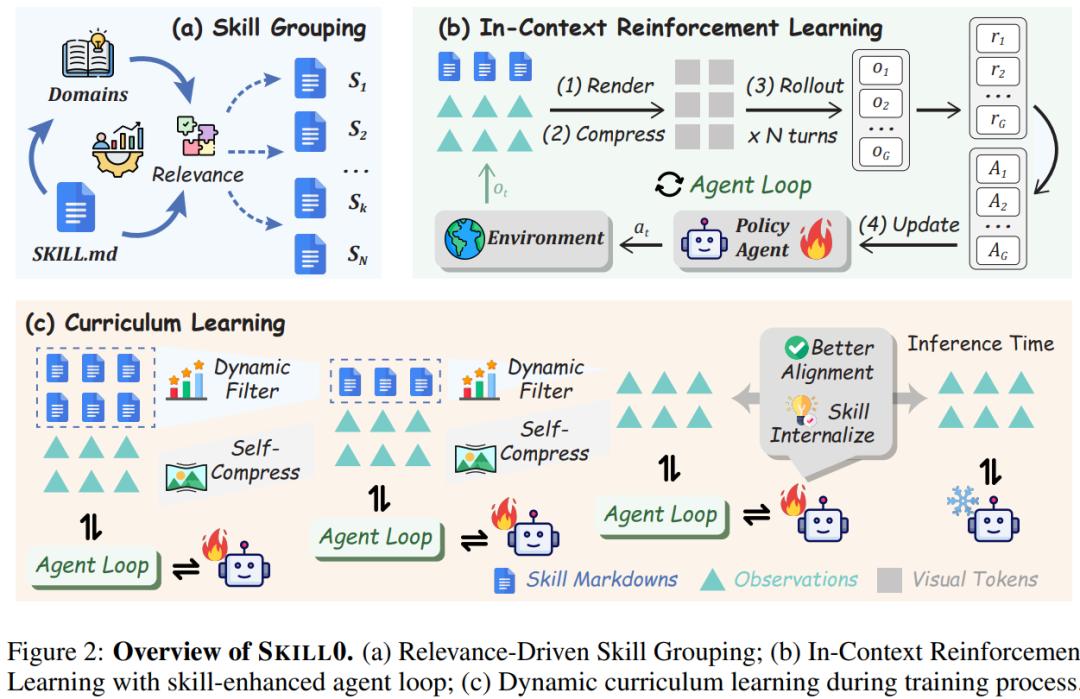
1. 上下文强化学习:逼着模型真学会,不是假看懂
先给大家补个常识:强化学习(RL),就是让AI通过试错,在环境里学会完成任务的方法。
之前的方案,要么全程不给技能,模型像无头苍蝇一样乱试,根本学不会复杂任务;要么全程给技能,模型只会照着念,永远形成不了自己的能力。
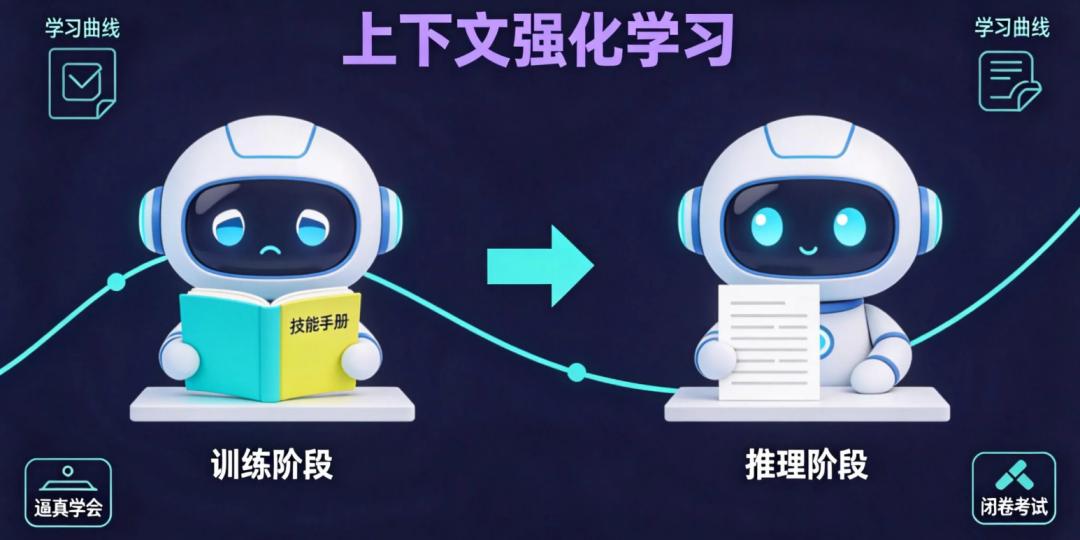
SKILL0做了一个颠覆性的设计:
训练的时候,给模型完整的技能上下文;但推理评估的时候,把所有技能全拿走。
整个强化学习的优化目标,从“照着技能把任务做完”,变成了“把技能内化成自己的能力,没了说明书也能把任务做好”。
就像练车的时候给你看操作手册,考试的时候必须闭卷。你只有真的把步骤刻进脑子里,才能通过考试。
2. 动态课程学习:最科学的“撤拐杖”方案
你可能会问:直接把技能全撤了,模型不会直接崩了吗?
这就是SKILL0设计最妙的地方——它不是生硬的“前半程给技能,后半程全拿走”,而是做了一套自适应的动态课程。
简单说,它会定期给每个技能做“摸底考试”:
在验证任务里,分别测模型“带这个技能”和“不带这个技能”的表现差距。
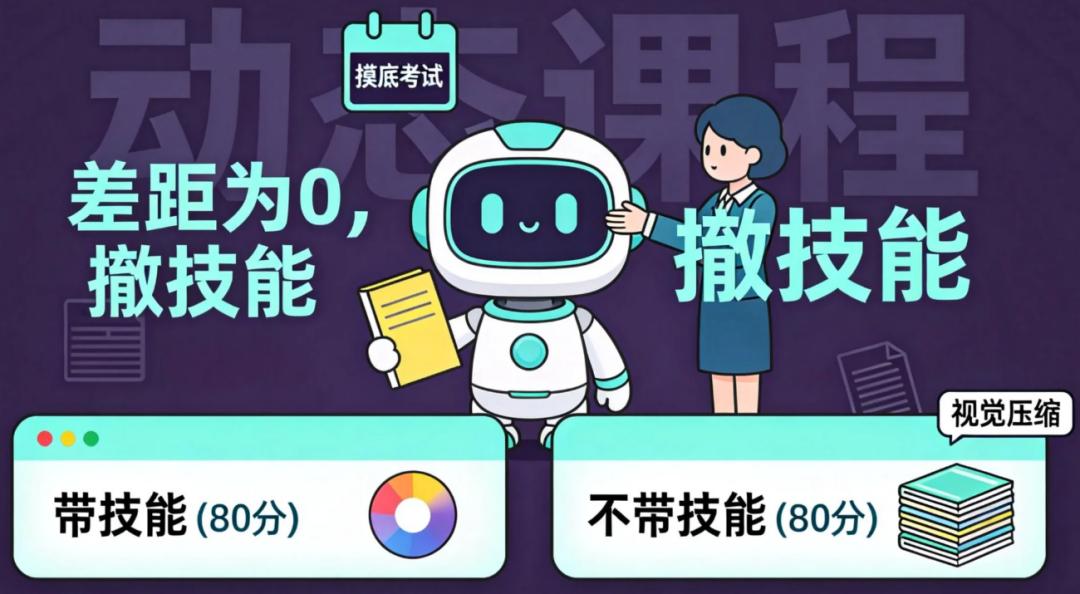
如果差距为0,说明模型已经完全掌握了这个技能,立刻把它从上下文里删掉;
如果差距还很大,说明模型还没学会,就再留一段时间,继续教学。
直到最后,所有技能全被撤掉,模型完全进入零技能推理状态。
论文里的消融实验直接证明:固定全程给技能的模型,一旦撤掉技能,效果直接暴跌13.3%;而用这套动态课程的模型,撤掉技能之后,效果反而还涨了1.6%。
说白了,它完美避开了“技能依赖”的坑,让模型真正完成了从“照着做”到“自己会”的内化。
3. 视觉上下文压缩:把token成本打到底
除了技能内化,SKILL0还解决了长上下文的token开销难题。
它把交互历史和技能内容,渲染成一张紧凑的RGB图片,用视觉编码器压缩成向量,再喂给模型。
就像把厚厚的一本说明书,缩成了一张一目了然的思维导图,既保留了所有关键信息,又把token开销砍到了极致。
三、最反常识的实验结果:没了技能,模型反而更强了
所有数据都来自论文的公开实验,Skill0全程零技能推理:
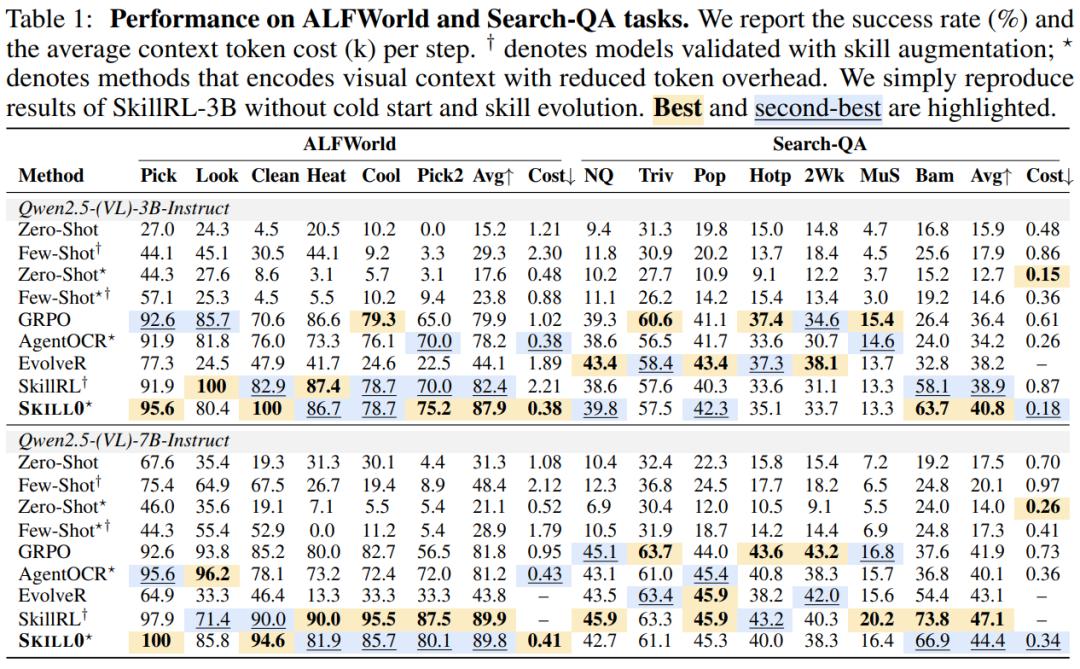
• ALFWorld家居机器人任务:3B模型的SKILL0,平均成功率87.9%,比标准RL基线AgentOCR直接高了9.7%,甚至比全程带技能的SkillRL(82.4%)还要强。
• Search-QA搜索问答任务:同样3B模型,平均分40.8%,比AgentOCR高了6.6%,和带技能的SkillRL打平甚至反超。
• 7B模型效果直接碾压闭源大模型:在ALFWorld任务上,SKILL0零技能推理做到了**89.8%**的成功率,远超GPT-4o(48.0%)和Gemini-2.5-Pro(60.3%)。
但让我最关注的,还不是效果反超,而是它的极致token效率。
3B模型的SKILL0,每步推理的上下文token开销:
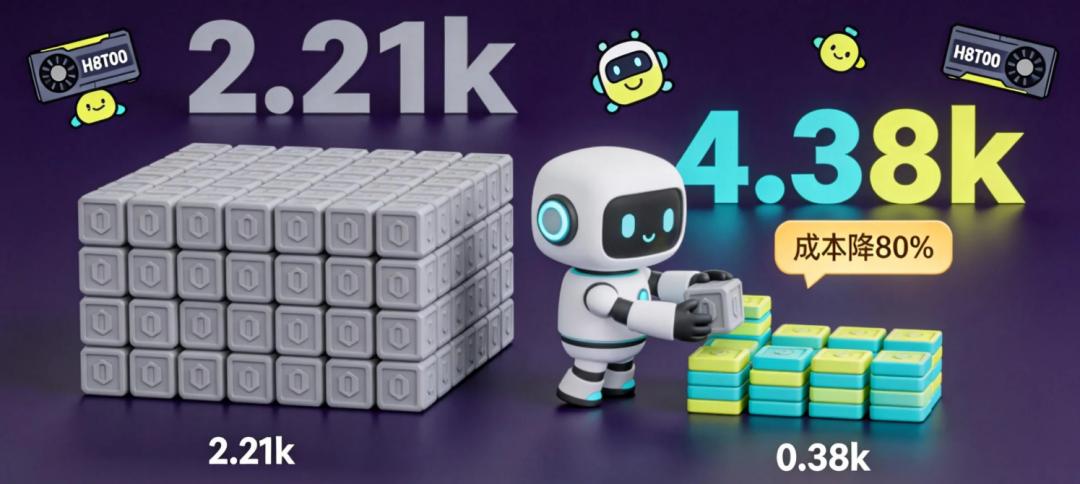
• ALFWorld任务仅0.38k,比SkillRL的2.21k,省了5倍还多;
• Search-QA任务仅0.18k,比SkillRL的0.87k,同样省了近5倍。
全程把单步token控制在0.5k以内,这是什么概念?
意味着Agent规模化落地的推理成本,直接被打了个2折,之前用不起的中小团队,现在也能玩得转了。
更有意思的是训练曲线:
训练初期,带技能的模型效果涨得飞快,不带技能的效果拉胯;但随着训练推进,不带技能的效果慢慢追了上来,最后甚至反超。
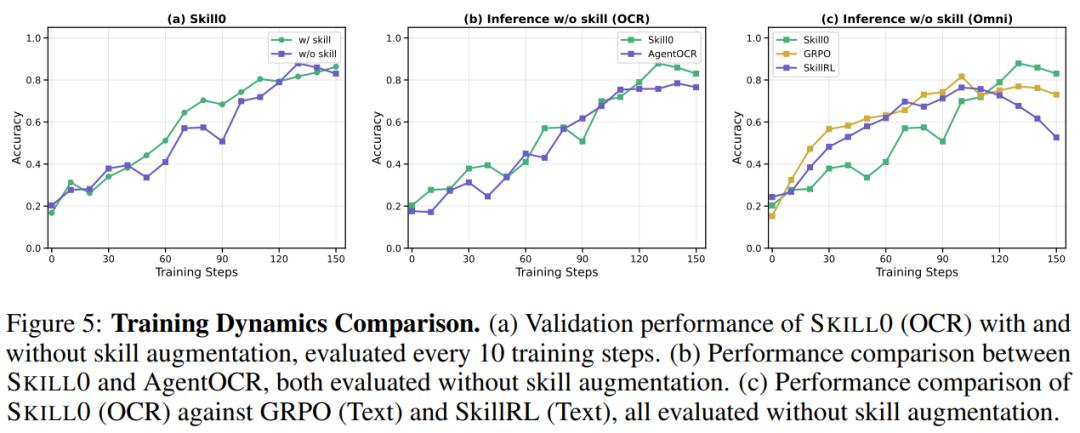
这就是实打实的技能内化——模型真的把技能刻进了参数里,不是临时抱佛脚。
四、底层逻辑:为什么扔了拐杖,反而走得更远?
回到最开始学车的类比。为什么教练全程念步骤,你永远学不会开车?
因为你的注意力全在听指令上,根本没去思考“为什么要打这个方向”“什么时候该踩离合”,大脑根本没形成自己的肌肉记忆。
而SKILL0的训练方式,是逼着模型去思考:“技能里的步骤,到底是怎么解决问题的?下次没了说明书,我该怎么做?”
之前的所有技能增强方案,都把技能当成了“推理时必须带的必需品”,而SKILL0把技能变成了“训练时用的教学脚手架”。
脚手架是帮你盖楼的,楼盖好了,脚手架必须拆掉,才能看到完整的建筑。
而之前的行业方案,都是把脚手架焊在了楼上,楼永远盖不完,模型永远成不了真正的自主智能。
这就是SKILL0效果反超的本质:
它把模型从“照着技能做决策”的机械执行,解放了出来,逼着模型把外部的程序性知识,内化成了自己的参数能力。
最终实现了:没了外部依赖,反而有了更强的自主决策能力。
五、工程落地:这不是纸上谈兵,是Agent规模化的破局点
很多学术论文好看不好用,但SKILL0不一样,它直接解决了现在Agent落地的三大死穴:
第一,推理成本直接打骨折。
现在Agent落地最大的门槛,就是多轮对话的token成本居高不下。SKILL0把单步token控制在0.5k以内,规模化落地的成本直接降80%以上,普通团队也能扛得住。
第二,从根源上解决了检索噪声问题。
现在技能库越大,检索越容易出错,一个错误的技能直接把Agent带偏,稳定性极差。SKILL0推理的时候根本不用检索技能库,从根源上优化了检索噪声,Agent的稳定性显著提高。
第三,真正的离线自主Agent成为可能。
之前的Agent,没了技能库、没了网络检索,就是个废物,根本没法在嵌入式、离线低资源场景落地。SKILL0把技能内化进模型,单模型就具备完整的任务能力,不用依赖任何外部组件,落地场景直接拓宽了一个量级。
更关键的是,它的落地门槛极低。
论文里用的是开源的Qwen2.5-VL 3B/7B模型,4张H800显卡,最多180步训练就能完成,中小团队完全可以复现和落地,不是只有大厂能玩的黑科技。
结尾
这篇论文最核心的价值,不是提出了一个新的RL框架,而是彻底重构了Agent技能的核心范式。
从“推理时技能增强”,转向“训练时技能内化”。
它打破了整个行业对“Agent必须带技能库”的固有认知,让Agent从“照着说明书操作的工具人”,真正走向了“具备自主能力的智能体”。
其实不止是AI,我们每个人学东西,都是这个道理。
永远照着PPT念的人,永远成不了好讲师;永远看着菜谱做饭的人,永远成不了好厨师;永远依赖外部工具的人,永远练不出自己的真本事。
真正的成长,从来都是把外部的知识,内化成自己的能力,而不是永远做知识的搬运工。
带说明书的,永远是工具;把说明书刻进骨子里的,才是智能。
参考资料
• SKILL0: Skill Internalization via In-Context Reinforcement Learning for Zero-Shot Autonomous Agents, https://arxiv.org/pdf/2604.02268