斯坦福&MIT最新Meta-Harness技术:端到端优化大模型Harness
斯坦福、MIT团队刚发了最新研究:端到端优化大模型周边代码(Meta-Harness)。
大模型系统的性能上限,往往是包裹模型的那层Harness代码决定的。Harness作为最近火起来的概念,大家还想怎么做Harness人工优化的时候,已经有人在研究它的自优化了。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
先搞懂:Harness是什么,我们卷错了什么?
先给所有人讲透一个词:Harness。
说白了,它就是大模型的「专属管家」。
你给大模型的任务指令,不会直接丢给模型本身,而是先经过Harness这层代码:它决定给模型看什么上下文、存哪些历史信息、什么时候调用工具、怎么组织prompt格式,甚至模型每一步输出后要做什么校验。同一个学生(固定大模型),一个管家只给他最有用的公式、精准的错题本;另一个管家给他一堆杂乱无章的资料,甚至关键信息都漏了。
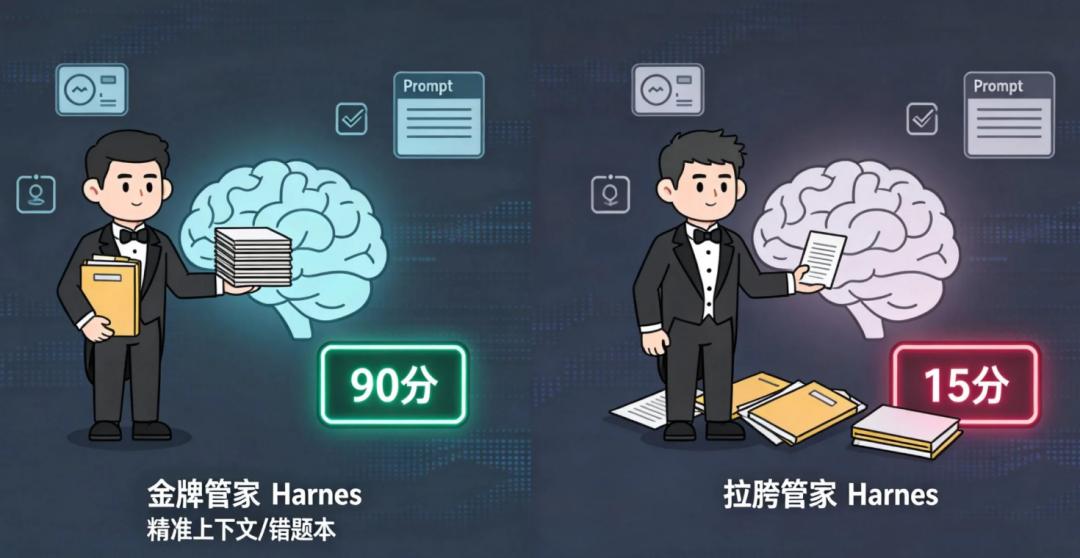
两者的成绩,能差多少?
这篇论文开篇就扔了个王炸:同一个固定大模型,换不同的Harness,同个基准测试上能跑出6倍的性能差距。
你可能突然就懂了:为什么你用和别人一样的GPT、Claude,做出来的应用效果天差地别?
不是模型不行,是你的「管家」太拉胯了。
但行业现状是什么样的?
现在的Harness工程,全靠人工手搓。算法工程师、研究员对着失败案例反复改逻辑、调规则、试prompt,全靠经验踩坑,效率低到离谱,上限完全取决于工程师的个人能力。
更要命的是,现有的自动优化方法,全是「瞎子摸象」。
它们要么只看最终的分数,要么只保留最近几次的结果,把完整的执行轨迹、失败细节全压缩成了几句总结。就像你改简历,只知道「这份简历没拿到面试」,却不知道是哪句话、哪个经历出了问题,只能闭着眼瞎改。
而这篇论文,直接把人工Harness工程这个事,给彻底自动化了。
Meta-Harness的核心创新:把「盲猜优化」变成「因果诊断」
我用一句话讲透它的本质:它是一个会复盘、会看病、会改方案的金牌Harness架构师,而不是只会瞎改模板的实习生。
它和现有方案的核心区别,只有两点:
第一,扔掉「压缩反馈」,给足全量的诊断信息
现有所有文本优化方法,每次迭代能用到的反馈信息,最多只有几万token。
相当于你改方案,只能看一页纸的精简总结,连完整的失败案例都看不到。
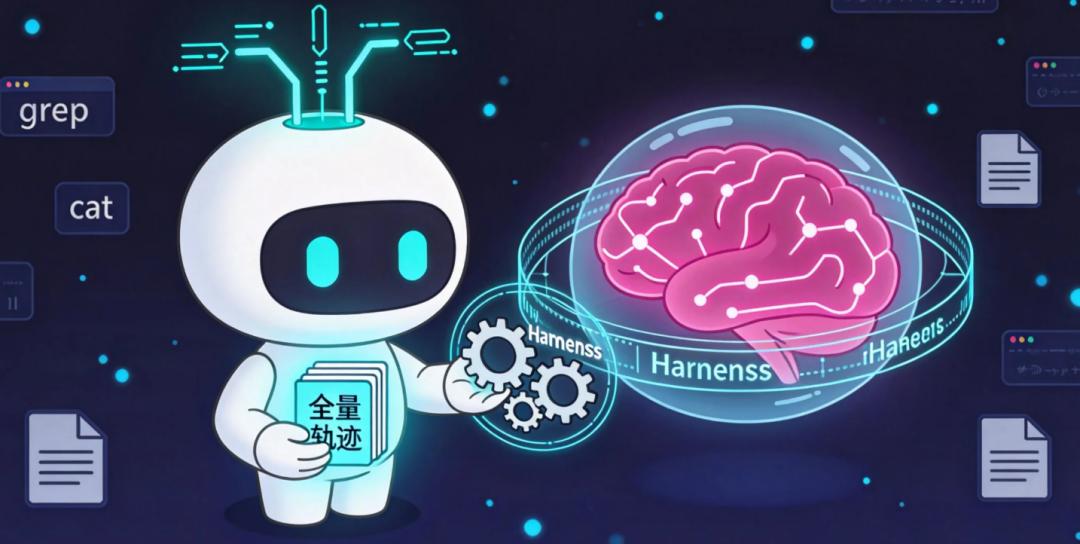
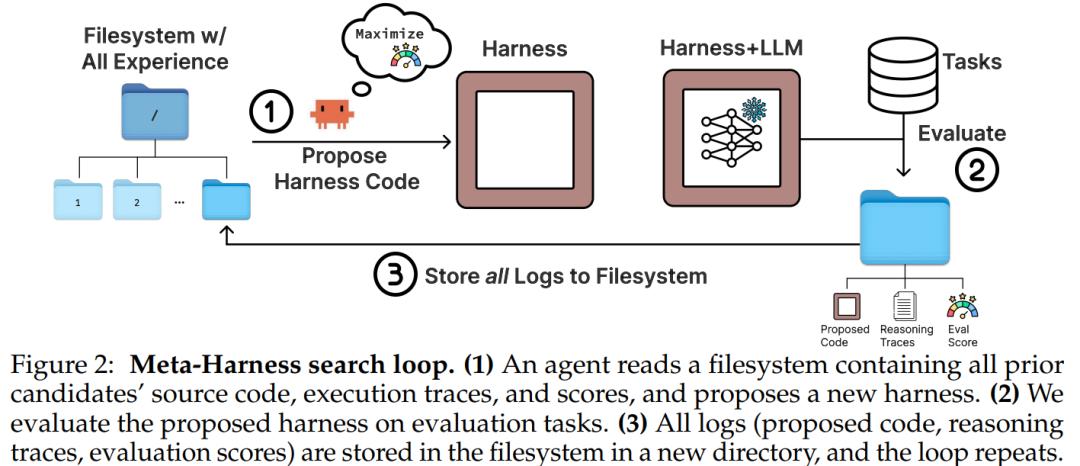
而Meta-Harness,直接给了提案者千万级token的全量历史数据:之前所有版本的Harness源代码、每一次执行的完整轨迹、每一个案例的成功失败细节、所有的分数记录,全给你。
你可能会问:这么多内容,模型的上下文窗口装不下怎么办?
这就是这个设计最妙的地方。它没有把所有日志硬塞到一个prompt里,而是做了一个文件系统,让编码智能体用grep、cat这些开发者命令,自己去查、去搜、去看。想查哪个版本的代码就查哪个,想看哪个失败案例的轨迹就看哪个,完全不受上下文窗口的限制。
论文里有个数据:提案者每次迭代,平均会读取82个文件,参考20多个之前的候选版本,精准定位问题。
这就像医生看病,终于不用只靠体温猜病因,而是能看完整的CT、验血报告、病史记录,直接找到病根。
第二,把「怎么优化」这件事,也交给了智能体自己
现有方法,全是人工定死的优化规则:选哪几个父版本、做什么类型的突变、用什么模板改,全是提前写死的。
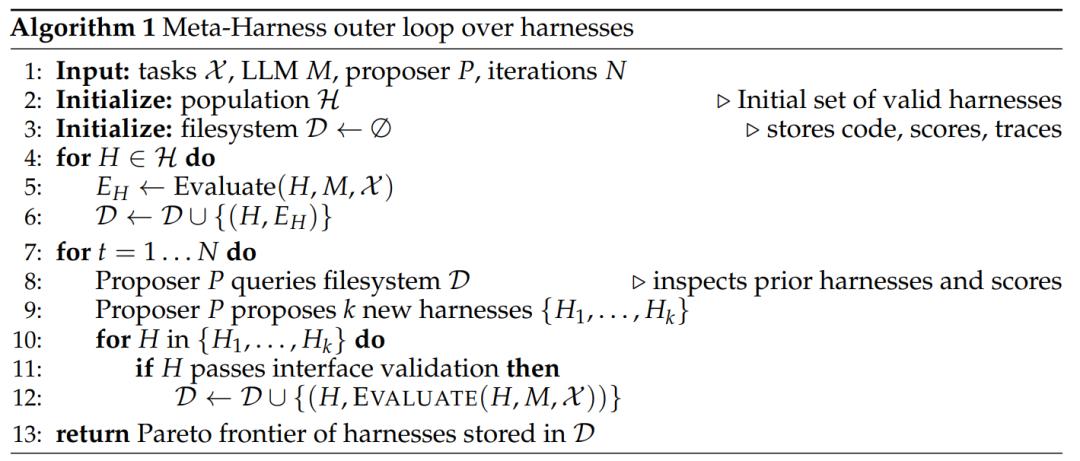
而Meta-Harness,只给智能体定了一个目标:优化Harness的性能。
剩下的,全交给智能体自己决定:看哪些历史数据、诊断什么失败模式、做局部修改还是整体重构,全是它自己说了算。
它的搜索空间,是完整的代码空间,不是人工预设的几个模板、几个参数。
它可以自由设计两阶段的分类逻辑,可以给数学题做分学科的检索路由,也可以给智能体加环境预加载逻辑——这些优化点,全是它自己发现的,不是人工提前教的。
我最认可的一个设计判断:这个系统的优化能力,会随着编码智能体的变强自动提升。你不用改外层的搜索逻辑,只要换更强的编码智能体,它就能优化出更好的Harness,这才是真正的「元优化」。
硬核结果:自动优化,超越顶尖人工方案
1. 文本分类:4次迭代,追上别人60次的效果
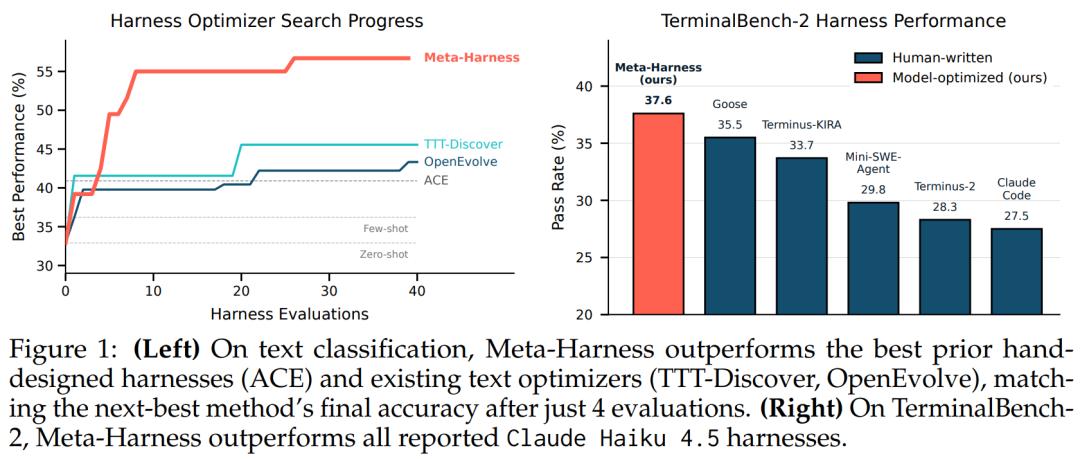
在在线文本分类任务上,Meta-Harness的表现堪称降维打击:
• 比人工精心设计的SOTA方案ACE,准确率直接提升7.7个百分点,同时上下文token用量直接减少4倍,真正做到了又准又省。
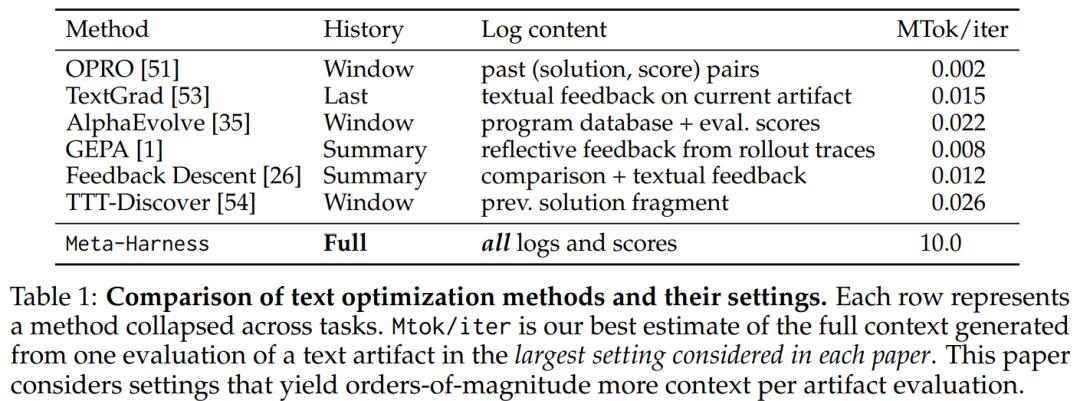
• 现有最好的文本优化方法,要60次迭代才能达到的最终效果,Meta-Harness只用4次评估就追上了,速度快了15倍,最终准确率还超出了10个百分点以上。
最能证明核心逻辑的,是它的消融实验:
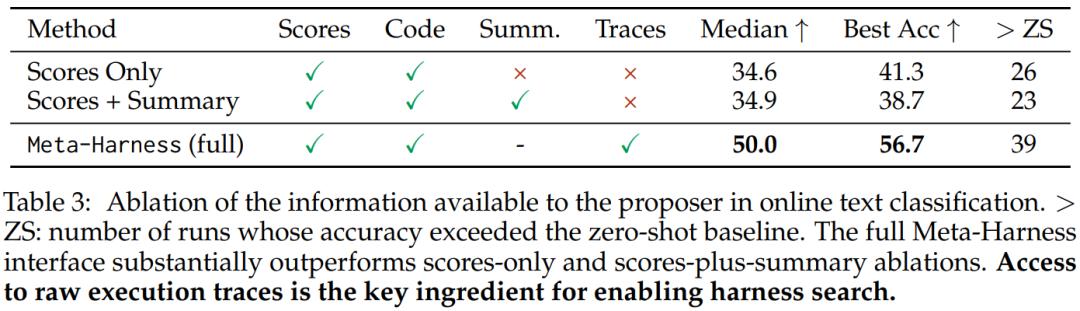
• 只给分数、不给完整轨迹的版本,最好准确率只有41.3%;
• 给LLM生成的摘要、不给原始轨迹的版本,最好准确率只有38.7%;
• 给全量执行轨迹的Meta-Harness,最好准确率直接干到56.7%,就连中位数表现,都比前两个版本的最好成绩还要高。
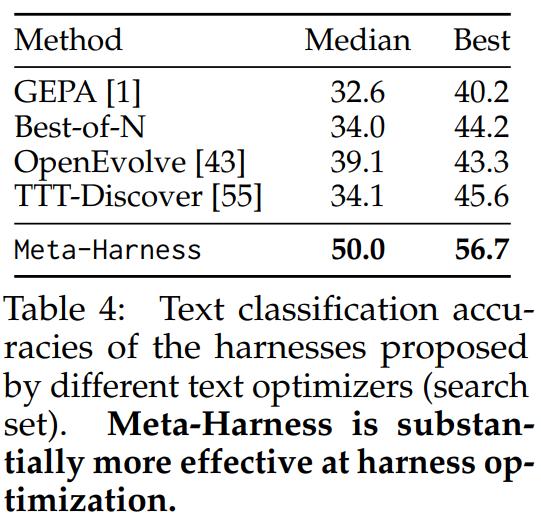
这直接锤死了:全量的执行轨迹,才是Harness优化的核心,压缩反馈就是在丢西瓜捡芝麻。
2. IMO级数学推理:跨模型通用,零额外成本涨点
数学推理是大模型的硬骨头,检索增强做了这么久,一直没突破,核心就是人工写不好检索策略。
而Meta-Harness自动发现的检索Harness,交出了一份优秀的结果:
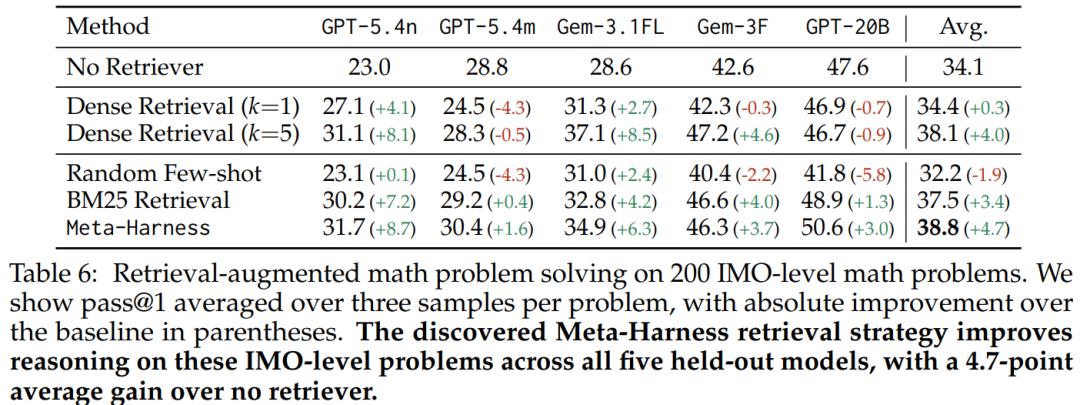
• 在200道IMO级难题上,跨5个完全没见过的大模型,平均准确率提升4.7个百分点;
• 只用了最基础的BM25检索,没加任何额外的嵌入模型,纯靠优化检索策略代码,效果就超过了人工设计的BM25基线1.3个百分点,还避免了密集检索那种部分模型性能倒退的问题。
重点是,这个Harness是在一个模型上优化出来的,却能在5个完全没见过的模型上通用涨点,泛化性显著。
3. 智能体编码竞技场:直接冲上排行榜第一
TerminalBench-2是行业里公认的智能体编码硬核竞技场,全球顶尖团队都在卷。
而Meta-Harness自动优化出来的Harness:
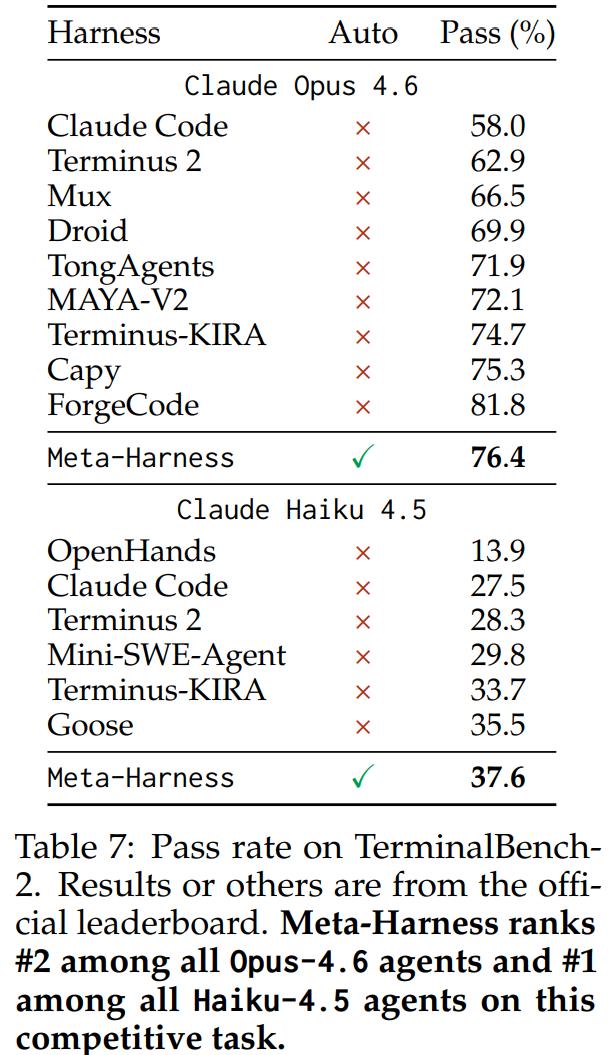
• 在Claude Opus 4.6上,通过率76.4%,超过了人工打磨的Terminus-KIRA(74.7%),直接冲到排行榜第二;
• 在更弱的Claude Haiku 4.5上,提升更夸张,通过率37.6%,超过了第二名Goose的35.5%,直接拿下排行榜第一!
更有意思的是,它发现的核心优化点,是人工根本没在意的细节:在智能体启动前,先跑一行命令获取环境快照,把系统、安装的工具、目录文件都列出来,直接省了2-4轮的无效探索步骤。
就这么一个点,直接把通过率拉了上去,而人工对着成千上万条轨迹,根本不可能精准找到这个根因。
底层逻辑:为什么它能比人工做得更好?
说白了,它解决了人工优化Harness的两个根本死穴。
第一个死穴:人工做不到完整的因果归因。
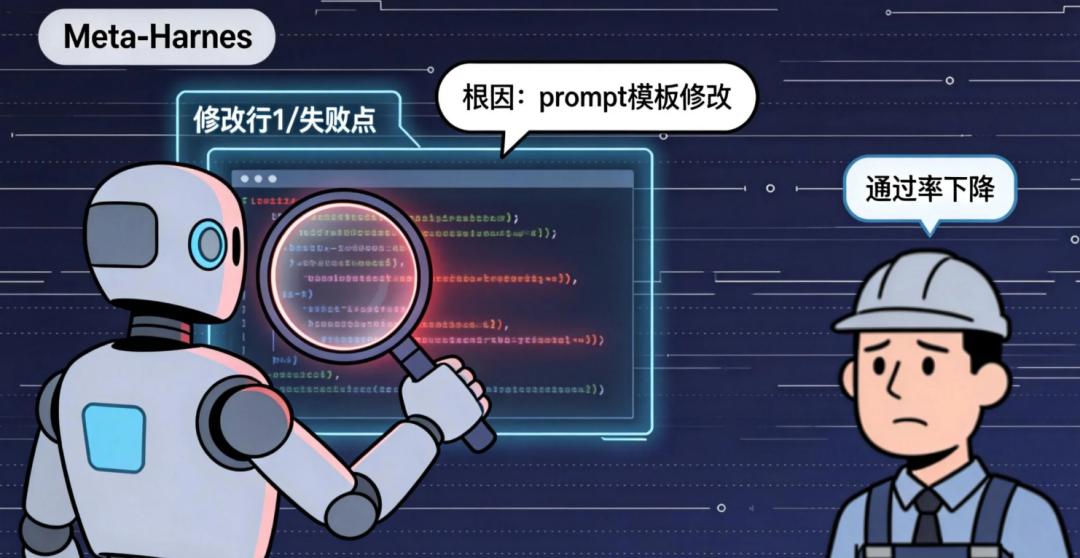
人工优化Harness,只能看到「这个版本通过率降了」,但很难搞清楚「到底是哪一行代码改坏了」。尤其是多个修改混在一起的时候,根本分不清哪个是加分项、哪个是减分项。
而Meta-Harness能对着完整的执行轨迹,一帧一帧复盘,精准找到混淆变量。论文里就记录了这个过程:它发现前两次优化都倒退,核心原因是改了prompt模板,而不是结构修复的问题,直接把根因揪了出来,单独验证了有效修改。
第二个死穴:人工的经验无法形成复利。
人工优化Harness,换个工程师、换个项目,之前踩过的坑、积累的经验就全丢了。而且人不可能记住几十上百个版本的代码、成千上万条执行轨迹。
而Meta-Harness的每一次迭代,所有数据都会永久存在文件系统里,后面的迭代能复用所有之前的经验,甚至能跨搜索run迁移经验。之前发现「不要清理服务文件」能涨18个点,后面的迭代直接就能用上,真正实现了经验的复利。
一句话总结它的本质:它把Harness优化,从「基于分数的盲猜」,变成了「基于全量轨迹的因果诊断」。
这就是它能吊打所有现有方案的根本原因。
产业落地:它会彻底改变LLM应用的开发范式
这篇论文最狠的地方,不是提出了一个新工具,而是把LLM系统的工程化,推进到了一个全新的范式。
它的落地价值,每一点都戳中了行业的痛点:
1. 优化成本显著降低:之前顶尖算法工程师花几周、几个月打磨的Harness,现在它几个小时就能跑完60次迭代,出来的效果比人工还好,人力成本直接降到接近零。
2. 零成本解锁模型性能上限:大家花几百万加参数、加算力,模型性能也就提升几个点;现在不用动模型权重,只改Harness代码,就能提升几个点甚至十几个点,性价比直接拉满。
3. 全场景适配,开箱即用:不管你用的是开源模型还是闭源API,不管是做文本分类、RAG、数学推理,还是智能体、客服机器人、代码助手,只要是LLM系统,就能用它来优化。
4. 完全白盒,可解释可审计:它优化出来的是可读的Python代码,不是黑盒的模型权重。哪里改了、为什么这么改,一目了然,出了问题能直接debug,完全不用担心黑盒风险。
未来LLM应用的开发范式会彻底改变。
之前的范式是:选模型→人工写Harness→反复调优上线;
未来的范式会变成:定任务目标→自优化Harness→直接上线。
以后LLM应用的核心竞争力,不再是谁能写出更好的prompt、更好的Harness,而是谁能用好这种元优化工具,快速迭代出最优的系统。
最后想说的话
这篇论文最核心的价值,不是提出了一个能打SOTA的新系统,而是给整个行业提了个醒:
我们花了太多精力去卷大模型的「大脑」,却忘了给大脑配一个好的「管家」。
大家都在拼命给模型加参数、加算力,却没发现,包裹模型的那层薄薄的代码,才是决定系统性能上限的关键。
这篇论文给我最大的启发,其实是一个最朴素的道理:
真正的优化,从来不是在信息不全的情况下反复试错,而是先拿到完整的信息,找到真正的根因,再做精准的改变。
不管是优化LLM系统,还是做产品、做管理、做人生决策,都是如此。
太多人只看结果、只看分数,却不愿意花时间去看完整的过程、找到真正的问题,最后只能在原地打转。
而真正聪明的系统,从来都不是最笨重的那个。
能让大模型发挥出全部潜力的,从来不是更重的权重,而是更聪明的Harness。
参考资料
• Meta-Harness: End-to-End Optimization of Model Harnesses, https://arxiv.org/pdf/2603.28052