「Harness Engineering」为什么需要 Harness Engineering?从Claude Code源码里扒出的真相:智能体不乱来,全靠这5层“枷锁”!
从Claude Code源码里扒出的真相:智能体不乱来,全靠这5层“枷锁”
做AI工程的都有个共同的痛:
聊智能体时,个个眉飞色舞——“能写代码、能调工具,堪比见习工程师”;可真把它放进终端、接触文件系统和Git,瞬间慌了神:一个指令写错,代码删光、仓库搞崩、权限泄露,轻则加班回滚,重则出生产事故。
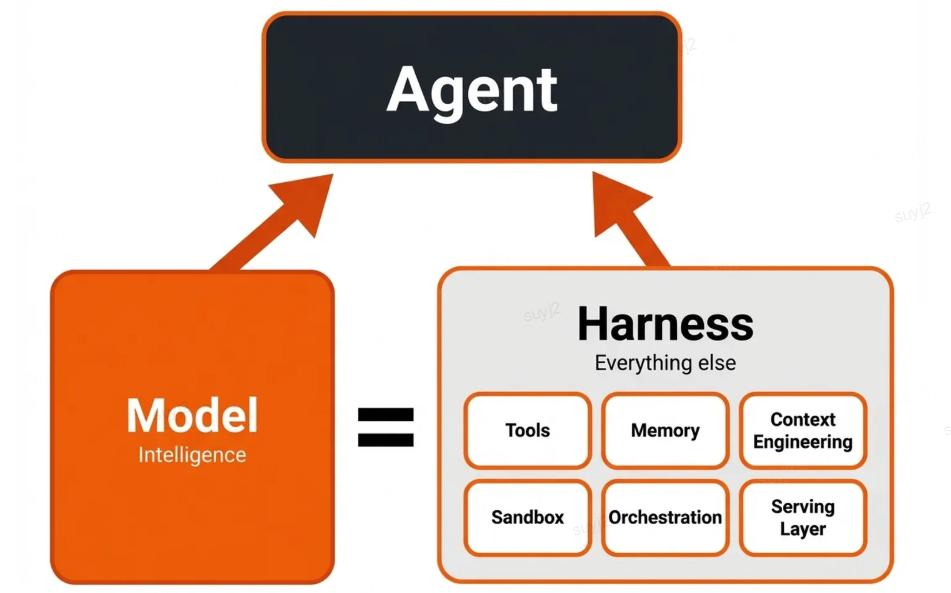
我们总在追求“更聪明的模型”,却忘了一个更本质的问题:智能体的核心不是“会做事”,而是“能可控地做事”。
而解决这个问题的关键,就是今天要深扒的——Harness Engineering(约束工程)。
很多人把它和Prompt Engineering(提示工程)混为一谈,但其实两者天差地别:提示工程管“怎么说”,约束工程管“怎么做、不能做什么”;前者是话术技巧,后者是一套实打实的系统控制逻辑。
最直观的例子,就是Anthropic的Claude Code。我翻了它的开源源码,发现它能稳定落地,根本不是靠模型多强,而是藏着5层“约束枷锁”——每一层都在解决一个真实工程痛点,每一行代码都在践行“先约束,再执行”的逻辑。
今天就从源码出发,用最实在的工程视角,把Harness Engineering讲透,没有空话、没有AI套话,全是能直接复用的底层逻辑。
先搞懂核心:为什么智能体必须“戴枷锁”?
我们总对智能体有个误解:觉得它只要“懂指令、会工具”,就能独立干活。但忽略了一个致命问题:
模型本质上就是一个“会说话的概率分布”——它只负责输出“最可能正确”的内容,不负责“绝对安全”的执行。
当它只输出文本时,最多是回答得不够好;可一旦让它接触shell、Git、本地文件,问题就从“话术问题”变成“执行灾难”:删错配置文件、乱提交代码、越权访问数据,这些不是“偶然失误”,而是模型的“天性”——它不懂工程边界,也没有风险意识。
而Harness(约束),就是给这个“天性不羁”的模型,套上一套制度化的“控制平面”:不是不让它做事,而是让它在规定的边界内,按既定规则做事。
Claude Code的源码,从头到尾都在践行这个逻辑——它没有把自己当成“裸模型接口”,而是一个被层层约束的“可控系统”。这也是为什么它能在真实工程环境中落地,而很多开源智能体只能停留在demo阶段。
深扒Claude Code源码:5层约束,层层锁死风险
我翻了Claude Code的核心源码文件(从prompts.ts到query.ts,再到toolOrchestration.ts),发现它的约束逻辑不是零散的,而是分成了5层,从“话术边界”到“错误处理”,形成了一个完整的控制闭环。每一层都有具体的源码支撑,真实可查、可复用。
第一层:受约束的会话系统——把Prompt变成“控制规则”,不是“人格装饰”
很多人写Prompt,还停留在“你是一个资深工程师,要认真写代码”这种空洞的修辞上。但Claude Code的Prompt,根本不是用来“塑造人格”的,而是用来“定义边界”的。
在src/constants/prompts.ts文件里,从175行开始,它的Prompt组织得极其规整:
175行起,先明确模型的身份和总任务(不是“助手”,而是“受约束的工程执行者”);186行起,补充工具权限、系统提醒、上下文压缩的系统级说明(比如“不能越权调用工具”“上下文满了要自动压缩”);199行起,再细化工程约束(“不要把验证说成已完成”“不要为了省事发明无意义的抽象”)。
更关键的是,它的Prompt不是“一整块”,而是“分段拼装”的。
在src/constants/prompts.ts的444行getSystemPrompt()函数里,静态规则和动态内容被明确拆开——memory、语言、输出风格、工具调用说明等,都是按段注入的;到了src/utils/systemPrompt.ts的28行,还定义了Prompt的优先级:默认Prompt < 自定义Prompt < 代理Prompt < 追加Prompt。
这背后藏着一个朴素的工程常识:一个可用的代理系统,不可能靠一段“万能Prompt”解决所有问题。就像写代码要分层、分职责一样,Prompt也要分层——新增一条约束不会和旧约束冲突,修改某部分规则也不会影响整体逻辑。
很多人做智能体,Prompt越写越长,最后自己都理不清逻辑,模型执行起来更是混乱——本质就是没搞懂“Prompt是控制平面的一部分”,而不是随便写的话术。
第二层:代理依赖持续循环——承认“单次执行不靠谱”,用状态机控全局
如果说Prompt定义了“该做什么、不该做什么”,那query loop(查询循环)就定义了“实际怎么跑”。
Claude Code的核心,根本不是某个单独的API调用,而是src/query.ts里219行开始的query()函数,以及241行开始的queryLoop()函数。这段代码最打动我的一点,是它坦诚承认“代理系统依赖带状态的多轮执行”——没有妄想“一次调用就搞定所有事”。
在src/query.ts的268行,它把messages(消息)、toolUseContext(工具使用上下文)、autoCompactTracking(自动压缩跟踪)、turnCount(轮次计数)等一系列参数,都放进了同一个跨迭代的状态里。
这意味着什么?意味着它明确知道:上一轮执行留下的问题,会带到下一轮;这一轮没处理完的任务,需要继续推进。比如模型调用工具失败了,不会直接报错终止,而是把“失败状态”记录下来,下一轮继续重试;上下文满了,会自动触发压缩,而不是直接崩溃。
更细节的是,在src/query.ts的365行往后,每一轮调用前,都会先处理消息裁剪、工具调用预算、历史片段截取、上下文压缩等操作——相当于“执行前先自查”,把控制权牢牢握在运行时手里。
这也是Harness和Prompt Engineering的核心区别:前者关心“状态机”(怎么持续可控地运行),后者关心“措辞”(怎么让模型听懂指令)。措辞再精准,没有状态机的控制,系统行为依然不可预测。
第三层:工具调用必须服从调度——工具不是“能力延伸”,是“受管单元”
智能体的风险,80%来自工具调用。一个模型如果只能输出文本,顶多让人觉得“说得不专业”;可一旦能调用Bash、Git、API,风险就会直接放大到外部系统——比如乱调用Bash删文件,调用Git乱提交代码,这些都是致命的。
Claude Code的解决方案很直接:工具调用必须服从调度,不能让模型“随心所欲”。
在src/services/tools/toolOrchestration.ts的19行runTools()函数里,工具调用会先经过partitionToolCalls()函数分组;到了91行,系统会读取工具的schema( schema),调用isConcurrencySafe()函数判断工具是否适合并发执行——能并发的归为一批,不能并发的(比如操作文件、修改Git),就按顺序一个个执行。
更细心的是,在并发执行时,context modifier(上下文修饰器)会先缓存,再按原始block顺序回放(见31-63行)——避免并发调用导致上下文混乱,出现“上一个工具还没执行完,下一个工具就篡改了上下文”的问题。
很多开源智能体,直接让模型自由调用工具,没有调度、没有并发控制——结果就是,模型一次调用多个工具,互相冲突,最后把系统搞崩。而Claude Code的逻辑是:工具不是模型的“能力延伸”,而是需要被管理、被调度的“执行单元”,纪律比能力更重要。
第四层:高风险工具,配最细的规矩——Bash的约束,细到“每一步操作”
在所有工具里,Bash是最危险的——它几乎没有领域边界,能直接操作文件、进程、网络、Git仓库,还带着重定向、管道等复杂语义。一个不小心,一句Bash指令就能删光整个项目的代码。
Claude Code对Bash的态度,堪称“极致保守”——在src/tools/BashTool/prompt.ts的42行往后,写了一整段操作规约,细到让人觉得“啰嗦”,但却能从根源上避免事故:
- 不要乱改git config;
- 不要跳过Git hooks(钩子);
- 不要随手用git add .(避免误加敏感文件);
- 不要在pre-commit失败后,用--amend把上一条提交也搭进去;
- 没有明确要求,绝对不能提交代码,更不能默认push。
有人会觉得,这么细的规矩,会不会限制模型的灵活性?但在真实工程环境里,“安全”永远比“灵活”更重要。
Harness Engineering的一个核心原则就是:能力越强,约束越细。Bash的风险最高,所以它的约束也最密——外部世界不会因为模型“语气坚定”,就原谅一次错误的Bash执行;再多的道歉,也挽回不了删光代码的损失。
第五层:错误是主路径的一部分——不回避失败,只做“可恢复的执行”
很多软件的设计逻辑是:成功是常态,失败是例外——用几个catch语句打发失败,只要不崩溃,就当作“正常运行”。但智能体不能这么做。
因为模型的失败,不是偶然的,而是稳定存在的:超token、Prompt太长、工具调用拒绝、API重试、用户打断……这些问题不是“例外”,而是每天都会遇到的“常态”。如果只是用catch语句敷衍,问题只会越滚越大,最后彻底失控。
Claude Code在query loop里,把失败当成了“主路径的一部分”来处理。
光看src/query.ts的453行往后,关于autocompact(自动压缩)的处理,以及592行往后对上下文上限、阻断逻辑的注释,就能看出来:它没有回避失败,而是把“失败”当成一个需要持续处理的结构性条件——比如上下文满了,自动压缩;token超了,自动裁剪;工具调用失败,自动重试;重试多次失败,就主动中止并汇报。
这也是Harness和普通助手的最大区别:
普通助手:先执行,错了再道歉;
Harness约束下的智能体:先约束,再执行;错了,按既定路径恢复,不临场发挥。
一个会道歉的系统,不一定成熟;但一个知道“何时不该开始、何时该重试、何时该中止”的系统,才是能落地的系统。
最后提炼:从源码里总结的1个核心原则+6条工程常识
看到这里,你应该能明白:Harness Engineering一点都不神秘,它不是什么高深的技术,而是一套“直面模型缺陷、用结构控制风险”的工程思维。
从Claude Code的源码里,我们能提炼出最核心的一个原则:
代理系统的关键能力,不是“聪明”,而是“约束执行”。
而支撑这个原则的,是6条常被我们忽视的工程常识——也是做智能体落地,必须牢记的6句话:
- 模型一定会犯错(不要妄想“模型足够强就不会错”);
- 工具会放大错误的后果(工具越强,风险越高);
- 上下文一定会膨胀(必须提前做好压缩和裁剪机制);
- 上一轮的状态会污染下一轮(必须做好状态管理);
- 用户会随时打断执行(必须支持断点续跑);
- 失败会反复出现(必须把失败当成主路径处理)。
这6条常识,看似简单,却很少有人真正落实——很多人沉迷于“调参、写Prompt,追求更聪明的模型”,却忘了“结构比聪明更可靠”。
毕竟,智能体要进入真实工程环境,不是靠“说得好”,而是靠“做得稳”。而Harness Engineering,就是让智能体“稳下来”的核心密码。
后续我会继续深扒Claude Code的源码,拆解更多约束工程的实操细节(比如上下文压缩的具体实现、工具调度的核心逻辑),关注我,避免错过干货~
最后想问一句:你做智能体时,有没有遇到过“模型乱执行”的坑?欢迎在评论区留言交流~
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系