FinTradeBench:LLM炒股是神助攻还是猪队友?多维度金融推理基准
“FinTradeBench: A Financial Reasoning Benchmark for LLMs”
真实世界的金融分析需结合公司基本面和市场动态两方面信息。现有LLM金融评估基准很少评估基于历史价格动态的交易信号推理,也不要求模型整合多源信息,因此不清楚当前LLMs能否联合推理公司基本面和市场行为来回答金融问题。
本文提出FinTradeBench金融推理基准,精选常用金融分析信号,整合不同数据源支持结构化推理,用校准-缩放流程生成1400个基准问题。实验发现混合推理问题上各模型性能提升显著,大、中、小模型最高分别提升39.8%、55.1%、49.5%。不同模型家族对上下文敏感度不同,Qwen模型从RAG中受益,LLaMA模型表现下降。
【 扫描文末二维码加入星球获取论文 】
摘要
现实金融决策需对公司基本面和交易信号等异质信号推理。现有金融问答基准多关注公司资产负债表数据,少评估市场交易及与基本面的交互推理。为此引入 FinTradeBench 基准,含 1400 个基于纳斯达克 100 公司十年历史数据的问题,分基本面、交易信号、混合三类。采用校准 - 缩放框架确保可靠性。评估 14 个大语言模型,发现检索能提升文本基本面推理,但对交易信号推理帮助有限,凸显当前大语言模型在数值和时间序列推理上的挑战。
简介
真实世界的金融分析需结合公司基本面和市场动态两方面信息。公司基本面是基于会计的指标,反映公司财务健康;交易信号源自历史价格和成交量数据,体现市场动态和投资者情绪。有效财务分析和估值需整合这两种视角,且因需综合异质信息源、分析数值指标和解读不确定市场行为,财务分析颇具挑战性。
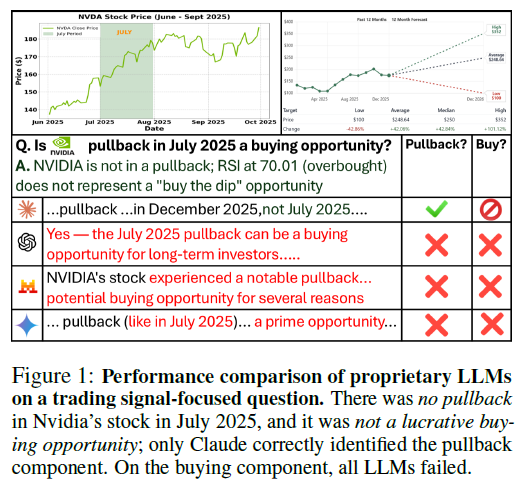
AI时代,大语言模型(LLMs)用于金融分析,现有基准数据集聚焦财务报告数值推理、长文本推理及检索式问答。但这些数据集很少评估基于历史价格动态的交易信号推理,也不要求模型整合多源信息,因此不清楚当前LLMs能否联合推理公司基本面和市场行为来回答金融问题,如判断英伟达2025年7月回调是否为买入机会,多数LLMs在处理此类问题时推理失败。
基本面与市场行为冲突时会产生歧义,如2025年4月特斯拉尽管一季度财报不佳、分析师看法谨慎,但股价仍上涨近20%,仅靠财务报表难判断买卖时机,评估此类推理较难。
本文提出FinTradeBench金融推理基准,精选常用金融分析信号,整合不同数据源支持结构化推理,问题分三类,用校准-缩放流程生成1400个基准问题。在零样本提示和检索增强设置下对14个大语言模型进行基准测试和评估,发现检索能大幅提升基本面和混合推理问题的准确率,但对交易信号问题效果有限或为负,表明当前大语言模型处理文本财务信息有效,但解读定量市场动态能力不足。
相关工作
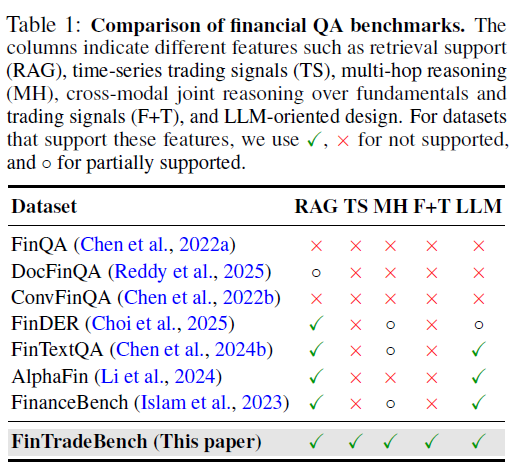
金融问答(QA)基准。过去十年金融问答和数值推理数据集激增,如FinQA、TAT-QA基于财务报告等;ConvFinQA拓展到对话场景,FinanceBench等扩展到长上下文金融推理和检索任务。这些基准推动了金融问答发展,主要聚焦文本财务披露和会计指标推理,但很少评估历史价格动态交易信号推理,也鲜少要求模型整合两种财务信息。
交易信号与量化交易。交易信号源于价格和成交量数据,对理解市场行为和风险动态至关重要。动量、波动率等指标被广泛研究,机器学习用于预测波动率和检测市场制度,但现有NLP基准很少评估大语言模型对这些信号的金融分析推理能力。
大语言模型评估与基准设计。精心设计评估大语言模型推理能力的基准很重要,金融问答因数值准确性、领域专业知识和异构数据源整合存在额外挑战。
与现有基准比较。现有金融问答基准侧重文本金融文档推理,量化金融研究聚焦交易信号预测建模,均未明确评估交易信号推理或基本面与市场动态的联合交互。FinTradeBench引入统一评估框架,涵盖公司基本面和交易信号的金融推理,更贴近现实金融分析。
FinTradeBench
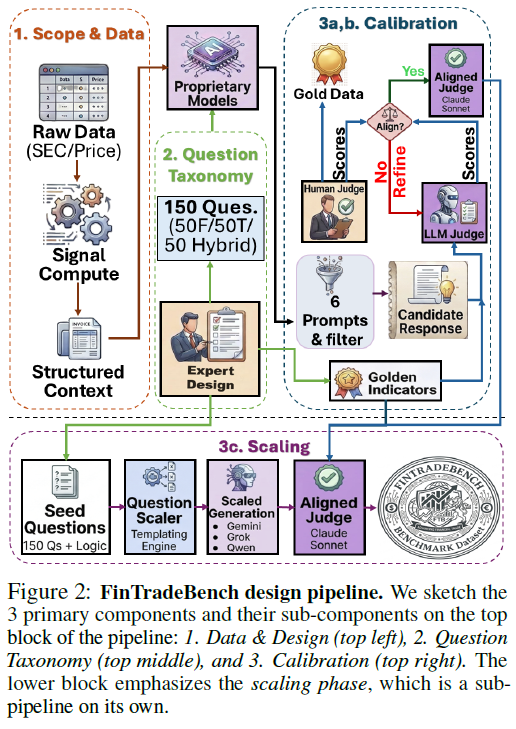
本文构建FinTradeBench采用校准-缩放范式,基准策划有三个主要部分及多个子部分。
范围与数据源
覆盖2015-2025年纳斯达克100指数公司,聚合监管文件(提取公司基本面指标)和每日交易数据(计算交易信号),信号按代码和财季对齐。信号选择遵循可解释性、实证相关性和流动性原则,分为公司基本面(如ROA、ROE等会计指标)和交易信号(如移动平均线、动量等价格时间序列指标)。
问题分类
将问题分为基本面聚焦(F 型)、交易聚焦(T 型)和混合(FT 型)三类,用于分析模型整合异质金融信号的能力。
校准-缩放框架
分三步,先专家引导构建种子,再评估校准,最后用校准的大语言模型裁判自动缩放。
阶段一:多模型候选生成与自选择
多模型、多提示采样:为每个问题用 TELeR 分类法的不同提示模板生成 6 个候选回复,促进模型内回复多样性和跨模型可比性。
模型内自过滤:各模型独立选最佳回复,避免跨模型偏好泄露。
自动数值审计:用独立大语言模型审计自选择回复,计算过滤前后数值准确率、精度、召回率和 F1 值。
阶段二:评估与校准
人工评估:金融专家对各模型自过滤响应按4个标准进行双盲5分制评估,作为校准自动化评判的金标准。
LLM评判:用Claude Sonnet 4.5按人类标准评估,通过平均绝对误差(MAE)衡量人机评判一致性,通过提示工程实现人机对齐。
阶段三:扩展
生成纳斯达克100指数公司2015 - 2025数据的种子问题扩展版本,用相同流程生成和过滤响应。
用MAE < 10%的人机对齐LLM评判评估响应,将基准扩展到1400个历史金融推理问题。
实验
在零样本(无RAG)和现实RAG条件下,于FinTradeBench评估LLMs,以区分不同信息源(文本/表格SEC文件与数值时间序列市场数据)的贡献,遵循高风险RAG评估建议。
实验设置
模型评估。评估14个LLMs,按参数规模和推理能力分为大(参数⪆100B)、中、小(参数1-70B)三类,在不同信号组合下评估,以研究模型大小和架构对不同金融信号表现的影响。
基于RAG的领域感知混合检索。设计基于RAG的架构用于金融分析,整合文本、表格和数值时间序列数据,采用四部分RAG,包括双轨检索引擎、TELeR引导生成和自过滤。
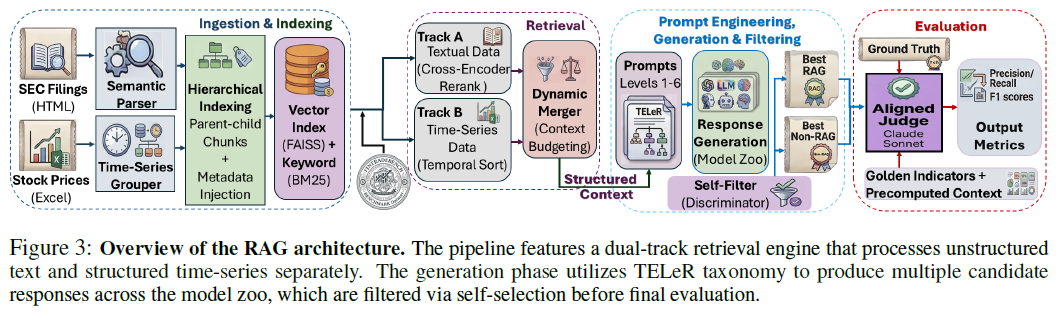
数据处理策略:1)分层索引:采用父子策略按逻辑边界分割文档,小的子块匹配触发加载完整父上下文;2)元数据注入:在每个块嵌入前添加结构化元数据以减少时间幻觉。
双轨检索引擎:采用双轨检索架构处理金融证据非对称结构。A轨用父子分块索引SEC文件,结合多种检索方法;B轨索引市场数据,通过辅助时间查询机制检索。查询时动态合并两轨输出,按规则处理后在全局令牌预算下组装最终提示。
TELeR引导的响应生成与自过滤:生成阶段用TELeR分类法为每个问题生成六个不同提示,减少推理错误。自选择模块评估候选提示,确定最佳RAG和最佳No - RAG响应。
评估指标和统计测试。LLM法官根据真实答案和关键金融指标评估最佳RAG和最佳No - RAG响应。评估指标包括绝对准确率、相对检索差异、黄金指标F1和集成得分。
实验结果
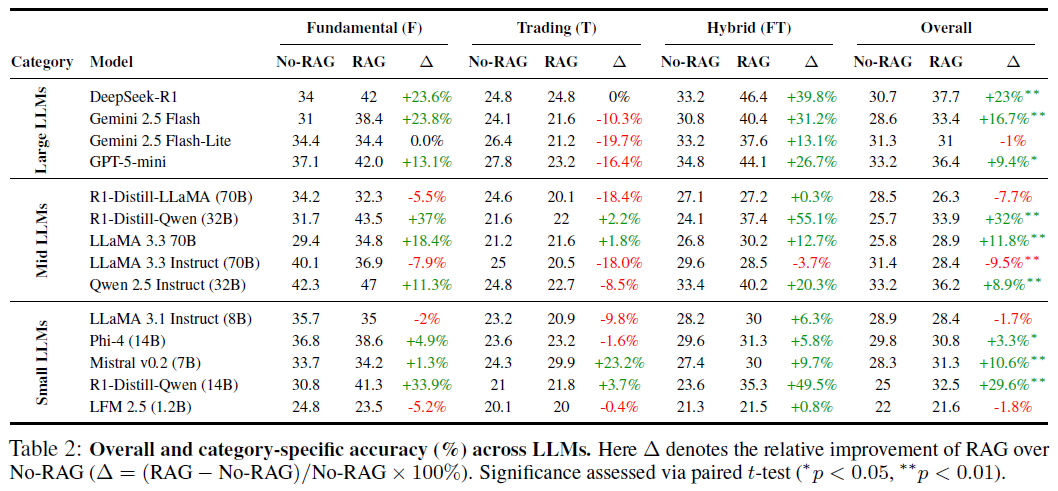
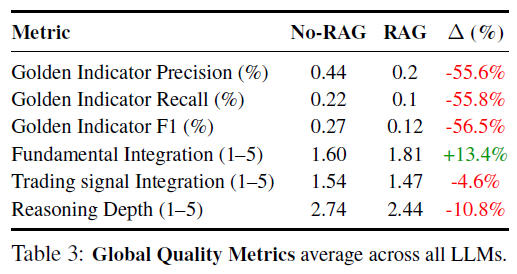
表2对比14个大语言模型基于RAG和无RAG架构在FinTradeBench上的表现,用配对t检验评估RAG带来变化的统计可靠性;Table 3和Figure 5补充全局生成质量指标,揭示RAG对模型推理行为的影响。
RAG对基本面分析(F)有利,对交易信号分析(T)不利
RAG对基础推理(F)有益,对交易信号(T)推理有负面影响。在F类问题上,推理能力强的大语言模型使用RAG后有显著提升,如R1 - Distill - Qwen(32B)提升37%,Gemini 2.5 Flash和DeepSeek - R1分别提升23.8%和23.6%,说明混合检索能有效锚定生成、减少幻觉。
交易类问题需计算技术指标,大语言模型(LLMs)使用检索增强生成(RAG)时表现变差,定量市场数据需中间计算步骤,LLMs 仅靠检索难实时计算指标,此与多步数学推理表现不佳情况相符。
预训练数据影响 LLMs 性能,因 SEC filings 在金融数据集中广泛存在,LLMs 有较强基础金融概念表征,RAG 可激活先验知识;而逐笔交易数据和专有技术交易信号因稀缺,使 LLMs 缺乏推理框架,注入上下文窗口会造成干扰而非增强。
推理LLM主导混合问题
混合(FT)问题认知负荷高,需模型检索信息并推理。具备潜在思维链推理能力的模型在该类别表现优于标准指令调优模型。DeepSeek - R1混合RAG准确率达46.4%,较无RAG基线提升39.8%。此能力转移到蒸馏开源权重模型,R1 - Distill - Qwen(32B)和(14B)在FT问题上分别提升55.1%和49.5%。无明确推理步骤的指令调优模型增益小甚至为负,因潜在推理模型能在推理时调和冲突信号,符合混合金融问题需求。
激活RAG影响某些系列模型性能
RAG对不同系列模型影响不同,Qwen及DeepSeek蒸馏模型有显著提升,LLaMA模型则出现系统性退化,如LLaMA 3.3 Instruct (70B) 整体下降9.5%,表明架构与预训练数据比模型规模更重要,LLaMA易受SEC文本和数值表干扰。
LLM被基于RAG的外部信息源分散注意力
LLMs受RAG额外信息源干扰,虽能基于基础文本作答,但推理能力下降,仅基础整合得分提升,黄金指标F1和推理深度下降,保留分析深度是金融RAG架构的核心挑战。
语境质量对推理影响的案例研究
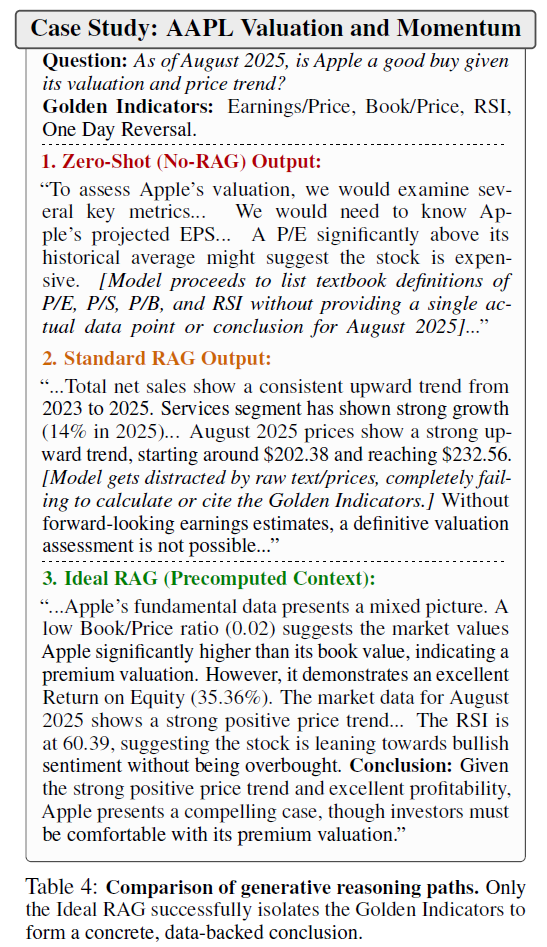
为定性说明干扰效应,对比Gemini 2.5 Flash - Lite在无RAG、有RAG和理想RAG三种检索条件下对苹果公司混合查询的输出。无RAG模型输出无实际数据的通用定义;标准RAG模型虽有真实数据但被大量信息淹没,未给出关键指标;理想RAG(提供预计算上下文)能精确推理,正确识别指标并得出投资结论,证实瓶颈在于上下文结构,预计算数值信号可让中等模型有效推理。还提供了单模态消融实验,跨市场部门和查询类型分析确认该模式具有系统性。
总结
本文介绍FinTradeBench,基于纳斯达克100指数十年数据,用校准 - 缩放框架,结合专家种子与自动评估,用于评估金融推理。对14个大语言模型在无检索增强生成(No-RAG)和检索增强生成(RAG)设置下进行基准测试:
混合推理问题上各模型性能提升显著,大、中、小模型最高分别提升39.8%、55.1%、49.5%。
RAG对基本面推理有显著改进,但会降低交易信号问题的性能,还会造成信息过载。
模型架构影响大,潜在推理模型在混合问题上表现优于指令调优模型。
不同模型家族对上下文敏感度不同,Qwen模型从RAG中受益,LLaMA模型表现下降。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
