FinToolSyn:金融工具使用对话数据与动态工具检索的正向合成框架,模型性能提升 21.06%
“FinToolSyn: A forward synthesis Framework for Financial Tool-Use Dialogue Data with Dynamic Tool Retrieval”
【 扫描文末二维码加入星球获取论文 】
摘要
金融领域大语言模型(LLMs)工具使用能力很重要,但现有数据合成方法有缺陷,如引入人工显式性、忽视动态检索。为此提出 FinToolSyn 正向合成框架,构建 43,066 个工具库,合成超 14.8 万个对话实例,融入动态检索,还建立专用基准评估工具调用能力。实验表明,基于 FinToolSyn 训练的模型提升 21.06%,为金融场景工具学习提供坚实基础。
简介
为金融领域大语言模型配备工具使用能力是关键进化,但现有“反向合成”范式存在问题,如逻辑捷径、数据“人工明确性”及忽视动态检索挑战。
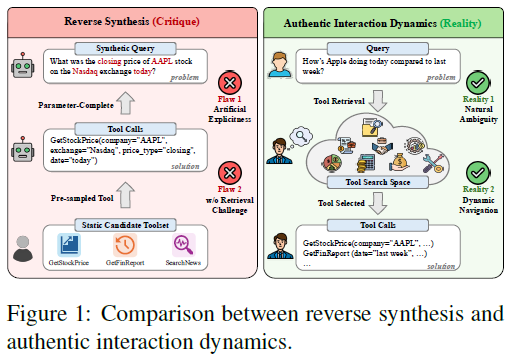
本文提出“正向合成”框架FinToolSyn,从底层重建高质量、事件驱动的金融对话,结合需求导向合成与动态候选工具检索,生成大量工具和对话实例。基于此建立FinToolBench基准评估工具调用能力,提出CB-HWS机制保障金融安全,引入KDA和ITA指标确保精度。实验表明,在FinToolSyn上微调可提升金融工具使用性能,增强复杂金融环境下的推理和决策能力。
相关工作
外部工具助大语言模型突破知识局限,有免调与调优方法,但效果依赖训练语料质量。为解决工具使用数据稀缺,现有反向合成法有偏差,本文提出正向合成框架。高效工具检索有挑战,现有方法难处理复杂指令,FinToolSyn引入动态检索。金融领域特定模型虽有进展,但工具调用数据稀缺,本文通过原子工具合成弥补。
FinToolSyn
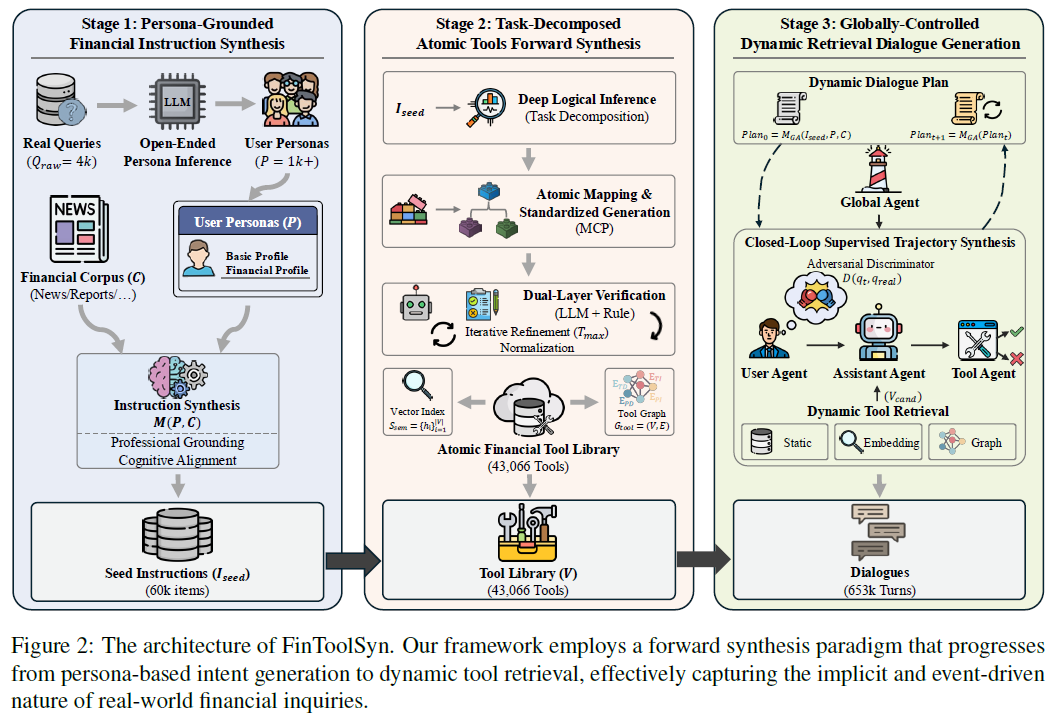
FinToolSyn含三核心组件:
1) 基于人物的金融指令合成,捕捉多样用户画像与现实场景;
2) 大规模、需求驱动的原子工具库,用于细粒度任务分解;
3) 全局控制的动态检索机制,实现现实约束下高保真对话生成。
基于人物的金融指令合成
种子指令质量是正向合成管道的基础。收集的4000条平台金融原始查询(Q raw )存在风格单一和平台特定偏差问题,为此引入基于用户角色的扩充策略,通过在合成用户角色下重新表述查询、将意图与产品特定约束分离,确保数据集涵盖广泛复杂金融目标。
开放式用户角色推断
在开放式用户角色推断方面,通过基于大语言模型对Q raw进行反向推断构建潜在用户空间,重构真实请求的潜在特征,每个角色包含基本和财务两个特征,经语义去重后整理出1000多个独特角色,这些明确特征约束生成模型,避免生成通用、教科书式查询。
基于语料库的金融指令合成
金融查询由外部信息驱动,为保证内容实质,引入金融语料(如新闻、财报)作刺激上下文 C。指令生成建模为 i new ∼ PM ( · | P, C),大语言模型 M 结合采样角色 P 与上下文 C 合成查询。该机制从 C 继承专业术语,依角色专业知识校准查询深度。不同角色查询有差异,如新手问趋势,专业人员关注利润率,由此产生具有专业差异细微特征的高保真种子集 I seed。
任务分解原子工具向前合成
工具库的覆盖范围和粒度决定下游模型性能上限,采用需求驱动原则,基于I seed挖掘复杂金融任务潜在功能需求,生成专业精细的原子工具库。
任务分解与工具合成
实施三阶段原子分解策略,先通过深度逻辑推理从I seed导出信息交互链,再经原子映射解耦为独立子任务,最后按模型上下文协议生成可直接执行的工具文档。
双层验证与进化
采用LLM判断和规则检查结合的双层验证管道,评估候选工具的结构完整性和逻辑正确性,对失败工具迭代改进,最后归一化生成43,066个高质量金融工具库。
矢量索引和工具图构建
为全面模拟现实检索机制,开发两种互补的工具选择架构:
语义向量索引:用预训练编码器将工具的名称和描述拼接文本投影为向量,形成向量空间,支持基于全局相似度的搜索,捕捉查询意图和语义相关性。
工具依赖图:构建有向图,边集分为四个不相交子集,分别为直接工具依赖、间接工具依赖、直接参数依赖和间接参数依赖,以捕捉潜在逻辑关联。
全局控制的动态检索对话生成
现有合成范式多为静态开环生成,缺乏在线监督。本文受控制理论启发,提出全局控制框架,让全局智能体成为动态规划和审核者,通过闭环监督实现反馈驱动的重新合成,防止金融环境中错误积累。
多智能体仿真框架
采用多智能体仿真框架,包含用户、助手、工具和全局四个智能体,构建高保真交互生态。
对话计划生成和适应性更新
对话计划生成与自适应更新:全局智能体根据合成指令、用户角色和实时金融上下文生成初始对话计划,该计划为可变状态变量。全局智能体持续验证中间查询和助手行动,出现冲突时触发自适应重新规划,更新对话计划,避免错误积累,支持非线性交互。
闭环监督轨迹生成
FinToolSyn的对话合成采用闭环、监督式流程,各智能体输出经针对性验证:
用户智能体:候选查询 q_t 经鉴别器 D 与真实样本 q_real 对抗判别,过滤人工显式内容,再经全局智能体质量检查与反馈。
助手智能体:全局智能体验证动作决策与质量,违规则反馈。
工具智能体:随机生成输出,不监督以保留API不稳定性。 反馈驱动的监督可自适应修正轨迹,避免误差积累,区别于静态合成范式。
多样化和噪声检索环境
为反映实际部署情况、评估模型鲁棒性,对 V cand 实施三种检索配置:1)静态检索用全局代理按 Plan 0 预设固定候选集,模拟稳定闭域场景;
2)向量检索通过查询重写进行轮次级语义搜索,解决多轮语境中的共指问题;
3)图增强检索结合向量搜索与工具依赖图 G tool 的 K 跳邻居,引入硬负样本。
候选集动态变化,结合闭环监督促使模型产生近似现实金融决策的行为。合成流程执行严格质量控制,整体丢弃率低于 10%,抽样数据获金融专业注释者 94.2%的接受率。
实验设置
数据组成
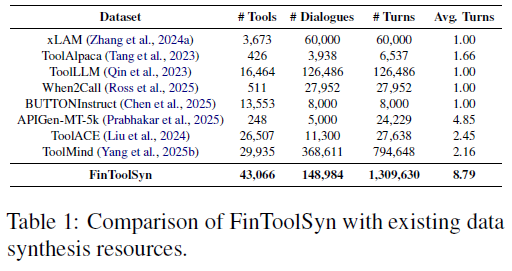
FinToolSyn生成148,984个对话,超130万轮次,涉及43,066种工具。合成以1000 +用户配置文件和60,000条指令为基础,多智能体模拟实现逼真多轮金融交互。
金融工具使用基准(FinToolBench)
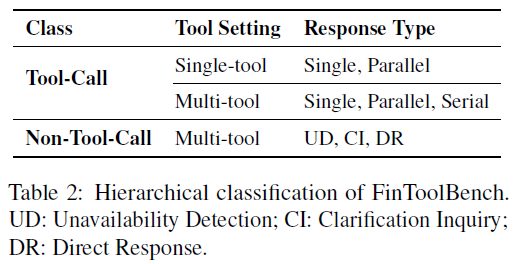
FinToolBench含843个经金融专业注释者验证的实例,从上下文深度(单轮ST、多轮MT)和候选工具密度(单候选SC、多候选MC)两维度评估,有ST - SC、ST - MC、MT - SC、MT - MC四种配置。非工具调用实例从不可用检测、澄清询问、直接响应三类评估。在提示模式和函数调用模式下评估。
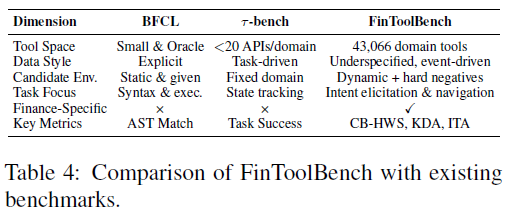
与现有基准对比:现有基准如BFCL用预言工具集评估,τ-bench限制每领域API数量,FinToolBench结合大规模动态检索环境与特定领域评估协议。
评分机制:
CB-HWS:量化高风险金融场景下模型可靠性,遵循“快速失败”原则。
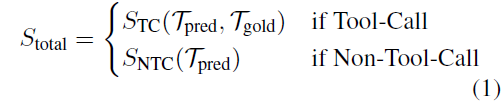
工具调用评分(STC):分两阶段,先规则检查(格式合规、工具幻觉检查、参数模式合规),通过后LLM软评估(工具选择得分、参数名称得分、参数值得分)。
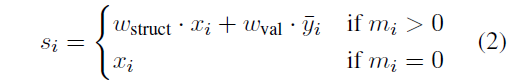
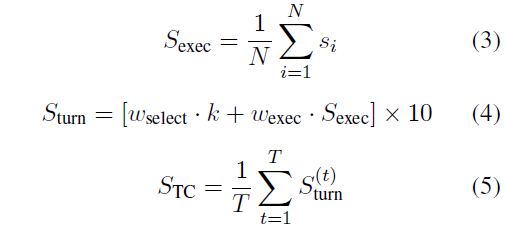
非工具调用评分(SNTC):禁止工具调用的实例,强制严格拒绝和意图识别,有幻觉工具调用则得0分。
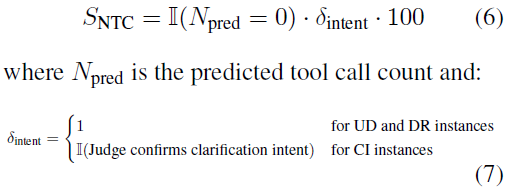
评估指标
FinToolBench报告综合CB-HWS分数及两个特定领域指标:关键数字准确性(KDA)测关键值精确匹配,调用时间准确性(ITA)评估业务流程遵循情况。评估更广泛能力从两方面进行:
一是通过BFCL-v4套件和τ-bench(Pass@1)测通用工具使用迁移能力;
二是用GSM8K、MMLU和HumanEval监测通用推理能力保存情况,确保领域适配不损害内在能力。
实现细节
数据合成:用DeepSeekV3.1 - Terminus作全局代理,Qwen3 - 235B - A22BInstruct - 2507实例化用户、助手和工具代理(温度0.6),检索召回top - 10候选,T max = 3次重试自纠错。
模型训练:对4个<14B参数的大语言模型基于LoRA进行SFT,用100k采样实例,8个H20 GPU训练1个epoch,最大序列长度32k,批大小128,学习率2e - 4,热身0.1,推理用贪心解码和官方聊天模板。
评估:推理温度0,最大9182个token保证结果确定性,DeepSeek-V3.2作Judge模型进行CBHWS评估,评估工具选择准确性、参数正确性和CI意图验证。
结果和分析
主要结果
表3展示FinToolBench表现,分Prompt和Function Calling两模式,结果显示框架有效缩小开源模型与前沿专有系统差距。
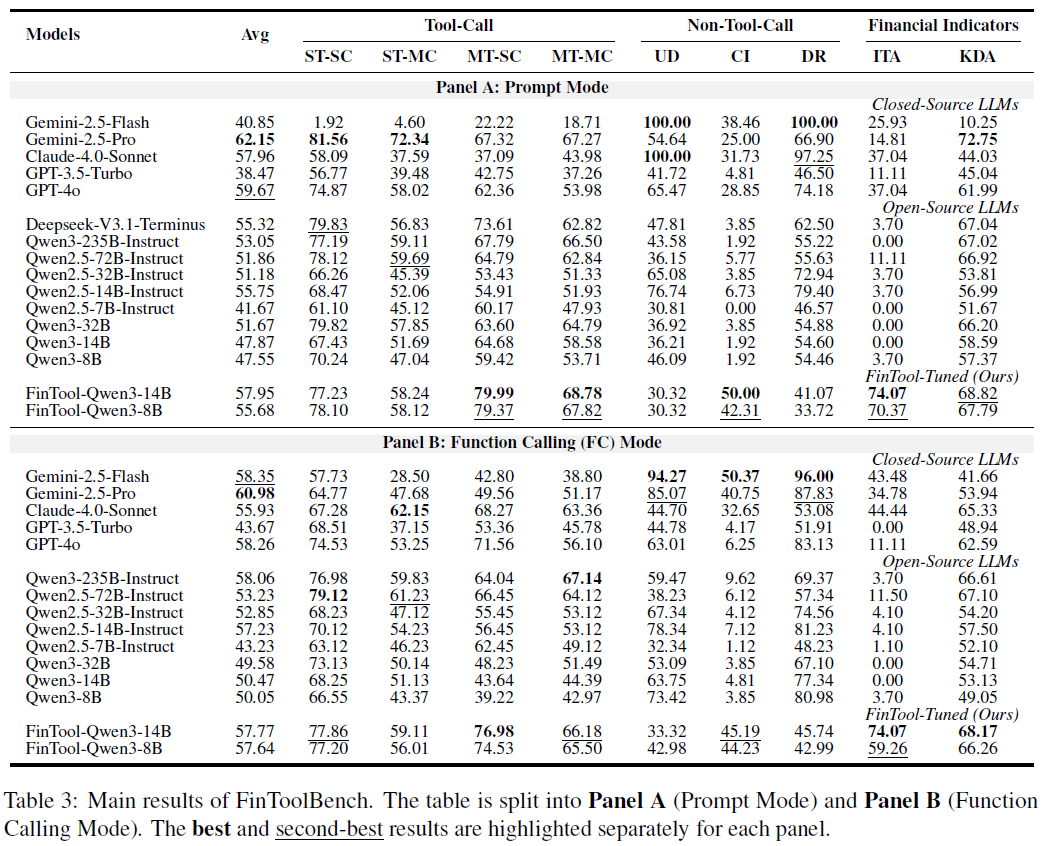
稳定性:微调模型在长时交互中稳定性佳,FinToolQwen3 - 14B及FCtuned版表现优于GPT - 4o等,FinToolSyn可缓解复杂金融场景误差积累。
业务逻辑:基础模型在金融指标的调用时机准确性常为0,而“我们的模型”最高达74.07,远超Claude - 4.0 - Sonnet,高关键数字准确性体现逻辑与数值精度。
交互范式:FinToolSyn能合成不同范式训练语料,Prompt格式数据训练模型优于基础版,FC训练模型适应严格结构约束,表现与GPT - 4o相当。
细粒度误差分析
为深入了解故障模式,表 5 从多维度分解预测误差,对比 FinTool - Qwen3 - 14B 与基线模型在 FC 和 Prompt 模式下的表现。
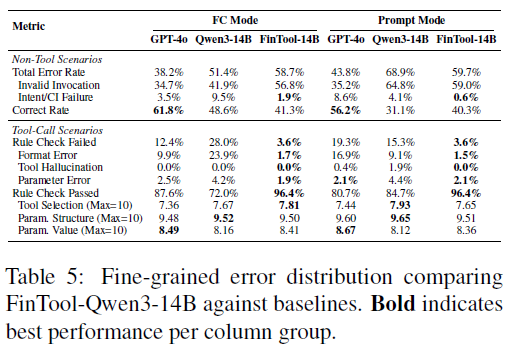
结构可靠性方面:FinTool - Qwen3 - 14B 在两种模式下规则检查失败率最低(3.6%),FC 模式下格式错误率仅 1.7%,远低于 GPT - 4o 的 9.9%,工具幻觉率为零。
意图判别权衡方面:非工具场景中,FinTool 因过度触发导致整体错误率达 58.7%(无效调用 56.8%),存在“亲工具偏差”;但意图/澄清失败率最低(FC 模式 1.9%、Prompt 模式 0.6%),能识别需更多信息,但有时会尝试推测性工具调用而非询问,未来需减轻过度触发行为。
泛化能力
为验证FinToolSyn灌输推理模式而非记忆数据集,在通用基准上评估模型,详细结果见表格。
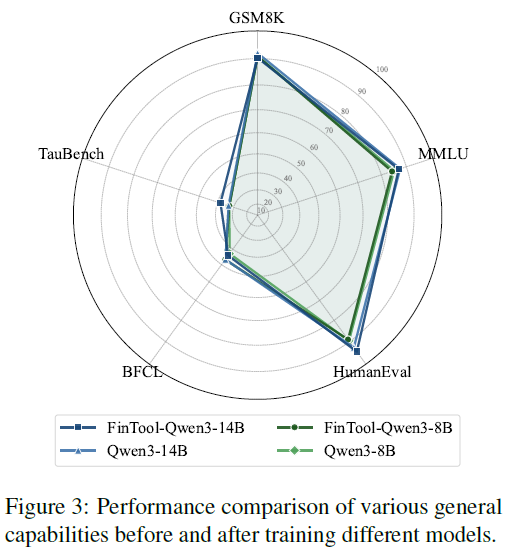
迁移性:在BFCL和τ-bench基准上,微调模型表现与基础模型相当或略优,如FinTool-Qwen3-8B提升BFCL 3.9分,FinTool-Qwen3-14B提升τ-bench 5.0分,表明模型内化工具调用结构,可迁移技能。
通用推理保留:在GSM8K、HumanEval和MMLU上,模型性能波动小(±2分),FinTool-Qwen3-14B提升HumanEval 1.83分,说明高质量合成数据增强领域能力且保留推理能力。
消融分析
合成方向性:反向合成虽提升工具使用,但引入“人工显式”偏差,使非工具准确率降至 15.01;正向合成使需求与解决方案匹配,恢复决策逻辑(非工具准确率 44.03),提高工具调用性能(65.84),表明方法教会何时用工具。
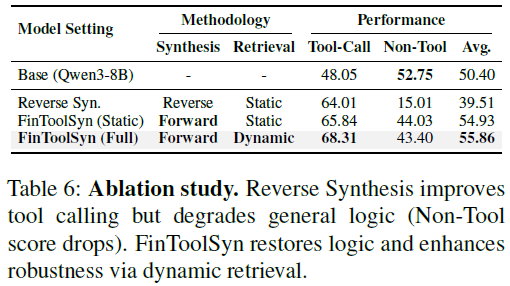
检索策略:动态检索增强抗噪鲁棒性,模型学习过滤干扰项,工具调用得分达 68.31,整体性能最佳(55.86),说明模拟检索噪声对智能体弹性至关重要。
总结
本文介绍FinToolSyn为金融智能体合成高质量数据,结合前向合成与动态检索,缓解反向方法“人工显式”偏差。实验表明,FinToolSyn优于基线,在掌握复杂工具和保留拒绝无效请求的推理逻辑间取得关键平衡,使智能体更可靠。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
