XBRLTagRec: 基于LLM的金融领域零样本重排序自动数字标签方法
“XBRLTagRec: Domain-Specific Fine-Tuning and Zero-Shot Re-Ranking with LLMs for Extreme Financial Numeral Labeling”
上市公司需按GAAP等框架披露标准化财务信息,XBRL用于结构化报告,但准确分配概念标签是挑战。现有方法在实际应用中难以区分语义相似标签、依赖静态标签编码、缺乏有效语义排序机制。
本文提出 XBRLTagRec 框架用于自动金融数字标签,匹配财务文本数字与 XBRL 标签。结果显示,XBRLTagRec在Hits@1、M-P、M-R和M-F1等指标上表现最佳,各指标分别提升2.64%、4.47%、4.42%和4.34%。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
上市公司需按SEC和GAAP规定披露财务信息,XBRL虽实现标准化和机器可读报告,但准确选标签难,现有微调方法区分相似标签能力有限。本文提出端到端框架XBRLTagRec用于自动财务数字标签,用微调的FLAN-T5-Large模型生成语义标签文档,通过语义相似度检索候选标签,用ChatGPT-3.5零样本重排选最优标签。FNXL数据集实验显示,XBRLTagRec优于FLAN-FinXC框架,Hits@1和Macro指标提升2.64%-4.47%,在大规模和语义复杂标签匹配场景有效。
简介
上市公司需按GAAP等框架披露标准化财务信息,XBRL用于结构化报告,但准确分配概念标签是挑战,目前标签选择多为手动,自动化匹配因分类法规模大、语义重叠等问题困难重重。此前自动化财务数字标签研究有多种方法,但都有局限,准确区分和排序极相似的XBRL数字标签仍是难题。
现有方法在实际应用中有三大挑战:难以区分语义相似标签、依赖静态标签编码、缺乏有效语义排序机制。FLANFinXC是金融数字标签的先进基线,但Top-1匹配可能遗漏正确标签,而ChatGPT凭借金融知识和学习能力,能迭代区分相似标签,实现更准确预测。
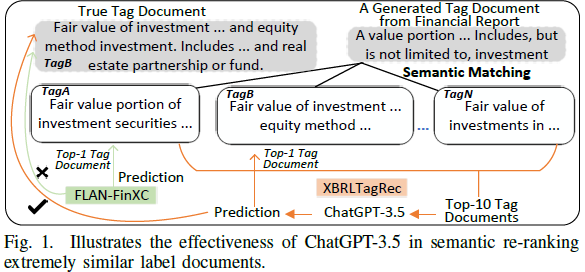
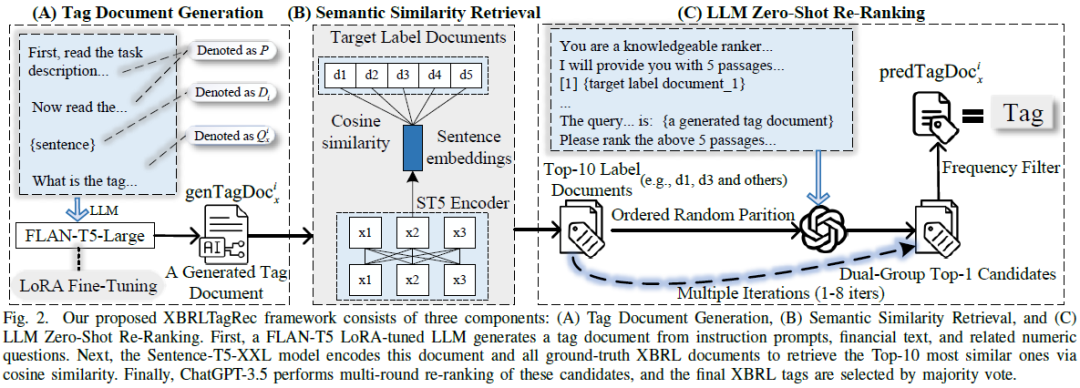
本文提出 XBRLTagRec 框架用于自动财务数字标签,匹配财务文本数字与 XBRL 标签。该框架含三模块:Tag Document Generation 用 LoRA 微调 FLAN-T5-Large 生成语义标签文档;Semantic Similarity Retrieval 用 Sentence-T5-XXL 检索相关 XBRL 标签文档;LLM Zero-Shot ReRanking 用 ChatGPT 多轮语义重排确定最终标签。在 FNXL 数据集子集实验,XBRLTagRec 超基线 FLAN-FinXC,Hits@1 和 Macro 指标提升 2.64%–4.47%,预测准确且多标签平衡。
本文提出结合 LLM 生成、语义检索和重排机制的 XBRL 标签预测框架;引入过滤和频率投票的迭代重排法,提升预测标签稳定性和语义对齐;开发模块化、可插拔框架架构,支持不同 LLM 和推理策略,增强系统泛化和工程适应性。
相关工作
XBRL 标签方法
早期用结构化知识和特定领域建模技术提升金融文本数值数据 XBRL 标签注释准确性,如 GalaXC 构建图神经网络、[5]发布 FNXL 数据集、[11]整合语义相似度指标;随着大语言模型(LLMs)发展,研究探索其在金融标签任务中的潜力,如 FLANFinXC 框架、XBRL - Agent 系统。
基于LLM的重排序
基于大语言模型的重排序方法在跨语言检索、多段落排序和上下文建模中成果显著,如 LRL 无监督列表法、[14]用微调大语言模型按相关性重排段落文本、RankVicuna 零样本列表文档重排、PRP 方法、ICR 方法。
XBRLTagRec
标签文档生成
采用指令调优的FLAN-T5-Large模型为核心文本生成器,用参数高效的LoRA微调,降低训练成本并增强对金融任务的适应性。训练样本由指令提示P、财务报表文本 D_i、针对报表特定数字的问题 Q_ix 组成,三者按换行连接成最终输入 D′_x。
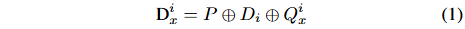
目标是训练模型生成目标数字对应的XBRL标签文档 genTagDoc_ix,训练采用自回归方法,以交叉熵损失为优化目标。测试时输入格式同训练,输出为生成的标签文档。生成标签文档而非单个标签,可提供更丰富语义结构,LoRA机制避免全参数更新,减少训练资源消耗。
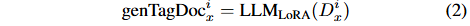
语义相似检索
采用预训练模型Sentence-T5-XXL对LoRA调优的FLAN-T5-Large生成的标签文档编码,同时对所有真实XBRL标签文档编码,计算生成文档与真实文档嵌入向量的余弦相似度,返回相似度最高的前10个XBRL标签文档集。
LLM Zero-shot 重排序
为提高标签预测准确性,引入 LLM 零样本重排序机制:
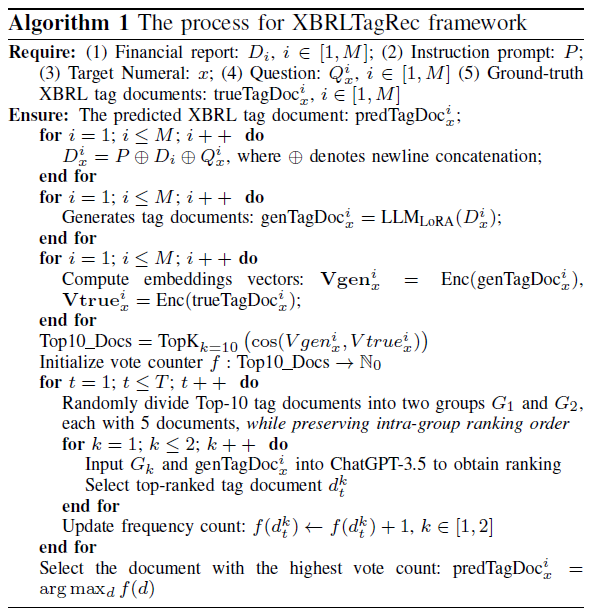
用 ChatGPT-3.5 对 Sentence-T5-XXL 得到的前 10 个候选 XBRL 标签文档重排序,选语义最接近 genTagDoc ix 的作为最终预测文档。
设计多轮迭代重排序策略:
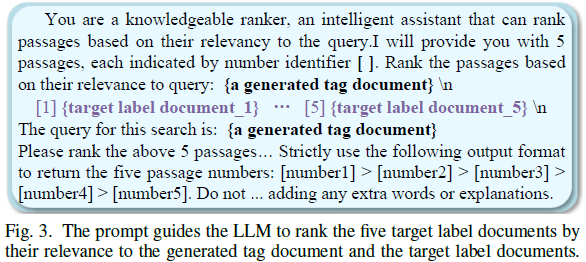
过滤策略:随机打乱前 10 个候选文档,均分为两组,每组 5 个,将每组目标 XBRL 标签文档与 genTagDoc ix 输入 ChatGPT-3.5 重排序,选相关性最高的。
多轮迭代:重复过滤过程,每轮从两组各选一个最优文档加入候选池。
最频繁选择:统计各文档在所有迭代中成为排名第一候选的累积频率 f(d),选 f(d) 最高的作为最终预测文档。
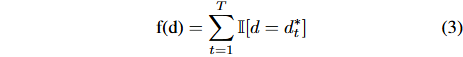
为 ChatGPT - 3.5 设计固定输入格式和高质量重排序提示。
实验
数据集
FNXL数据集由 [5] 基于SEC年度10 - K公开文件构建,涵盖2339家上市公司,有79088个句子、142922个手动标注财务数字实例,对应2794个不同XBRL标签,标签分布呈长尾特征。因完整数据集未公开,实验采用Khatuya等 [8] 发布的部分数据集,该子集源于同一原始数据集。
评估指标
采用四个评估指标进行 XBRL 标签预测,包括计算各类别精度均值的 Macro-Precision(M-P)、各类别召回率均值的 Macro-Recall(M-R)、适用于类别不平衡场景的平衡精度与召回率的 Macro-F1(M-F1),还引入反映实际效用、支持专家标签推荐的 Hits@1。
基线
为确认框架有效性,将其与以下基线方法对比:
1)FLANFinXC:基于生成模型,经指令调优,在极端金融数字标注任务表现佳;
2)AttentionXML Pipeline:构建基于BERT的序列到序列标签器,将标注任务建模为极端多标签分类问题;
3)FiNER:将标注任务表述为NER问题,仅涵盖139个最常见XBRL标签;
4)Label Semantics:结合标签语义描述,将标注任务重新表述为以实体描述为输入的标准NER任务;
5)GalaXC:在构建的文档 - 标签图上进行联合学习,有效整合标签元信息到模型表示中。
实现细节
在32GB Tesla V100 GPU上实现,采用Hugging Face的FLAN-T5-Large和Sentence-T5-XXL预训练检查点。LoRA微调FLAN-T5-Large时,设rank为2、lora alpha为32、dropout率0.05、学习率5e-4、训练轮数5、输入序列最大长度128、批量大小8。使用ChatGPT-Turbo1106的重排序模块,将Top - 10候选XBRL标签文档分两组(每组5个),每轮从每组选排名最高的加入候选池,重复13轮。
实验结果
RQ1:XBRLTagRec框架是否优于基线方法?
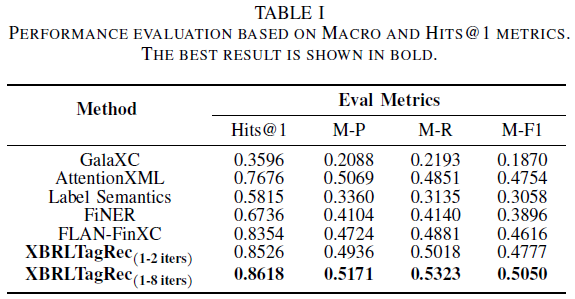
在FNXL数据集上对现有方法和框架XBRLTagRec进行对比评估。结果显示,XBRLTagRec在Hits@1、M-P、M-R和M-F1等指标上表现最佳。迭代1-2轮时就超越所有基线方法,1-8轮时性能进一步提升,Hits@1达0.8618。与最强基线FLAN-FinXC相比,各指标分别提升2.64%、4.47%、4.42%和4.34%;与FiNER相比,Hits@1提升18.82%,M - F1提升11.54%。该框架在FNXL数据集上优于所有基线,有很强实用价值和应用潜力。
RQ2:框架的关键参数设计对整体性能影响程度如何?
开展三项实证研究,聚焦迭代范围、组大小、组排序策略三个核心参数:
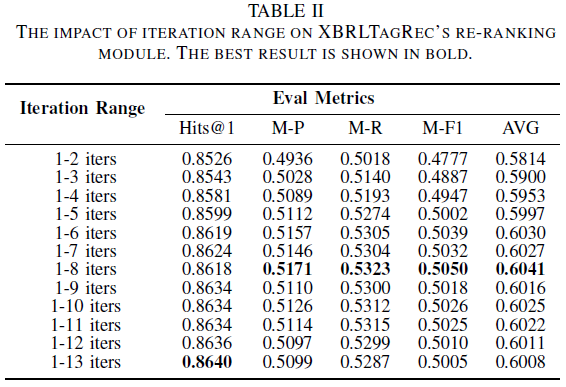
迭代范围:迭代增加时性能呈“先升后稳”,1 - 8 次迭代整体性能最优,过多迭代会引入冗余信息,合适迭代次数可提升性能、防过拟合、避不必要计算。
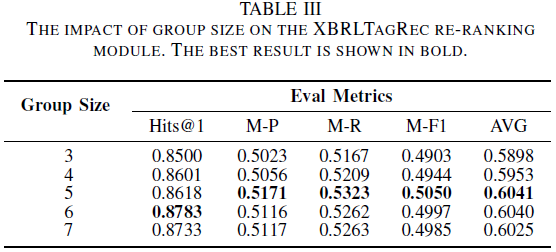
组大小:从 3 增至 5 时评估指标提升,再扩大到 6 或 7 时部分指标退化,组大小设为 5 可平衡性能与计算成本。
组排序策略:保序策略(Order - Preserving)显著优于随机排序(OrderShuffled),保留初始语义排序有助于提高排名准确性和鲁棒性。
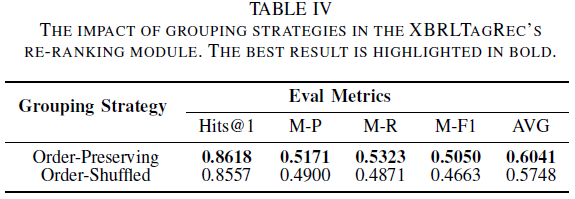
综上,XBRLTagRec 重排序模块配置:1-8 次迭代、组大小为 5、采用保序策略,此设置性能稳定,可为后续任务提供指导。三个参数对性能提升至关重要。
RQ3:框架在不同大语言模型中是否有泛化和鲁棒性能?
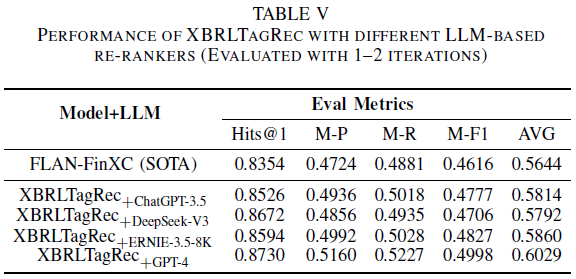
在统一生成与检索管道的重排序模块中替换大语言模型(LLM),选用ChatGPT-3.5-Turbo1106、GPT-4o、DeepSeek-V3和ERNIE-3.58K在FNXL数据集上评估。结果显示,XBRLTagRec框架在四个模型中表现稳定,有良好的模型独立性、跨模型适应性和强鲁棒性。各模型表现有差异:GPT - 4综合最佳;ERNIE-3.5-8K的M-F1排第二;DeepSeek-V3 Hits@1高但M-F1低;ChatGPT-3.5 Hits@1最低但M-F1超DeepSeek-V3。综合性能与计算成本,选ChatGPT-3.5为主要实验模型。该实验仅换重排序模块的LLM,结果体现框架模块化、可插拔及良好扩展性。
总结
本文提出端到端框架 XBRLTagRec 用于金融文本 XBRL 标签自动匹配,集成指令调优大语言模型、语义检索和迭代重排序,解决大规模标签系统语义模糊和上下文复杂问题,实验显示优于现有方法,模块化设计确保灵活可扩展,是实用且强大的金融数据标注方案。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
