中山大学提出MagicSeg|全面破解开放世界分割标注难题
还在为开放世界分割任务中天价的像素级标注成本发愁吗?还在苦恼模型无法识别训练集外的“稀有物种”吗?今天,一个名为MagicSeg的全新框架,只需一个类别名称,就能全自动生成海量、多样、带精准掩码标注的训练数据,甚至还能生成“反事实”图像辅助训练,在多个权威数据集上性能反超一众SOTA方法。这不仅是数据生成技术的突破,更是开放世界分割预训练范式的一次革新。读完本文,你将彻底掌握这套“数据炼金术”的核心原理与实现细节。
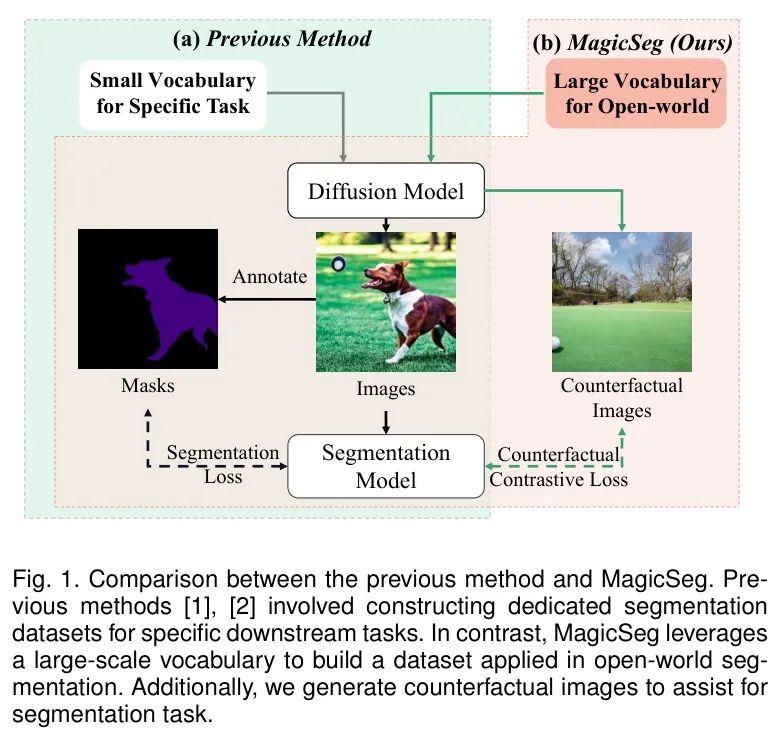
图:MagicSeg(右)与传统方法(左)对比,利用大词汇量和反事实图像生成,革新了开放世界分割的数据构建与训练范式
❓ 核心痛点:开放世界分割的“数据饥荒”
当前,基于视觉-语言模型(如CLIP)的开放世界分割取得了长足进步,但其性能天花板深受制于一个根本矛盾:模型需要海量、多类别、像素级标注的数据来学习细粒度分割能力,而现实世界中这样的数据获取成本极其高昂,近乎不可能。
传统监督分割(图1左)往往局限于PASCAL VOC等小词汇量、特定任务的数据集。而开放世界模型依赖的图像-文本对(如LAION)虽然规模庞大,却缺乏像素级标注。这就导致了一个尴尬的局面:模型“认识”很多物体(通过文本),却无法精确地“勾勒”出它们的轮廓。
更严峻的挑战在于“长尾分布”。现实世界有成千上万的物体类别,但标注数据往往集中于常见类别。当模型遇到“水母”、“小熊猫”甚至“钢铁侠”这类稀有或新兴类别时,其分割能力会急剧下降。为每个新类别收集并标注数据?这在经济和时间上都是不可承受之重。
那么,能否让AI自己创造训练数据呢? 早期的尝试如GAN或基于扩散模型注意力机制生成掩码的方法,要么仍需少量真实标注,要么生成的掩码噪声太大。直到MagicSeg出现,它提出了一套堪称优雅的自动化解决方案,直击上述所有痛点。
🎨 漫画解读:1分钟get论文精髓
在深入技术迷宫之前,我们先通过一张趣味漫画,快速把握MagicSeg如何像魔法一样“变”出高质量的训练数据!
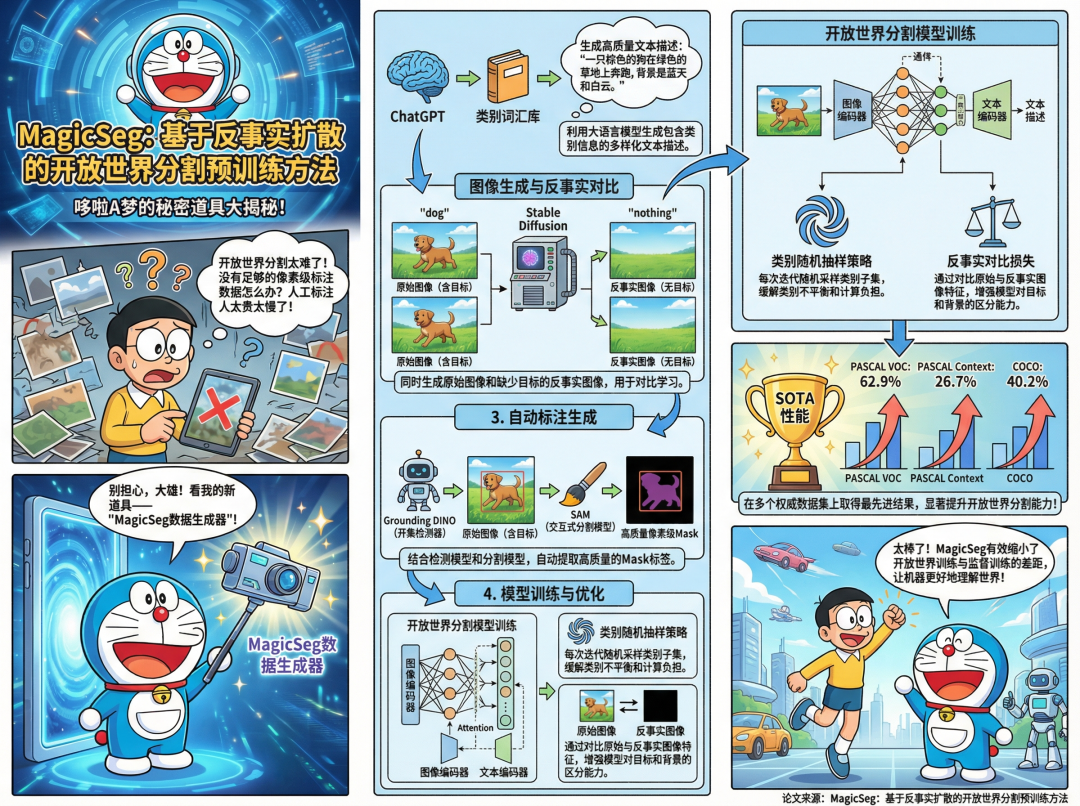
图:论文核心内容漫画解读
一张漫画胜千言——MagicSeg的核心就是“输入类别,吐出带标注的数据对”。接下来,我们拆解这背后的三大核心技术。
🚀 原理拆解:三大核心技术揭秘
MagicSeg的完整流程分为两阶段:1. 基于反事实扩散的数据生成;2. 融入创新训练策略的模型学习。其精妙之处,就藏在以下几个核心设计中。
💡 核心一:反事实扩散生成框架
这是MagicSeg的“数据工厂”,其完整流水线如图3所示。整个过程从用户提供一个简单的类别名(如“狗”)开始,却产出了四元组结构化数据 {文本, 图像, 反事实图像, 像素掩码}。
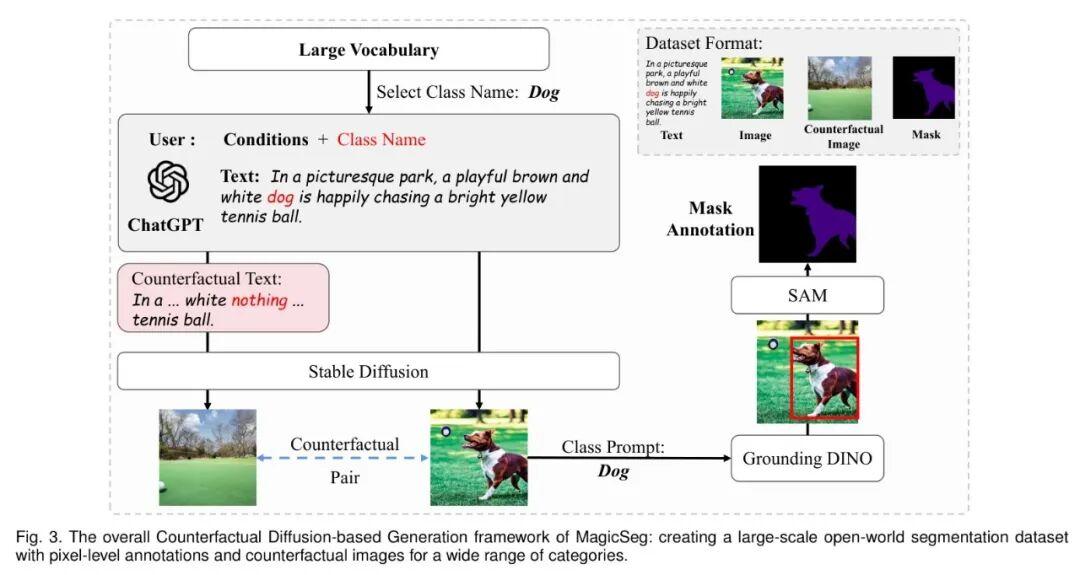
图:MagicSeg数据生成完整Pipeline,集成ChatGPT、Stable Diffusion、Grounding DINO和SAM,实现从类别名到带标注反事实图像对的自动生成
第一步:高质量文本Prompt生成。 直接使用“一张狗的照片”这样的简单提示,生成的图像多样性有限。MagicSeg请出“外脑”ChatGPT,给定诸如“场景细节尽可能多样化”等条件,让它为“狗”这个类别生成丰富、充满细节的场景描述,例如“一只金毛犬在秋天的公园长椅旁嬉戏,远处有泛黄的银杏叶”。
第二步:反事实图像对生成。 这是第一个关键创新点。除了用上述描述生成原始图像 , MagicSeg还会将描述中的目标类别词替换为“nothing”,生成反事实文本,进而用同一个Stable Diffusion模型生成反事实图像 。如图6所示,反事实图像与原始图像背景、布局几乎一致,唯独“移除”了目标物体(如鸟屋、雪人)。
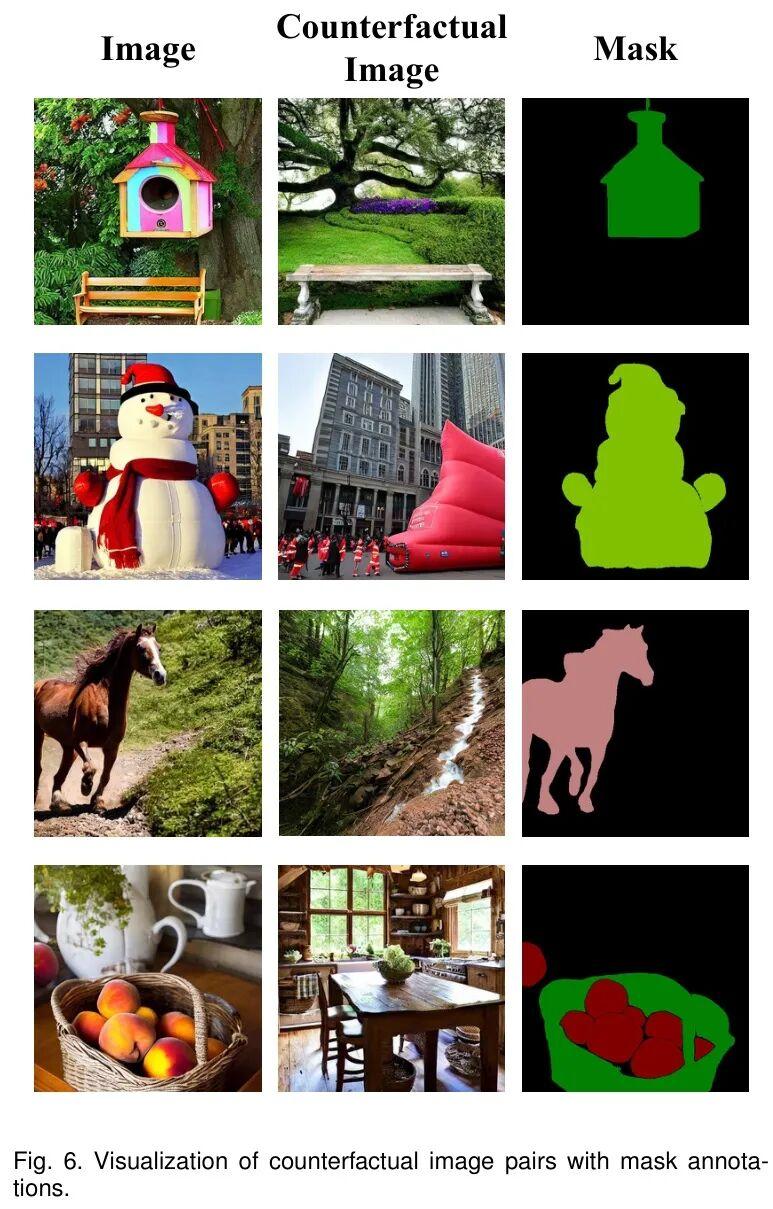
图:反事实图像对示例,通过移除特定对象生成,用于后续的对比训练
第三步:高精度像素掩码标注。 如何为生成图像自动打上精准的像素级标签?MagicSeg巧妙地组合了现有SOTA工具:先用开集检测器Grounding DINO,根据类别名在图像中定位目标边界框;再将此框输入到分割一切模型SAM中,得到高质量的像素级掩码 。这套组合拳利用了这些模型强大的零样本能力,避免了在生成模型内部挖掘噪声注意力图的困境。
最终,我们获得了一批如图2所示的高质量、多样化合成数据,涵盖了复杂场景下的多个物体。
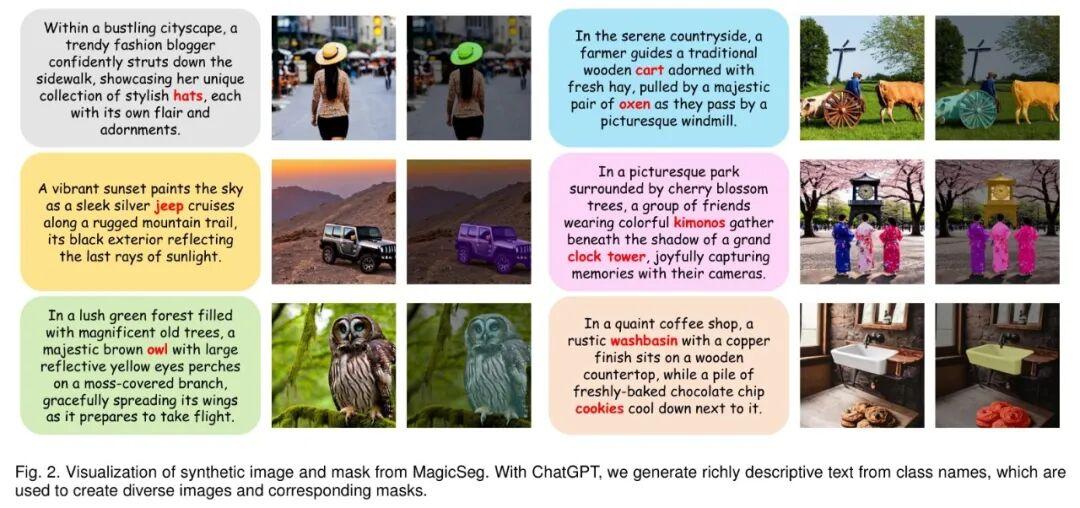
图:MagicSeg生成的多样化合成图像及其对应的语义掩码,展示了其多场景、多物体的生成与标注能力
💡 核心二:类别随机采样策略
有了包含1205个类别的大词汇表 ,如何高效训练?传统方法若对每张图像都用全部 (如1205) 个类别进行预测,计算量巨大,且由于每张图实际只包含少数几个类别,会导致梯度被大量“背景”类别淹没。
MagicSeg提出了巧妙的类别随机采样策略。在训练时,对于每张图像,除了其真实存在的类别 ,模型会从大词汇表 中随机采样一个包含 个类别的子集 来进行掩码预测。
这里 是基于CLIP的分割模型(如ZegCLIP)。这个策略有三大好处:1) 极大降低了计算复杂度;2) 让模型在每次迭代中学习与不同随机类别组合的关联,防止对固定词汇的过拟合;3) 通过控制 的大小,平衡了正负样本的学习效率。
💡 核心三:反事实对比损失
自动生成的掩码难免有噪声(如漏标、错标)。如何让模型不那么依赖有噪声的伪标签,还能学会更通用的“物体定位”能力?MagicSeg的答案是反事实对比学习。
其训练框架如图4所示,模型会同时处理原始图像 和对应的反事实图像 ,提取它们的CLS token特征 和 。由于两者共享背景但一个有目标一个没目标,模型被鼓励拉远这两个特征的距离,从而学会关注并定位出那个“消失的对象”。
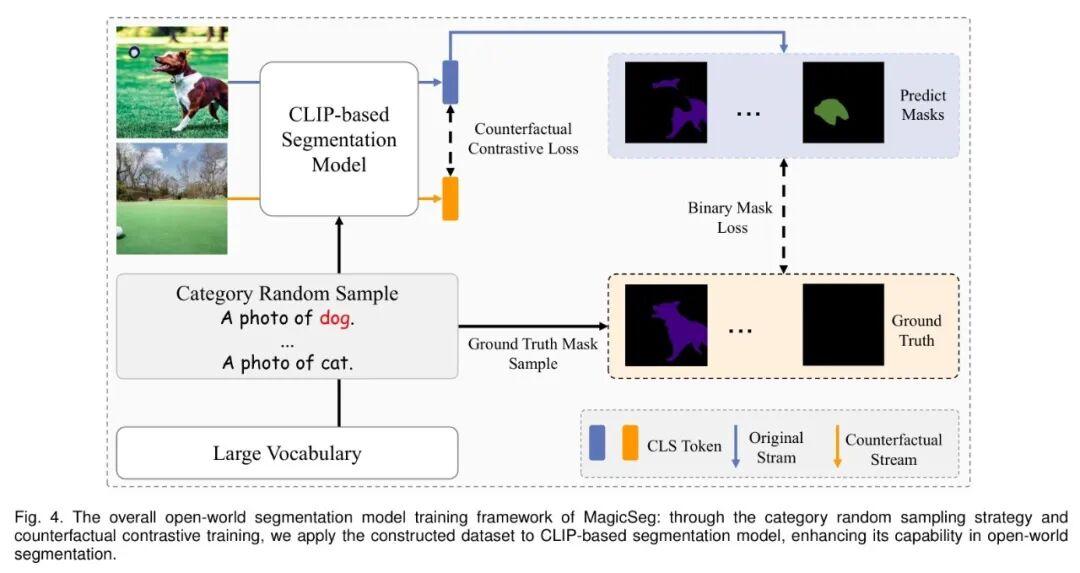
图:MagicSeg训练框架,包含类别随机采样、双流(原始/反事实)处理以及反事实对比损失
损失函数定义为余弦相似度的负值:
这提供了一个强大的自监督信号。模型无需掩码标注,仅通过对比图像对,就能隐式地学习到目标物体的位置信息,从而增强了模型的分割鲁棒性和泛化能力。
最终的训练损失是掩码损失(Focal Loss + Dice Loss)与反事实对比损失的加权和:
你正在构建一个开放世界应用,是愿意投入百万资金标注数据,还是尝试用MagicSeg这样的方法自动生成?欢迎在评论区分享你的看法!
📊 实验验证:数据与视觉的双重碾压
理论再优美,也需要实验的铁证。MagicSeg在多个标准基准测试中展现了压倒性的优势。
🏆 SOTA对比:全面领先
首先看与最强基线Grounded SAM(即其数据标注所用工具链)的对比(表1)。在PASCAL VOC上,MagicSeg以62.9% mIoU略胜一筹(61.8%)。而在类别更多、分布更复杂的长尾数据集LVIS上,Grounded SAM性能骤降至0.5%,而MagicSeg仍能保持4.9%,优势扩大了近10倍,这证明了其生成的数据能有效提升模型在复杂开放世界中的分割能力。
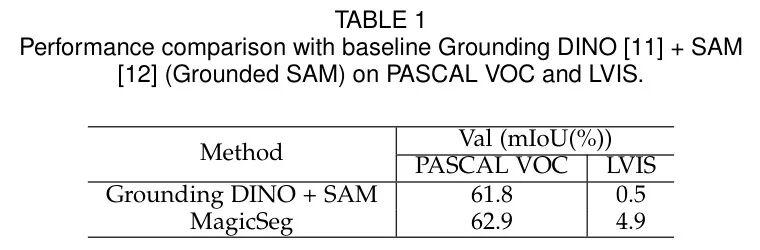
表1:在PASCAL VOC和LVIS数据集上,MagicSeg显著优于其数据标注来源的基线方法Grounded SAM
更全面的开放世界语义分割SOTA对比如表2所示。MagicSeg在PASCAL VOC上达到**64.3%的mIoU,超越了所有仅使用图像-文本对或无掩码监督的方法。即使与部分使用真实掩码数据的方法相比,差距也大大缩小。在COCO上,MagicSeg更是取得了40.2%**的优异性能。
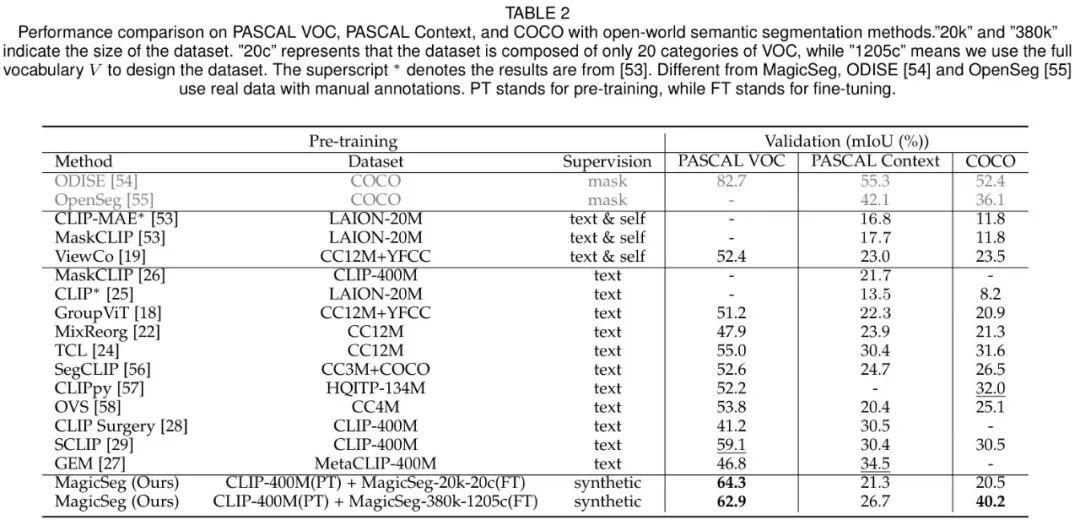
表2:在多个数据集上的开放世界语义分割性能对比,MagicSeg取得领先
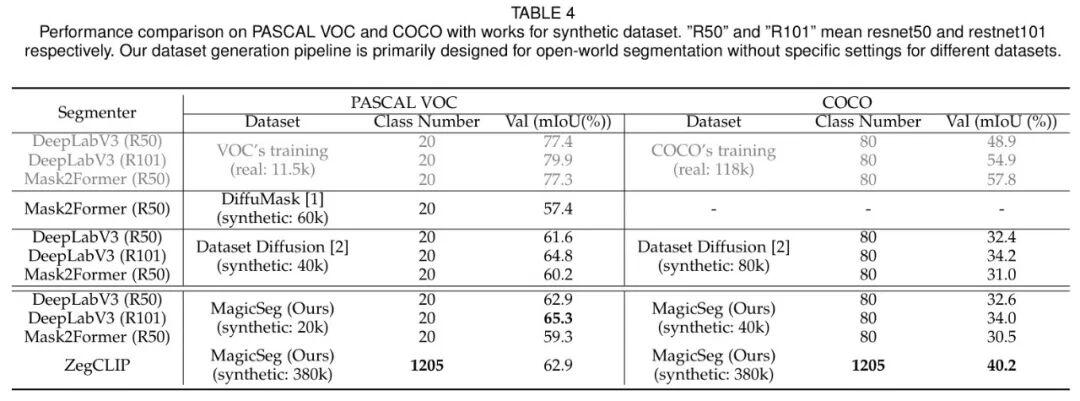
表4:与其他合成数据方法对比,MagicSeg训练出的模型在PASCAL VOC和COCO上表现最佳
特别值得注意的是表4,MagicSeg与其它专门为分割生成合成数据的方法(如DiffuMask、Dataset Diffusion)相比,在相同骨干网络下性能更优或相当。这证明了其数据生成流程的有效性,且无需为每个下游任务定制数据集。
🔬 消融实验:每个设计都关键
MagicSeg的每个组件都不是摆设。消融实验给出了量化证据。
1. 反事实提示与对比损失的作用(表5):使用MagicSeg的详细提示时,启用反事实对比训练能使mIoU从36.0%提升至37.2%。而使用简单提示时,反事实训练反而有害(28.6%→27.5%)。这是因为简单提示生成的反事实图像信息丢失严重,而详细提示的反事实图像保留了丰富背景,使对比学习有效。
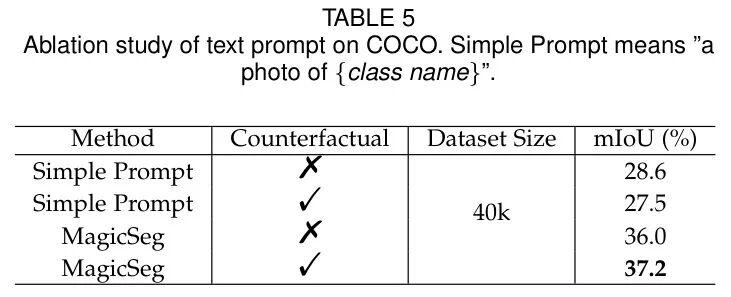
表5:反事实提示机制的有效性消融研究
2. 类别随机采样规模 与对比损失(表6):当同时启用反事实对比损失,并将随机采样类别数 设为100时,性能达到最优的40.2%。(只学当前类)或 (学全部类)都会导致性能显著下降,验证了随机采样策略设计的合理性。
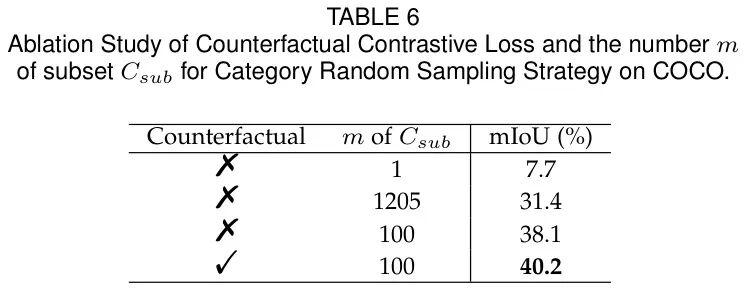
表6:反事实对比损失与类别随机采样规模m的消融实验,二者结合效果最佳
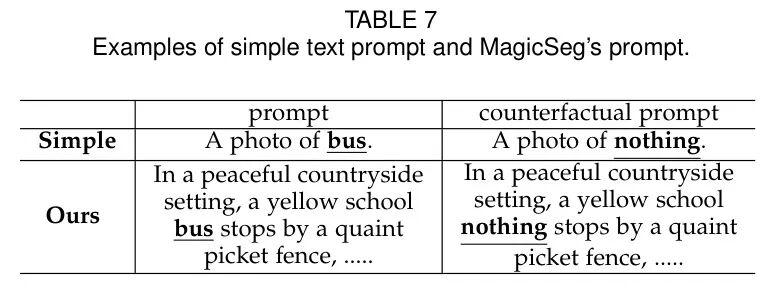
表7:简单提示与MagicSeg详细提示的示例对比,后者包含丰富场景细节
👁️ 可视化对比:眼见为实
数字之外,视觉结果更有冲击力。图8、图9展示了MagicSeg与代表性开放世界模型GroupViT在PASCAL VOC和COCO上的分割结果对比。
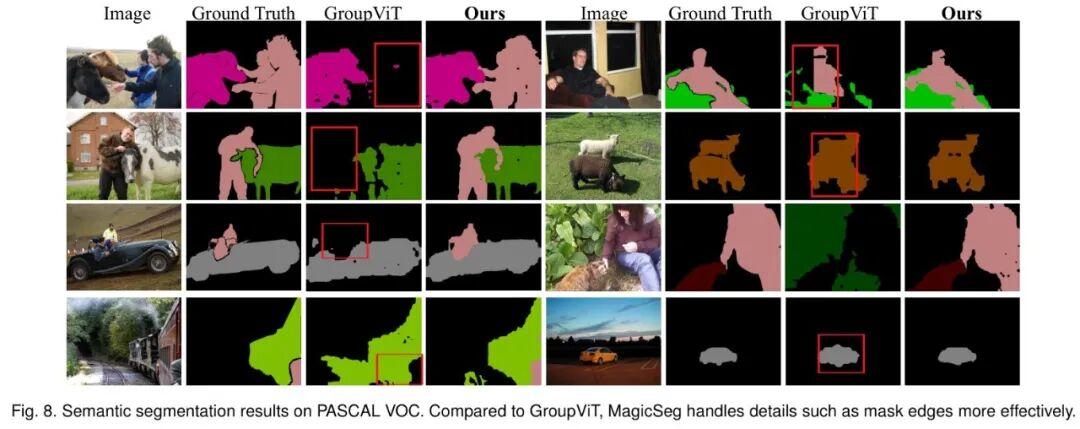
图8:在PASCAL VOC数据集上,MagicSeg(Ours)比GroupViT具有更清晰的边界和更完整的目标分割
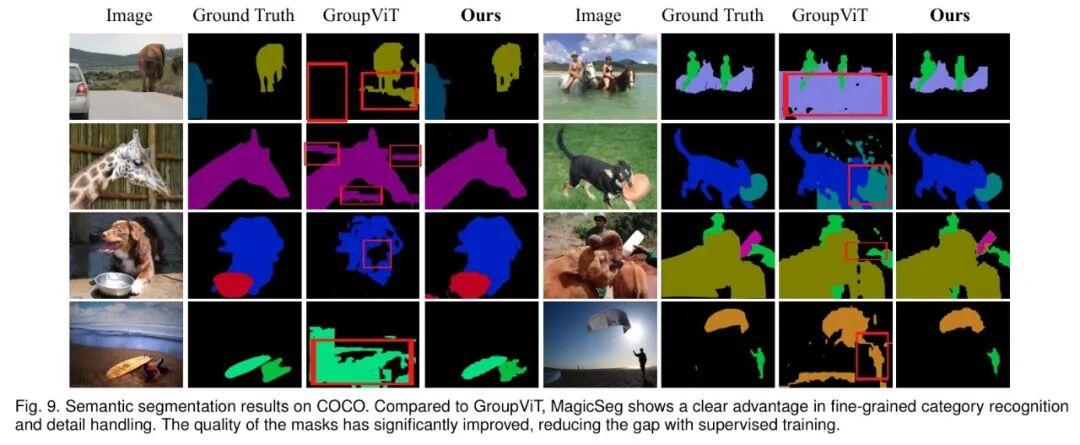
图9:在COCO数据集上,MagicSeg在细粒度识别和细节处理上显著优于GroupViT
可以明显看到,GroupViT的结果经常出现边缘模糊、小目标漏检、多个实例粘连等问题。而MagicSeg的分割结果边界清晰、实例完整,甚至接近有监督方法的视觉质量。这得益于其海量高质量合成数据与反事实对比训练带来的细粒度对齐能力。
最令人惊艳的是其开放世界泛化能力。如图10所示,对于训练集中未曾出现过的稀有类别(如宇航员、水母)甚至卡通形象(海绵宝宝),MagicSeg都能给出相当不错的分割结果。
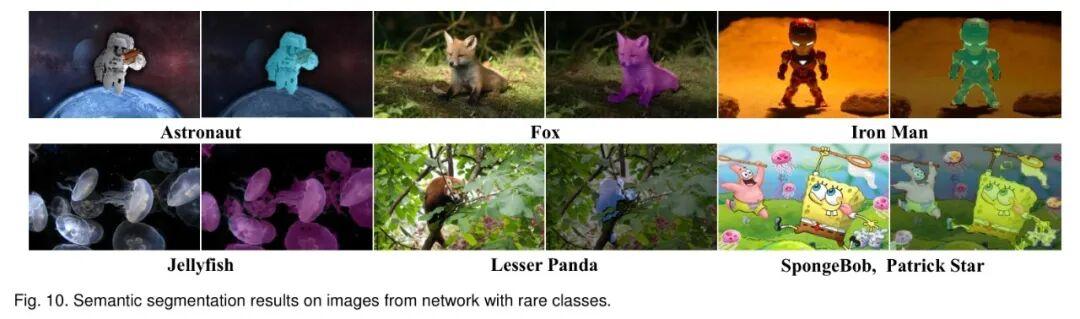
图10:MagicSeg对稀有类别、卡通图像等开放世界场景展现出了强大的零样本分割泛化能力
⚖️ 客观评价与未来展望
当然,MagicSeg并非完美。它的局限性主要在于:1) 生成质量依赖于基础文本到图像模型和自动标注模型(Grounding DINO, SAM)的性能上限;2) 当前流程主要针对前景“物体”类别生成,对背景“材质”类别的覆盖可能不足;3) 每张图像生成的类别数量有限(1-2个),与真实世界图像中多类别的密集场景存在差距。
然而,它的方向无疑是正确的。随着多模态大模型和文生图模型的持续进化,自动生成数据的“质量-多样性”天花板将被不断推高。未来,我们可以期待更智能的提示工程、融合真实与合成数据的训练策略,以及专门为分割优化的生成模型。
🌟 价值总结与行动号召
回顾全文,MagicSeg的核心价值在于它提供了一套可扩展、低成本、高性能的开放世界分割预训练解决方案:
- 1. 数据解放:用AI生成替代人工标注,彻底解决了开放世界分割的数据瓶颈。
- 2. 性能卓越:创新的反事实对比训练与随机采样策略,使模型在多个基准上达到SOTA。
- 3. 泛化强大:学到的表示具备优秀的零样本能力,可分割稀有乃至未知类别。
这项工作清晰地表明,合成数据不是次选项,在开放世界设定下,它可能是最优解。它不仅是分割领域的进展,更为所有依赖昂贵标注的视觉任务(如检测、姿态估计)提供了全新的数据引擎思路。
🤔 深度思考:你认为MagicSeg这套“自产自销”的数据生成范式,最可能率先在哪个领域引爆应用?是自动驾驶、医学影像分析,还是AR/VR内容生成?欢迎在评论区留下你的真知灼见!
💝 支持原创:如果这篇近5000字的深度解读让你有所收获,点赞 + 在看就是对原创技术分享最好的支持!也请分享给你身边正在为数据发愁的算法工程师伙伴!
🔔 关注提醒:关注我们,设为星标,第一时间获取更多颠覆性的AI技术深度解读!
#AI技术 #深度学习 #计算机视觉 #语义分割 #生成式AI #论文解读 #MagicSeg
参考
MagicSeg: Open-World Segmentation Pretraining via Counterfactual Diffusion-Based Auto-Generation