NVIDIA让AI狂肝7天自己写算子,GPU内核性能超越人类专家
AI写代码已经不新鲜了,新鲜的是,AI能连续7天不眠不休狂肝,最终写出的GPU内核比NVIDIA自家工程师手工调优的代码还要快。
过去用大语言模型做进化搜索,模型只是个候选方案生成器,被框架牵着鼻子走。
AVO把这个框架拆掉,让AI智能体自己当变异算子,自己决定查什么资料、改什么代码、什么时候测试、什么时候推翻重来。
在NVIDIA最新的Blackwell B200 GPU上,AVO用7天时间自主进化出注意力(Attention)内核,最高达到1668 TFLOPS,比NVIDIA自家的cuDNN快3.5%,比FlashAttention-4快10.5%。
更让人意外的是,把这些优化迁移到分组查询注意力(GQA)场景,额外只需要30分钟自主适配。
AI智能体开始替代人类专家了,在GPU内核优化这个门槛极高、需要深度硬件知识的领域,干出超越人类极限的活。
传统进化搜索的天花板
进化搜索是一类经典优化方法。它的基本思路是维护一个候选解种群,每轮从中挑选较好的个体,通过变异或交叉产生新解,评估后决定保留哪些,循环往复逼近最优。
传统进化搜索的变异算子是人为设计的,比如随机改变参数、交换片段等,这些启发式规则虽然有效,但在面对高度复杂的代码优化问题时,灵活性和深度都很有限。
大语言模型的出现改变了这个局面。以FunSearch和AlphaEvolve为代表的系统,用LLM替代了手工变异算子,在数学优化和算法发现领域取得了显著成果。
FunSearch在2024年登上了Nature封面,AlphaEvolve在2025年展示了解决复杂科学问题的能力。这些系统有一个共同特点:LLM被限定在一个固定的管道中,只负责生成候选方案,其他环节,包括父代采样、方案评估、种群管理,全部由外层框架控制。
论文作者把这种方式称为“把LLM关在固定管道里当候选生成器”。在数学问题中,这种方式管用,因为很多数学问题可以通过单次生成解决。在GPU内核优化这样的工程任务中,这个限制就暴露出来了。
GPU内核优化是人类工程师的看家本领。
以注意力内核为例,从FlashAttention到FlashAttention-4,每一代都凝聚了数月甚至数年的手工调优经验。
FlashAttention系列通过分块计算避免了存储完整的注意力矩阵,把瓶颈从显存带宽转移到计算吞吐量上。
到了FlashAttention-4,内核采用了warp specialization(线程束分工)设计,在线程块内部把不同线程束组分配到不同的角色:MMA线程束负责矩阵乘法,Softmax线程束计算注意力权重,Correction线程束处理在线Softmax中的累积器缩放,Load线程束负责通过张量内存加速器(TMA)搬运数据。
这些线程束组通过双Q阶段设计并行处理两个Q分片,用屏障信号协调交接。
如此精心设计的内核,要想再提升哪怕1%的性能,都需要深入理解硬件微架构,广泛尝试不同的优化策略,反复调试和profiling。
单次LLM调用生成一段代码,根本不可能完成如此深度的迭代优化。
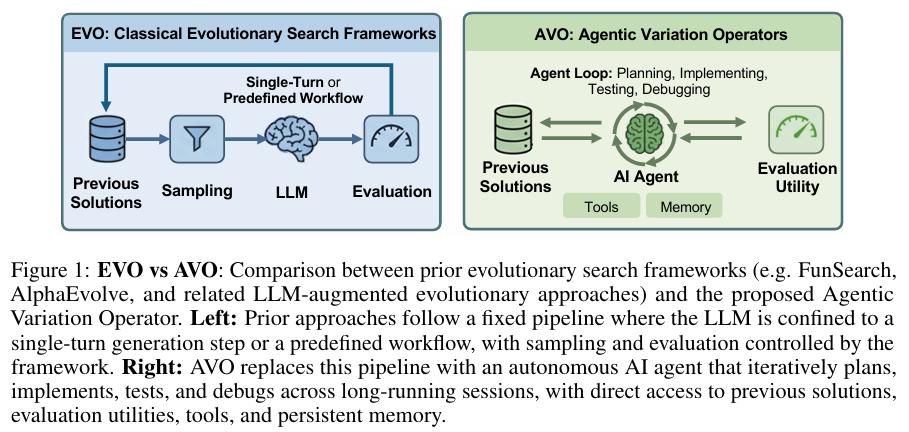
传统方法遵循固定管道,LLM被限定在单轮生成步骤中,采样和评估由框架控制。AVO用自主AI智能体替代了这个管道,智能体在长时间运行中迭代规划、实现、测试和调试,直接访问历史方案、评估工具和持久记忆。
论文作者由此提出了一个根本性的角色转变:把AI智能体从候选方案生成器提升为变异算子本身。让智能体跳出框架,自己充当框架本身。
AVO怎么干活
传统进化搜索把变异算子拆解为:采样父代,然后生成候选方案,两步分离。
AVO把这个拆解压缩为一个自主智能体调用:Agent(种群,知识库,评分函数)。智能体同时拿到所有历史方案及其评分、领域知识库和评分工具,自己决定下一步干什么。
在具体实现中,每个候选解是一个CUDA内核实现(包含内联PTX代码),评分函数从两个维度评估:数值正确性(跟参考实现对比)和目标硬件上的吞吐量(TFLOPS)。
候选方案如果数值正确性不达标,无论吞吐量多高都记为零分。知识库里装了CUDA编程指南、PTX ISA文档、Blackwell架构规格书,以及FlashAttention-4的源代码。
论文没有使用专门为内核优化定制的智能体,而是直接部署了NVIDIA内部开发的通用编程智能体。
这个智能体具备代码编辑、Shell命令执行、文件系统导航、文档检索等标准软件工程工具,通过对话历史维护持久记忆。给它装上知识库和评分函数,它就变成一个内核优化专家了。
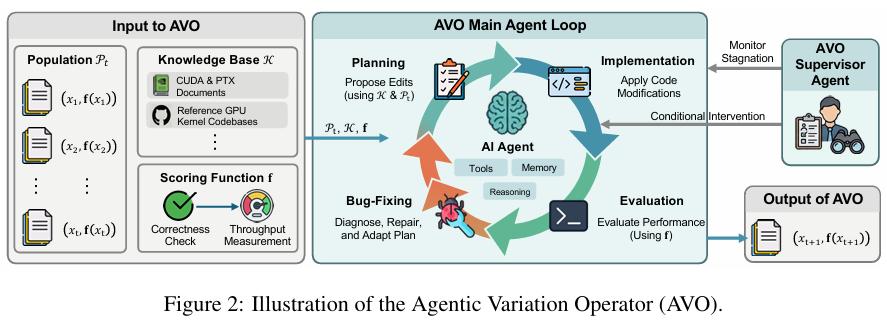
智能体接收当前种群、知识库和评分函数作为输入,通过自主循环完成方案改进。
AVO的一个变进步骤远不止一次LLM调用,而是一个完整的自主循环。
智能体在单步变进步骤中可能执行大量内部操作:查看多个历史方案的profiling特征来识别瓶颈,查阅知识库中的硬件文档了解约束条件,实现候选优化,调用评分函数测试结果。
当候选方案没有通过正确性检查,或者没有超越当前最优评分时,智能体会诊断问题并修改方案,重复这个编辑-评估-诊断循环,直到产生一个满意的改进版本。
凭借这种能力,智能体能够随着搜索进展自适应地调整优化策略。早期的变进步骤可能侧重于参考知识库中的实现进行结构性重构,后期步骤则可以转向基于profiling反馈和历史方案模式的微架构调优。
只有当新版本通过了正确性检查并且达到或超越了当前最优评分时,它才会被提交为一个新的已确认版本。不成功的中间尝试仍然保留在智能体的内部搜索轨迹中,但不会进入已确认的血统。
在长时间自主优化中,有两个常见的失败模式:智能体可能停滞(耗尽了当前的探索方向),或者进入无 productive cycles(反复修改但无法提升评分)。
AVO通过一个自监督机制来应对这两种情况。当检测到停滞或无效循环时,自监督机制会审查整体进化轨迹,引导搜索转向几个候选优化方向,从而用新的视角重新推动探索。
七天跑出的成绩单
实验在NVIDIA B200 GPU上进行,使用CUDA 13.1和PyTorch 2.10.0,与两个基线对比:cuDNN 9.19.1和FlashAttention-4。
基准测试评估前向预填充(forward prefilling)吞吐量,头维度128,BF16精度,序列长度覆盖4096、8192、16384和32768四种。总token数固定为32768,通过调整批大小来配合不同的序列长度。多头注意力(MHA)使用16个头,在causal(因果掩码)和non-causal(无因果掩码)两种模式下测试。
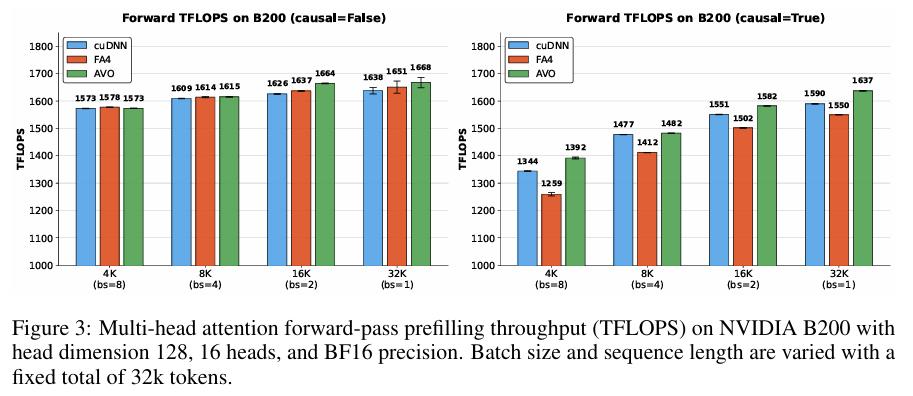
在causal MHA上,AVO在所有测试配置中都超越了两个基线。相比cuDNN,提升幅度从0.4%到3.5%;相比FlashAttention-4,提升幅度从5.0%到10.5%。
在non-causal MHA上,AVO在较长序列(超过16384)时取得1.8%到2.4%的cuDNN增益,在较短序列上则与两个基线处于测量噪声范围内。
为了验证优化方案的迁移性,研究团队让AVO智能体把进化得到的MHA内核适配为支持GQA。
智能体在约30分钟内自主完成了这个适配,不需要任何人类指导。测试了Qwen3模型家族的两种GQA配置:32个查询头配4个KV头(组大小8,对应Qwen3-30B-A3B)和32个查询头配8个KV头(组大小4,对应Qwen3-8B)。
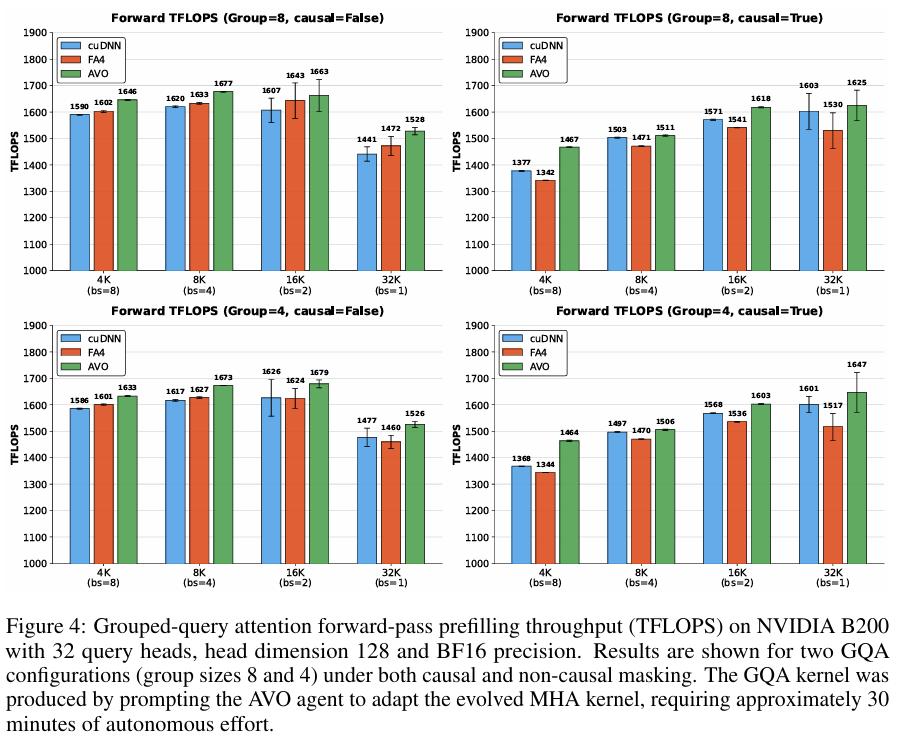
在causal GQA上,AVO相比cuDNN提升高达7.0%,相比FlashAttention-4提升高达9.3%。在non-causal GQA上,提升分别达到6.0%和4.5%。
GQA场景下的出色表现说明,智能体在MHA进化中发现的优化策略并不局限于MHA配置,可以泛化到GQA这样具有不同计算和内存访问模式的场景。
论文还用FlashAttention-4论文中报告的基线数据做了交叉验证。即使对照其他实验室在其他硬件上报告的数字,AVO的表现依然全面领先。
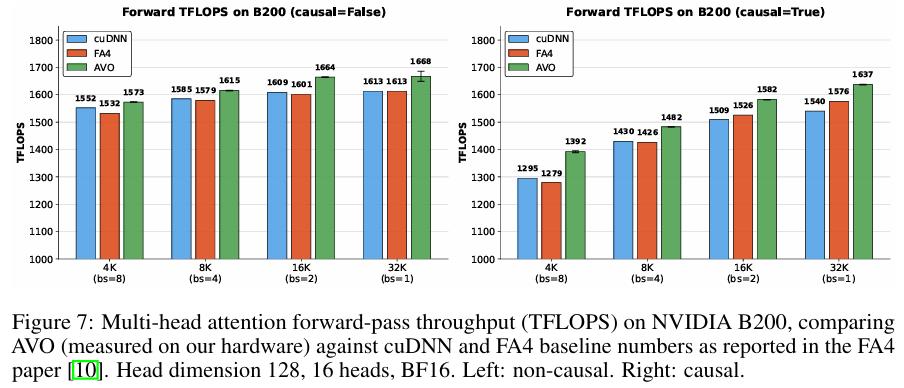
在non-causal注意力上,AVO相比FA4报告的cuDNN提升1.4%到3.4%,相比FA4提升2.3%到3.9%。在causal注意力上,相比cuDNN提升3.6%到7.5%,相比FA4提升3.7%到8.8%。
进化轨迹与AI发现的优化手法
7天进化过程中,AVO共产生了40个已确认的内核版本,内部探索了超过500个候选优化方向。
每个方向都需要阅读文档、实现修改、编译、测试、profiling,如此系统性的探索量远远超出人类工程师在同一时间段内能完成的规模。
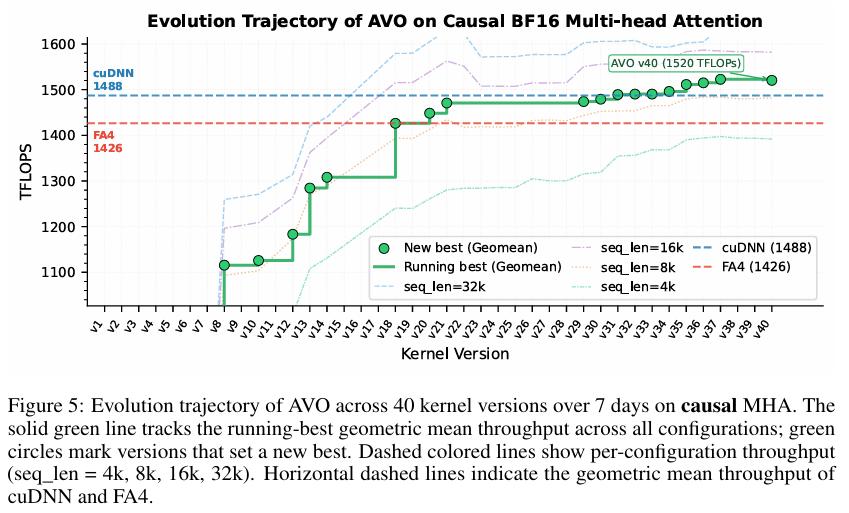
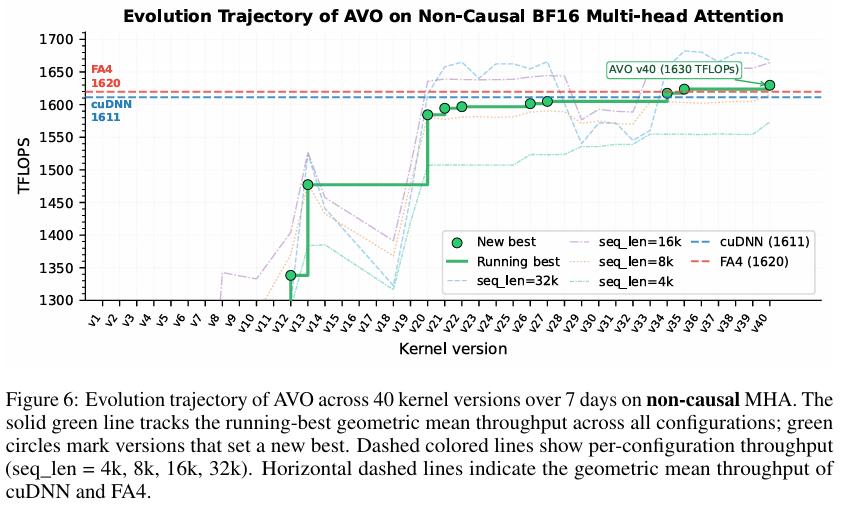
吞吐量以离散跳跃的方式提升。5个最大增益分别对应5个架构层面的转折点:引入QK-PV交织和位掩码因果掩码(版本8),重构单遍Softmax计算(版本13),无分支累积器缩放配合更轻量的内存屏障(版本20),Correction/MMA流水线重叠(版本30),以及跨线程束组的寄存器再平衡(版本33)。其余版本贡献了单个较小但累积可观的微架构调优。
早期版本(v1到v20)贡献了最大的单版本绝对增益,把一个朴素实现拉到了经过良好优化的基线附近。后期版本(v21到v40)的增益较小,通过周期级调度和精细化资源分配来挤压剩余性能余量。
这与内核开发的普遍规律一致:早期开发捕获粗粒度增益,后期优化通过越来越细粒度的调优来榨取剩余空间。
论文重点分析了三个具有代表性的优化,展示智能体对硬件推理的深度和水平。
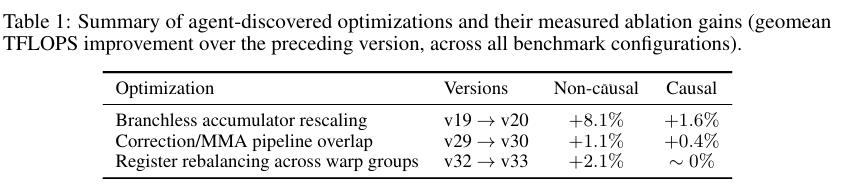
第1个优化是无分支累积器缩放,也是整个进化过程中增益最大的单项优化。
第2个优化是Correction/MMA流水线重叠。
第3个优化是跨线程束组的寄存器再平衡。
三项优化有一个共同特征:每一项都需要联合推理多个硬件子系统,包括同步和内存排序、流水线调度、寄存器分配,并非孤立地调优单个参数。
如此深度的硬件推理,通过自主迭代地与文档和profiling反馈交互来执行,印证了智能体变异算子可以成为专家级内核优化的有效手段。
AVO作为变异算子层面的方法论,不局限于注意力内核,可以扩展到其他性能关键型软件系统、不同硬件平台上的优化,以及需要长时间自主探索的工程和科学领域。
从一个专用AI工具到一个通用的自主优化范式,这个方向正在快速突破。
能连续7天不休息地调优GPU内核,还能做出超越人类专家的微架构决策,自我进化的AI已经到来了。
参考资料:
https://arxiv.org/pdf/2603.24517v1