听说读写画样样精通!美团开源LongCat-Next,给物理世界AI统一了语言
美团刚刚开源了最强原生多模态模型LongCat-Next,将物理世界AI的语言统一了。
LongCat-Next模型能听,能说。比如语音问答,或者让它用指定音色说话,
,时长00:07
,时长00:10
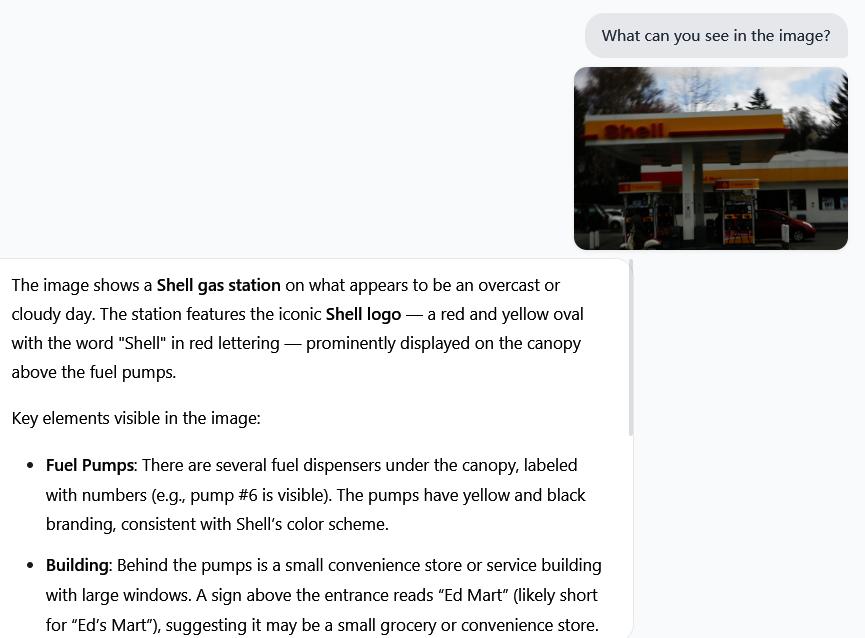
能读能写(视觉理解和推理),
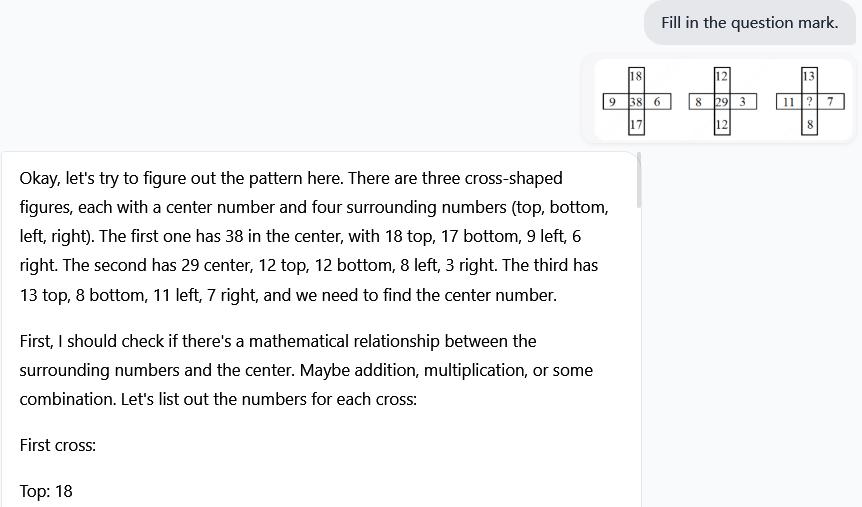
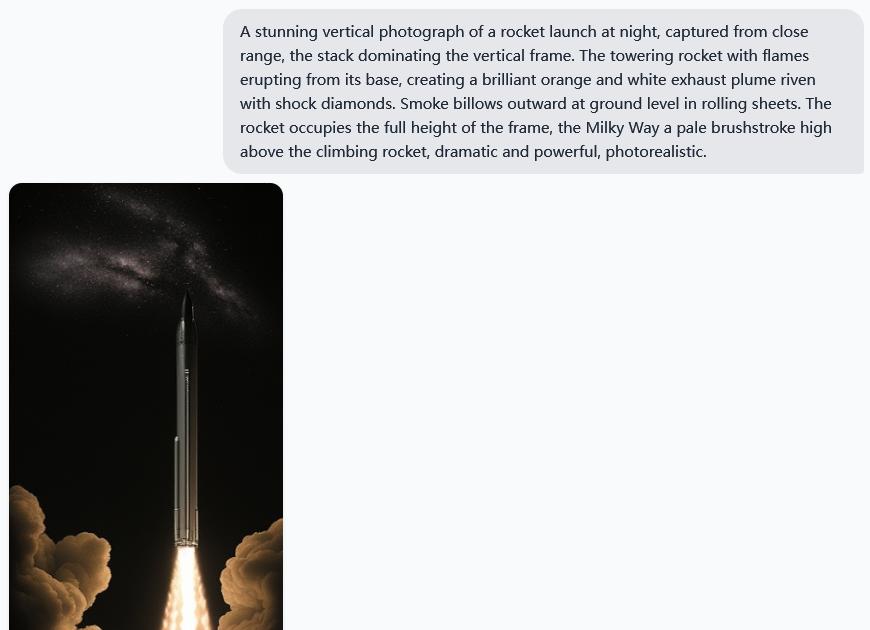
还能画画和设计,
今天的大模型,本质上仍然是以语言为中心的建模系统。
能否让AI像处理语言一样,用同一种方式,简洁有效地处理物理世界的图像、声音、文字交织而成的信息?
美团LongCat团队给出了答案,LongCat-Next模型把图像、语音与文本统一映射为同源的离散Token,让物理世界的AI统一了自己的母语。
一套架构统一所有模态
业界主流的多模态大模型,长期受制于语言基座加外挂视觉或语音模块的拼凑式架构,非语言模态往往只作为辅助组件存在。
这种设计带来很多结构性问题,比如图像理解与生成在结构与优化上长期割裂:前者依赖对齐机制,后者依赖扩散等独立模型,多模态信息始终停留在被投影,而非被内化。
LongCat团队构建了DiNA(Discrete Native Autoregressive,离散原生自回归)架构,核心思路非常简单:将所有模态统一为离散Token,并用同一个自回归模型进行建模。
这套架构将物理世界广泛存在的多模态信号收敛为同源的离散特征,实现了视觉、语音、文本多模态的底层建模统一。
作为整个大语言模型体系的自然扩展,DiNA彻底打破了模态间的隔阂。它通过极简的下一Token预测(Next Token Prediction,NTP)范式,将图像、声音和文字统一转化为同源的离散Token。在这套原生的统一架构下,视觉的看与画、听觉的听与说,不再是拼接的异构模块,而是同一套预测逻辑的自然涌现。
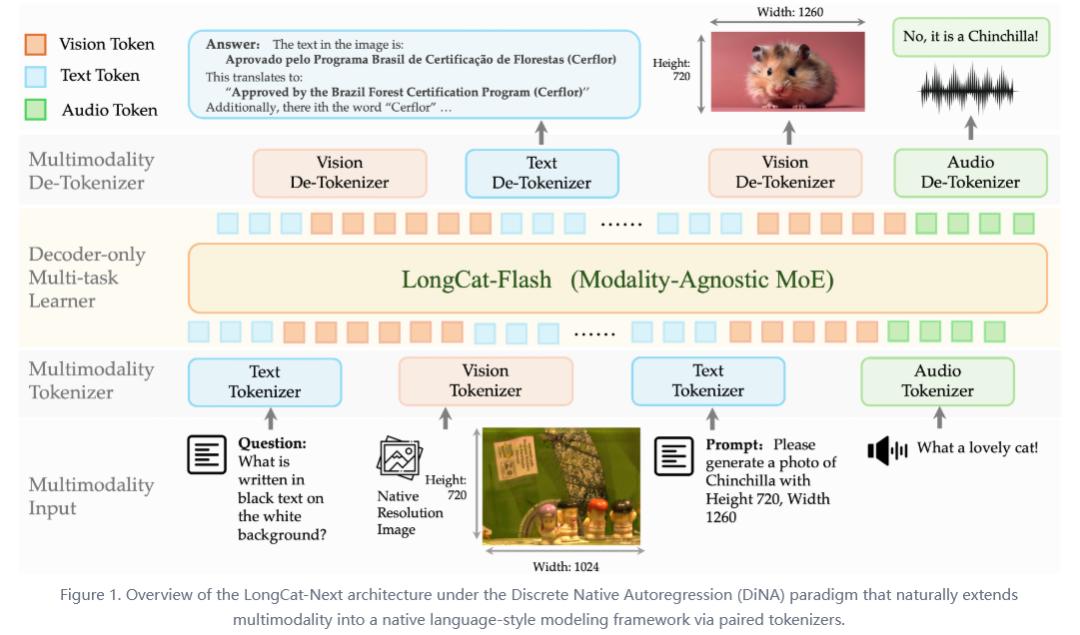
简单而言,LongCat-Next把文字、图像、语音都变成同一种东西,离散Token。无论读文字、看图片还是听声音,对AI来说都是同一件事:预测下一个Token是什么。
这个设计带来三个根本性改变。
第一个改变是架构极简。所有模态共享同一个自回归骨干,无论输入的是文字、图像还是音频,模型都用同一套参数、同一个注意力机制、同一个损失函数。
这种统一设计,让模型在训练时更稳定,部署时更轻量。LongCat-Next以LongCat-Flash-Lite MoE作为基座,总参数68.5B,激活参数3B。
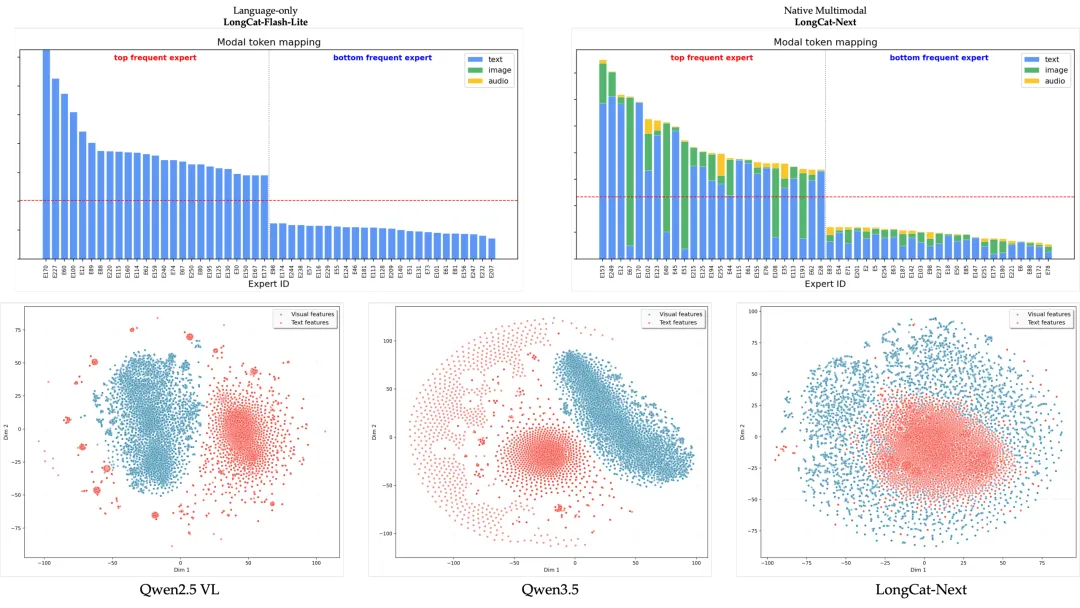
实验表明,DiNA的MoE路由在训练中逐渐出现模态专精化,激活专家数量相比纯语言设置有所增加,模型正在用更大容量支撑能力扩展。
第二个改变是理解与生成对称。LongCat-Next用同一个自回归模型同时实现了视觉理解和生成,通过这样解决了长期困扰的理解生成架构和优化不一致问题。
在统一Token空间中,理解与生成被统一为同一数学问题,两者本质上都是条件下的Token预测:给定图像Token预测文字Token是理解,给定文字Token预测图像Token是生成,数学形式完全一致,从此不再割裂。
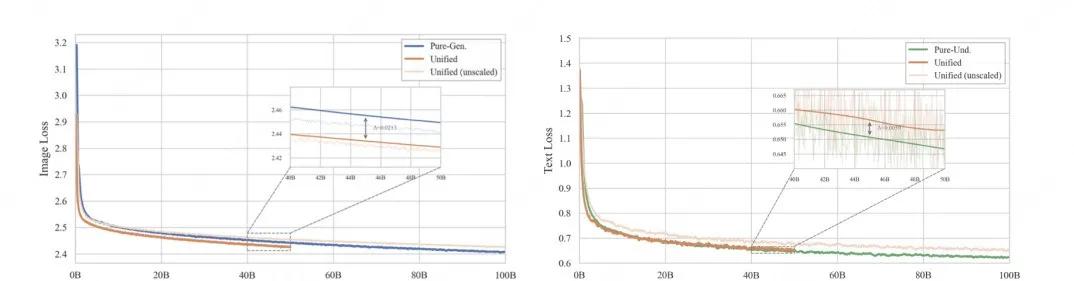
实验证明,这种对称设计在优化上消弭了冲突:统一模型的理解损失仅比纯理解模型高0.006,而生成损失比纯生成模型低0.02。理解没有损害生成,反而表现出协同潜力。
第三个改变是模态内化。在离散原生训练范式下,不同模态被统一编码为Token,并以相同方式建模。研究者观察到,不同模态的Token表征在表示空间中自然融合,MoE专家自发形成模态偏好分化。这表明模型并非在对齐模态,而是在内部形成统一的多模态表征结构。
视觉词汇把图像变成语言
DiNA解决的是如何统一建模,dNaViT解决的则是如何让图像本身能够被离散化为可建模的Token。
LongCat团队首创的dNaViT技术相当于语言模型中的tokenizer分词器,就像把句子拆成单词,它把一张图拆解成一系列有意义的视觉词汇。
dNaViT实现了原生任意分辨率支持。不做缩放、不裁剪、不填充,每一处细节都完整保留。
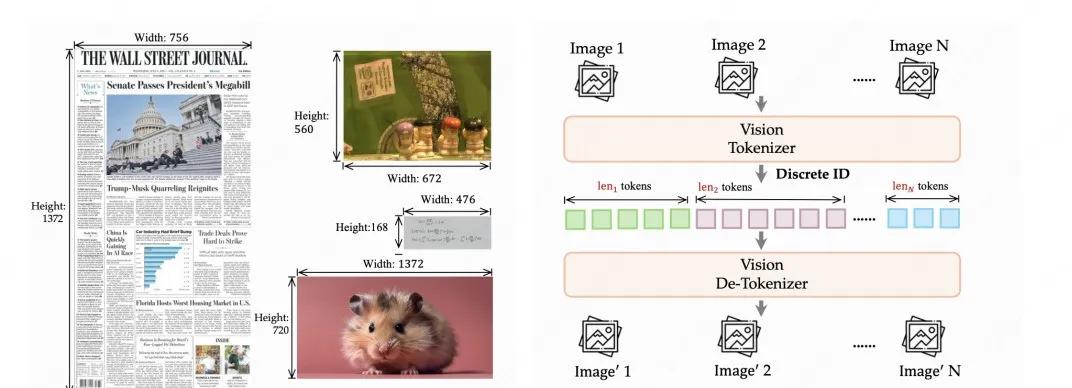
通过精心设计的训练策略,dNaViT实现了任意分辨率的图像编码与解码,在文档解析(OCR)、复杂图表推理等对细节敏感的任务中具备优势。在OmniDocBench、OCRBench等密集文本场景的测试中均表现优异。
dNaViT采用8层残差向量量化(Residual Vector Quantization,RVQ)技术。细节多了怎么办?分层打包。
类比于第一层打包轮廓,第二层打包颜色,第三层打包纹理,8层级联递归拟合残差中的残差,可以实现高达28倍极致像素空间压缩。解码时,DepthTransformer将多级Token合并重建,让压缩与还原高效协同。
dNaViT还采用了解耦的双轨生成解码器(Dual-Path Detokenization)设计。离散token还原图像时,先由结构像素解码器保住布局,再由扩散像素细化器注入纹理细节。解耦设计降低生成方差,确保文本渲染无损清晰。
更妙的是,这套视觉词汇实现了image → token → image的完整回环,像语言tokenizer一样,既用于看懂图像,也用于画出图像。理解时学到的对应关系,生成时正好反过来用,图像描述和图像生成在同一套token序列中闭环流转。
在LongCat-Next中,视觉Token完成的是图像到离散ID的映射,真正的特征是原生学习的。
真正的视觉表征,是在语言模型内部通过embedding学习得到的。模型不是接入视觉能力,而是在内部学习并形成自己的视觉语言。这种从借用模态到内生模态的转变,是原生多模态建模的核心。
离散表示何以承载丰富信息
离散建模通常被认为受限于两方面:表征容量与离散化损失。
LongCat团队进一步分析发现,真正决定上限的关键在于离散Token本身是否具备语义完备性。问题不在于是否离散,而在于离散后的表示,是否能够同时承载高层语义与细粒度信息,如颜色、纹理与空间结构,从而支撑统一的理解与生成。
基于这一视角,LongCat团队提出实现语义完备离散表示的关键,在于构建合适的表征基础。
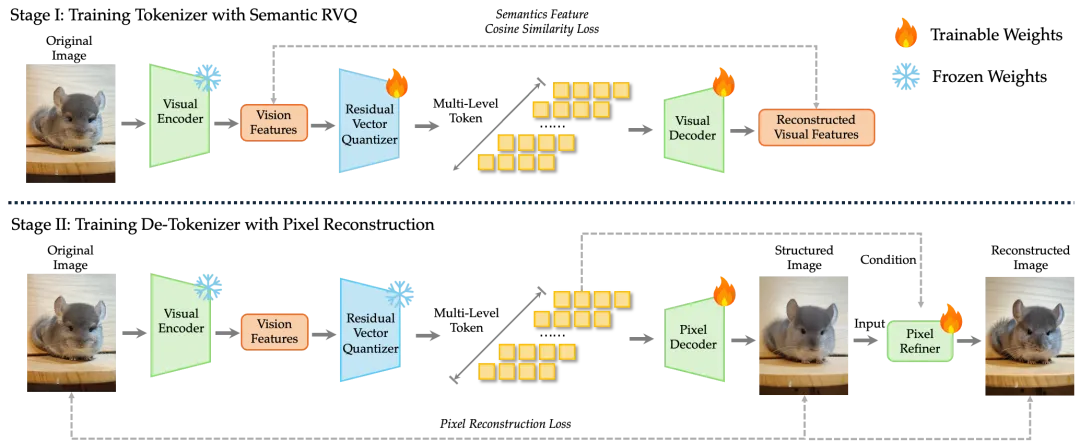
其中一类重要的候选范式是SAE(Semantic-and-Aligned Encoder,语义对齐编码器)。
不同于以对比学习为主的模型,SAE通过大规模视觉语言监督,涵盖图像描述、视觉问答乃至视觉推理等任务,学习高信息密度、多属性的表征。
这类表征不仅具备丰富的语义结构,同时在网络的残差传递机制下,底层视觉细节能够持续向高层传播,从而在抽象语义中保留细粒度信息,为离散Token的语义完备性提供基础。
在此之上,离散化过程本身仍需尽可能减少信息损失。LongCat团队采用多级残差向量量化机制,对表征进行逐级离散建模:通过层级化拟合残差中的残差,在有限离散空间内逼近高维连续表示,从而在压缩率与信息保真之间取得平衡。
最终得到的离散视觉Token,不仅能够支撑细粒度理解任务,例如在密集文本识别中优于连续表征模型,同时也具备高保真的图像重建能力。离散表示并非信息的退化形式,而可以成为统一理解与生成的完备表达载体。
用数据说话
LongCat-Next在视觉理解、图像生成、音频、智能体等多个维度上,以一套离散原生框架展现出与多模专用模型相当甚至领先的性能。
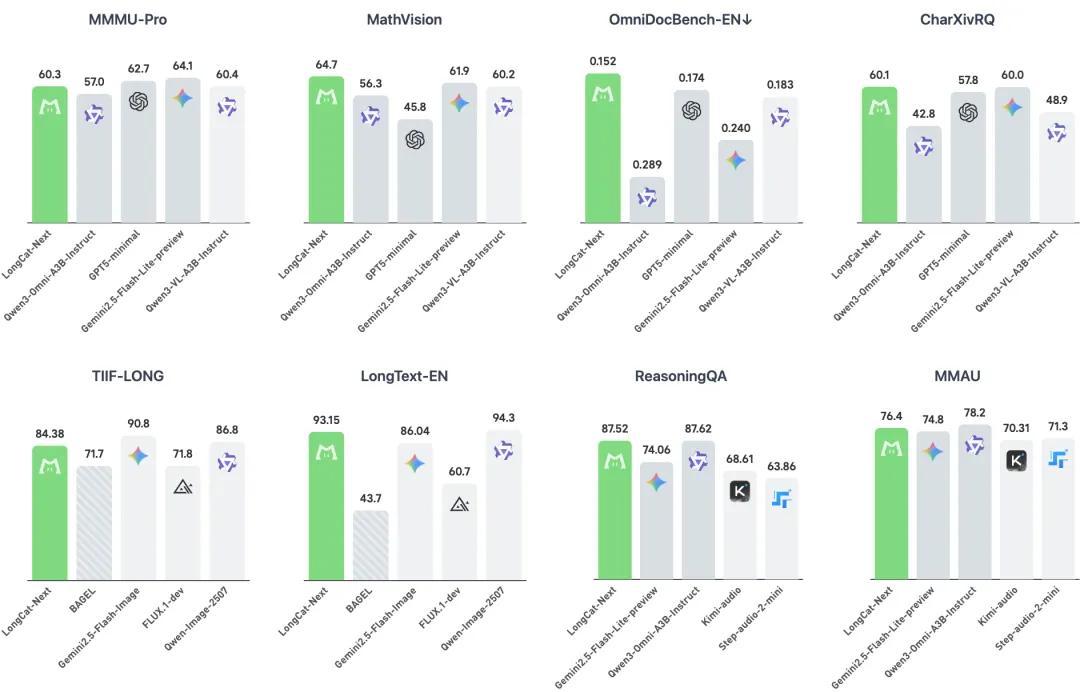
这些成绩验证了三个关键发现。
行业长期认为,离散模型在细粒度文本识别上必然不如连续模型,这也是一直阻碍业界使用离散建模作为选项的原因。
经过dNaViT的设计以及DiNA的建模框架,LongCat-Next表现出了非凡的细粒度感知能力和高质量的视觉推理能力。LongCat-Next在OmniDocBench上的表现达到0.152和0.226,这个数据集包含学术论文、财报、行政表格,不仅超越Qwen3-Omni,还超过了专用视觉模型Qwen3-VL。
离散化不是细粒度感知的天花板,关键在于如何构建语义完备的离散视觉表征。
传统观点认为,一个模型很难同时做好理解和生成。
消融实验对比中,LongCat-Next统一模型的理解损失仅比纯理解模型高0.006,而生成损失比纯生成模型低0.02。在图像生成上,LongCat-Next在LongText-Bench英文测试达到93.15;在图像理解上,MathVista达到83.1,成为一个具备工业级潜力的理解生成统一方案。理解没有损害生成,反而表现出协同潜力。
在纯文本任务上,LongCat-Next的MMLU-Pro达到77.02,C-Eval达到86.80,表现领先,证明原生多模态训练未削弱语言核心能力。
在工具调用上,τ²-Bench零售场景达到73.68,大幅领先Qwen3-Next-80B-A3B-Instruct的57.3;在代码能力上,SWE-Bench达到43.0,显著超越同类模型。
在音频领域,这一框架同样展现出良好的通用性。
TTS任务上,SeedTTS的中文和英文WER分别低至1.90和1.89;音频理解上,MMAU达到76.40、TUT2017达到43.09,均达到先进水平。模型支持低延迟的并行文本语音生成与可定制的语音克隆,让语音交互更自然、更个性化。
模型学会用同一种方式理解图像、声音和文字,它在理解世界时变得更聪明了,无论是看懂图表、听懂语音,甚至是调用工具、编写代码。
LongCat-Next作为一个初步的尝试,展示了一个有意义的视角。
物理世界的信息可以被离散化、统一化、像语言一样被建模,让AI第一次能够像处理文字一样原生地理解物理世界的多模态信号。
参考资料:
https://longcat.chat/longcat-next/intro
https://github.com/meituan-longcat/LongCat-Next
https://huggingface.co/meituan-longcat/LongCat-Next