Karpathy的AutoResearch指南:用AI智能体自动化机器学习实验
本文将详解 Karpathy 的 AutoResearch 如何在单张 GPU上一夜间运行上百个机器学习实验,涵盖其三文件架构、棘轮循环机制、实测效果与局限。
Andrej Karpathy 推出的 AutoResearch 是一款开源工具,它能循环执行机器学习实验,仅保留能超越当前最优结果的改进方案。你只需在 Markdown 文件中写明研究方向,将 AI 编码智能体指向代码仓库,便可放手不管。次日清晨,你就能得到一份记录了所有有效改进的 Git 提交历史,以及智能体所有尝试的完整日志。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
AutoResearch 项目于2026年3月发布,短短几天内就在 GitHub 收获5万+星标,Karpathy 发布的介绍视频播放量达860万次。本文将拆解其三文件架构的运行逻辑、夜间实验中棘轮循环的工作机制、AutoResearch 已取得的效果,以及该方案的边界与局限。
一、什么是 AutoResearch?
AutoResearch 是一款开源 Python 工具,可让 AI 智能体在无需人工干预的情况下,于单张 GPU 上自主运行机器学习实验。它循环执行「提出假设→训练→评估」流程,仅保留能降低验证损失的修改,项目采用 MIT 开源协议。
这并非超参数调优。Optuna、Ray Tune 等工具仅在预定义的参数空间内搜索;而 AutoResearch 赋予智能体任意修改代码的自由,其搜索空间完全由大语言模型(LLM)的能力决定,这让它成为一款与现有工具截然不同的全新品类。
自动化机器学习(AutoML)与神经架构搜索(NAS)框架,依靠结构化算法在架构或超参数空间内搜索,精准但受限于预设范围;谷歌 DeepMind 的 AlphaEvolve 采用进化算法结合 Gemini 模型探索算法,实现了更大突破,但属于闭源工具,绝大多数团队无法使用;SWE-Agent、OpenHands、Aider 等通用编码智能体可编写任意代码,却并非为机器学习研究所需的「实验-评估-保留/回退」循环设计。
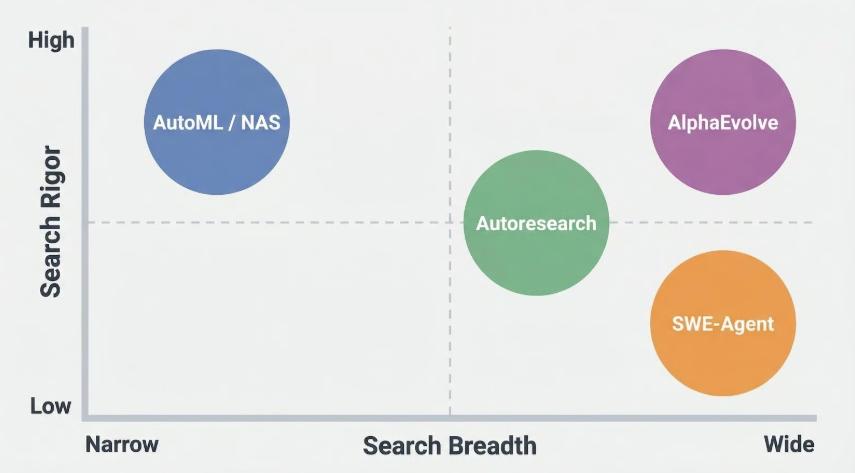
AutoResearch 的核心思路,是依托大语言模型的通用知识提出优质实验方案,而非通过限制搜索空间换取数学上的确定性保证。
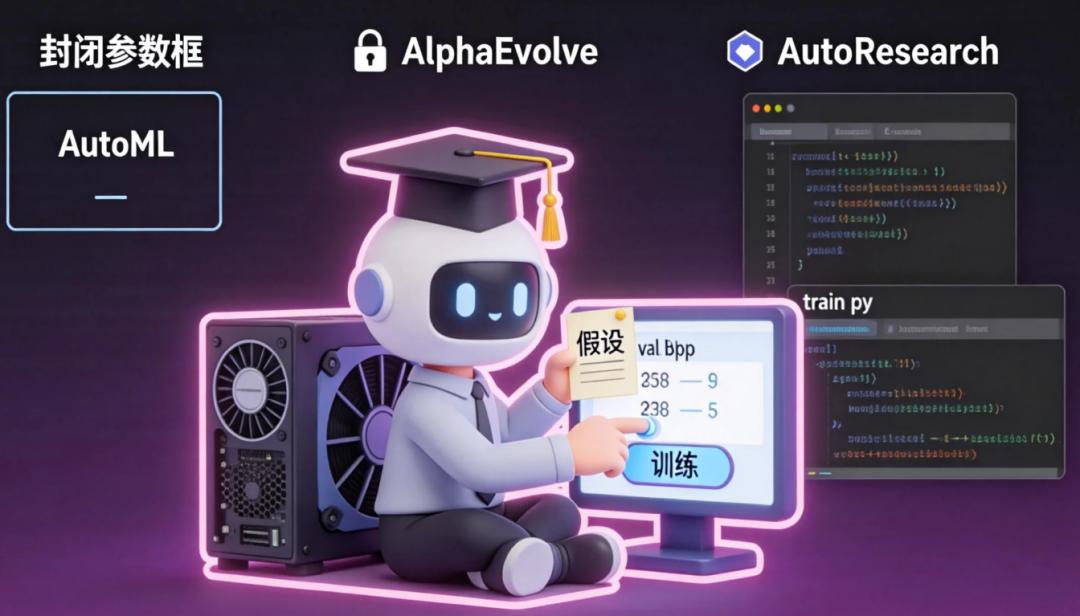
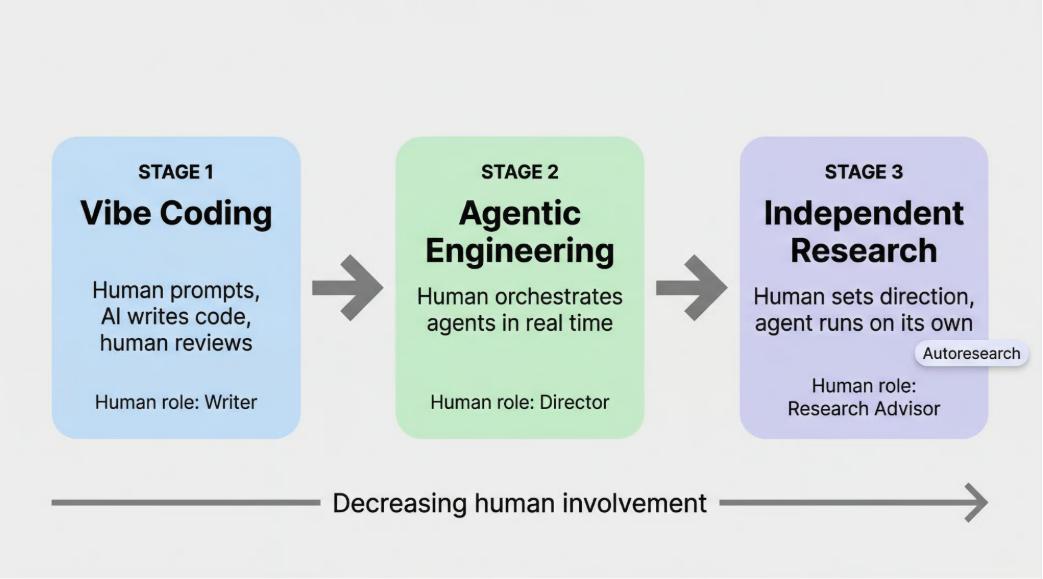
从氛围编程(vibe coding)到研究顾问(research advisor)
Karpathy 将这一趋势定义为工程师与 AI 协作方式的自然演进。2026年2月,他提出智能体化工程概念:「99%的时间里你不再直接写代码,而是统筹智能体执行工作,并担任监督角色。」AutoResearch 则更进一步——人类甚至无需统筹,只需在 Markdown 文件中定义「优质研究」的标准,便可完全放手。
这一演进路径为:
1. 氛围编程:人类写提示词,AI 生成代码,人类审核;
2. 智能体化工程:人类实时统筹智能体工作;
3. 完全自主研究:人类设定方向,智能体自主运行。
每一步都将人类的角色从代码编写者转变为方向把控者,最终成为 Karpathy 中的研究顾问。
在后续文章中,他进一步描述了未来方向:「我们的目标不是模拟单个博士生,而是模拟一整个研究社区」,这一思路参考了分布式智能体协作模式。
而这一愿景的落地,核心依靠三个核心文件。
二、AutoResearch 的三文件架构
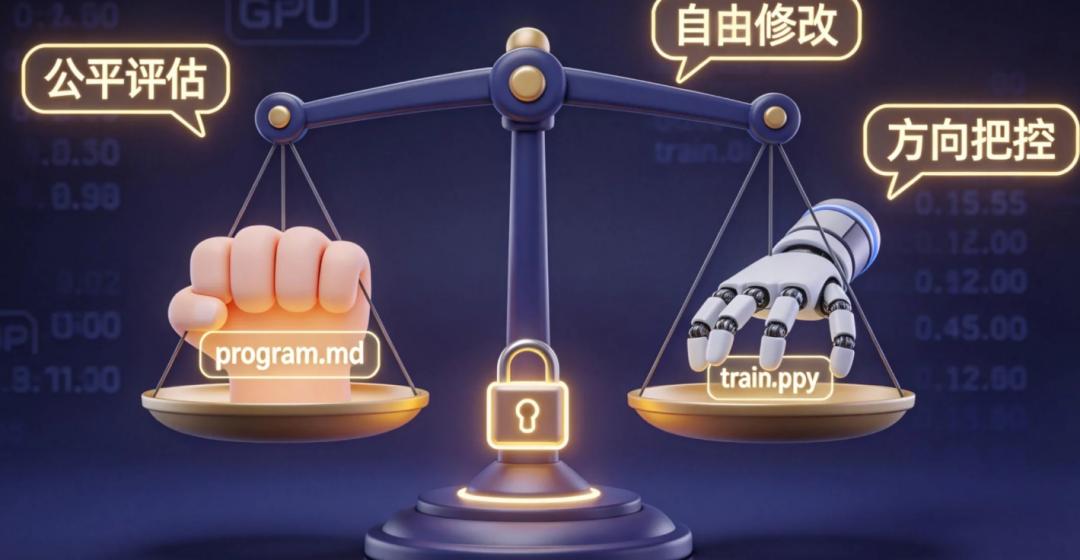
AutoResearch的设计核心是三个文件的权责约定,每个文件都有严格的修改权限规则,互不越界。
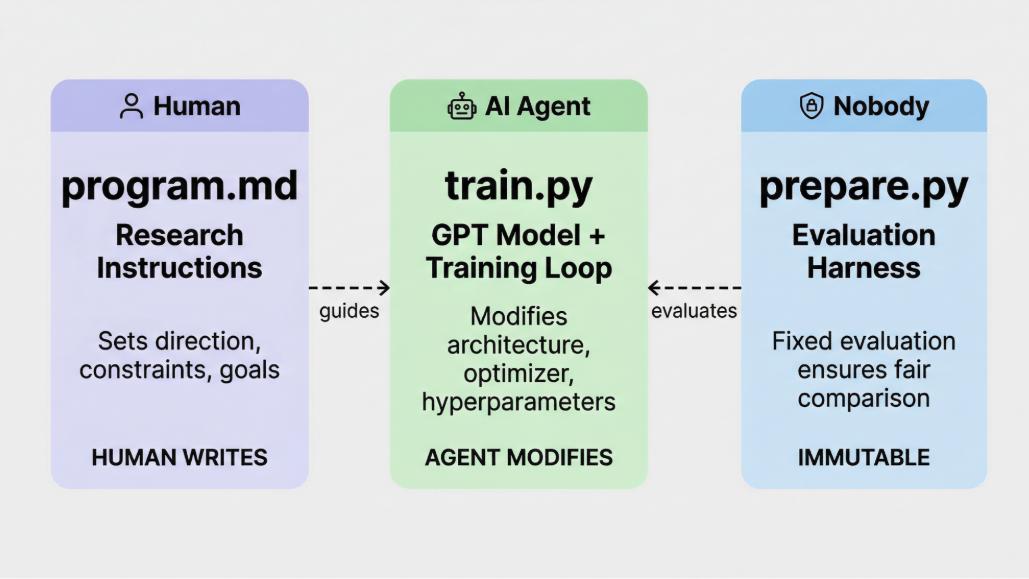
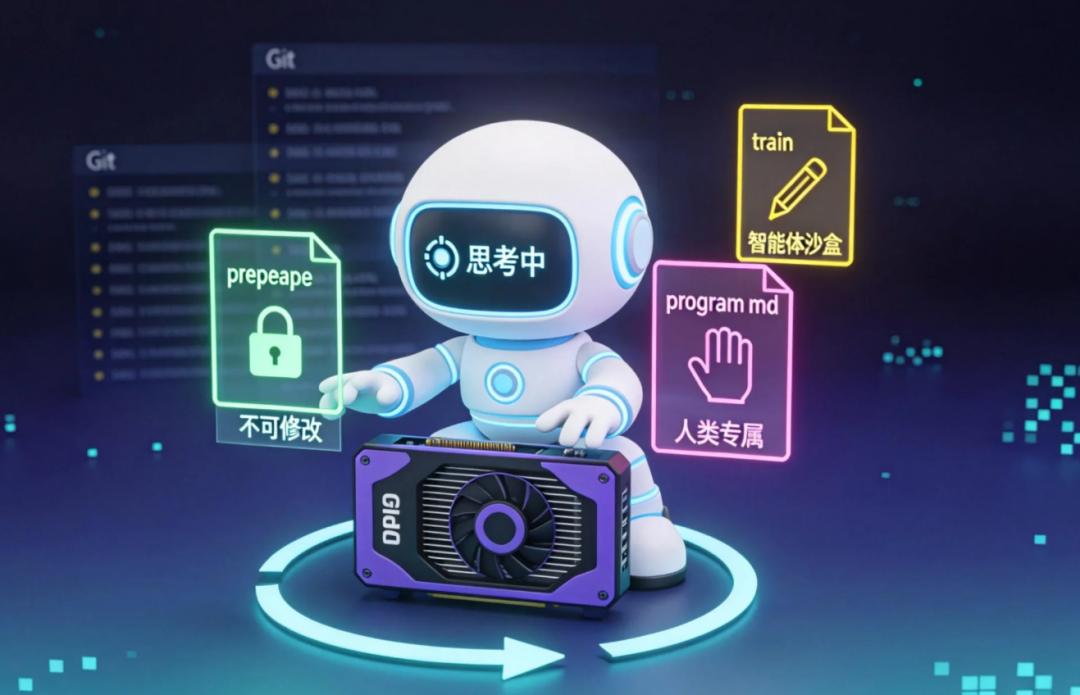
1. prepare.py(不可修改)
该文件负责数据预处理与模型评估,内置8192词表大小的字节对编码(BPE)分词器,处理训练语料,并定义核心验证指标:val_bpb(验证集字节比特率)。
它是完全不可变文件:人类与智能体均无权修改,确保所有实验都用同一套标准评估,保证公平性。
2. train.py(智能体沙盒)
这是智能体的自由修改区,共630行代码,包含 GPT 模型架构、Muon+AdamW 优化器与完整训练循环。
智能体可任意修改此处代码(替换激活函数、重构注意力头、调整学习率策略、修改权重初始化等),唯一要求是修改后的代码能正常训练并输出 val_bpb 分数。
3. program.md(人类专属)
纯 Markdown 编写,仅允许人类修改。它向智能体明确:要探索的研究方向、需规避的问题、实验执行规则。
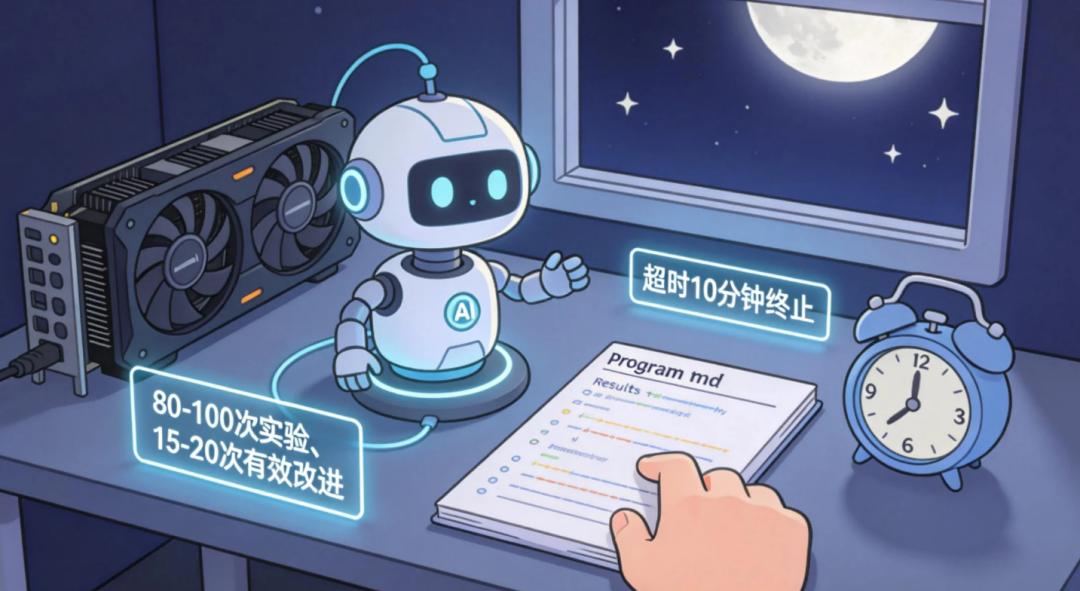
program.md 的核心控制项
• 写入基线指标,让智能体明确优化目标(val_bpb:0.997900,显存峰值:45GB);
• 定义实验运行与结果提取的精确命令;
• 设定故障处理规则:修复语法错误并重跑、彻底放弃存在根本性问题的思路、超时10分钟强制终止;
• 核心执行指令:「永不停止」——实验循环启动后,无需暂停询问人类意见;
• 设计约束:同等效果下,越简单越好。华而不实的复杂改进毫无价值,引导智能体避免过度设计,产出人类认可的简洁方案。
三者权责清晰:人类通过 program.md 定研究方向,智能体修改 train.py 执行实验,prepare.py 作为中立裁判。这套约定让智能体可不间断自主运行实验循环。
三、AutoResearch 飞轮循环
AutoResearch 的核心是无需人工干预的实验循环,单次迭代遵循 program.md 定义的9步流程,也是「飞轮」名称的由来:
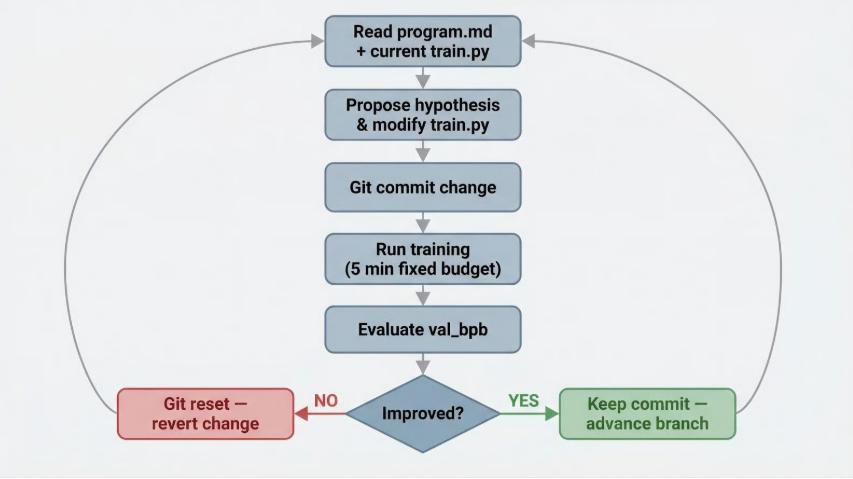
1. 智能体读取 program.md,明确当前研究优先级与约束;
2. 查看当前 train.py 代码与 results.tsv 中的近期实验结果;
3. 提出假设:架构修改、优化器调整或训练策略优化;
4. 修改 train.py 实现假设方案;
5. 将修改提交至 Git 分支;
6. 严格执行5分钟训练(固定时长预算,保证实验可比性);
7. 若训练崩溃,记录故障、回退提交并重新尝试;
8. 用 val_bpb 评估结果,写入 results.tsv 日志;
9. 效果提升则保留提交,未提升则执行 git reset HEAD~1 回退至上一版本。
循环重新开始,每轮实验固定5分钟,每小时可执行约12次实验。
「飞轮」的核心逻辑体现在 Git 历史中:仅进不退。有效改进保留提交,无效尝试直接回退,代码库只会持续积累验证过的优化,不会倒退。
Git 作为研究记忆库
从结构上看,它类似进化算法,但 AutoResearch 仅保留单一路线,而非种群进化。大语言模型同时承担「变异算子」(提出修改)与「选择压力」(依据历史结果选择尝试方向)的角色。
智能体会读取 Git 历史与 results.tsv 日志,在有效方向上持续优化。results.tsv 会完整记录每一次实验:提交哈希、val_bpb 分数、显存占用、成功/失败状态、实验内容描述。
次日你可清晰复盘所有尝试,智能体也会依据这份日志校准后续方向:早期实验偏向宽泛探索(测试不同优化器配置),后期则聚焦数据验证有效的方向深耕。
四、快速上手 AutoResearch
运行 AutoResearch 需满足以下条件:
• 硬件:NVIDIA GPU(默认配置适配20GB+显存的现代显卡);
• 环境:Python 3.10+、uv 包管理器、编码智能体(Claude Code、Cursor 等)。
基础运行命令
git clone https://github.com/karpathy/autoresearch.gitcd autoresearchuv syncuv run prepare.py
该工具无调度脚本(无 run.py、无流水线、无框架封装),官方 README 说明:「只需在项目目录启动 Claude/Codex 等编码智能体即可」。
操作流程:在项目目录打开编码智能体,提示它读取 program.md,智能体便会自主运行实验循环。大语言模型就是自动化层,可通过实时查看 results.tsv 或 Git 提交日志监控进度。
首次运行配置
默认配置基于 FineWeb-Edu 数据集训练 GPT 模型,需高性能显卡且数小时才能看到效果。小硬件测试建议:切换至 TinyStories 数据集,将词表大小降至256、模型深度降至4,可大幅降低显存要求,数小时内就能看到飞轮循环的效果。
首次夜间运行建议
• 提前阅读并修改默认 program.md,这是控制实验方向的核心;
• 想聚焦注意力机制、禁止修改优化器,直接在文件中写明约束,智能体严格遵守;
• 夜间运行约80-100次实验,约15-20次有效改进;
• API 成本随实验次数增加,单次夜间运行成本可控,多日运行需规划预算;
• 部分实验会崩溃,循环会自动恢复,不影响夜间运行;
• 次日直接查看 results.tsv,val_bpb 分数的阶梯式提升比单条日志更直观。
五、AutoResearch 实测效果与创新上限
AutoResearch 已在官方实验、社区复现、生产落地中完成多轮测试,核心效果如下:
智能体发现的优化点,都是人类研究者逐步探索会找到的方案:
• 注意力锐化的 QK 归一化缺少缩放乘数;
• 值嵌入(Value Embeddings)需添加正则化;
• 带状注意力调优、AdamW β参数、权重衰减策略优化。
这些都是结构性代码修改,而非随机超参数扫描,人工逐一测试需耗费数天。
Shopify CEO Tobi Lutke 将 AutoResearch 用于内部查询扩展模型,在37次实验后,0.8亿参数模型的验证分数提升19%,次日便得到结果。
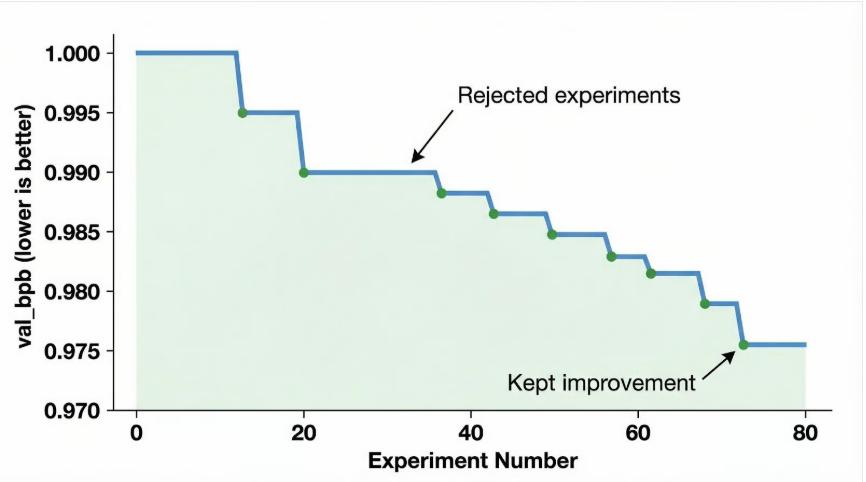
尽管效果呈阶梯式提升,但每一步改进都微小且渐进。智能体仅能做细节调优(如修改β参数、添加正则化),目前尚无案例证明它能发明全新注意力机制、提出人类想不到的架构创新——这就是创新上限。
核心局限:创新天花板
GitHub Issue #22 指出了结构性问题:智能体只会在最后一次有效方案上做微小变体,陷入局部搜索陷阱。
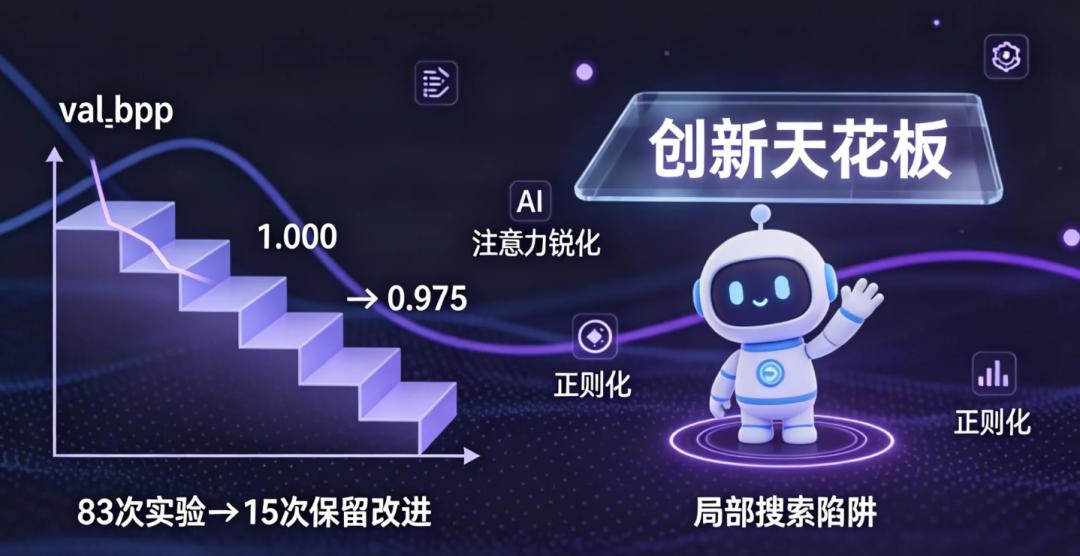
飞轮机制仅接受立即提升 val_bpb 的修改,导致智能体无法「先退后进」,为更大突破做短期妥协。而人类研究者常会主动接受短期下降,换取长期更优解。
Karpathy 在黑客新闻论坛也提到:面对开放式问题,智能体表现得「谨慎又胆怯」。他认为这源于**基于人类反馈的强化学习(RLHF)**训练——模型更倾向安全、保守的输出,而非大胆探索。智能体具备提出创新方案的能力,却被训练成「求稳」模式。
此外,固定5分钟训练窗口也是约束:
• 快速见效的修改会被发现,长期训练才能验证的方案被忽略;
• 同一验证集上百次实验,存在过拟合风险:部分改进仅适配验证集,而非真实泛化能力;
• prepare.py 的不可变性是公平保证,也成为系统盲区。
社区正在讨论创新上限源于框架还是底层模型,提出的优化方向包括:
• 元提示优化:用第二个智能体根据结果重写 program.md;
• 多样性激励:同时奖励创新与效果提升;
• 定期重置:从早期检查点重启实验,跳出局部最优。
目前的 AutoResearch,是自动化机器学习研究中「方法论执行」环节的工具,可高效跑数百次小实验;但创新方向定义这一核心创造性工作,仍需人类完成。这一分工也是判断它是否适合你的工作流的核心标准。
六、AutoResearch 的适用场景
三文件约定(不可变评估器、智能体可修改执行层、人类定方向),不仅适用于大语言模型训练,也可迁移至所有能定义自动评分函数的领域:
• 搜索排序优化、商品分类、临床命名实体识别、欺诈评分、意图分类等。
这类任务的共性:小模型可在数分钟内训练、评分标准清晰、改进可迁移至更大模型。
当实验效率提升至人类的100倍,评估流程会成为新瓶颈:静态基准测试很快会达到饱和。采用该模式的团队,需要同步迭代评估集,加入更难的边缘案例。
Karpathy 本人已在8张 H100 GPU 上运行 AutoResearch 的「增强版」,用于生产级 nanochat 框架,证明该模式可扩展至非玩具级实验。社区已推出 macOS/苹果芯片适配版,并提出旧显卡兼容方案,而GPU 仍是迭代训练的刚需硬件。
如果你的目标是在成熟训练流程中榨取渐进式改进,AutoResearch 是绝佳工具;但需要真正创新的问题,仍离不开人类研究者——这款工具最擅长的,是机器学习研究中占比最高的方法论迭代工作。
七、结论
编写一份优质的 program.md,前提是你自己做过相关研究。你需要知道哪些方向值得探索、「优化」的定义是什么、渐进式改进何时触达天花板。智能体负责执行,但研究方向的判断仍属于人类。
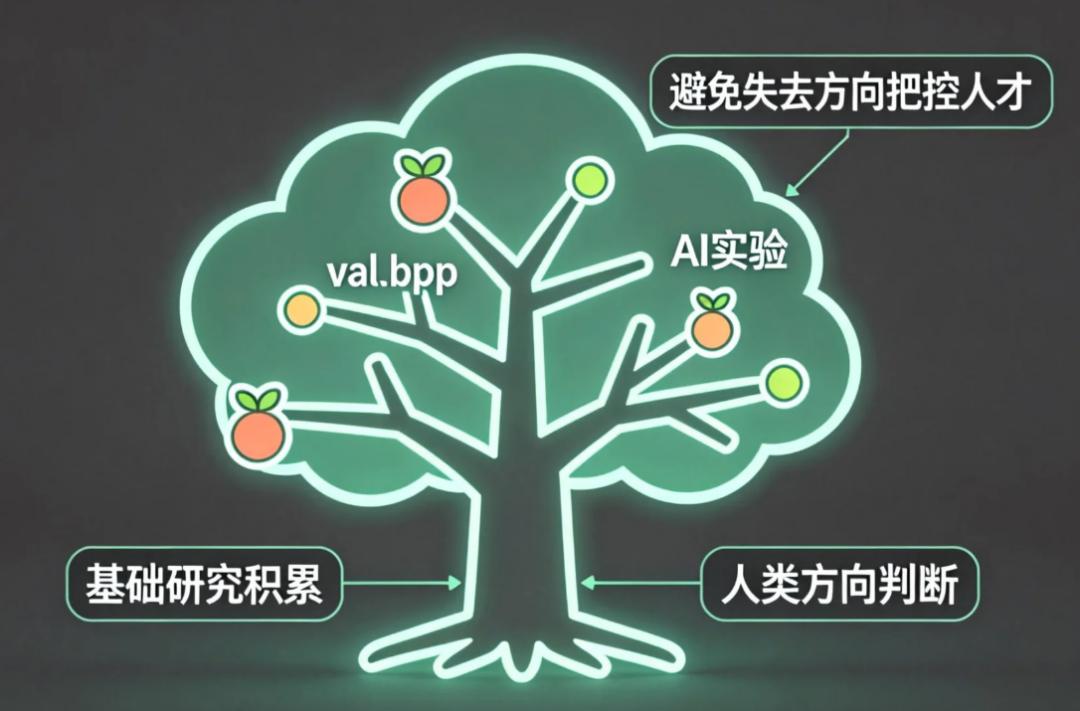
如果新一代工程师因智能体替代执行工作,而跳过了基础研究积累,行业将拥有充足算力,却失去能把控方向的专业人才。
八、AutoResearch 常见问题
• 什么是 AutoResearch? Andrej Karpathy 开发的开源 Python 工具,让 AI 编码智能体在单 GPU 上自主运行机器学习实验,循环执行「提出-训练-评估」流程,仅保留有效改进,无效方案通过 Git 回退丢弃。
• AutoResearch 飞轮循环如何工作? 智能体读取 program.md 获取研究方向,修改 train.py 并提交,执行5分钟训练,用 val_bpb 评估;效果提升则保留提交,否则回退,循环自动重复。
• AutoResearch 的三文件架构是什么?
• prepare.py:不可变,负责评估;
• train.py:智能体沙盒,可任意修改;
• program.md:人类编写,定义研究方向、约束与实验规则。
• AutoResearch 的局限是什么? 核心是创新上限:飞轮机制仅接受即时优化,无法「先退后进」,智能体仅能做微小渐进改进,无法提出架构级创新。
• AutoResearch 与 AutoML、AlphaEvolve 有何区别? AutoML 与 NAS 仅在预设参数空间搜索;AlphaEvolve 闭源且采用进化算法;AutoResearch 允许智能体任意修改代码,依托大模型知识探索,完全开源(MIT协议)。
参考资料
• https://github.com/karpathy/autoresearch
• https://www.datacamp.com/tutorial/guide-to-autoresearch