微软开源Phi-4|15B参数破解标注成本困局,数据闭环+混合推理实现降本增效
🔥 开源代码已放出:https://aka.ms/Phi-4-reasoning-vision[1] https://github.com/microsoft/Phi-4-reasoning-vision-15B[2]
还在为动辄数十亿参数、推理缓慢如牛的多模态大模型发愁吗?每次想部署一个能看图、能推理的AI,都被高昂的计算成本和漫长的响应时间劝退?微软最新开源的 Phi-4-reasoning-vision-15B 告诉你:推理能力翻倍,计算量砍半,小模型也能办大事!
读完本文,你将彻底掌握这个仅用1/5训练数据、在效率-性能权衡上杀出重围的“小而美”多模态模型的全部秘密。
❓ 核心痛点:为什么大模型越跑越慢?
如今的视觉-语言模型(VLM)赛道,似乎陷入了一个怪圈:为了追求更高的基准分数,参数规模(如Qwen3-VL-32B)和训练数据量(动辄万亿token)疯狂堆砌。
这直接导致了两个致命问题:训练成本高不可攀,让大多数研究团队望而却步;推理延迟令人抓狂,严重阻碍了在自动驾驶、教育辅助等实时交互场景中的落地。
难道高性能就必须以“巨无霸”的体量为代价吗?微软研究团队用Phi-4-reasoning-vision-15B给出了否定的答案。他们发现,通过极致的架构设计和严苛的数据筛选,一个仅150亿参数的紧凑模型,完全可以在显著减少计算量和token消耗的前提下,达到甚至超越同类模型的性能。
关键就在下面这张图里:
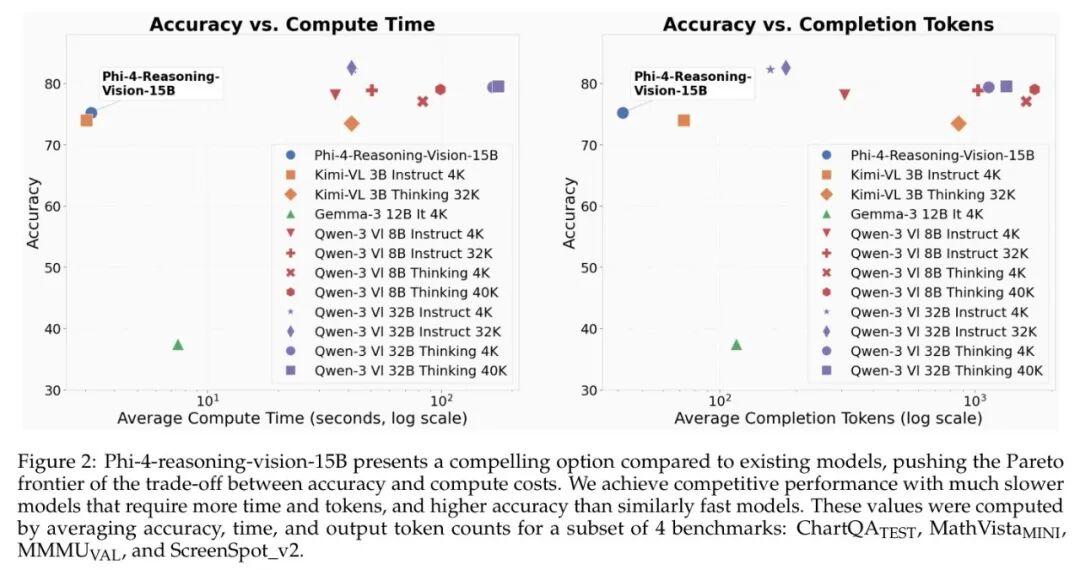
从图中可以清晰看到,Phi-4-reasoning-vision-15B(紫色星星)位于帕累托前沿的有利位置。这意味着,在相同的计算时间或token消耗下,它能提供更高的准确率;而在追求相同准确率时,它的计算成本又显著更低。这个设计直觉,直接颠覆了“大力出奇迹”的粗暴逻辑。
那么,这个“神奇”的小模型,内部到底藏着哪些精妙的设计?
🚀 原理拆解:三大核心创新,铸就“小而快”的基石
Phi-4-reasoning-vision-15B的成功并非偶然,它建立在三个环环相扣的核心设计之上:高效的“中层融合”架构、渐进式的三阶段训练策略,以及开创性的“混合推理”模式。让我们一层层剥开来看。
🏗️ 整体架构:精打细算的“中层融合”
首先,我们来看模型的整体骨架。与计算成本高昂的“早期融合”(将图像块和文本token一起扔进一个巨大Transformer)不同,Phi-4选择了更务实的中层融合 路线。
它的核心思想是:让专业的组件做专业的事,然后在“中间层”进行高效的信息交换。
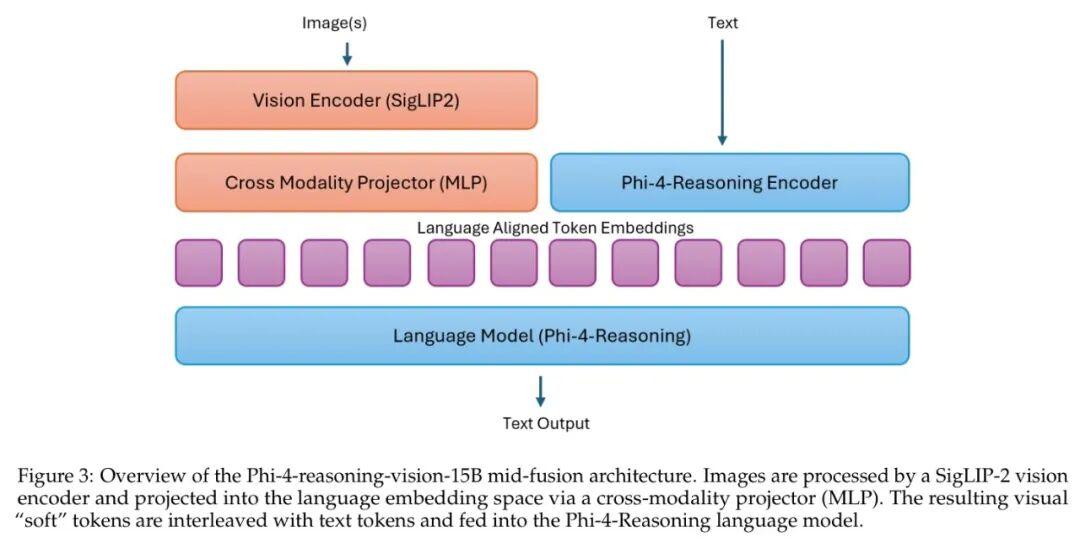
具体流程如下:
- 1. 视觉编码:输入图像由高性能的 SigLIP-2视觉编码器 处理,提取视觉特征。
- 2. 跨模态投影:这些视觉特征通过一个轻量级的 MLP投影器,被映射到语言模型的嵌入空间中,形成“视觉软token”。
- 3. 文本编码:输入文本由强大的 Phi-4-Reasoning语言模型 的编码器处理,得到文本token。
- 4. 融合与推理:视觉软token与文本token交错拼接后,一同送入Phi-4-Reasoning的解码器中进行联合推理,最终生成文本输出。
这种设计巧妙之处在于,它既利用了预训练视觉编码器(SigLIP-2)和语言模型(Phi-4-Reasoning)的已有强大能力,又通过一个可训练的MLP桥梁实现了高效的模态对齐。整个过程中,只有MLP投影器是全新引入并需要从头学习的,极大地降低了训练成本和数据需求。
💡 核心创新一:动态分辨率处理 —— 为“高分辨率”任务而生
一个残酷的现实是:许多多模态模型在数学图表、屏幕截图等需要细粒度感知的任务上折了翼。传统的固定分辨率编码(如384x384)在处理屏幕截图、科学图表等包含密集小目标的图像时,信息严重丢失,导致模型“看不清”,自然无法“想明白”。
为此,团队进行了大规模的消融实验,对比了多种高分辨率处理方案,最终找到了最优解。
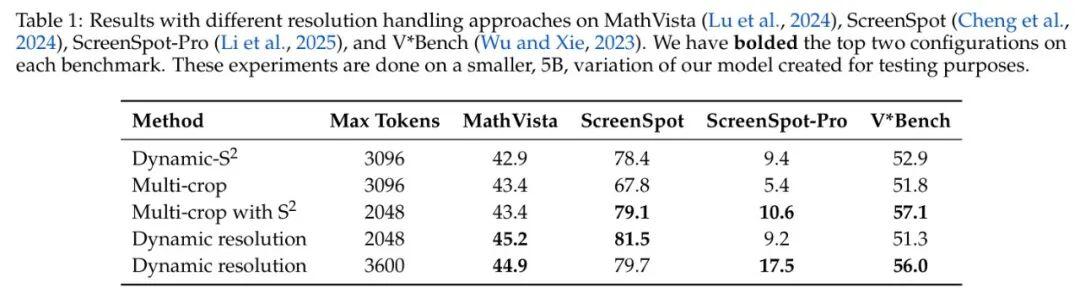
从表1可以清晰地看到:动态分辨率策略在绝大多数任务上表现最佳,尤其是在ScreenSpot(屏幕理解)和V*Bench这类高分辨率任务上优势显著。
这里的“动态”是指视觉编码器(SigLIP-2的NaFlex变体)能够原生支持不同尺寸的输入,并动态调整patch数量。实验表明,将最大视觉token数从2048提升到3600(约对应720p高清分辨率),能在ScreenSpot-Pro上带来显著性能提升。这证明了“看得清”是“推得准”的重要前提,尤其是在GUI导航、文档分析等场景中。
💡 实战思考:这个发现对Agent开发极具启发。要让AI准确点击屏幕上的按钮,首先得让它“看见”按钮。动态高分辨率编码是解决GUI grounding问题的关键技术路径。
💡 核心创新二:三阶段渐进训练 —— 稳扎稳打的养成计划
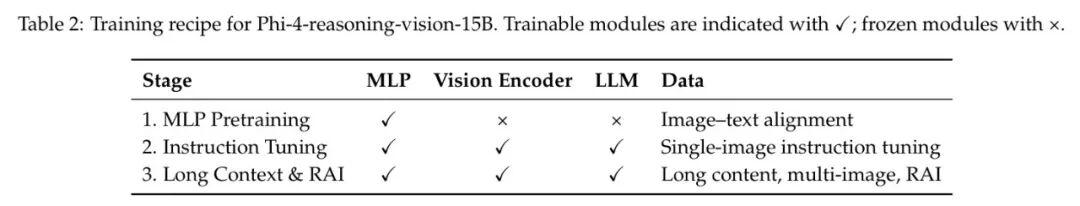
训练一个多模态模型就像组装一台精密仪器,不能把所有零件一次性通电。Phi-4采用了一种渐进解冻、逐步增强的三阶段训练策略,确保学习过程稳定高效。
阶段1:MLP预训练(对齐热身)
- • 目标:在视觉特征空间(SigLIP-2)和语言嵌入空间(Phi-4-Reasoning)之间搭建最初的桥梁。
- • 方法:仅训练MLP投影器,视觉编码器和语言模型全部冻结。
- • 数据:使用少量高质量的图像-文本对齐数据。
- • 直觉:先让“翻译官”(MLP)学会两种“语言”(视觉和文本)的基本对应关系,避免一开始就干扰已经很强大的“专家”(视觉编码器和LLM)。
阶段2:指令微调(全面学习)
- • 目标:让模型掌握全面的多模态任务能力。
- • 方法:解冻所有模块(MLP、视觉编码器、语言模型),进行联合训练。
- • 数据:使用大规模、多样化的单图像指令微调数据,涵盖VQA、数学推理、定位、OCR等所有任务。
- • 关键:本阶段数据混合了推理轨迹和直接响应样本,为下一项创新埋下伏笔。
阶段3:长上下文与安全训练(专项强化)
- • 目标:赋予模型处理长文档、多图像序列的能力,并强化其安全边界。
- • 方法:继续全参数训练。
- • 数据:使用长文档、多图像任务以及专门的负责任AI(RAI)安全数据。
这种由简入繁、从对齐到泛化再到强化的训练课程,是模型在有限数据(仅2000亿多模态token)下实现高效学习的关键。
💡 核心创新三:混合推理与非推理 —— 聪明的“双模式”大脑
这是论文中最具巧思的设计之一。传统的推理模型会对所有问题都进行逐步推理,这在处理“描述这张图片”这类简单感知任务时,纯属浪费算力,增加延迟。
Phi-4-reasoning-vision-15B提出了一个混合模式:让模型自己学会判断,何时该“慢慢想”(推理模式),何时该“快速答”(非推理模式)。
实现机制:
- • 数据层面:在阶段2的训练数据中,约20%是包含完整推理链的样本(用于数学、科学等复杂问题),约80%是以
<nothink>token开头的直接响应样本(用于描述、OCR等简单任务)。 - • 模型层面:由于主干是Phi-4-Reasoning(一个具备强推理能力的LLM),模型本质上拥有推理能力。通过这种混合数据训练,它学会了根据问题类型隐式地切换模式。
- • 可控性:用户也可以通过显式添加
<reason>或<no_reason>指令token来手动控制模式。
带来的好处是巨大的:
- 1. 效率提升:对于简单任务,避免了不必要的推理开销,响应速度更快。
- 2. 准确性保障:对于复杂任务,仍然能调用强大的逐步推理能力保证答案正确。
- 3. 单一模型:无需维护“快速版”和“思考版”两个模型,部署更简单。
这个设计完美呼应了开篇的效率追求,让模型成为一个“能省则省,该花则花”的智能计算体。
你在部署AI应用时,是否也为响应速度和复杂任务精度难以兼得而头疼?这个双模式设计是否给了你新的思路?欢迎在评论区聊聊你的看法~
📊 实验验证:数据不说谎,小身材也有大能量
理论再美妙,也需要实验的检验。Phi-4-reasoning-vision-15B在多项标准基准测试中,与当前主流开源模型进行了硬碰硬的对比。
🏆 SOTA对比:以小搏大,不落下风
首先看它在常规多模态理解任务上的表现。表5对比了主流非推理开源模型。
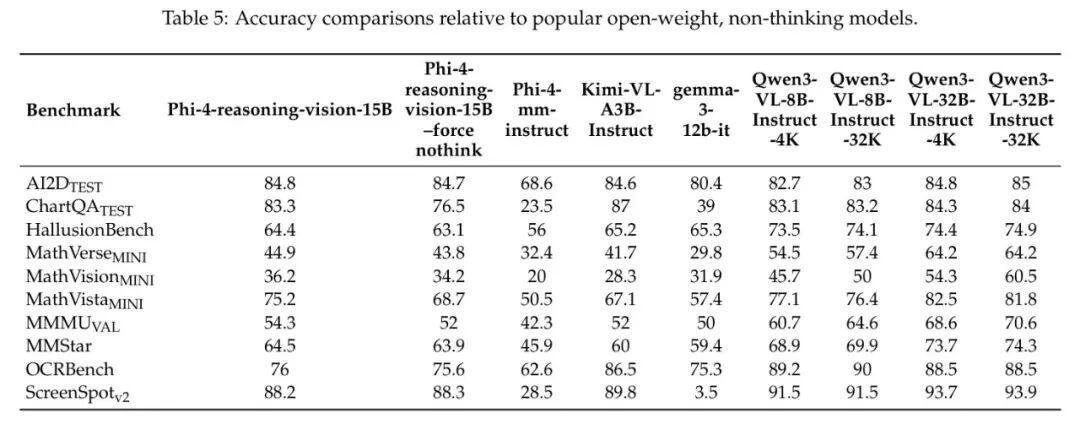
虽然Qwen3-VL-32B凭借其巨大参数量在多数任务上领先,但Phi-4-reasoning-vision-15B作为一个小得多的模型,在AI2D、HallusionBench、MathVerseMINI等多个任务上表现极具竞争力。考虑到其训练数据量(200B token)远少于对手(>1T token),这个成绩含金量十足。
更重要的是在推理模型的对比中(表6),Phi-4的混合模式展现出了独特价值。
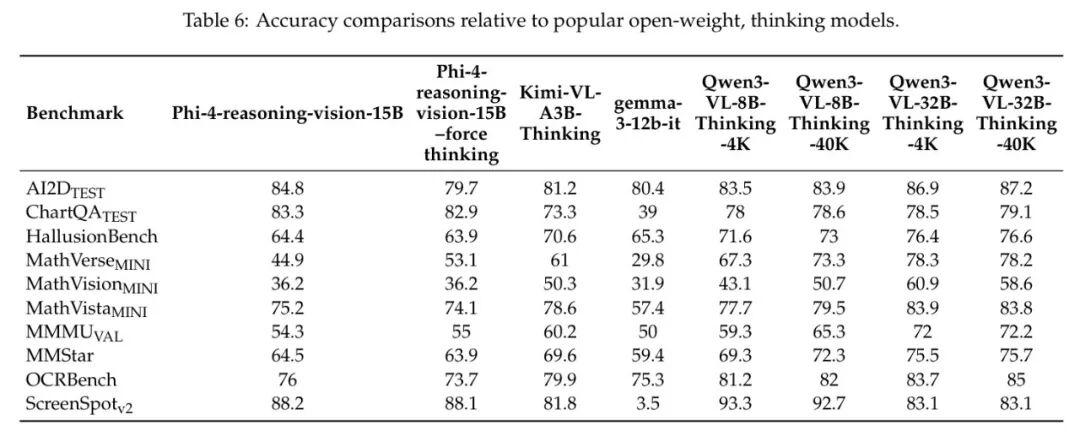
在MathVista、MMMU等需要深度推理的任务上,Phi-4-reasoning-vision-15B与专为推理设计的Kimi-VL-A3B-Thinking、Qwen3-VL-Thinking等模型同台竞技,表现依然可圈可点。这证明了其从Phi-4-Reasoning继承的推理能力,在视觉语境下得到了有效迁移和发挥。
🔬 消融实验:每一个设计都贡献了力量
“混合模式”中推理与非推理数据的比例如何确定?更多数学数据会不会损害计算机视觉能力?这些都需要消融实验来验证。
实验一:数据配比的艺术
团队调整了数学和计算机使用(CUA)数据的比例,观察模型性能变化。
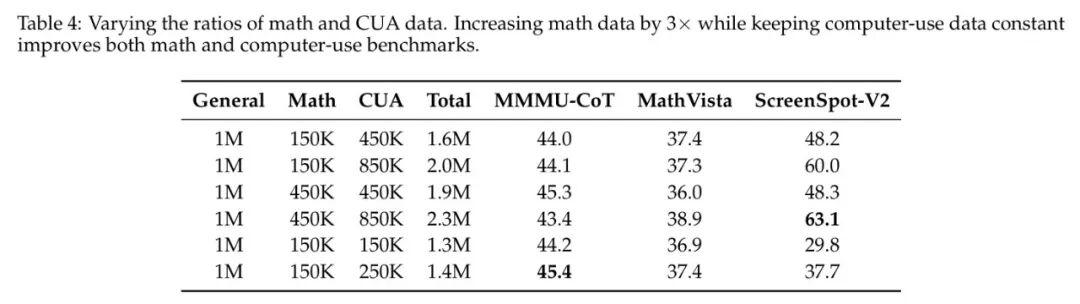
结论令人振奋:增加数学数据(从150K到450K),不仅提升了数学推理任务(MMMU-CoT)的性能,连带计算机使用任务(ScreenSpot-V2)的性能也大幅提升! 这打破了“不同任务数据会相互干扰”的刻板印象,表明高质量的数学推理数据有助于培养模型更一般的逻辑泛化能力,这对所有任务都有益。
实验二:动态分辨率的威力
这一点我们在核心创新部分已结合表1详细阐述,动态分辨率策略被证明是提升高分辨率任务性能的关键。
⚖️ 客观评价与未来展望
当然,Phi-4-reasoning-vision-15B并非完美。报告也诚实地指出了其局限:
- • 模式切换不总是最优:模型自学习的切换策略有时会出错,好在用户可以通过指令手动控制。
- • 极致细节理解有上限:对于需要像素级分析的极端任务,小模型的能力仍有边界。
- • 对比超大模型:在非常宽泛、无限制的基准上,千亿级参数的专有模型仍有综合优势。
但它的核心价值在于,为“高效率、低成本的多模态AI”提供了一个极其优秀的开源范本和可复现的路径。它证明,通过架构创新(中层融合+动态分辨率)、训练策略创新(三阶段渐进)和任务范式创新(混合推理) 的组合拳,小模型完全可以挑战大模型的性能,并在效率上实现碾压。
🌟 价值升华与行动号召
回顾全文,Phi-4-reasoning-vision-15B给我们带来的启示远超一个模型本身:
- 1. 效率优先的设计哲学:在盲目堆料之前,先思考如何让每一分计算资源都发挥最大价值。动态分辨率、混合推理都是这种思想的产物。
- 2. 数据质量重于数量:用2000亿token达到别人万亿token的效果,核心在于极致的清洗、修正和合成增强。数据工程的价值再次被凸显。
- 3. 模块化与继承:充分利用预训练组件的优势(SigLIP-2, Phi-4-Reasoning),通过精巧的适配器(MLP)和训练策略快速构建强大模型,是未来AI开发的高效范式。
- 4. 一个模型,两种模式:混合推理设计在实用性与智能性之间找到了优雅的平衡点,为AI产品的体验优化提供了新思路。
从写旅行博客、解析账单,到理解科学图表、定位屏幕元素,Phi-4-reasoning-vision-15B展示了紧凑型多模态AI触手可及的未来。
🤔 深度思考:你认为这种“小而快”的混合推理模型,最可能率先在哪个场景大规模落地?是教育领域的实时解题助手,还是办公场景的自动化流程Agent?欢迎在评论区留下你的高见!
💝 支持原创:如果这篇近5000字的深度解析让你对高效多模态AI有了新的认识,点赞+在看就是对我最大的鼓励!也欢迎分享给你身边正在研究模型压缩和部署的朋友们。
🔔 关注提醒:想第一时间获取更多顶尖AI论文的硬核解读?别错过接下来的更新!
#AI技术 #深度学习 #模型优化 #多模态AI #论文解读 #微软 #Phi4
参考
Phi-4-reasoning-vision-15B Technical Report
引用链接
[1]: https://aka.ms/Phi-4-reasoning-vision[2]: https://github.com/microsoft/Phi-4-reasoning-vision-15B