ArchetypeTrader:基于强化学习的加密货币交易策略框架
“ArchetypeTrader: Reinforcement Learning for Selecting and Refining Learnable Strategic Archetypes in Quantitative Trading”
强化学习(RL)因能处理高维数据和解决复杂决策问题,在量化交易领域有应用前景。但现有方法有两大缺陷:一是用手工指标分割市场,简化市场动态,忽略细微机会;二是未系统利用示范数据,易致高方差和大利润回撤。
本文提出ArchetypeTrader,一种用于自动加密货币交易的新型强化学习框架。它通过向量量化编解码器从动态规划生成的演示中发现战略原型,由水平层强化学习代理根据市场上下文选择最佳原型,步长层适配器通过后悔感知更新细化原型动作。在四种主要加密货币对上的实验表明,ArchetypeTrader在盈利方面持续优于多个先进交易算法,且具备出色的风险管理能力。
【 扫描文末二维码加入星球获取论文 】
摘要
量化交易借助数学模型和自动执行做交易决策,在金融市场广泛应用,强化学习(RL)用于加密货币交易有前景,但现有方法有两大缺陷:一是用手工指标分割市场,简化市场动态,忽略细微机会;二是未系统利用示范数据,易致高方差和大利润回撤。
本文提出ArchetypeTrader框架,分三步:1. 用动态规划生成专家轨迹,训练VQ编码器 - 解码器提取交易原型;2. 训练RL代理从代码本选原型重建动作序列;3. 训练策略适配器,利用后视奖励动态优化原型动作。实验表明该框架在盈利和风险管理上超现有方法。
简介
全球金融市场容量超90万亿美元,量化交易受关注,强化学习(RL)因能处理高维数据和解决复杂决策问题而有前景,可让交易代理从市场互动中学习策略,在波动市场有效。但现有RL算法有不足:一是将金融市场视为同质稳定过程,或用人工指标划分市场状态,导致策略在波动资产上表现差,且忽略细微盈利机会;二是未能有效利用示范数据,易引入噪声或偏差,导致高方差和次优表现。
为应对挑战,提出ArchetypeTrader这一新型强化学习框架,通过三阶段运作:1. 动态规划生成示范轨迹,用向量量化编码器 - 解码器压缩成交易原型码本;2. 训练强化学习驱动的原型选择器,为当前市场选择合适原型;3. 用逐步策略适配器根据市场观测和表现优化所选原型动作,兼顾盈利与最小化遗憾。
本文主要贡献在于:
1. 无人工启发式发现可复用交易原型;
2. 设计两层控制方案,提供盈利且稳健策略;
3. 对4种加密货币实验显示,ArchetypeTrader在盈利和风险管理指标上远超基线。
相关工作
传统方法
经典技术分析认为价格-成交量模式可预示未来走势,催生众多手工指标,如订单流失衡、MACD 等。但在高度非平稳的加密货币市场,这些信号常嘈杂且具误导性。
强化学习方法
早期将DQN、PPO等算法应用于金融市场,后续变体改进稳定性或表征能力,如CDQNRP、CLSTM-PPO,但这些静态策略在高波动市场表现不佳。近期方法用手工指标分离数据,采用分层强化学习(HRL),如EarnHFT、MacroHFT,但依赖人工标签有偏差,且无法利用事后演示,收益不稳定、欠佳。
问题建模
先介绍加密货币交易的关键金融概念与基本MDP公式,再对比当前强化学习交易方法,指出其核心局限,引出对更稳健解决方案的探索。
MDP建模
市场观测:包含 M 级限价订单簿 b_t、OHLCV 柱 x_t 及基于回溯窗口 w 计算的技术指标 y_t。
持仓:资产数量 P_t 有短、平、长三种状态。
执行损失:执行持仓变化 ΔP_t 会产生损失 O_t。
净值:V_t 为现金与加密货币市值之和。
MDP 模型:状态 s_t 为市场观测,动作 a_t 设定目标持仓 P_t,转移 T 随市场变化,奖励 R 为净值差 r_t_step,γ 为折扣因子。目标是找到最优策略 π* 最大化期望折扣回报 J。
问题分析
现有方法(Qin等2023;Zong等2024)通过高级策略选特定制度子策略应对加密货币市场非平稳和高波动性,但面临两障碍:一是人为设定的制度标签(如牛市/熊市)简化动态,使代理趋于僵化追趋势;二是示范要么被忽视,要么使用方式引入噪声(如“最优”DP轨迹或手工规则)。因此,无人工干预、系统且过滤噪声地利用示范仍是待解决问题。
ArchetypeTrader
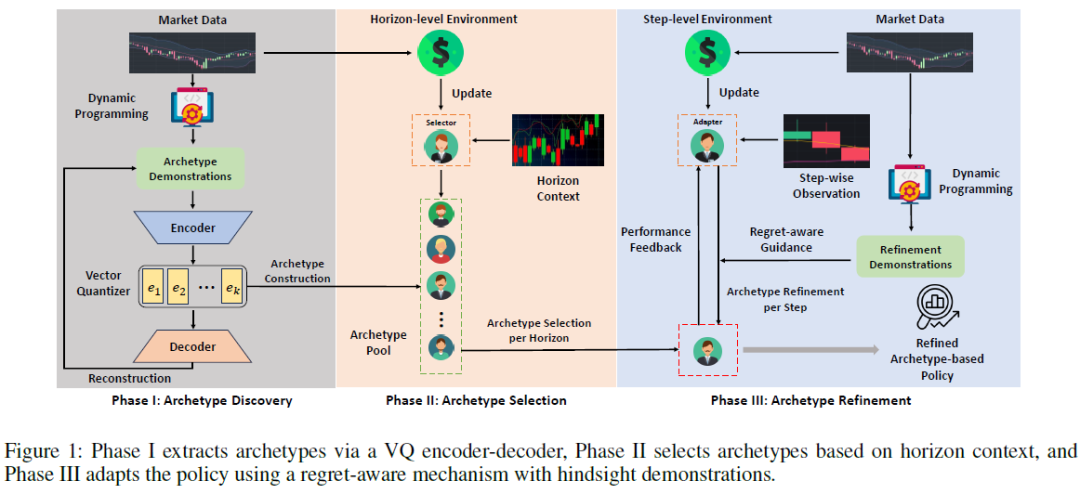
为克服人工分割与示范利用不足问题,提出ArchetypeTrader分层框架,含三阶段:1. 用DP规划器生成示范轨迹,VQ编解码器将其压缩为捕捉关键交易行为的原型集;2. 水平层强化学习智能体选最适配当前市场特征的原型;3. 步骤层策略适配器根据实时市场观测和中期表现优化原型基础动作,确保波动环境下的稳健与灵活。
原型发现
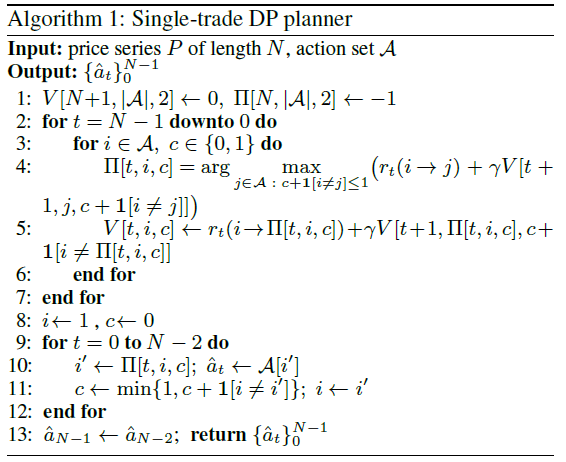
提出自监督学习管道,直接从高质量交易轨迹提取紧凑且可复用的交易原型,摆脱人工设计和启发式方法依赖。具体做法:从训练集采样固定长度为 h 的 n 个数据块,用 DP 规划器为每个数据块确定盈利交易动作,每个数据块仅进行一次交易以突出重要机会、减少噪声。DP 规划器根据市场观测输出演示动作序列,每个序列仅一次交易,执行动作得到奖励序列,将演示轨迹收集成元组并编成数据集,作为原型提取的训练基础。
为将演示轨迹提炼为代表性交易原型,采用编码器-解码器框架,但连续表示存在问题,故引入 VQ 模块。实践中,演示轨迹经 LSTM 编码器生成连续嵌入 z_e,通过从可学习码本 ε 选最近项量化为离散潜在表示 z_q,再由解码器根据状态和量化嵌入重构原始动作。训练时最小化组合损失函数 L,使码本向量学习捕捉可复用交易模式,后续可基于市场观察选原型并解码成具体动作序列,作为交易策略部署。
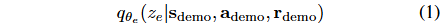
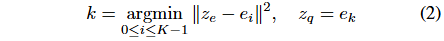
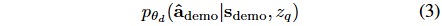
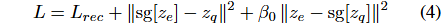
原型选择
为将战略原型应用于交易,训练基于强化学习(RL)的原型选择器,依据市场观测选最优原型并执行解码后的微观动作。将基本马尔可夫决策过程(MDP)提升为水平级 MDP (M_{sel}),状态 (s_{sel}) 为水平起始时刻状态向量,动作 (a_{sel}) 为从原型集选原型,选好后将原型代码输入解码器生成后续 (h) 步微观动作。以水平内逐步骤奖励之和为原型选择奖励函数 (r_{t}^{sel}),优化策略 (\pi_{\phi}) 最大化期望回报并兼顾与示范轨迹的一致性,定义目标函数(公式 (5)),其中 (r_{t}^{sel}) 是水平内累积回报,(\hat{a}_{sel}^{t}) 是示范块的真实原型标签,(\alpha) 平衡环境奖励与 KL 散度惩罚。
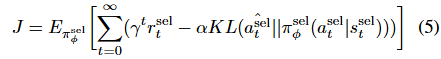
原型细化
水平层选择原型虽能提供连贯交易计划,但市场条件变化或原型选择不佳时存在局限:无法应对短期变化、选错原型会致全程表现欠佳。
提出步级原型细化方法,用策略适配器结合市场观察和部分原型表现微调原型基础动作。
每个水平层H冻结选择策略,解码对应微观动作序列,将原型细化过程构造成步级MDP。
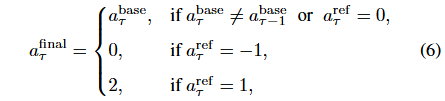
适配器观察实时状态生成细化信号,调整原型基础动作且不覆盖原交易,细化策略训练时每个水平层最多覆盖一次。
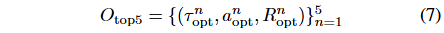
为聚焦有意义调整,计算前5个事后最优调整,引入后悔感知奖励函数,平衡相对基础策略的盈利调整和与最佳调整的差距。
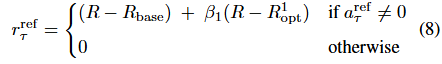
每个水平层仅允许一次调整,适配器选非零动作时强化学习情节终止,给出训练细化策略的目标函数。
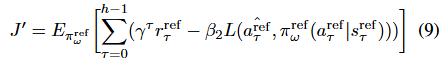
实验
数据集
用BTC/ETH/DOT/BNB对USDT的10分钟、订单簿深度M = 25的数据评估方法有效性,数据集2021-06-01至2023-05-31用于训练,2023-06-01至2023-12-31用于验证,2024-01-01至2024-09-01用于测试。
评估指标
从 6 个金融指标评估,包括 1 个盈利、2 个风险、3 个风险调整后盈利指标:
总回报(TR):整个交易期总体回报率,TR = (VT - V1) / V1(VT 为期末净值,V1 为期初净值)。
年化波动率(AVOL):一年回报变化,AVOL = σ[r] × √m(r 为回报,σ 为标准差,m = 52560 为时间步数)。
最大回撤(MDD):衡量从峰值最大损失,体现最坏情况。
年化夏普比率(ASR):衡量单位额外风险的额外回报,ASR = E[r] / (σ[r] × √m)。
年化卡尔玛比率(ACR):风险调整后回报,ACR = E[r] × √m / MDD。
年化索提诺比率(ASoR):用下行偏差(DD)衡量风险,ASoR = E[r] / (√DD × √m) 。
基线
为对方法进行基准测试,选取 8 个基线,涵盖标准强化学习(DQN、PPO、CDQNRP、CLSTM-PPO)、分层强化学习(EarnHFT、MacroHFT)及基于规则的策略(IV、MACD)。
实验设置
实验在 4 个 RTX - 4090 GPU 上进行,交易佣金 δ = 0.02%,不同资产有不同最大持仓量。进行原型发现,采样 30k 个 DP 轨迹(h = 72),训练 128 单元 VQ 编解码器(向量维度 16,K = 10,β0 = 0.25)100 个 epoch。原型选择时,优化 RL 选择器 300 万步并保留最佳验证性能的检查点。原型精炼中,训练遗憾感知适配器 100 万步,β2 = 1,β1 按资产调整(BTC/DOT 为 0.5,ETH/BNB 为 0.7)。所有 DP 模块仅用于训练,推理时禁用以防信息泄露。
结果分析
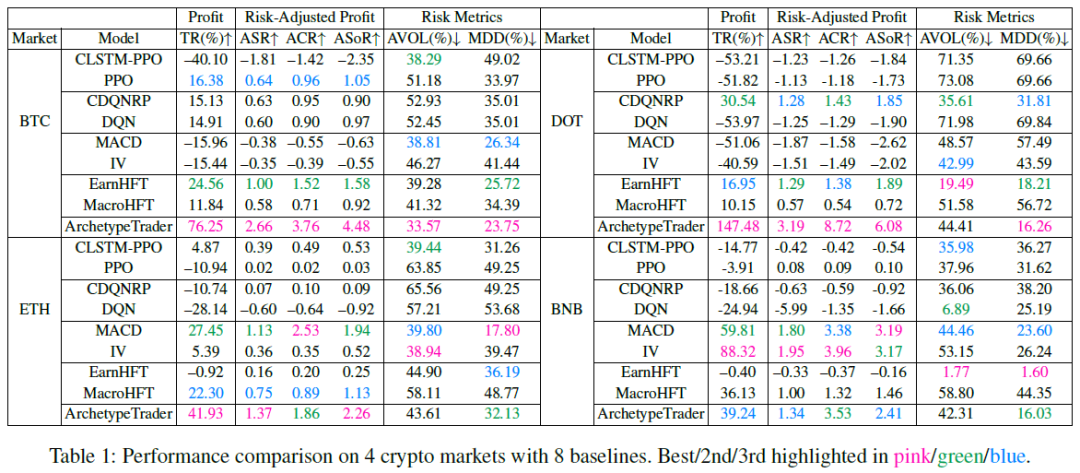
表1展示ArchetypeTrader与基线方法在四个加密货币市场的表现。ArchetypeTrader除BNBUSDT外,在各市场均获最高利润和最佳风险调整回报,在BNB市场也有竞争力。基于统一策略的强化学习方法难适应市场变化,利润不稳定;基于规则的方法在特定数据集表现尚可,但缺乏鲁棒性;分层强化学习方法回报较稳定,但子策略有局限。ArchetypeTrader直接从示范数据中发现和完善原型,交易行为更广泛灵活,风险管理佳、盈利能力强。
原型的可解释性分析
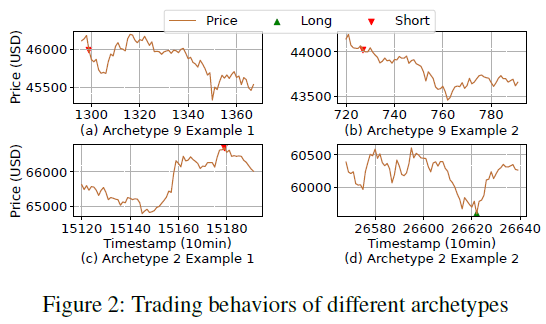
为证明数据驱动的原型能捕捉超越标准手工分割的专家行为,在BTCUSDT上可视化所选原型的交易信号。如原型9呈现“卖空并持有”策略,适用于熊市,市场下跌时可能被选;原型2倾向在局部峰值卖空、谷底做多,捕捉价格反转,是典型的反向或均值回归风格,虽非重复相同操作,但有一致的均值回归效果。这些原型保留了直观且专业的交易行为,而非遵循固定趋势。
消融分析
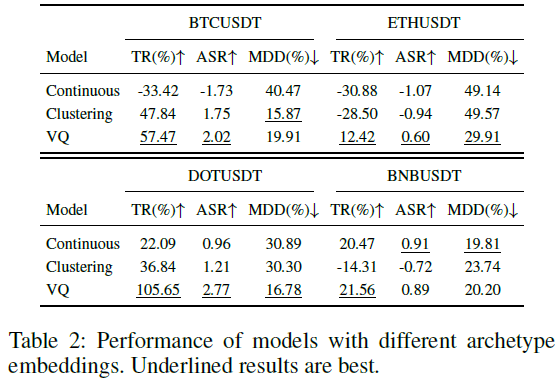
对比三种原型嵌入方法(连续嵌入、聚类嵌入、向量量化离散嵌入),结果显示离散 VQ 嵌入回报更高、风险管理更好。
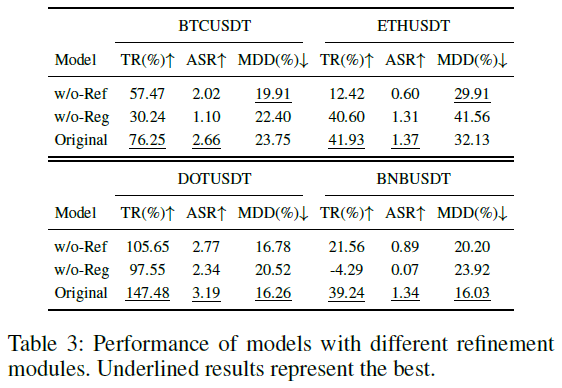
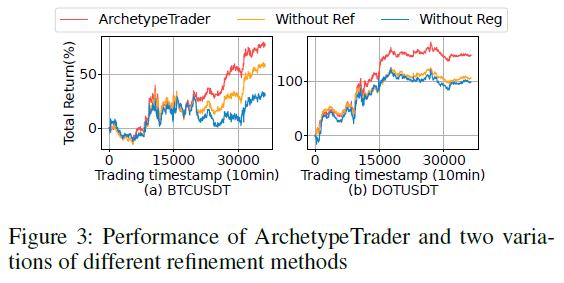
对比三种细化方法(无细化、无后悔细化、有后悔细化),发现政策适配器细化可捕捉交易机会、纠正执行问题,加入事后后悔惩罚能确保在最有价值时刻细化,后悔引导对干预很关键。
超参数敏感度
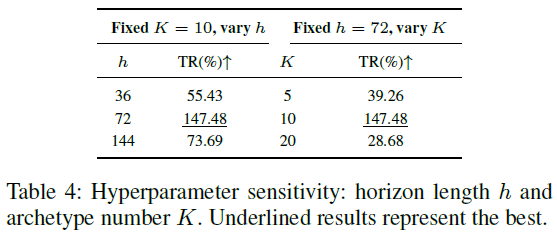
评估超参数对DOTUSDT数据集性能的影响。码本过小无法充分代表交易模式,过大则使选择器和适配器负担过重;预测期过短会引发频繁噪声驱动的变动,过长则延迟更新、降低响应性。K和h取中间值可在表达能力和灵活性间取得最佳平衡。
总结
本文提出ArchetypeTrader,一种用于自动加密货币交易的新型强化学习框架。它通过向量量化编解码器从动态规划生成的演示中发现战略原型,由水平层强化学习代理根据市场上下文选择最佳原型,步长层适配器通过后悔感知更新细化原型动作。在四种主要加密货币对上的实验表明,ArchetypeTrader在盈利方面持续优于多个先进交易算法,且具备出色的风险管理能力。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
