Skill让计算消耗暴降80%!SkillCraft基准揭示越强模型越能降本增效
赋予AI像人类一样沉淀和复用Skill的能力,能让其在处理复杂任务时的计算消耗暴降80%。
牛津大学联合多所顶尖高校与研究机构推出了一个全新的基准测试SkillCraft。
旨在考察智能体能否自主组合基础工具形成可复用的Skill。
实验数据印证,越强的模型越能降本增效,它们能通过复用高质量Skill大幅提升运行效率,并维持极高的任务成功率。
同时还揭示了盲目追求复杂的Skill嵌套往往适得其反。
告别笨拙的工具调用
真实世界中的工具调用场景通常伴随着长周期的工作流,而且里面充满了重复的子任务结构。
比如在处理文档、分析代码仓库或者调用网络服务时,搜索数据、分析内容、总结提取这样的一套固定动作会被反复执行。
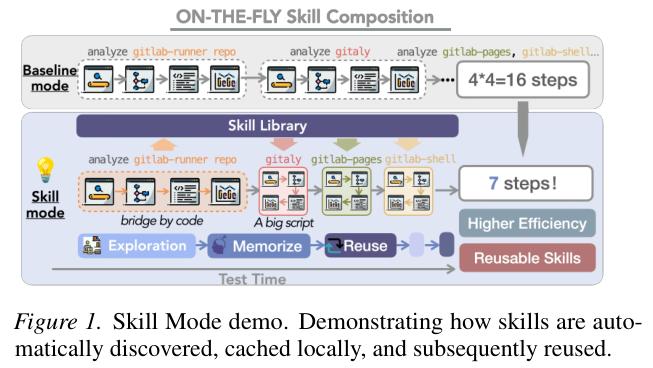
在认知科学领域,这种重复性正是Skill抽象的起源,人类的智慧不体现在机械地重复孤立动作上,我们更擅长从过往的经验中获取灵感,把零散的操作打包成高阶的标准化流程。
目前的智能体在面对长周期任务时,往往只会像一个不知疲倦但有些刻板的新手,针对每一个细分需求去单次调用底层工具。
这种机械的运行方式暴露出两个极其消耗资源的弊端。
冗余的状态传递让智能体在连续的工具调用之间反复处理中间结果,无形中浪费了海量的计算资源。
上下文窗口饱和也是一个令人头疼的难题,冗长的工具调用记录和返回结果会迅速塞满模型的记忆空间,让模型在执行到一半时遗忘最初的目标或者丢失关键线索。
为了精准测量智能体是否具备摆脱这种机械劳动的能力,研究人员精心打造了名为SkillCraft的测试基准。
现有的测试平台大多采用固定的工具集来考验模型能否完成单次任务,很难考察模型沉淀复用能力的深浅。
SkillCraft则将重复的子结构巧妙地嵌入到单个长周期任务中,强迫智能体在有限的资源预算下,必须学会从繁杂的原子工具操作中识别出规律,将其组合成可以重复使用的Skill代码。
构建这个庞大而精密的测试平台并非易事,研究团队设计了严谨的三阶段流水线。
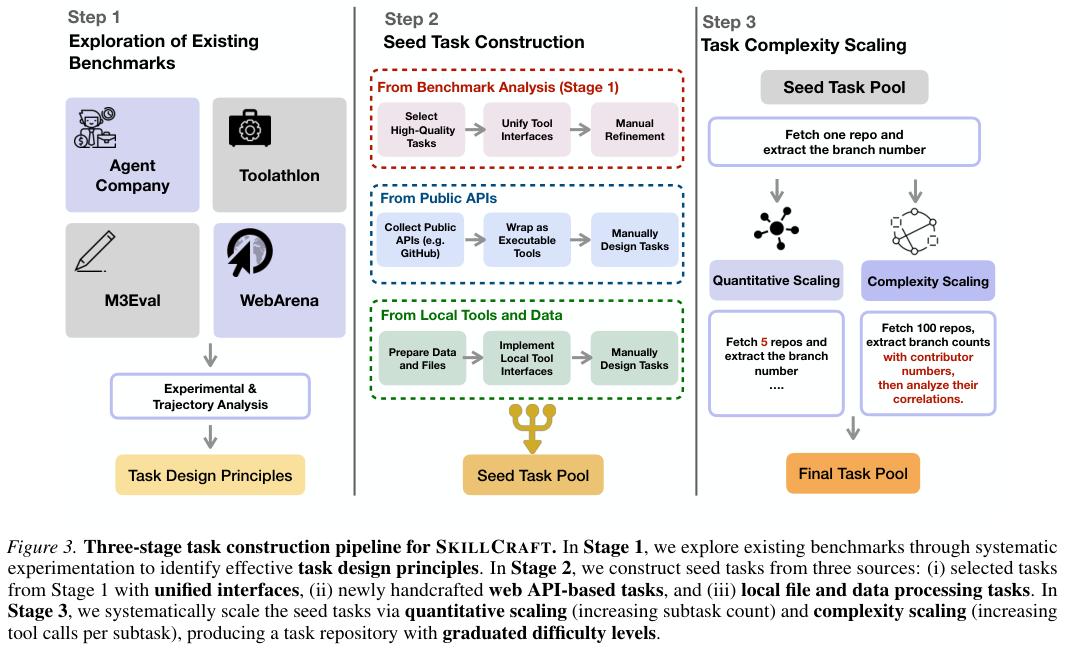
探索阶段对现有的多个前沿平台进行了海量测试,摸清了稳定可靠的接口和任务类型。
种子任务创建阶段则将目光锁定在极其稳定的公共接口和本地数据上,手工打造了涵盖天气预测、影视数据抓取、代码托管平台分析等真实场景的基准库。
系统性缩放阶段将任务难度沿着两个垂直方向拉升,数量缩放要求智能体处理更多的实体目标,例如从分析一个代码仓库的提交记录变为分析一百个,复杂性缩放则在单次操作中加入更多的工具调用环节。
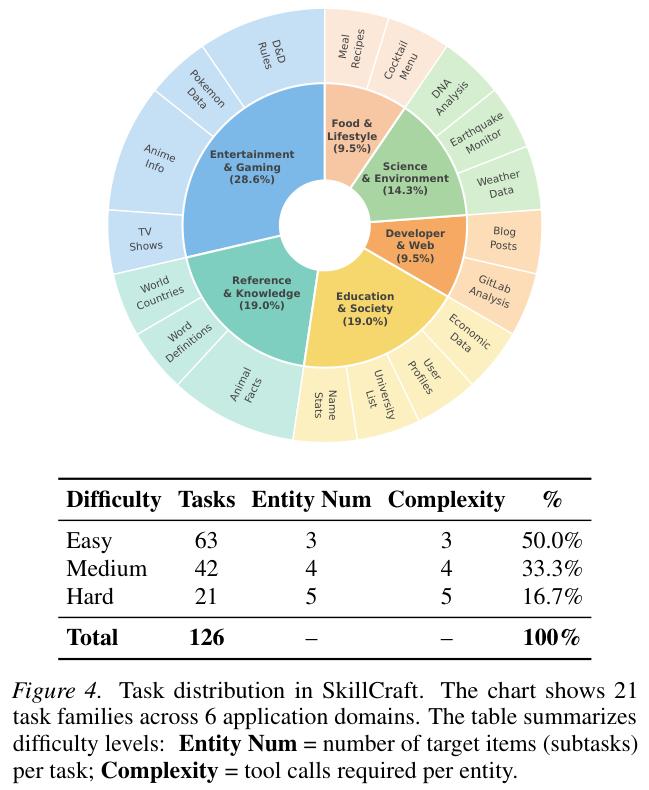
最终落地的SkillCraft测试基准包含了126个极具挑战性的任务,跨越了6个各具特色的应用领域,细分出6个难度等级。
从游戏动漫数据的提取到自然科学数据的追踪分析,从基础的3个实体调用到复杂的5次嵌套组合,海量的测试数据为评估大模型的真实进化水平提供了坚实的试炼场。
表1详细记录了这三个阶段的演进历程与任务数量分布,展现了从原始构想到庞大任务库的搭建细节。
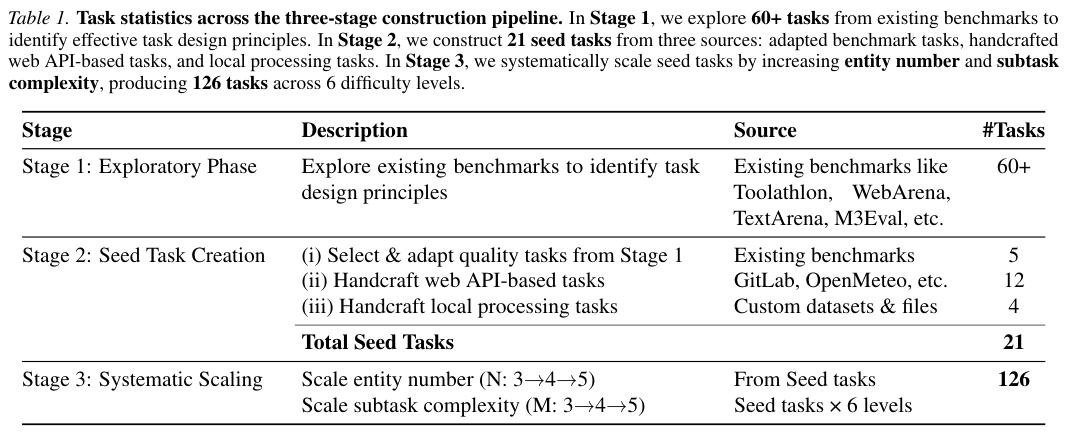
图4则直观呈现了这126个任务在不同维度的比例划分,其中简单难度占据了一半,中等和困难难度构成了对高级智能体的终极考验。
聪明大模型更懂降本增效
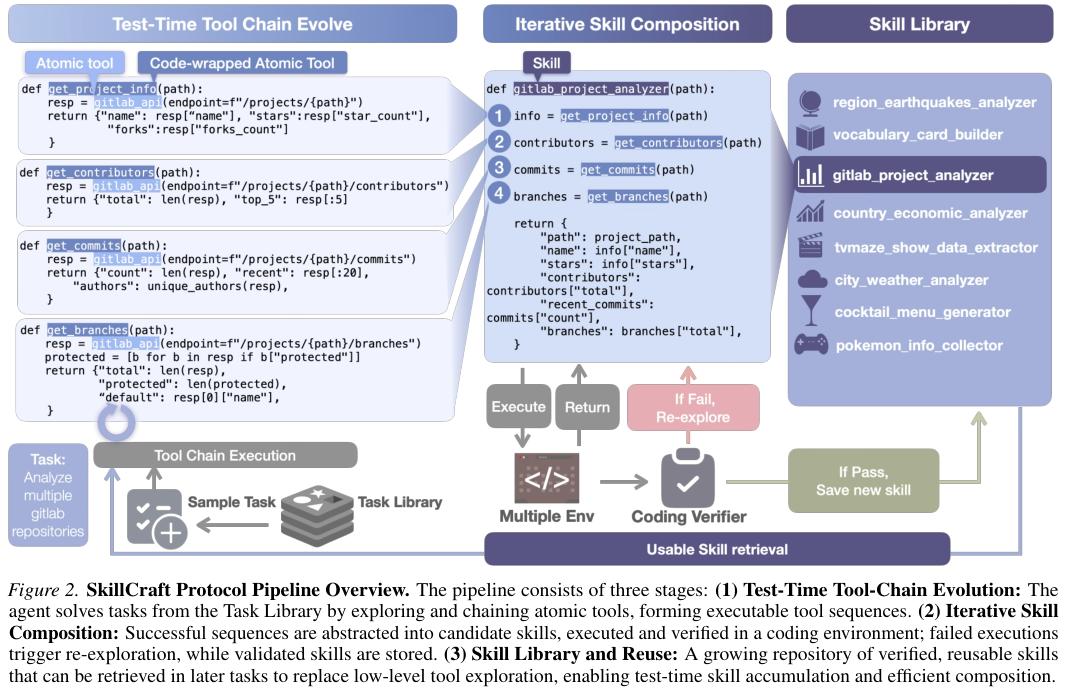
为了让大语言模型真正掌握组合工具的艺术,研究人员引入了一套轻量级的Skill模式评估协议。
这套协议基于MCP打造,仅仅对外暴露四个极其精简的指令操作。
保存Skill(save_skill)负责将跑通的成功工作流固化在本地,获取Skill(get_skill)用来读取历史代码和相关元数据,列出Skill(list_skills)帮助模型在面对新任务时翻阅已经学会的招式库,执行Skill(execute_skill)则直接把固化好的代码当作一个高级工具来运行。
在这套流水线下,模型面对一个新任务时会优先查阅现有的Skill库,试图找到能直接套用的现成Skill。
只有在找不到合适Skill或者执行失败的情况下,模型才会老老实实地去探索底层基础工具,一步步摸索出通关路径。
一旦这条原始的工具链成功解决问题,模型就会将其抽象提炼成一段参数化的候选代码Skill,用代码变量代替原本冗长的自然语言来传递中间结果。
将粗糙的代码直接存入Skill库有着极高的风险,研究人员为此设置了极其严苛的代码验证官机制。
进入Skill库前,候选代码必须经历三道关卡。语法验证阶段会直接拦截那些格式错乱、拼写有误的基础废品,并把错误信号反馈给模型。
运行时错误报告阶段会捕获执行崩溃的具体原因,将异常信息和追踪栈原封不动地交还给智能体,帮助其精准定位是语法问题还是参数匹配失误。
执行后质量检测阶段则是为了防范那些默默失效的伪劣代码,如果产出的数据中有超过一半是未知或者空值,这段代码就会被立刻打回重造。
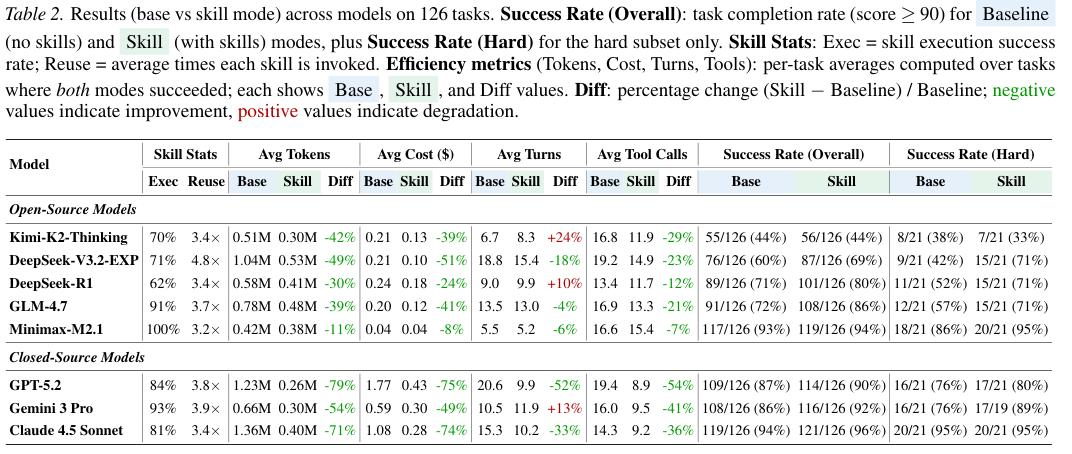
实测数据展示了极其惊艳的成效。在涵盖了多个开源和闭源顶尖模型的全面评测中,Skill模式为几乎所有参赛选手带来了立竿见影的减负效果。
表2完整收录了这些模型在基础模式与Skill模式下的各项关键指标对比。
强大的模型在掌握这项绝技后展现出了压倒性的优势。
以GPT-5.2为例,在开启Skill模式后,其任务成功率不仅从87%稳步攀升到了90%,单次任务的平均消耗更是出现了断崖式下跌,从惊人的123万暴降至26万,节省了高达79%的计算资源,平均成本也同步锐减75%。
Claude 4.5 Sonnet同样表现不俗,不仅将本就极高的94%成功率进一步推高到96%,更一举砍掉了71%的计算消耗。
部分开源模型在这场测验中则暴露出了一些深层能力上的短板。
例如Minimax-M2.1虽然拥有完美的Skill执行成功率,但其整体计算节省幅度仅有可怜的11%,原因在于它在面对许多任务时,依旧选择用最原始的方法硬啃,未能敏锐察觉到调用Skill捷径的时机。
图5的交叉指标相关性热力图揭示了一个有趣的真相。
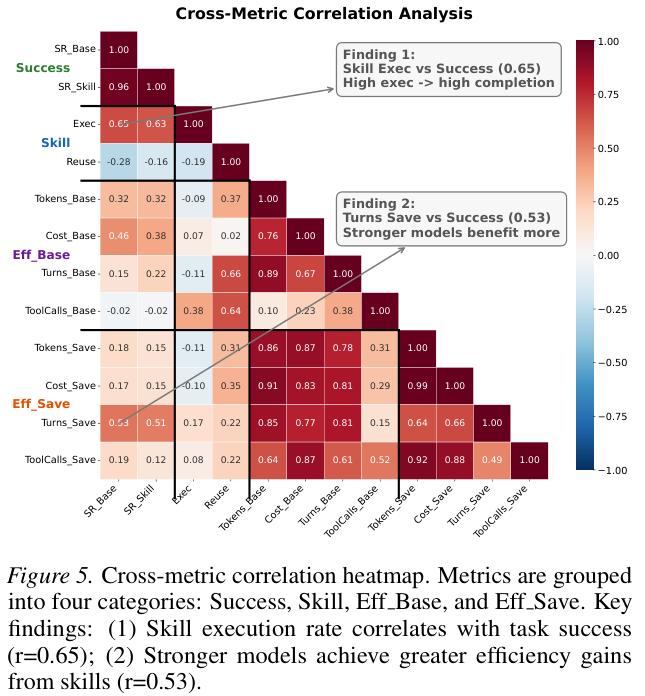
Skill的执行成功率与最终的任务成功率呈现出高度正相关,关联度达到了0.65,证明了编写和执行高质量代码的能力是决定智能体能否成功闯关的核心底座。
同时,计算资源的节省幅度与模型原本的基础成功率同样紧密相连,关联度达到0.53,彻底印证了越强的模型越懂得如何降本增效,它们能够更灵活地抽象出正确的逻辑并在后续任务中精准复用。
越简单反而越好用
当模型学会了把基础操作打包成Skill后,一个自然而然的猜想浮出水面,如果我们允许模型把这些初步打包好的Skill当作积木,继续拼接组合成更加宏大深邃的高阶Skill,是不是就能带来指数级别的效率飞跃。
为了验证这个看似无懈可击的理论,研究人员解锁了层级模式。
在这个模式下,调用工具的接口被彻底解开封印,模型不仅能触发底层工具,还能直接唤醒之前封存的各类子Skill,理论上可以一直嵌套到10层深度。
图6详细拆解了这种层级结构的理想状态。
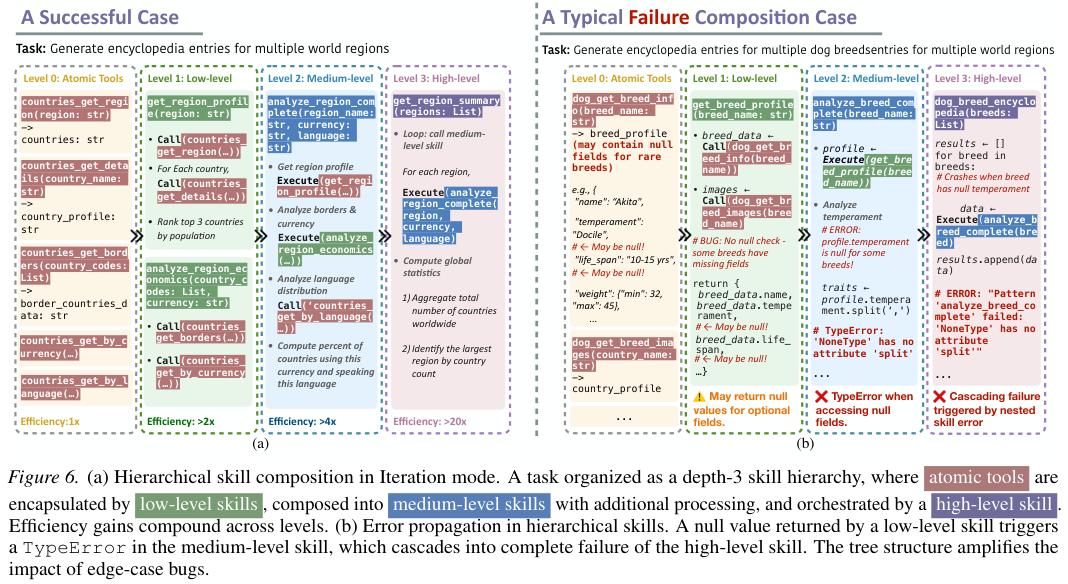
以生成全球犬种百科全书为例,底层Skill专门负责抓取单一犬种的基础档案,中层Skill将底层抓取的数据进行清洗和专业分析,顶层Skill则化身为总指挥,通过循环调用中层Skill,最终汇编出一部完整的百科词典。
然而现实往往比理论更加残酷,层级模式在实测中遭遇了意想不到的滑铁卢。
表3清晰地展示了这一反直觉的结果。
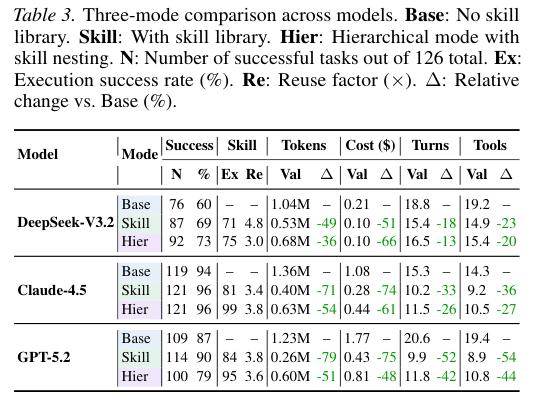
即便强大如GPT-5.2,在从扁平的单一Skill模式切换到层级嵌套模式后,整体成功率不升反降,直接从90%跌落至79%,节省下来的计算资源也大打折扣,从26万回弹到了60万。
图6的右侧部分精准地剖析了导致这场溃败的致命元凶。
由于Skill层层嵌套,一旦底层结构出现极微小的瑕疵,灾难就会沿着逻辑树向上疯狂蔓延。
在获取犬种数据的底层Skill中,模型没有对某些罕见犬种缺失的性格字段做空值校验。
这个看似无关痛痒的漏洞在底层执行时安静蛰伏,当数据传递给中层Skill进行文本切割分析时,由于获取到的是空值,直接引发了类型错误崩溃。
这个异常瞬间向上传导,导致正在满负荷运转的顶层百科汇编Skill彻底宕机,前功尽弃。
层级嵌套犹如在沙丘上建高塔,底层的隐患在复用中被成倍放大,而排查这种嵌套错误的成本更是高得令人咋舌,往往需要模型一层层剥开代码追踪溯源,消耗的精力远超直接用最笨的方法重新执行一遍。
这些冷冰冰的教训为后来的开发者敲响了警钟,经过充分测试且结构扁平的浅层Skill库,在当前阶段远比那些自动生成的复杂层级网络要可靠和实用得多。
好Skill跨界也吃香
评价一项Skill是否有价值,关键在于它能否跨越原本的任务边界去解决新问题。
如果模型写出的代码只能应付特定的题目,那充其量只是记住了标准答案,真正高价值的Skill应该具备提炼通用解决流程的能力,不管题目怎么变都能游刃有余。
为了摸清这些Skill的通用性底细,研究团队设计了一场跨难度大考。
他们先让模型在某个难度级别里闭关修炼,把跑通的成熟Skill统一打包存入缓存。
随后开启第二阶段,把这份热腾腾的Skill包裹直接塞给准备挑战新难度的智能体系统。智能体在读取到这本附带详细参数说明和执行历史的秘籍后,就可以带着前人的智慧去闯荡新关卡。
这场知识迁移实验的成绩极其亮眼。
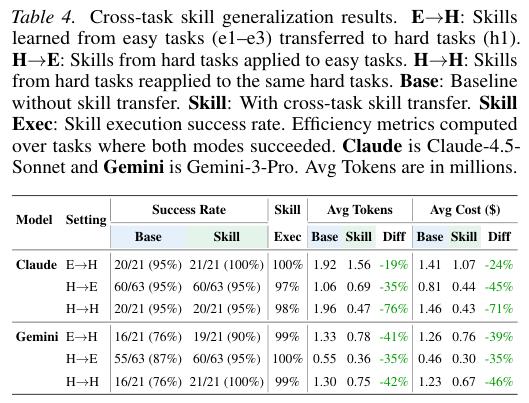
Claude 4.5 Sonnet拿着在简单关卡沉淀的Skill去挑战困难关卡,不仅把成功率从原本的95%稳稳拉升到了完美的100%,还将计算消耗从192万一口气砍到了156万。
把困难关卡磨练出的Skill平移去解其他困难任务时,虽然成功率保持在95%的绝对高位,但计算资源却出现了从196万暴降至47万的神奇魔术。
Gemini 3 Pro也在这套打法中获益匪浅,无论是从简入深还是同级切磋,都在大幅削减成本的同时拔高了通关胜率。
高达97%以上的跨关卡执行成功率确凿无误地证明,只要Skill抽象得足够精炼,完全无视难度壁垒的限制。
研究的脚步并未停歇,他们抛出了一个更具野心的问题,不同大模型之间能否共享彼此的心血。
研究人员把Claude、Gemini、GLM和Minimax这四位大咖分别请进测试场,让它们各自在一批最高难度的任务中创造Skill。
随后进入静态复用环节,强制屏蔽掉重新创造新Skill的功能,让每一位选手轮流去执行其他人写好的旧Skill。
整整16组混合搭配的碰撞,催生出了两张极具冲击力的热力图。
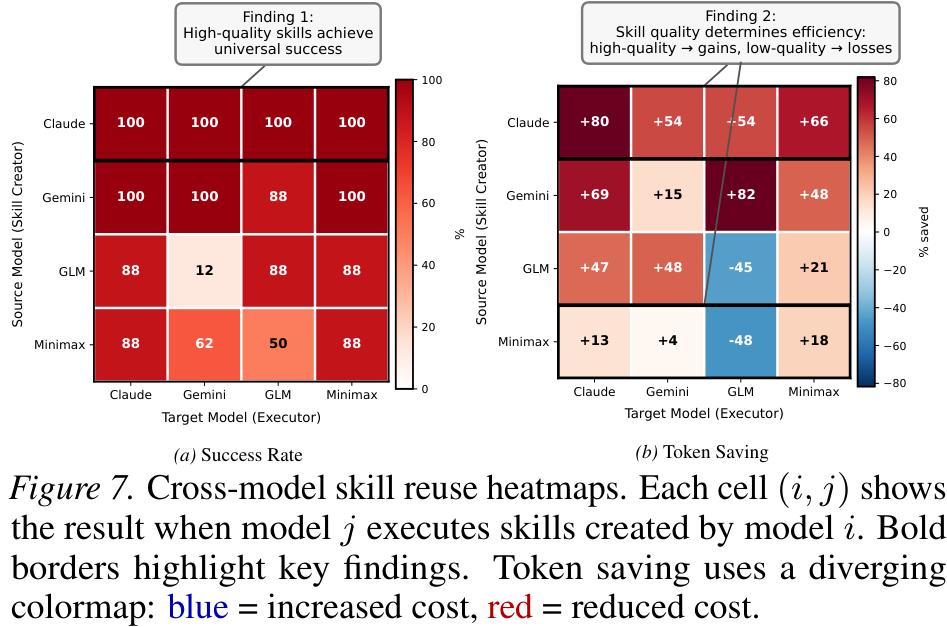
图7的热力图揭开了大模型世界的一条残酷定律,高质量Skill可以包打天下,而拙劣的Skill只会反噬自身。
Claude作为业内顶尖选手,它写出的Skill堪称教科书。
无论是由Gemini接手,还是交由GLM、Minimax去跑,Claude创造的这批代码都在所有目标模型上拿下了令人咋舌的100%成功率,且全部实现了54%到81%的大幅算力缩减。
反观Minimax创造的Skill库,则成了一场不折不扣的灾难。当其他模型硬着头皮去执行这些带着瑕疵逻辑的次品时,计算消耗并没有如预期般降低,反而出现了飙升。
更有戏剧性的是,Claude在使用Gemini编写的Skill时,竟然帮对方跑出了69.2%的惊人降本效果,远超Gemini自己运行这套Skill时省下的14.8%。
好的Skill创造者比单纯的Skill执行者更有价值。
未来的多智能体系统应当优先选择由强模型提炼的高质量Skill库,让每一次计算都花在刀刃上。
参考资料:
https://arxiv.org/abs/2603.00718v2