Mamba-3来了:显存砍半性能暴增,榨干每一滴AI芯片算力
AI越来越聪明,但成本依然高昂。
全行业都在寻找比传统Transformer更高效的轻量化替代方案。
Mamba-3用一半的内存状态达到了前代产品完全一样的性能,同时解锁了此前同类序列模型无法完成的复杂逻辑推理能力。
来自卡内基梅隆大学、普林斯顿大学等的研究团队,通过底层数学离散化方法的彻底升级,复数状态的精妙引入,以及多输入多输出架构的颠覆重构,全面拉升了模型在文本生成阶段的硬件利用效率与逻辑理解质量。
数学底层的进化
当我们在屏幕前向人工智能提出问题,云端庞大的计算集群正在后台进行天文数字般的矩阵运算。
目前占据绝对统治地位的Transformer架构,随着对话上下文长度的增加,注意力机制需要的计算量呈几何级爆炸式增长,记住过去信息的键值缓存会无休止地吞噬宝贵的硬件显存。
业界为打破运算瓶颈,近年来大力研发以SSM(状态空间模型)为代表的次2次方复杂度模型,试图用恒定的内存占用和线性的计算量,来重塑人工智能的运行规则。
现实世界的物理系统通常是连续不断的,计算机处理真实信息,必须将其强行转化为离散的微小步骤。
状态空间模型最初来源于控制理论中的连续动态系统,为适应文本序列的计算,必须进行严谨的数学离散化处理。
前代产品Mamba-1与Mamba-2在处理随时间变化的动态系统时,采取了一种欠缺严格理论基础的启发式近似运算。
研究团队在Mamba-3中,提出了一套名为指数梯形的全新离散化框架,彻底理顺了底层公式的理论脉络。
经典控制理论中有着成熟的离散化方程,在深度学习框架下盲目套用旧公式,会出现严重的精度折损。
研究团队深入分析了包含指数变量的系统动态,发现利用简单的欧拉规则进行1阶近似计算,会产生极大的截断误差。
新的梯形法则通过对时间区间两端的端点进行数据依赖的凸组合计算,提供了更加精确的2阶近似。
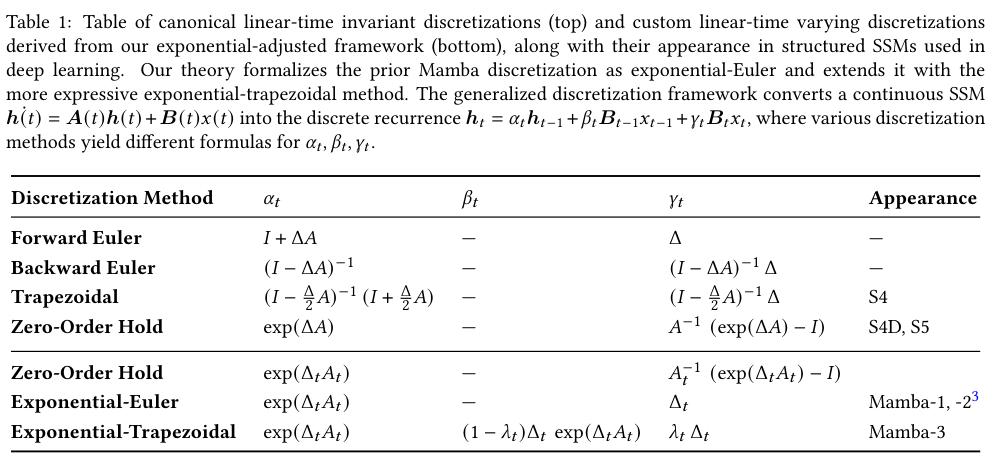
表1清晰展示了多种不同离散化方法的推导来源与最终数学形态,新一代梯形方法具备更广阔的运算表达空间。
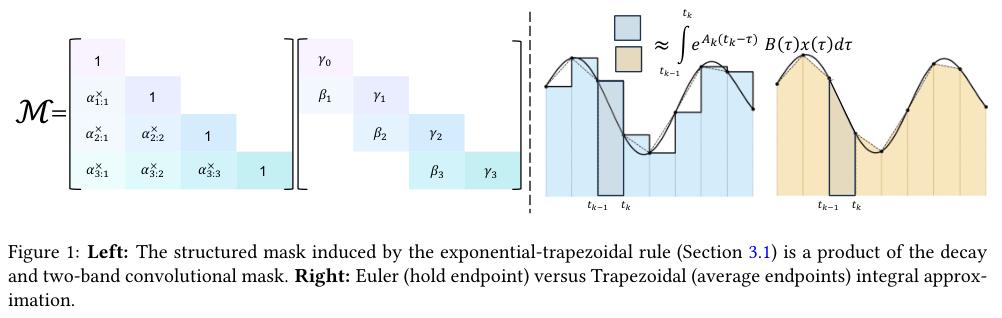
图1右侧生动直观地对比了欧拉方法与梯形方法在积分近似上的视觉差异,梯形取两个端点的组合,能更好地贴合连续曲线的实际走势。
神奇的化学反应随即发生。
新数学公式在底层模型内部完全展开后,自然形成了一种隐式卷积计算效果。以往的轻量化模型往往需要在循环结构之外,单独套用一个独立的短因果卷积层,用来专门增强短文本特征提取。
结合全新的独立偏置参数设计,Mamba-3完全抛弃了累赘的外部因果卷积。精简掉冗余组件后,整体计算架构变得更加干净纯粹。
引入复数与状态追踪
为追求出色的计算效率,过去几代基础架构不断向现实妥协,强行简化核心的状态转移矩阵,前代产品Mamba-2甚至将其粗暴地削减为单一的标量单位阵。
过度简化的代价十分惨重,模型在状态追踪任务上表现大跌眼镜,完全无法完成诸如计算一段二进制数列中1的数量是奇数还是偶数,这样最基础的校验任务。
奇偶校验本质上需要系统具备一种类似圆周旋转的隐藏状态动态变化,纯实数矩阵如同走在一条永远不回头的直线上,绝对无法表达周期性的旋转特征。
研究团队果断重新引入复数来构建状态空间。复数包含实部和虚部两个数学维度,天然具备描述二维平面旋转的绝对优势。问题在于,利用计算机处理复数通常会大量消耗宝贵的计算资源。
研发团队巧妙地通过数学等价转换破解了算力难题。
他们将复杂的复数状态更新,等效为对输入和输出投影应用数据依赖的RoPE(旋转位置编码)。经过旋转位置编码魔法的底层加持,处理复数转移矩阵的计算开销,与纯实数矩阵完全保持一致。
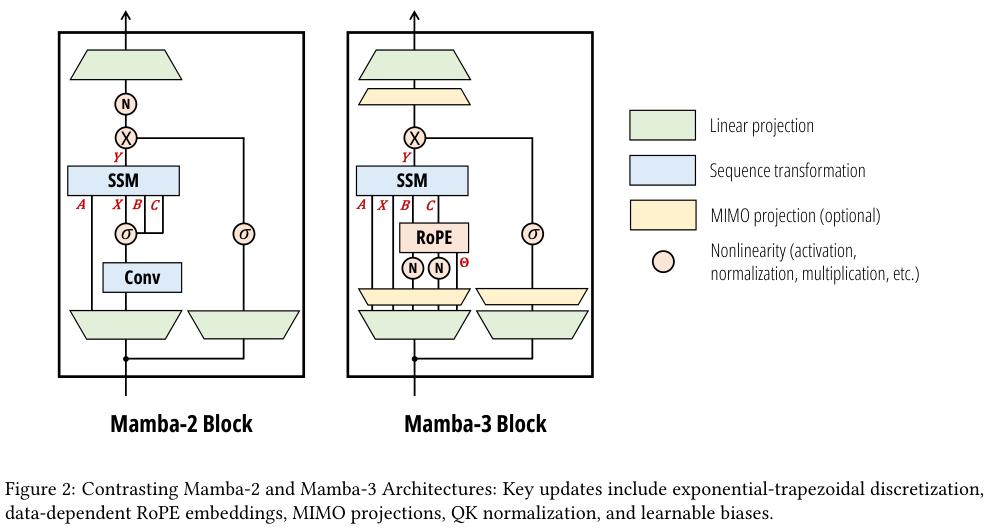
图2详尽对比了上下两代核心架构区块的模块差异。新架构大刀阔斧地取消了外部卷积层,加入了处理复数虚部的主力旋转位置编码模块,并增加了数据标准化处理节点,用以稳定大规模的集群训练。
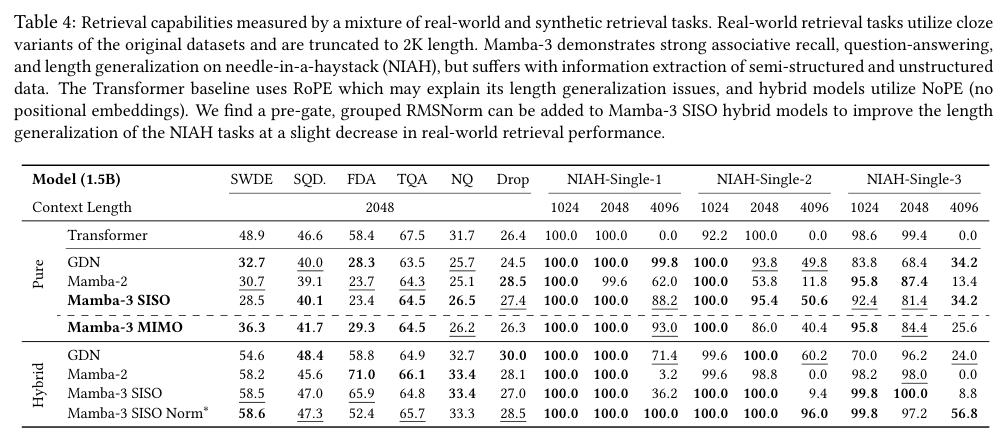
表4列举了各项高难度检索任务的实测跑分数据。在需要从杂乱无章的超长文本中找出关键信息的大海捞针测试里,新架构展现出强大的联想记忆与问答推理实力。
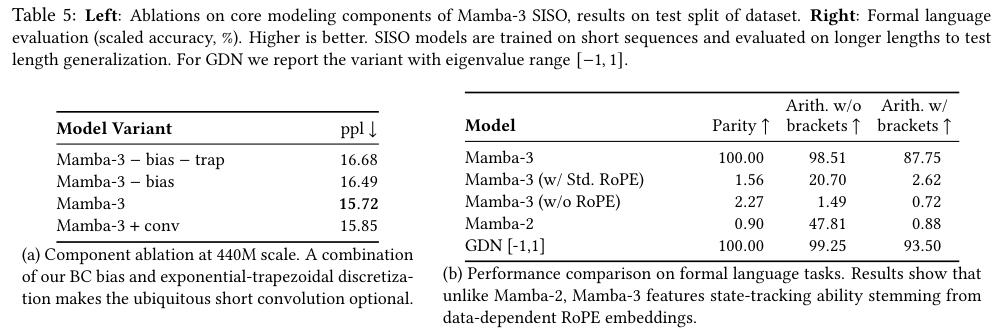
表5专门针对状态追踪任务进行了严苛的消融实验比对。在奇偶校验与模块化算术两项考验底层逻辑的硬核测试中,无旋转位置编码的老旧架构准确率基本等同于瞎蒙,配备了数据依赖旋转位置编码的新一代模型势如破竹,拿下了接近满分的完美成绩。
榨干硬件算力
大语言模型生成连贯文本是一个逐字向外吐出的漫长过程,每生成一个新词汇,都需要将庞大的模型权重,从外部显存中完整读取到核心计算单元。
当前人工智能推理面临的最大物理瓶颈,在于显存数据传输通道不够宽敞,底层芯片运算速度完全充裕。计算核心如同饥饿的猛兽,大部分时间都在空转,苦苦等待缓慢的数据喂入。
衡量硬件真实利用效率的核心指标叫做算术强度,指代每次传输1个字节的数据,运算芯片能够顺手执行多少次浮点运算。
前代底层架构采用SISO(单输入单输出)设计原则,单次生成词汇的算术强度仅为每字节2.5次轻量运算。
当今顶级专用显卡的理论矩阵运算强度,高达每字节近300次巅峰运算。巨大的天壤之别暴露出惊人的硬件算力闲置黑洞。
为彻底填补庞大的效能洼地,研发团队将基础模型结构全面升级为MIMO(多输入多输出)。
内部状态的核心计算过程,由低维度的向量与向量相乘操作,硬核升维至高维度的矩阵与矩阵相乘。
矩阵运算不会显著增加显存的数据读取压力,利用底层芯片内部专用的张量加速单元,能成倍增加实际计算产出量。
大破大立的系统重构,在不增加整体系统等待时间的前提下,大幅提高了每一次内存访问带来的实质运算收益。
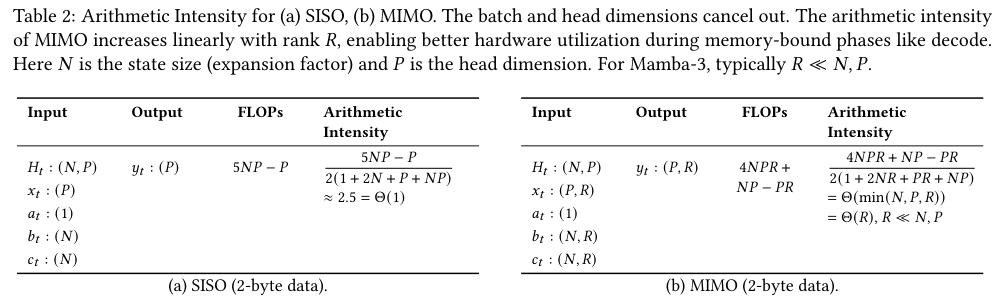
表2直接对比了单输入单输出与多输入多输出两代架构的真实算术强度差异。
多输入多输出通过大胆引入全新的秩参数,将受限于显存传输的低效运算,转换为完美贴合图形处理器张量核心的高效矩阵运算,在不增加解码延迟的严苛条件下,完成了几何级数增长的计算量。
为在核心训练阶段控制总体参数爆炸,研究人员精妙地共享了多个预测头部的投影矩阵结构,只用微小的参数增长,就换来了巨大的整体性能提升。
在底层训练算法层面,多输入多输出机制同样表现出令人惊叹的自适应性。
研发团队利用创新的分块算法,将长篇大论的输入序列,均匀切碎成无数个固定长度的临时知识块。知识块内部利用图形处理器的狂暴并行能力进行矩阵狂飙,区块与区块之间保持严密的先后顺序传递记忆。
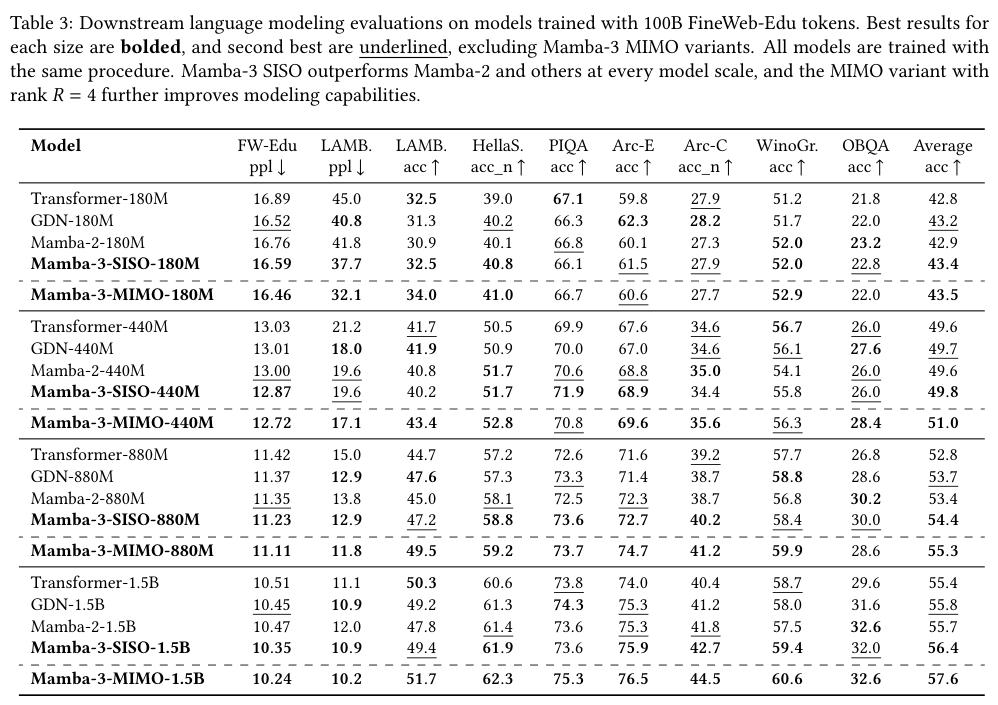
表3的权威下游语言评估测试结果证明了新架构的强悍。在各类常识推理与高难度阅读理解任务中,Mamba-3在1.8亿,4.4亿,8.8亿,15亿4个重量级参数测试场上全面压制竞争对手。
多输入多输出版本进一步拉高了理论能力上限,在15亿参数规模下,比传统的Transformer模型整整高出2.2个百分点。
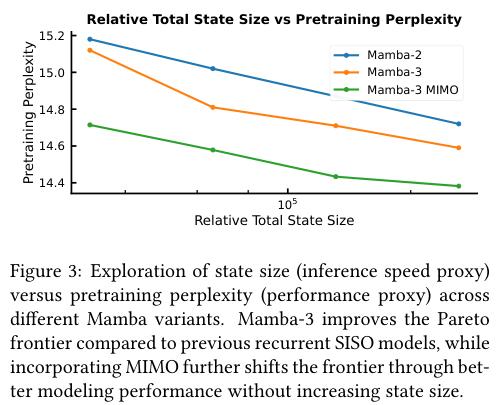
图3给出了关于部署成本与生成性能最直观的结论。在参数量绝对固定的测试场上,状态尺寸大小直接决定了最终推理速度的快慢。
Mamba-3使用64的状态尺寸,就可以完美匹敌前代Mamba-2使用128状态尺寸的文本困惑度指标,等效于用一半的时间延迟获得完全相同的文本生成质量。
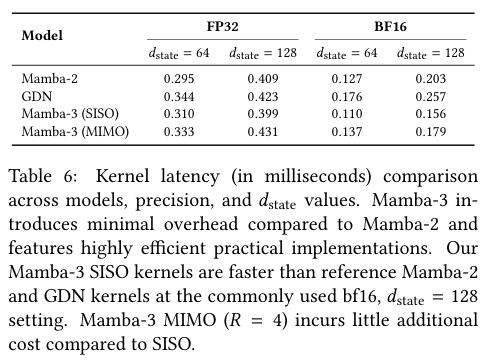
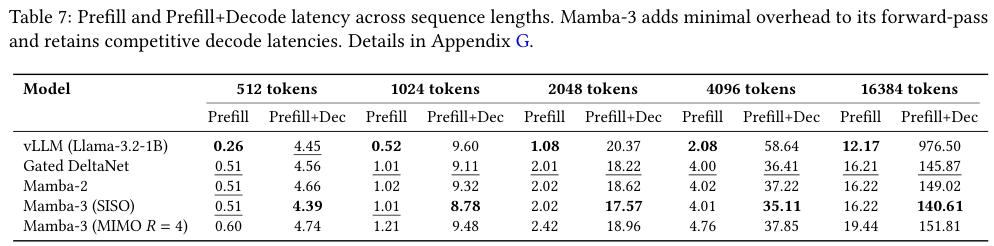
表6与表7提供的底层内核延迟与端到端真实延迟测试数据证实,复杂的底层复数数学优化并没有拖慢整体运行速度,反而展现出出色的工程落地可行性。
随着智能体和复杂逻辑推理应用的全面爆发,未来的人工智能大模型每天可能要生成数以千亿计的文本字符。
一套既能听懂复杂逻辑指令,又能给计算中心省下一半高昂电费的底层网络架构,无疑会成为全行业争相追捧的核心基石。
Mamba-3在这条路上又迈出了一大步。
参考资料:
https://arxiv.org/abs/2603.15569v1