上下文工程的工具和框架
理论和方法论为我们指明了方向,但要将宏伟的蓝图变为现实,我们还需要趁手的工具。上下文工程的快速发展,催生了一个繁荣、多样且日新月异的开源及商业工具生态。这些工具和框架,将底层的复杂性封装起来,为开发者提供了更高层次的抽象,让我们能够更专注于业务逻辑,而不是重复地“造轮子”。
一、数据与存储层
上下文工程的所有上层建筑,都建立在一个坚实的“地基”之上,这便是数据与存储层。这一层负责对AI应用所需的海量、异构的知识进行持久化、结构化的存储,并提供高效的检索接口。它的核心任务,是为L3语义记忆和L2情景记忆提供一个可靠的“家”。
在现代AI技术栈中,数据与存储层正在经历一场深刻的变革。传统的SQL或NoSQL数据库虽然仍在发挥作用,但舞台的中央,正越来越多地被两种新兴的数据库形态所占据:向量数据库和图数据库。
向量数据库是实现RAG的核心引擎。它们通过将文本、图片等非结构化数据转化为“嵌入向量(Embedding)”,并在高维空间中进行高效的相似度搜索,从而赋予了机器“理解”语义的能力。
核心功能与价值:
语义检索:超越关键词匹配,根据概念和意图查找信息。
非结构化数据管理:为文本、图片、音频等过去难以索引的数据类型提供了统一的管理范式。
RAG的基石:是构建L3语义记忆、实现检索增强生成的基础。
主流向量数据库概览(截至2026年初):
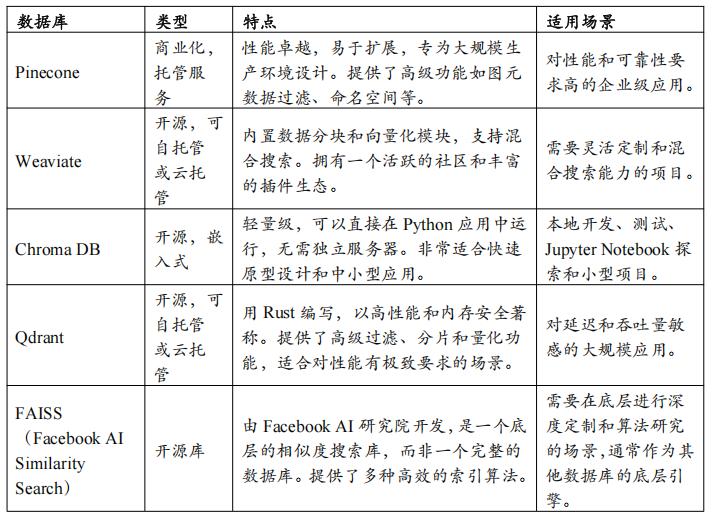
向量数据库解决了“什么与什么相关”的问题,但无法很好地表达“它们之间是什么关系”。这正是图数据库(Graph Database)的用武之地。图数据库将数据存储为节点(Nodes)和边(Edges),天然地适合表达实体之间的复杂、多层级的关系。
核心功能与价值:
关系建模:直观地对“谁认识谁”、“什么属于什么”、“A影响B”等关系进行建模。
多跳查询与推理:能够高效地进行“朋友的朋友”、“影响的传递”等多跳(Multi-hop)查询,这是传统数据库难以做到的。
知识图谱的实现:是构建L3语义记忆中知识图谱部分的理想载体。
主流图数据库概览:
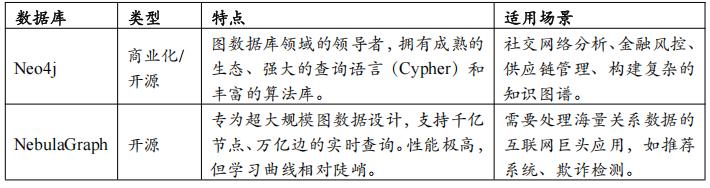
图数据库与LLM的结合,正在催生一种更强大的“结构化RAG”。例如,你可以先用LLM将用户的自然语言问题,转换为一句图查询语言(如Cypher),然后从Neo4j中精确地检索出相关的子图,再将这个子图作为上下文喂给LLM,让它基于这些结构化的关系信息来生成答案。这比单纯的文本块检索,能实现更深层次的推理。
在全球向量数据库的浪潮中,由中国团队主导开发的开源项目Milvus 扮演了举足轻重的角色,并已成为该领域事实上的领导者之一。
核心特点:
云原生架构:Milvus从设计之初就遵循云原生思想,采用了存储计算分离的架构,具有极高的弹性和可扩展性。
高性能与海量支持:专为大规模向量搜索设计,支持百亿甚至千亿级别的向量数据,并能保持毫秒级的查询延迟。
丰富的索引与调优能力:支持多种先进的索引算法(如HNSW, IVF系列等),并允许用户对搜索参数进行精细调优,以在性能和准确率之间取得最佳平衡。
活跃的开源社区:作为CNCF(云原生计算基金会)的毕业项目,Milvus拥有一个全球化、充满活力的开发者社区。
定位与适用场景:Milvus是构建大规模、生产级、对性能有高要求的AI应用的理想选择。当你的业务需要处理数千万以上的向量数据,并且需要一个稳定、可扩展、能够进行深度性能调优的向量数据库时,Milvus是当之无愧的首选。它被广泛应用于图像搜索、推荐系统、文本检索等多种场景。
Milvus对于构建服务于海量用户的AI应用,特别是需要私有化部署和深度定制的场景,具有至关重要的意义。
二、编排与代理层
编排与代理层(Orchestration and Agent Layer)是指挥调度粮草、制定作战计划的“司令部”。这一层的框架,负责将底层的模型、数据源和工具,粘合成一个连贯的、有逻辑的、能够执行复杂任务的智能系统。它们是上下文工程方法论中“编排”和“代理”思想的具体代码实现。
在当前的AI开发生态中,有三个框架在这一层扮演着举足轻重的角色:LangChain、LlamaIndex和AutoGen。它们虽然在功能上有所重叠,但其核心哲学和最佳适用场景却有着显著的区别。
LangChain 是最早出现也是最广为人知的LLM应用开发框架。它的核心设计理念是“链(Chains)”——将LLM的调用、工具的使用、上下文的处理等步骤,像链条一样串联起来,形成一个可复用的逻辑单元。
LangChain最适合需要构建高度定制化、复杂逻辑流的应用。当你需要将多个LLM调用、多种工具、复杂的条件判断组合在一起时,LangChain的灵活性会大放异彩。它是一个通用的“应用框架”,而不仅仅是一个RAG工具。
与LangChain的“通用”定位不同,LlamaIndex 从一开始就将自己定位为一个“数据框架(Data Framework)”,其核心使命是“让LLM更好地使用你的私有数据”。换句话说,LlamaIndex深度专注于RAG的每一个环节,并力求将其做到极致。
LlamaIndex是构建以RAG为核心的应用的首选框架。当你的主要任务是搭建一个高效、精准的知识问答、文档分析或聊天机器人时,LlamaIndex的“专家”定位能让你事半功倍。
AutoGen 由微软研究院推出,它开辟了一个全新的方向:多智能体对话(Multi-Agent Conversation)。它的核心思想不是构建单一的、全能的Agent,而是定义不同角色、拥有不同能力的多个Agent,并通过一个自动化的“群聊”来让它们协同解决问题。
AutoGen最适合用于需要多个不同角色协同、或者需要进行复杂规划和代码执行的任务。例如,构建一个“AI软件开发团队”(包含产品经理Agent、程序员Agent、测试工程师Agent),或者一个能够自主进行数据分析和可视化的“AI数据分析师”。
在上述三大框架的基础上,社区也在不断演进。LangGraph(由LangChain团队推出)和CrewAI等新兴框架,正在将Agent编排推向一个新的高度。
LangGraph:它将多Agent协作建模为状态图(State Graph),提供了比AutoGen更强的流程控制能力和确定性,被认为是构建“生产级”复杂Agent系统的更优选择。
CrewAI:它提供了一种非常直观的、基于“角色扮演”的方式来定义Agent(Role)、任务(Task)和流程(Process),大大降低了构建多Agent系统的门槛。
在全球AI开源生态蓬勃发展的同时,中国的开发者社区也贡献了许多极具价值的编排与代理框架。这些项目通常对国内的大模型和应用场景有着更好的适配性,并提供了独特的创新视角。
Dify 是一个非常受欢迎的开源LLM应用开发平台。它与LangChain等纯代码框架不同,提供了一个高度可视化、低代码的操作界面,让开发者甚至非技术人员都能快速地构建和编排AI应用。
Dify非常适合中小企业或开发团队快速验证和部署AI应用,尤其是标准的RAG和Agent场景。它极大地降低了开发门槛,让创意的实现变得更加高效。你可以将其看作是Agent领域的“Wordpress”,功能强大且易于上手。
LangChain-Chatchat 是一个基于LangChain和FastAPI的开源项目,它的核心目标是解决LangChain在中国本土化应用中的痛点。
如果你的团队技术栈基于LangChain,但主要使用国产模型,并且希望快速搭建一个本地化的知识库问答系统,LangChain-Chatchat是一个绝佳的起点。它为你省去了大量环境配置和模型适配的繁琐工作。
ModelScope-Agent(魔搭):由阿里巴巴达摩院的魔搭社区推出,是一个基于开源LLM的AI智能体开发框架。它依托于ModelScope庞大的模型库和数据集,在多模态Agent和工具使用方面具有独特的优势。
BISHENG(毕昇):这是一个面向企业级AI应用的开源LLM DevOps平台。它不仅包含Agent和RAG的功能,还覆盖了模型管理、评估、监控等更广泛的LLMOps环节,旨在为企业提供一站式的生成式AI解决方案。
来自中国的开源项目,与国际主流框架形成了良好的互补。它们更贴近国内的开发环境和生态,解决了许多“最后一公里”的实际问题。对于上下文工程师来说,熟悉并善用这些工具,将使其在构建面向中国市场的AI应用时,拥有更强的竞争力和更高的效率。
三、评估与观测层
评估与观测层(Evaluation and Observability Layer)是应用的“中枢神经系统”。它负责感知、度量和诊断系统在开发和运行过程中发生的一切,确保我们能看清系统的内部状态,理解它的行为,并在出现问题时快速定位和修复。没有这一层,我们的AI应用就是一个无法理解、无法维护的“黑箱”。
这一层的工具,主要解决两大核心问题:
评估(Evaluation):在开发阶段,如何量化地、数据驱动地评判和改进我们的系统?
观测(Observability):在生产阶段,如何实时地监控、追踪和调试线上运行的AI应用?
当前,主流的评估框架都致力于将“RAG三元组”等核心指标的计算自动化。
主流评估框架对比:
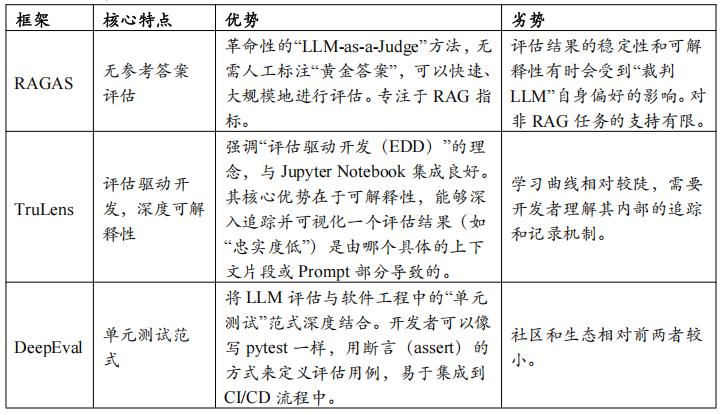
当应用上线后,评估的工作并没有结束,而是转化为了观测。我们需要一个平台来捕获、分析和可视化生产环境中的每一次LLM调用、每一次Agent决策、每一次工具使用。这就是LLM可观测性(LLM Observability)平台的作用。
主流观测平台概览:
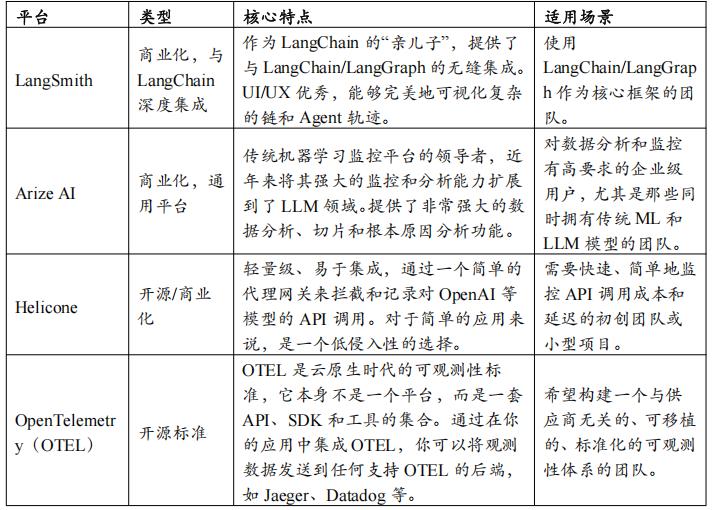
评估与观测层,是让我们的AI应用从一个凭感觉构建的“手工作坊”,进化为一个用数据说话的“现代化工厂”的关键。它们为我们提供了看清系统内部、度量系统质量、诊断系统问题的“眼睛”和“大脑”。
在LLM可观测性领域,开源的力量同样不容忽视。由中德团队背景的初创公司开发的Langfuse 便是其中的杰出代表,它为开发者提供了一个功能强大且可以私有化部署的开源替代方案。
Langfuse非常适合那些重视数据主权、希望拥有一个可控的、与框架无关的LLMOps平台的团队。对于不想被特定商业供应商锁定的企业,或者需要在没有外网连接的环境中部署AI应用的场景,Langfuse的开源和可私有化部署特性使其成为一个极具吸引力的选择。
在中国,随着信创产业和数据安全法规的日益完善,像Langfuse这样优秀的开源、可自托管的工具,正在受到越来越多企业和开发者的青睐。它们为构建自主可控的AI基础设施,提供了坚实的基础。
四、操作与部署层
我们已经有了数据、大脑和仪表盘,现在是时候将我们的AI应用真正推向世界了。操作与部署层(Operations and Deployment Layer)负责处理将一个在开发环境中运行良好的原型,转变为一个能够服务于成千上万用户的、健壮、可扩展、安全的生产级服务所需的一切。这一层是连接AI与真实世界的桥梁,也是工程挑战最集中的地方。
这一层主要包含三大组件:模型服务(Model Serving)、应用部署(Application Deployment)和安全网关(Security Gateway)。
对于使用闭源API(如OpenAI, Anthropic)的应用来说,模型服务由API提供商负责。但如果你选择使用开源模型(如Llama 3, Mixtral),你就需要自己来“托管”这个模型,将其部署为一个可供调用的API服务。这是一个对硬件和软件都有极高要求的任务。
挑战:
显存(VRAM)消耗:大模型体积巨大,需要海量的显存才能加载。
吞吐量与延迟:如何在有限的硬件上,同时服务于多个并发请求,并保证足够低的响应延迟,是一个核心挑战。
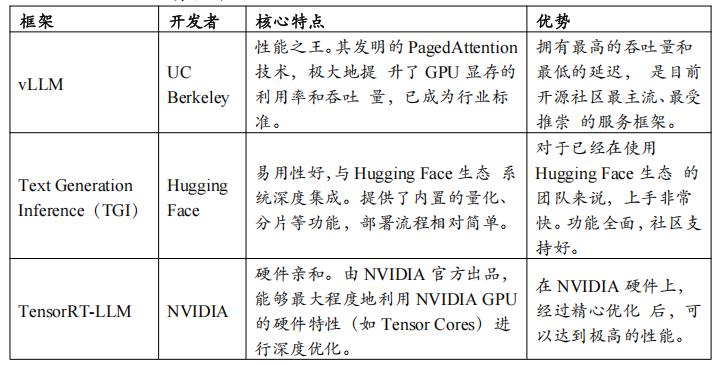
为了解决这些问题,社区开发了一系列专门的LLM服务框架,它们通过各种先进的技术(如PagedAttention、连续批处理等)来榨干GPU的每一滴性能。
主流LLM服务框架对比:
有了模型API后,我们还需要将使用LangChain或LlamaIndex编写的业务逻辑(即那些“链”和“代理”)打包成一个可以独立运行的Web服务。幸运的是,主流的编排框架都考虑到了这一点。
LangServe:由LangChain团队提供,可以让你用几行代码,就将一个用LCEL构建的“链”或“代理”,自动转换为一个符合RESTful API标准的、功能完备的FastAPI应用。它甚至自动生成了用于调试的Web界面和流式输出的支持。
LlamaIndex的REST API:LlamaIndex也提供了将查询引擎或Agent包装为FastAPI应用的功能,使得将RAG能力服务化变得非常简单。
一旦你的应用被打包成了一个标准的Web服务(如FastAPI或Flask应用),你就可以使用任何你熟悉的云原生技术栈来部署和扩展它了,例如:
容器化:使用Docker将你的应用打包成一个容器镜像。
编排:使用Kubernetes来管理和扩展你的容器化应用。
Serverless:对于需要快速弹性伸缩的应用,可以考虑使用AWS Lambda、Google Cloud Functions或Modal等Serverless平台。
在用户请求到达我们的应用,以及我们的应用调用外部LLM API之间,我们还需要一个“中间人”来扮演“安全卫士”和“交通枢纽”的角色。这就是AI网关(AI Gateway)。
主流AI网关/防火墙工具:
Cloudflare AI Gateway:由全球最大的CDN厂商之一提供,拥有强大的全球网络和缓存能力。
Cequence AI Gateway:专注于企业级安全,提供了强大的API安全和机器人防护能力。
Lakera Guard / Prompt Security:专注于LLM防火墙功能,提供了针对提示注入、数据泄露等AI原生威胁的精细化检测和防御能力。
操作与部署层是上下文工程“落地”的最后一环,也是最考验工程能力的一环。一个完整的、生产级的AI应用部署架构,应该是一个分层、解耦的系统。
以上内容为《大模型上下文工程(Context Engineering)指南》的部分内容节选,完整版指南请扫描下方二维码下载。
END