让AI看懂科研图表:深势科技开源150万高质量科研图文数据集
AI在自然图像识别上表现十分出色,如果换成一篇前沿科学论文里的显微图像或者复杂的数据走势图,就会捉襟见肘。
一家致力于打造AI科学家及自主进行科学发现智能系统的公司,深势科技,
开源了他们精心打造的,包含1500000个高质量图文对的OmniScience数据集。
OmniScience将多模态大型语言模型阅读科学图表的能力提升到了全新高度。
整套方案通过破解复杂文档版式,利用前沿算法重写图像描述,把封存在文献里的密集知识转化成了AI能够轻松理解的养分。
解锁科研文献隐藏知识
科研领域的知识大多以复杂文档布局的形式存在,文字排版交错,图表穿插其中。
普通算法在处理多模态信息时面临巨大的理解障碍。
历史上的开源数据集由于涉及领域有限,结构标注粗糙,很难让计算系统建立起视觉元素与专业语义之间的准确联系。
研究人员将目光投向了平均影响因子大于12的高质量开放获取期刊和预印本平台。
过去蕴含着博士级别专家智慧的宝藏因为文档解析技术的局限一直被束之高阁。利用一款名为Uni-Parser的先进文档解析工具,团队结合光学字符识别工具去识别图像内的字母标记,配合启发式规则成功攻克了跨栏与跨页匹配的难题,把分布在不同位置的图片、原始说明文字和正文里提及图片的段落精准提取出来。
根据500份文档的基准测试,提取系统在处理图文配对时的准确率达到了100%。
经过严格的去重和筛选流程,系统依据数字对象唯一标识符(DOI)剔除了重复文档,同时利用图像哈希算法清除了高度相似的冗余图片,OmniScience数据集最终成型。
整个集合涵盖了生物学、材料科学、物理学和计算机科学等10个主要学科。
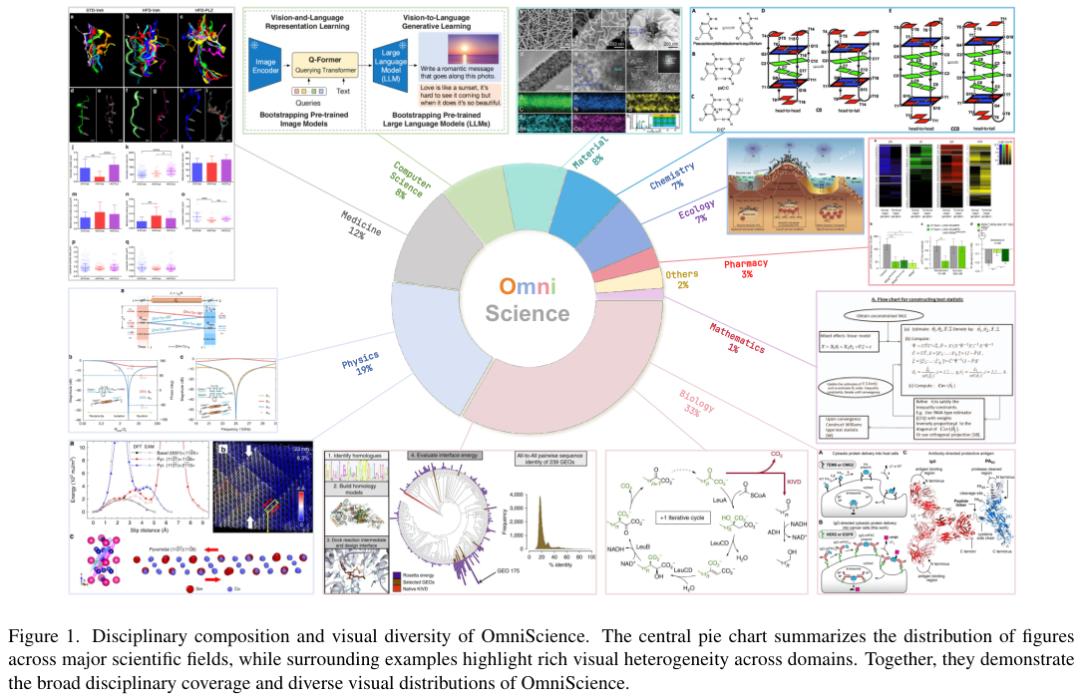
全套数据集包含了超过5000000个带有精确空间定位的子图,涉及4300000000个词元,其中包含1900000000个图像词元和2400000000个文本词元,为AI全面学习科学规律打下了坚实的数据基础。
OmniScience在学科覆盖广度和数据维度上明显超越了以往的同类数据集。
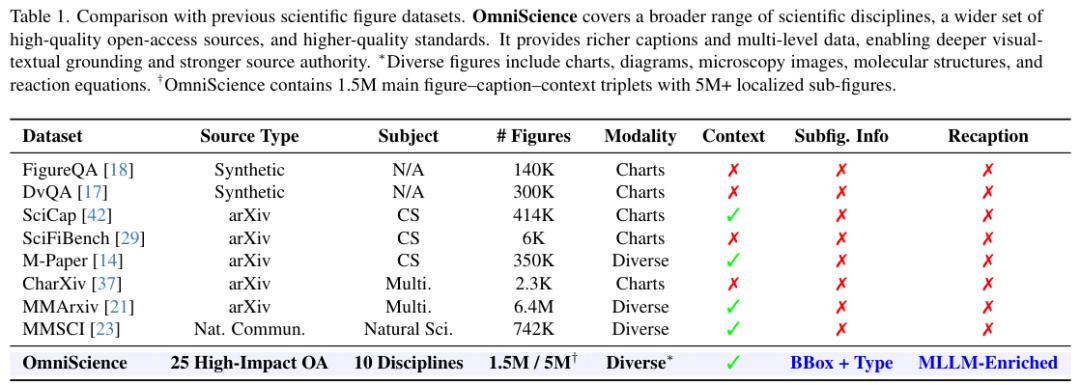
表1将OmniScience与以往的科学图表数据集进行了对比,内容涵盖了更广泛的科学学科和更多高质量来源,提供了更丰富的描述和多层次数据。
让AI做专业图像解说员
论文里的图表说明文字通常是写给同行专家看的,内容十分简略,缺乏必要的上下文。为了让算法更好地领会图表背后的复杂逻辑,研究人员设计了一条动态模型路由重写流水线。
流水线宛如一个高效的调度中心,综合参考图片的学科分类、视觉类型以及人类撰写的原始描述,把重写任务分配给最适合的大语言模型。复杂的扫描电子显微镜(SEM)、核磁共振(NMR)图谱与化学结构图会被送到专门擅长处理密集型数据的Gemini系列模型去解析,带有长篇背景文字的样本交给具备超长上下文处理能力的模型,那些相对基础的统计图表则由Qwen3与GPT5等高性价比模型负责处理。
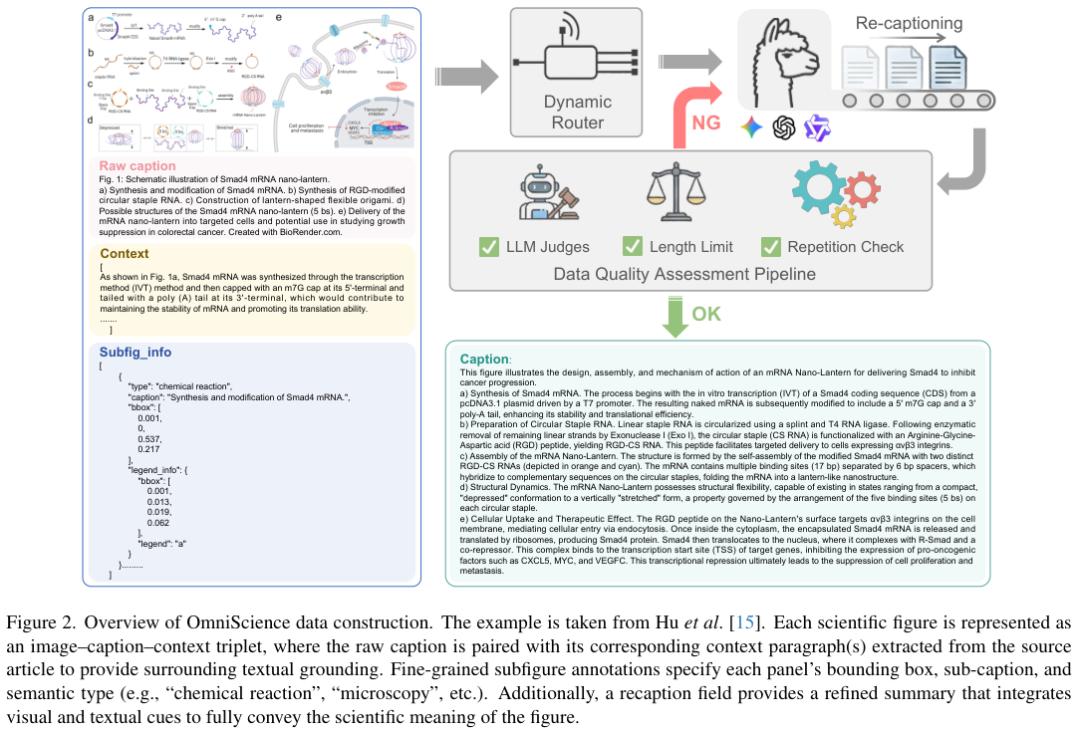
图2展示了数据构建的全过程,系统结合视觉特征、原始说明文字以及来自论文正文的相关段落,生成了内容丰富且自成一体的新描述。
为了保证新生成的文字描述准确无误,研究团队引入了严苛的质量控制体系。
验证环节使用一套基于视觉语言模型的事实核查工具,对图片、原始文字和新生成的文字进行三角比对。
一旦发现虚拟算法凭空捏造数据或者产生了不符合常理的推断,系统就会把错误原因反馈回去要求重新生成。
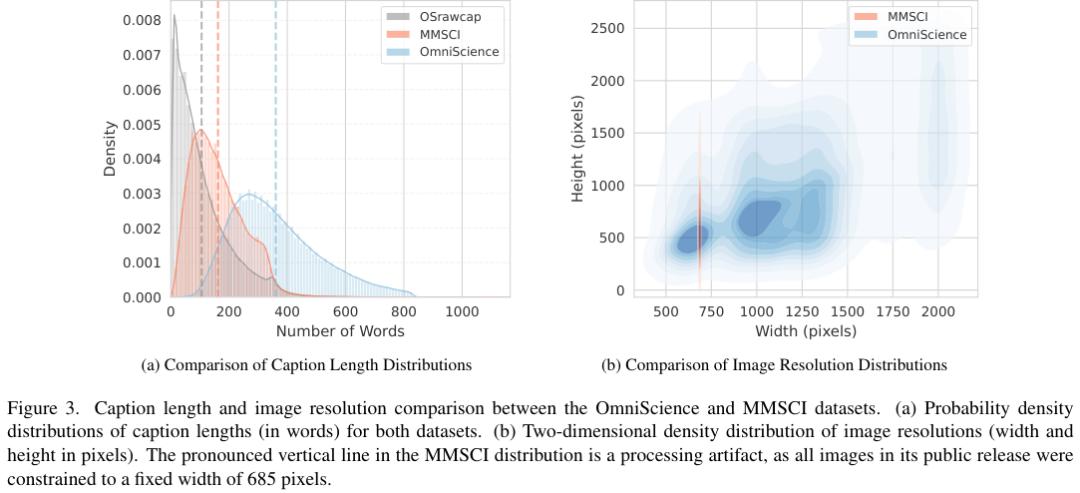
观察图3的数据分布,经过流水线处理后,图表描述文字的平均长度从106.2个单词增加到了360.6个单词,图像分辨率也保持了原有的高清晰度状态。
更详细丰富的文字描述大幅度提升了文本与图像之间的语义契合度。在衡量跨模态匹配精准度的评分系统中,采用新描述的图文相似度得分从0.769跃升到了0.956。
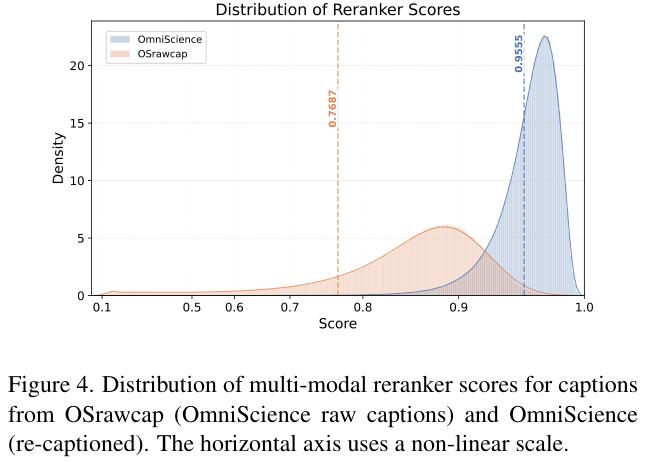
图4直观地反映了分布变化,重写后的描述在多模态相似度得分分布上显著向右偏移,聚集在得分更高的区域。
用海量数据喂出聪明算法
高质量的数据最终要服务于计算能力的提升。研究人员挑选了各类图文匹配数据集,分别去微调同一个底层模型Qwen2.5,并放在多个专业的评估标准下进行测试。
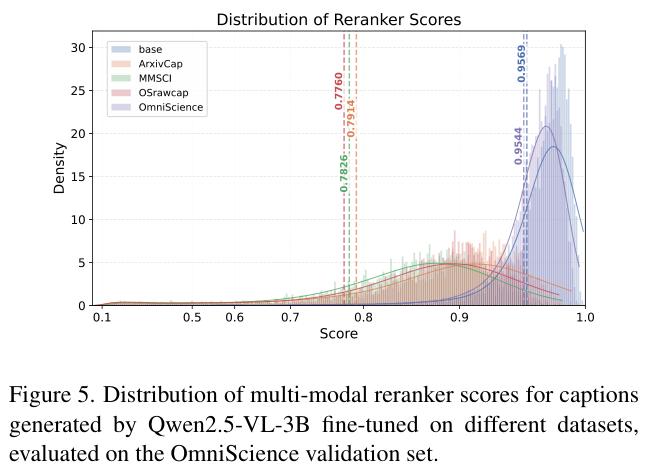
如图5所示,在OmniScience验证集上,使用重写描述训练出的模型,生成的文字与图片的契合度远远甩开了使用原始粗糙描述训练的对照组。
为了更细致地评估生成文字的质量,团队搭建了一个由多个先进算法组成的评委团,从语言流畅度、信息一致性、关键信息准确度和细节丰富度四个维度进行打分。
打分体系与人类专家的评判保持了0.831的高度一致性,展现出极高的可靠性。
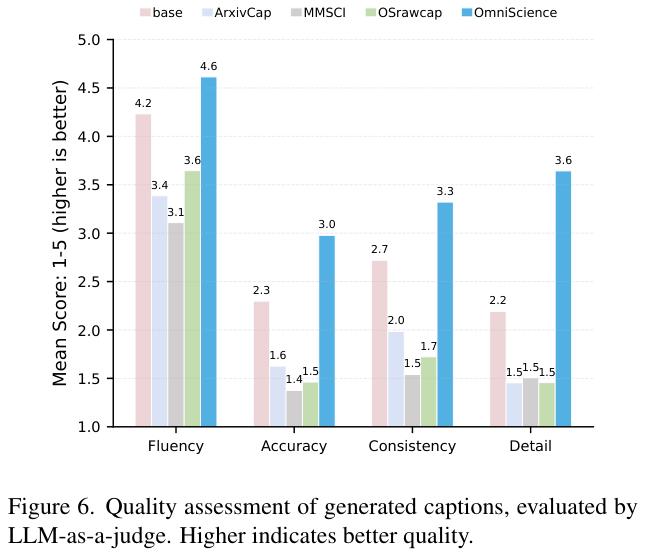
图6的评委打分结果清晰地呈现出,在OmniScience数据集上训练的系统在各个评估维度上都占据了领先位置,尤其在信息一致性和关键信息准确度上进步巨大。
研究团队还提出了一种新颖的验证思路,优异的图表描述文字应该能够完美替代原图去回答相关的复杂科学问题。评估过程把生成的文字直接放进推理引擎里,让引擎在完全看不到原图的情况下只凭文字去解答专业难题。
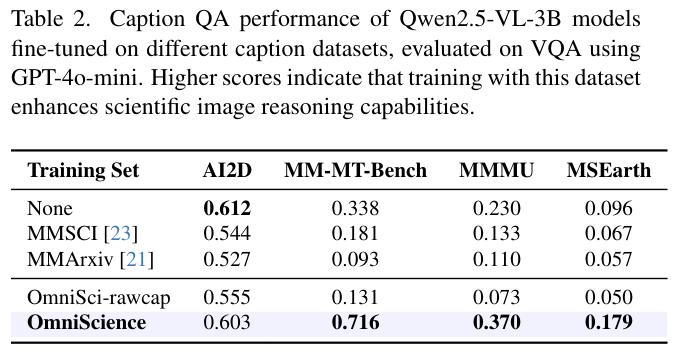
表2的测试数据印证了研发人员的设想,经过OmniScience训练的系统在面对各类多模态基准测试时,即便只依靠文字输出去答题,成绩也取得了大幅度的绝对提升,在MMMU测试集上提升了0.140,在远程传感测试集上提升了0.083。
算法不再是简单地看图说话,真正把复杂的视觉信息提炼成了AI能够消化运用的文本知识。
高质量的科学图文数据如同破译自然规律的密码本,基于OmniScience的丰厚积累,AI自主科研的路又前进了一步。
参考资料:
https://huggingface.co/datasets/UniParser/OmniScience
https://arxiv.org/pdf/2602.13758