谷歌劲爆论文被曝学术不端!华人学者公开指控抄袭、贬低已有理论成果
谷歌前几天发布的一篇博客文章:“内存减6倍、精度0损失,推理提速8倍!谷歌新技术震撼了AI圈”。
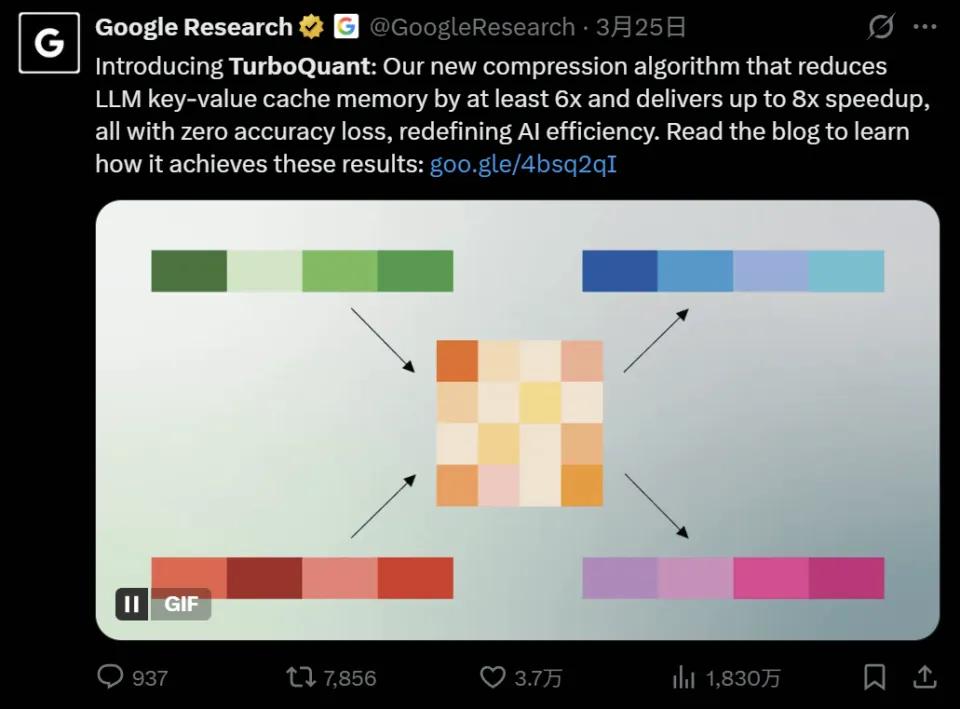
这项被谷歌高调宣传、号称把大模型KV缓存压到原来1/6、推理提速8倍的TurboQuant算法,一夜让内存股蒸发超过900亿美元。
X上关于该技术的消息,发布不到24小时上千万浏览。
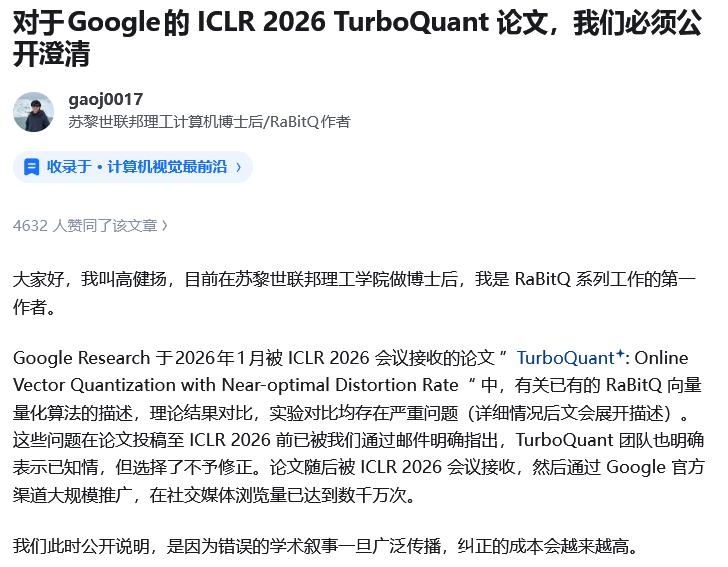
就在整个AI圈为之震动时,一位华人博士后,公开指出这篇论文的核心方法与他的团队两年前发表的RaBitQ高度雷同,而且论文中存在刻意回避、误导性描述和不公平实验三重问题。
更令人不安的是,这些问题在论文投稿前就已被指出,却被作者方选择性忽略。
一篇论文砸掉900亿美元
AI大模型在生成每一段文字时,都需要反复回顾之前的对话内容,这些历史数据被存储在一种叫做KV缓存的临时内存区域中。
随着对话越来越长,KV缓存占用的内存会迅速膨胀,成为大模型运行过程中最昂贵的成本瓶颈。
KV缓存就像一个不断被塞满的临时记事本,记事本越大,读取速度就越慢,运行成本也越高。这就催生了一个庞大的AI存储芯片市场,投资者普遍押注大模型的内存需求将长期高速增长。
2026年3月24日,谷歌研究部门通过官方博客发布了一篇名为TurboQuant的技术论文,声称找到了一种极限无损压缩算法,能够将KV缓存的内存占用减少到原来的1/6,同时推理速度提升8倍,而且精度没有任何损失。
这篇论文的全称是TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate,已于2026年1月被全球AI研究顶级会议ICLR 2026正式接收。
消息传出的当天,美股内存芯片板块遭遇了罕见的集中抛售。内存板块蒸发的市值总额超过了900亿美元。
CNBC、Tom's Hardware、TrendForce等国际主流科技媒体纷纷对此进行了报道,谷歌研究团队在X平台上的宣传帖浏览量迅速突破数千万。
TurboQuant的技术思路可以概括为两个步骤。
第一步是高质量压缩,算法先对数据向量进行随机旋转操作,简化数据的几何结构,然后使用PolarQuant方法进行压缩。
第二步是消除隐藏误差,仅用1比特的压缩空间,对第一阶段残留的微小误差应用QJL算法进行修正。
谷歌在论文中称,在所有基准测试中,TurboQuant都达到了完美的下游任务表现。
在H100 GPU上,4比特TurboQuant相比32比特未量化的键值,实现了高达8倍的性能提升。
这些数据看起来非常漂亮,也直接动摇了市场对AI存储芯片长期需求的乐观预期。投资者开始担忧,一旦这种压缩技术成熟普及,大模型对内存芯片的爆发式增长需求可能被大幅削弱。
被忽视的先行者
TurboQuant引发了AI圈和内存市场震荡,而一位名叫高健扬的华人学者正在经历一种截然不同的情绪。
高健扬是苏黎世联邦理工学院的计算机科学博士后,也是RaBitQ系列论文的第一作者。
RaBitQ是一种高维向量量化方法,最早于2024年5月在预印本平台arXiv上发布,随后发表在数据管理领域顶级会议SIGMOD 2024上,扩展版则发表于SIGMOD 2025。
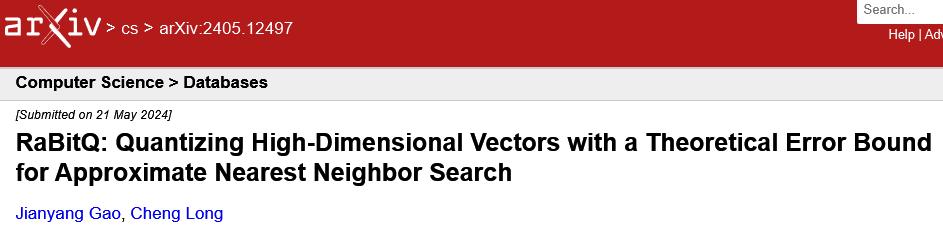
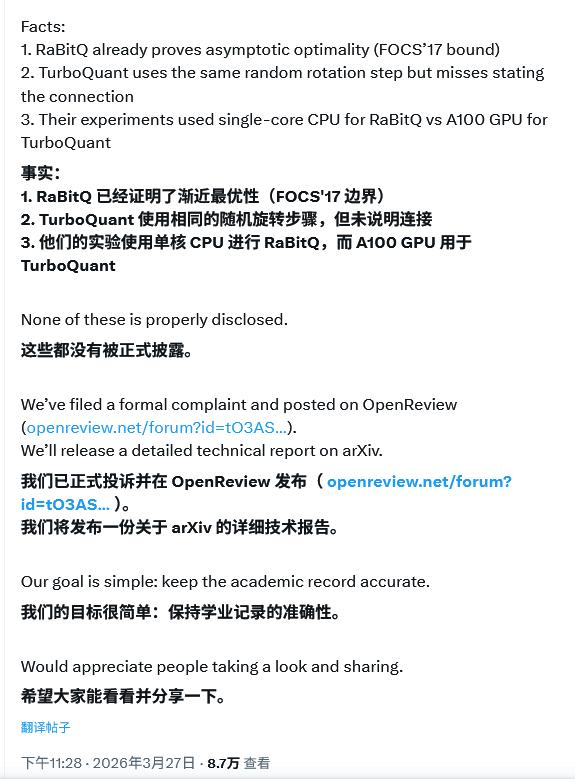
RaBitQ的核心思路之一,是在量化前对输入向量施加随机旋转,即Johnson-Lindenstrauss变换,利用旋转后坐标分布的数学性质来进行向量量化,并在理论上证明了其误差界达到了理论计算机顶级会议论文(Alon-Klartag,FOCS 2017)给出的渐近最优误差界。
因为这一理论贡献,高健扬团队被邀请至理论计算机科学顶级会议FOCS的Workshop进行报告。RaBitQ的代码也在GitHub上完全开源,任何人都可以自由查看和复现。
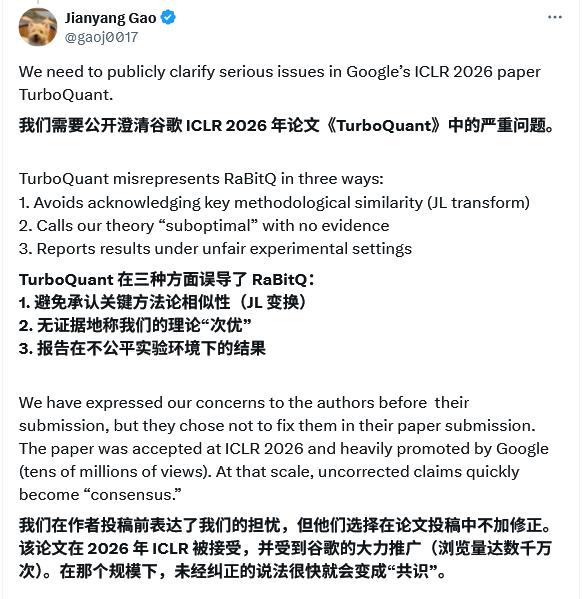
高健扬在3月27日于知乎和X平台,列举了TurboQuant论文存在的三大问题。
他在文章中完整回顾了事件的时间线,TurboQuant团队与RaBitQ团队之间的交集远比外界想象的要深。
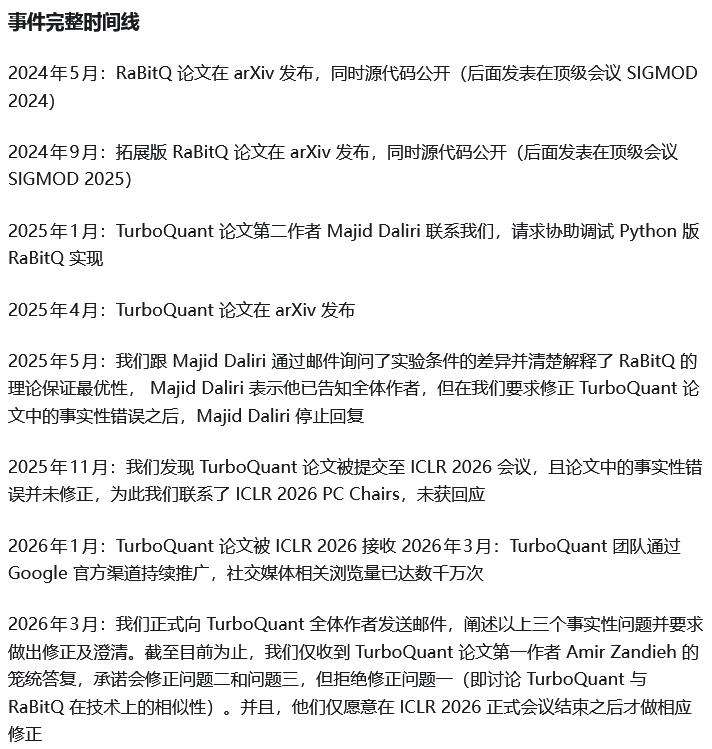
2024年5月至9月,RaBitQ团队陆续发布了论文预印本和扩展版,同时开源了代码。
2025年1月,TurboQuant论文的第二作者Majid Daliri主动联系高健扬团队,请求协助调试其自行用Python复现的RaBitQ代码。
三个月后的2025年4月,TurboQuant论文在arXiv上发布。
高健扬团队很快发现TurboQuant论文在描述RaBitQ时存在问题,随即通过邮件与TurboQuant团队进行了多轮沟通。
2025年5月,高健扬团队与Majid Daliri进行了详细的邮件技术讨论,逐条澄清了TurboQuant对RaBitQ理论结果的错误解读。
Majid Daliri在邮件中明确表示已将讨论内容告知全体共同作者。
2025年11月,TurboQuant论文被提交至ICLR 2026,此前指出的问题并未被修正。
高健扬团队联系了ICLR 2026的程序委员会主席,但未获得任何回应。
2026年1月,TurboQuant论文被ICLR 2026正式接收,随后谷歌开始通过官方渠道进行大规模推广。
三项指控与一份沉默
TurboQuant论文系统性地回避了其方法与RaBitQ的相似性。
RaBitQ和TurboQuant在方法设计上有一个最核心、最接近的共同点,两者都在量化前对输入向量施加随机旋转(Johnson-Lindenstrauss变换)。
在ICLR的审稿过程中,有评审者明确指出“RaBitQ and variants are similar to TurboQuant in that they all use random projection”,要求TurboQuant团队充分讨论两者的关联。
TurboQuant团队不仅没有正面回应这一要求,反而将正文中对RaBitQ的不完整描述移到了附录中。
TurboQuant论文在正文中将RaBitQ描述为grid-based PQ,完全忽略了RaBitQ中核心的random rotation步骤,有意模糊了两者之间的传承关系。
TurboQuant作者对此的回应是,随机旋转和Johnson-Lindenstrauss变换已经是该领域的标准技术,不可能引用每一篇使用了这些方法的论文。
高健扬团队认为这一回应是在转移矛盾,作为在相同问题设定下率先将随机旋转与向量量化结合并建立最优理论保证的具体先行工作,RaBitQ理应在文中被准确描述。
TurboQuant论文错误描述了RaBitQ的理论结果。
TurboQuant论文在不提供任何推导、对比或论据的情况下,将RaBitQ的理论保证定性为次优(suboptimal),将原因归结为较粗糙的分析(loose analysis)。
事实上,RaBitQ扩展版论文(arXiv:2409.09913)的Theorem 3.2已经严格证明,RaBitQ的误差界达到了理论计算机顶级会议论文给出的渐近最优误差界。
这一理论结果的质量已经得到了学术界的认可,高健扬团队也因此被邀请至FOCS的Workshop进行报告。
2025年5月的邮件沟通中,这些问题已被逐条澄清,Majid Daliri也确认已告知全体共同作者。
但在论文经历完整审稿、被接收乃至被谷歌大规模宣发的全过程中,这一错误定性始终未被更正。
TurboQuant论文刻意制造了不公平的实验环境。
在测试RaBitQ的运行速度时,TurboQuant团队既没有使用RaBitQ官方开源的C++实现,而是用了Majid Daliri自己翻译的Python版本(效果明显差于官方实现),又将RaBitQ限制在单核CPU、关闭多线程的条件下运行。
与此同时,TurboQuant自身使用的是NVIDIA A100 GPU进行测试。
用CPU上的Python代码和GPU上的优化代码进行性能对比,得出的RaBitQ比TurboQuant慢数个数量级的结论,具有明显的误导性。
Majid Daliri在2025年5月的邮件中承认了单核限制这一情况,但论文中并未对这两层系统性的不公平条件进行充分披露。
舆论发酵与谷歌的回应
随着高健扬公开文章的传播,这起事件在学术圈和社交平台上引发了广泛讨论。
TurboQuant论文的一位评审者在OpenReview平台上公开发表评论,表示他虽然认为TurboQuant的理论分析和实验结果很出色,但也发现这一方法与RaBitQ存在明显的共通之处,并曾要求TurboQuant团队比较两者在设计上的差异如何影响性能。
在查看TurboQuant的最终版本时,他惊讶地发现RaBitQ在实验部分仅被提及了一次。
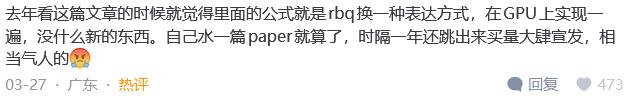
有网友表示读TurboQuant论文时就感受到其与RaBitQ的高度相似,认为TurboQuant更像是把RaBitQ换了一种表达方式在GPU上实现一遍,创新性不足。
高健扬文章最后说,一篇论文被谷歌以数千万曝光量推向公众,在这种体量下,论文中错误的叙事不需要主动传播,只需要不被纠正,就会自动成为共识。错误叙事一旦广泛传播,纠正的成本会越来越高。他选择在此时公开发声,正是出于这个原因。
事件发酵后,TurboQuant论文第一作者Amir Zandieh作出了回复。
他的回应相当有限,承诺会在2026年4月ICLR 2026正式会议结束之后,修正对RaBitQ理论结果的错误描述以及实验环境差异的披露问题,但拒绝在文中讨论TurboQuant与RaBitQ在技术上的相似性。
这场争议尚未有官方定论。谷歌方面尚未对学术界的质疑作出正式公开回应,ICLR官方也未发表任何声明。
回顾整个事件,有几点值得思考。
在技术层面,TurboQuant和RaBitQ是否真的存在抄袭关系,需要学术界通过技术报告和同行讨论来做出判断,目前不宜妄下结论。
在学术规范层面,对先行工作的准确引用、对实验条件的完整披露、对质疑的及时回应,是维护学术共同体公信力的基本责任。
当一篇论文被顶级会议接收并通过大型科技公司的渠道获得千万级曝光时,其技术叙事的影响力已远超学术圈本身,甚至直接波及资本市场,对数百亿规模的产业造成实质性冲击。在这种量级的影响力之下,学术严谨性的要求只会更高,不会更低。
顶会的标签和大厂的背书,从来不是学术质量的护身符。
对学术规范的敬畏、对先行者的尊重、对每一份实验数据的诚实,始终是不可逾越的底线。
这起事件的最终走向如何,我们拭目以待。
参考资料:
https://zhuanlan.zhihu.com/p/2020969476166808284
https://x.com/gaoj0017/status/2037552350924042488