元学习龙虾:CMU、伯克利联合发布 MetaClaw,8.25 倍性能跃升
龙虾热潮不断,最近UNC、CMU等顶尖机构刚放出了一篇热点论文:MetaClaw。
现在行业里所有落地的 LLM Agent,都有个致命通病 —— 一次训练终身不变,越用越跟不上用户需求。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这篇论文给出的答案是 MetaClaw——一个让 Agent 在真实使用中持续进化、完全零停机、不需要本地 GPU 的元学习框架。这可能是第一个能在生产环境落地的“会自我成长的 Agent”。
所有部署在野的 Agent,都在重复犯同样的错误
先说个你肯定遇到过的场景。
你在用一个 CLI Agent 帮你处理文件操作,第一天它因为没验证文件路径,直接读了个不存在的文件,报错了。你手动修复,继续用。第二天换了个任务,它又因为同样的原因挂了。第三天、第四天……它像个没有记忆的金鱼,在同一个坑里反复摔跤。
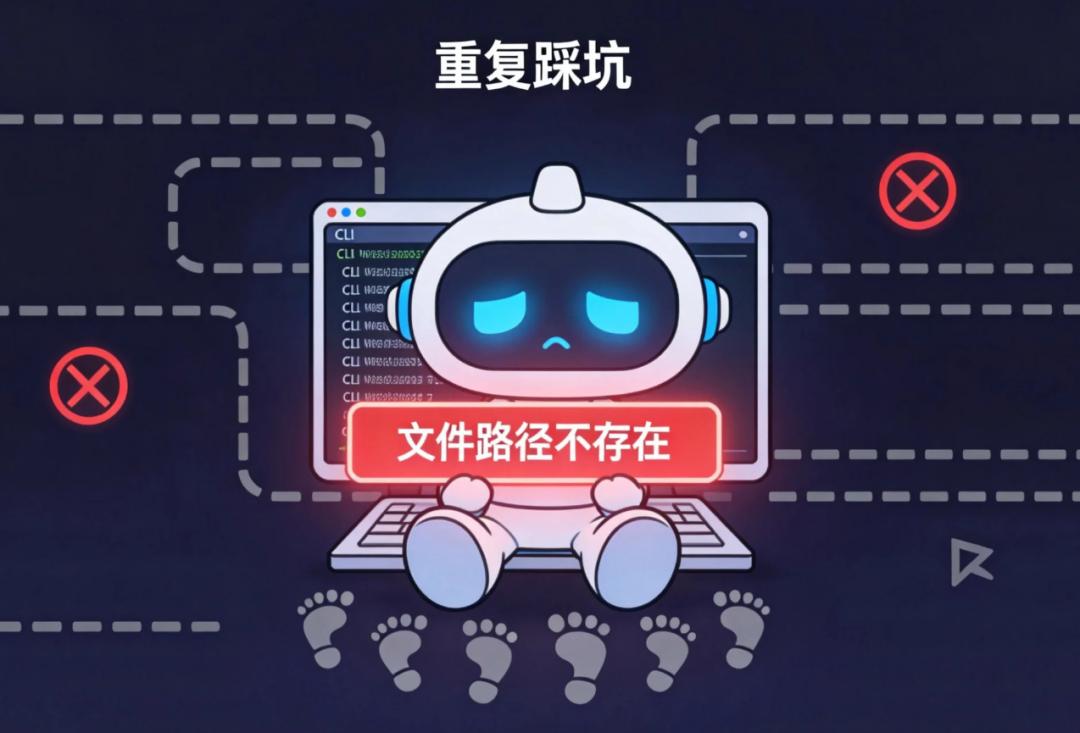
这不是个例,这是整个 AI Agent 行业的通病。
现在的 Agent 部署逻辑是这样的:在实验室里用固定数据集训练好,打包上线,然后就再也不动了。用户的真实需求在变——这周在处理 JSON 文件,下周在写 Shell 脚本,下下周在做多步推理——但模型的权重、知识库、行为策略,全是静态的。
你可能会说,不是有很多“记忆增强”的 Agent 吗?
对,现在确实有三类主流方案:
1. Memory-based 方法(像 Reflexion):把失败的对话原封不动存下来,下次遇到类似任务再翻出来看。问题是,这些轨迹又长又冗余,Agent 根本提取不出可迁移的行为模式——就像你把所有考试错题的完整答题过程都抄一遍,但从来不总结“哪类题用哪个公式”。
2. Skill-based 方法(像 Voyager):把成功经验压缩成可复用的技能指令,存到技能库里。听起来很美,但这些技能库永远是个静态数据库,从来不和模型的权重优化联动——就像你背了一堆解题技巧,但大脑本身的推理能力没有任何提升。
3. RL-based 方法:用强化学习更新模型权重。但现有工作都在离线小规模场景做,完全没考虑一个致命问题:一旦技能库进化了,之前收集的轨迹里的 reward 就过期了——你用“旧技能”时失败得到的负 reward,不能用来惩罚“新技能”下的模型,否则梯度更新的目标就错了。
这三类方法的共同问题,是它们都只解决了“进化”的一个维度,把另外两个维度完全扔掉了。
而这篇论文最核心的洞察是:Agent 的进化,天然存在两个完全不同的时间尺度,而这两个尺度不仅不冲突,反而是互补的、互相强化的。
双时间尺度进化:一个在秒级生效,一个在天级优化
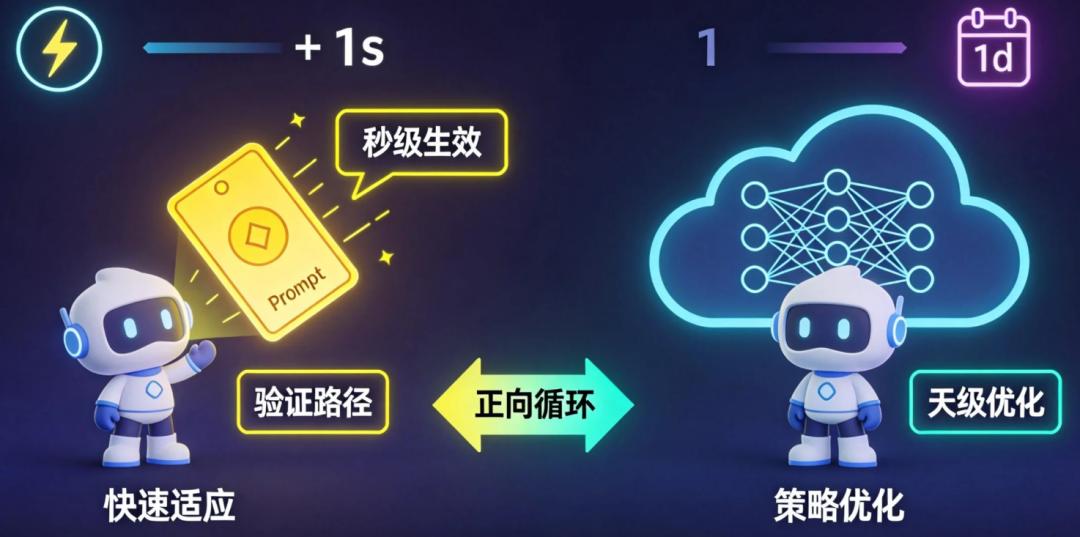
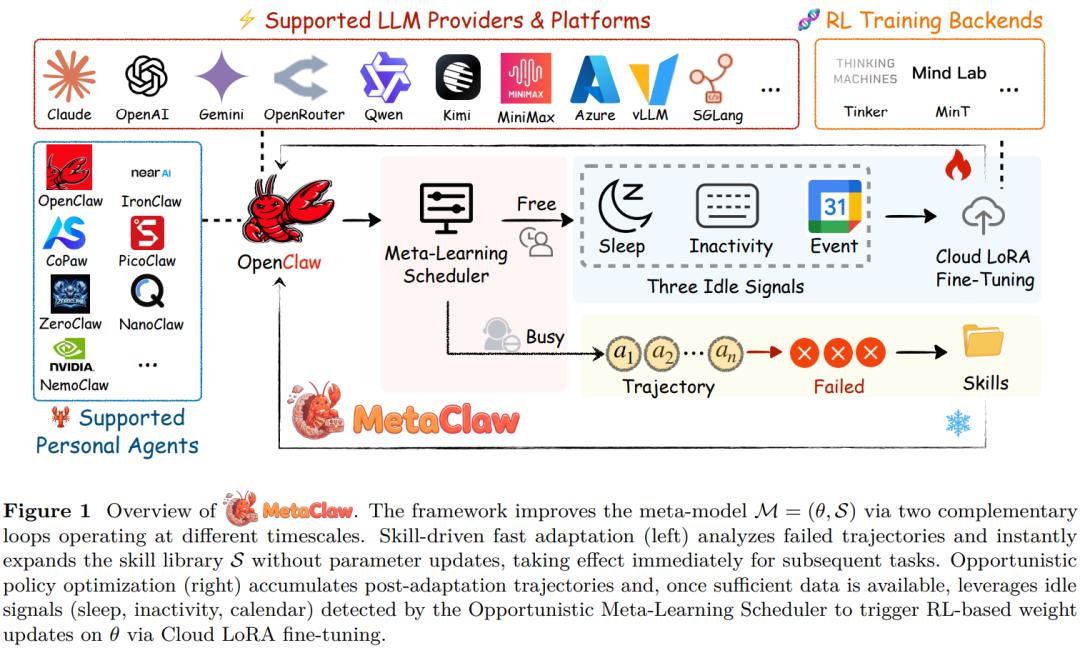
MetaClaw 的核心设计,是把 Agent 的“元模型”拆成两个组件:基座 LLM 的权重θ + 技能指令库𝒮,然后用两套完全不同的机制分别优化它们。
想象一个场景:
快速适应(秒级生效): Agent 执行一个文件读取任务失败了,因为它没检查路径是否存在。系统立刻调用一个 LLM“技能进化器”,分析这条失败轨迹,提炼出一条行为指令——“在读取文件前,必须先验证路径存在性”。这条指令立刻注入到 Agent 的 system prompt 里,下一个任务马上就能用上。零参数更新,零停机时间,瞬间生效。
策略优化(天级优化):系统在后台持续收集 Agent 使用新技能后的执行轨迹,积累到足够多样本后(比如几百条),在用户不活跃的时间窗口(深夜、开会、键盘无输入),启动云端 LoRA 微调,用强化学习更新模型权重。这次更新的目标不是“把任务做对”,而是“让模型在有了新技能后,表现得更好”——相当于不仅教会了 Agent 一个解题技巧,还提升了它理解和运用技巧的底层能力。
这两个机制是怎么互相强化的?
• 更好的权重θ → 产生更有信息量的失败案例 → 技能进化器能提炼出更高质量的技能
• 更丰富的技能库𝒮 → Agent 执行任务时得到更高的 reward → 策略优化时的梯度信号更强
这就形成了一个正向循环:模型越用越聪明,越聪明越会从失败中学习,越会学习就越聪明。
但你可能会问:同一个词在不同场景下意思不一样,技能库怎么知道什么时候该用哪条技能?
答案是:检索 + 上下文匹配。每条技能都有 embedding 表示,执行任务时用余弦相似度检索 top-k 相关技能,注入 prompt。更妙的是,技能本身就是自然语言写的行为指令(比如“遇到 JSON 文件,优先检查 schema 合规性”), LLM 天然就能根据当前任务上下文判断要不要用、怎么用。
最反常识的发现:技能进化对“推理任务”的提升,居然比“知识任务”还大
看到实验结果时,我最震惊的不是整体准确率提升了多少,而是一个完全违背直觉的现象。
在 MetaClaw-Bench(一个跨 44 个工作日、934 道题的连续 Agent 基准测试)上,研究者把任务分成两类:
• Multi-choice 任务:概念性、程序性问题,考验推理和规则理解
• File-check 任务:实际执行的文件操作,输出要通过自动化 checker 验证
按常理,技能库存的都是“遇到 XX 情况就做 YY”的行为规则,应该对知识类、规则类任务帮助最大,对需要多步执行的文件操作帮助有限。
结果完全相反。
对 GPT-5.2,光加技能库(MetaClaw Skills), Multi-choice 准确率从 41.1% 升到 44.0%(+7.1%), File-check 完成率从 14.7% 升到 17.1%——看起来差不多。
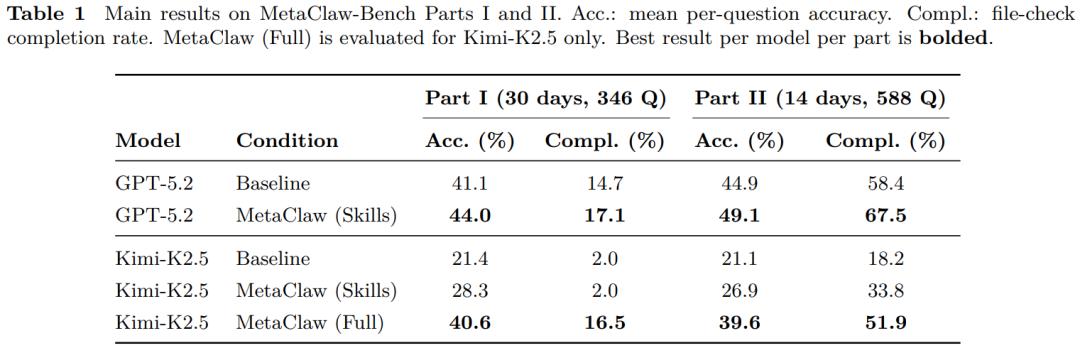
但对 Kimi-K2.5,File-check 完成率在 Part II 直接从 18.2% 跳到 33.8%(+85.7%),而 Multi-choice 只从 21.1% 升到 26.9%(+27.5%)。
更夸张的是,当加上完整的 RL 权重优化(MetaClaw Full)后,Kimi-K2.5 的 File-check 完成率在 Part I 暴涨 8.25 倍(从 2.0% 到 16.5%), Part II 更是冲到 51.9%——直接追平了 GPT-5.2 的 baseline 水平。
为什么会这样?
论文里给了一个非常深刻的解释:技能库释放了模型的“推理深度”。
想象两个学生做物理题。一个学生花 20 分钟背公式,剩 40 分钟做题;另一个学生带了公式表,60 分钟全用来推理。谁的复杂题做得更好?
File-check 任务的本质,是多步骤、有依赖关系、容错率极低的执行链——你要先检查路径、再读文件、再解析 JSON、再验证 schema、再写输出,任何一步出错整个任务就挂了。这种任务最消耗的不是“知识”,而是“执行过程中的注意力分配和错误预判”。
当技能库把“检查路径”“备份原文件”“遵守命名规范”这些程序性知识显式注入 prompt 后,模型不用再从头推导“我现在该注意什么”,直接把全部算力用在“怎么把这些步骤串起来、怎么处理边界情况”——相当于把模型的早期层从静态规则重建里解放出来,把全部网络深度都留给了更有价值的复杂推理。
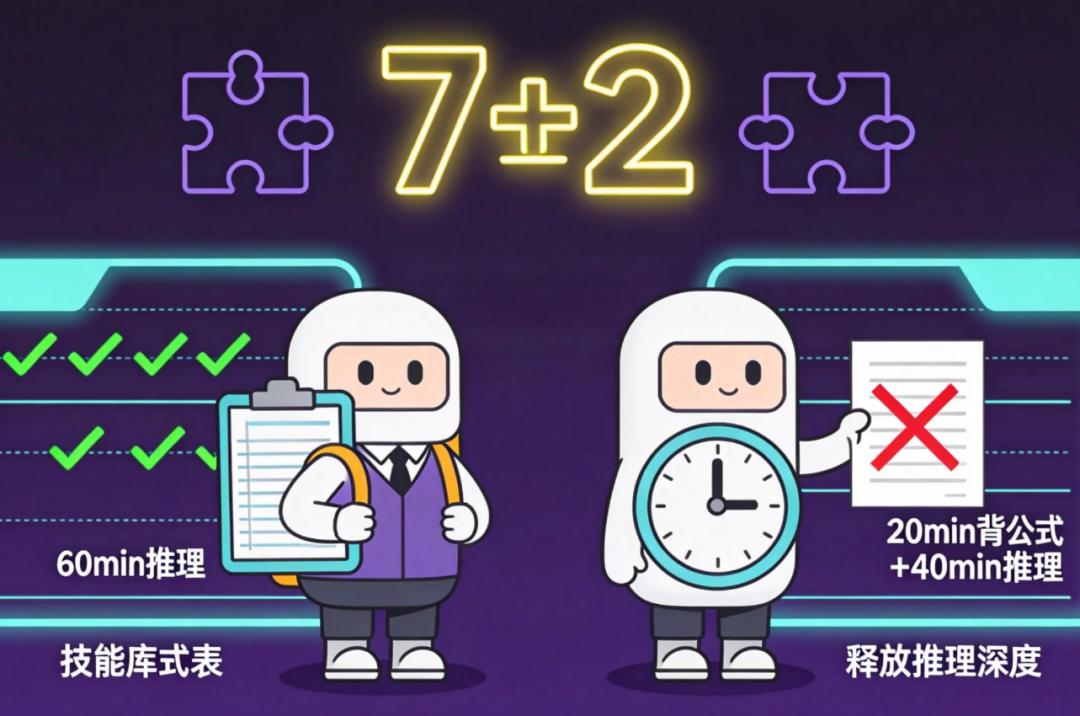
George A. Miller @ Psychological Review: “The Magical Number Seven, Plus or Minus Two: Some Limits on Our Capacity for Processing Information.”
这个发现给我最大的启发,其实是一个最朴素的认知科学原理:人类的工作记忆容量是有限的(7±2 chunks),真正的专家和新手的区别,不是记忆力更好,而是把该记住的东西“组块化”(chunking)了,腾出工作记忆去做更高阶的推理。
MetaClaw 的技能库,本质上就是在给 LLM 做“认知组块”——把程序性知识预先打包好,让模型不用每次都从零重建,直接调用。
零停机进化的秘密:三重闲时信号 + 轨迹版本控制
看到这你可能会问:RL 训练需要更新模型权重,怎么做到零停机?
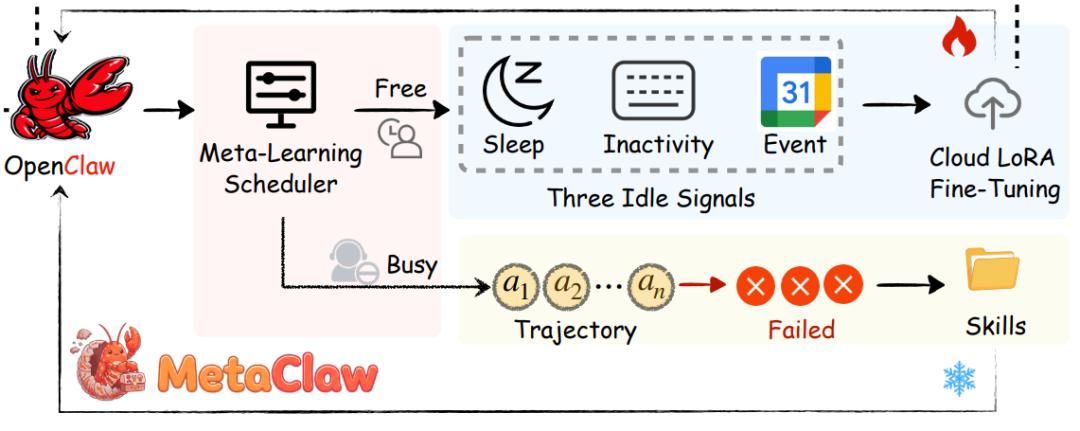
这是 MetaClaw 工程设计最狠的地方——Opportunistic Meta-Learning Scheduler(OMLS,机会主义元学习调度器)。
它同时监听三个“用户不在”的信号:
1. 睡眠窗口:用户配置作息时间(比如 23:00-07:00),这段时间系统保证空闲,提供最大的连续训练块
2. 系统无输入:轮询操作系统的输入设备空闲计时器(macOS 上是 ioreg HIDIdleTime),如果 30 分钟没有键盘鼠标活动,就开启训练窗口;一旦检测到新输入,立刻暂停训练并保存 checkpoint
3. 日历感知调度:查询用户的 Google Calendar API,如果当前时间在会议日程里,说明用户在开会,也是训练的好时机
只要任何一个信号显示用户不在,就开启训练;任何一个信号显示用户回来了,就暂停。训练器支持跨碎片化空闲窗口的 pause/resume,不需要一整块连续时间。
更关键的是,训练完成后的权重热替换,只在用户确认空闲时才执行,整个过程对用户完全透明。
但还有一个更隐蔽的技术难题:哪些数据能用来训练?
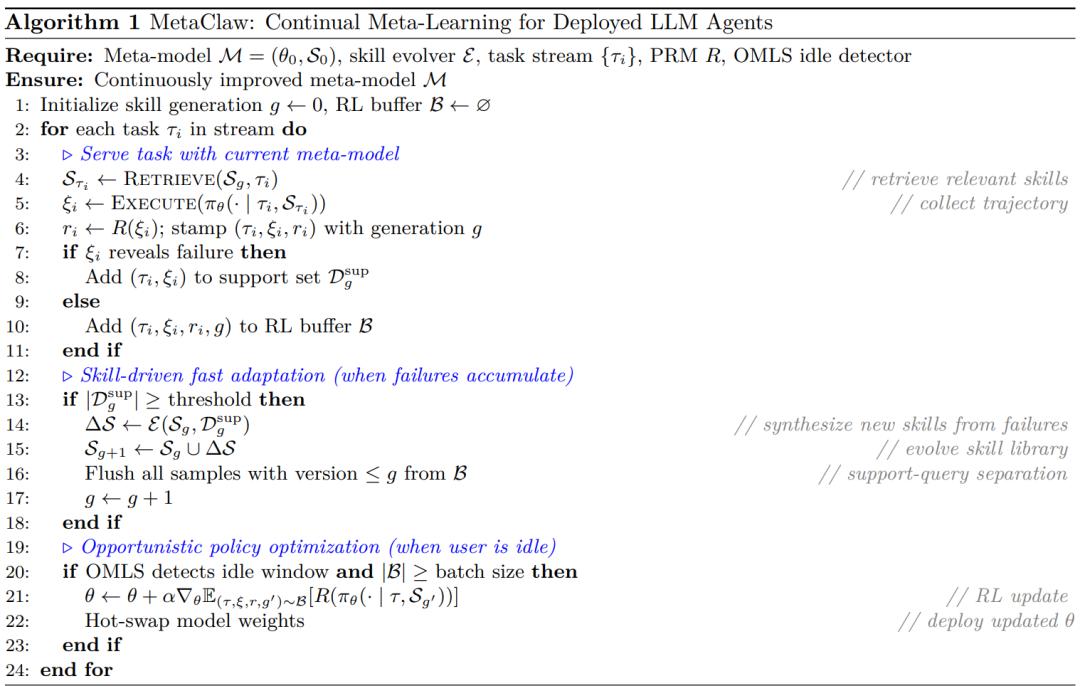
这是论文里最精妙的设计——Skill Generation Versioning(技能代版本控制)。
问题是这样的:假设第 5 天,Agent 因为没验证文件路径失败了,系统提炼出一条新技能,技能库从𝒮₃升级到𝒮₄。那第 5 天这条失败轨迹能不能用来训练模型?
绝对不能。
因为这条轨迹的 reward,是在“没有这条技能”的情况下得到的——它失败了,得到负 reward。但如果你用这条数据去更新模型权重,相当于在惩罚模型“在没有技能的情况下失败了”,而实际上现在技能已经加上了,这个失败已经被修正了。用过期的 reward 训练,会让模型优化错误的目标。
MetaClaw 的解决方案是:把轨迹分成 support data(触发技能进化的失败轨迹)和 query data(技能进化后收集的新轨迹),只有 query data 才能进 RL 训练 buffer。
具体实现是:每条轨迹打上技能代版本号(generation index g),每当技能库从𝒮ₘ升级到𝒮ₘ₊₁,训练器就把 buffer 里所有 version ≤ g 的样本全部 flush 掉,确保策略优化永远用的是“当前技能库下的表现数据”。
这个设计直接对应了元学习里的 support-query 分离原则,但 MetaClaw 把它搬到了在线、异步、非平稳的真实部署场景里——这是我看到的第一个在生产环境真正 enforce 这个原则的系统。
从 21.4% 到 40.6%:一个二线模型如何追平 GPT-5.2
实验数据最震撼的地方,不是绝对数字有多高,而是 MetaClaw 能让一个能力明显弱的模型,通过持续进化,追平顶级模型的 baseline 表现。
在 MetaClaw-Bench Part I(30 个工作日,346 道题)上:
• GPT-5.2 baseline:41.1% 准确率,14.7% file-check 完成率
• Kimi-K2.5 baseline:21.4% 准确率,2.0% file-check 完成率——整整落后一倍
• Kimi-K2.5 + MetaClaw (Full):40.6% 准确率,16.5% file-check 完成率——几乎完全追平 GPT-5.2
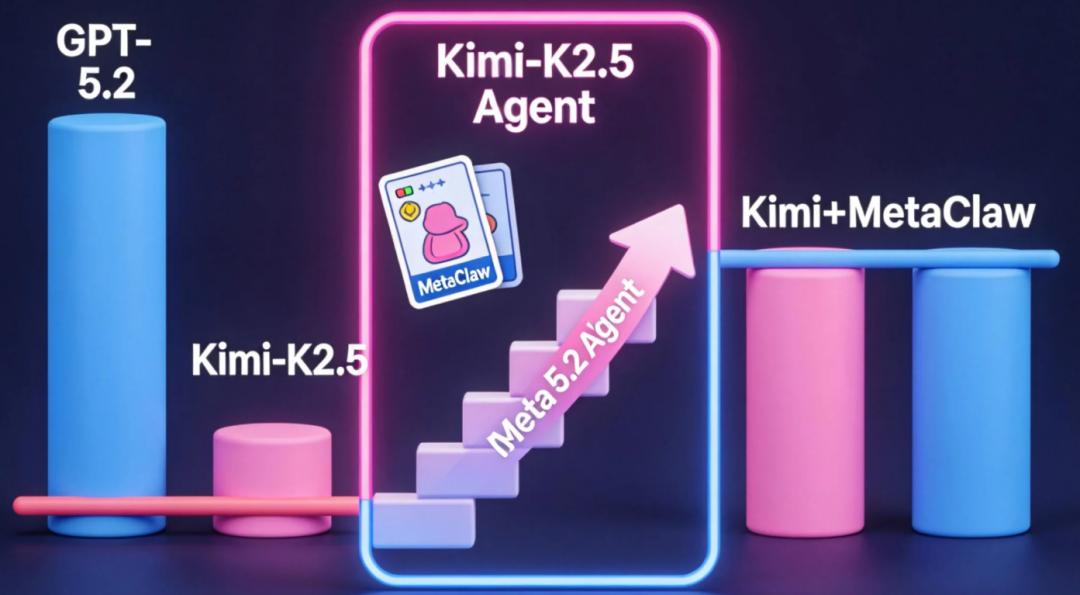
这意味着什么?
意味着一个部署成本更低、推理速度更快的模型,通过在真实使用中持续学习,可以在特定领域达到甚至超越顶级闭源模型的表现。
更关键的是,这个提升不是靠“多训练几轮”刷出来的——MetaClaw 的进化是在真实使用中、用真实失败案例、零人工标注完成的。
论文里还有个特别有意思的发现:越强的模型,从 MetaClaw 获得的收益越小;越弱的模型,收益越大。
GPT-5.2 加了技能库,准确率只提升 7.1%; Kimi-K2.5 提升了 32.2%。
为什么?
因为 GPT-5.2 在预训练时已经隐式学到了很多过程知识(procedural knowledge),技能库提供的显式规则对它来说是“锦上添花”;而 Kimi-K2.5 缺少这部分知识,技能库对它来说是“雪中送炭”。
这个 pattern 给产业界一个非常明确的信号:如果你想用一个性价比高但能力稍弱的模型做生产部署,MetaClaw 这类持续学习框架,可能比无脑堆更大的模型更划算。
跨域验证:从 CLI 任务到 23 阶段自主科研流水线
MetaClaw-Bench 是一个人工设计的模拟基准,你可能会问:这套机制在真实的、开放式的、长链条任务上还 work 吗?
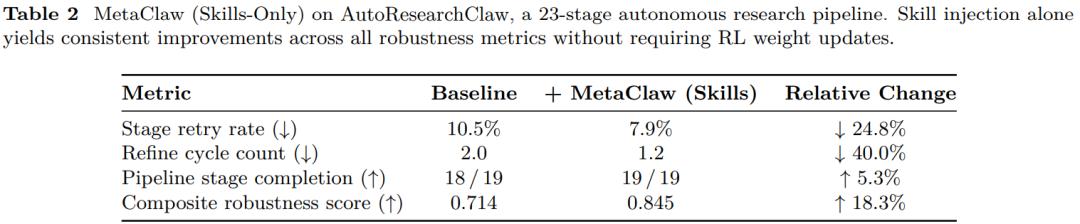
研究者在 AutoResearchClaw 上做了验证——这是一个完全自主的 23 阶段科研流水线:从一个 research idea 开始,自动做文献检索、假设生成、实验设计、代码合成、沙盒执行、结果分析、论文撰写、多 Agent peer review,最后输出一篇会议级论文。
这个场景和 MetaClaw-Bench 完全不同:没有结构化的 file-check,没有明确的对错,失败表现为阶段重试、过度 refinement、流水线卡住。
结果:只用技能注入(不做 RL 权重更新), MetaClaw 就把阶段重试率降低了 24.8%(从 10.5% 到 7.9%), refinement 轮数减少 40%(从 2.0 轮到 1.2 轮),流水线完成度从 18/19 提升到 19/19,综合鲁棒性得分提升 18.3%。
这说明什么?
说明 MetaClaw 的轻量级、零停机的技能注入机制,对复杂、长时程、开放式的 Agent 工作流同样有效——你不需要重新设计系统,不需要调超参,只要把失败信息喂给技能进化器,它就能自动提炼出可迁移的行为规则。
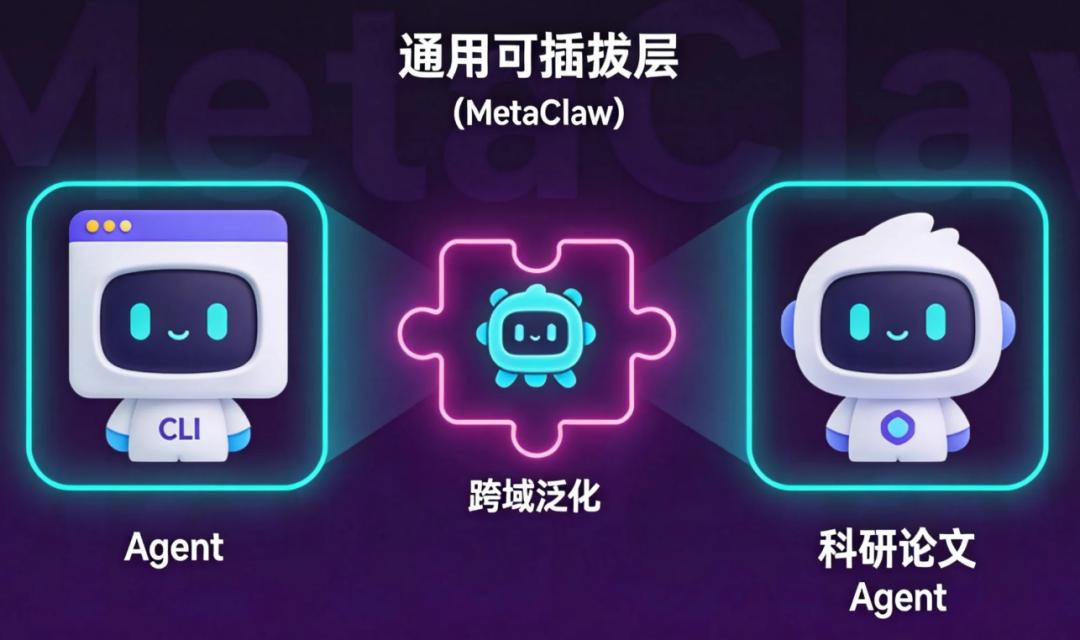
这种跨域泛化能力,是我认为 MetaClaw 最有产业价值的地方:它不是一个针对特定任务的优化 trick,而是一个通用的、可插拔的持续学习层,能直接嵌入任何现有的 Agent 系统。
这篇论文给我最大的启发:记住该记的,思考该思考的
真正聪明的系统,永远是知道什么该记住、什么该思考的系统。
MetaClaw 的技能库,记住的是那些“答案固定、可预存、跨任务通用”的程序性知识——O(1)的查表,永远比 O(n)的重复计算快。
MetaClaw 的权重优化,提升的是“如何理解上下文、如何组合技能、如何处理边界情况”的底层推理能力——这些是无法预存的,必须通过梯度更新 internalize 到参数里。
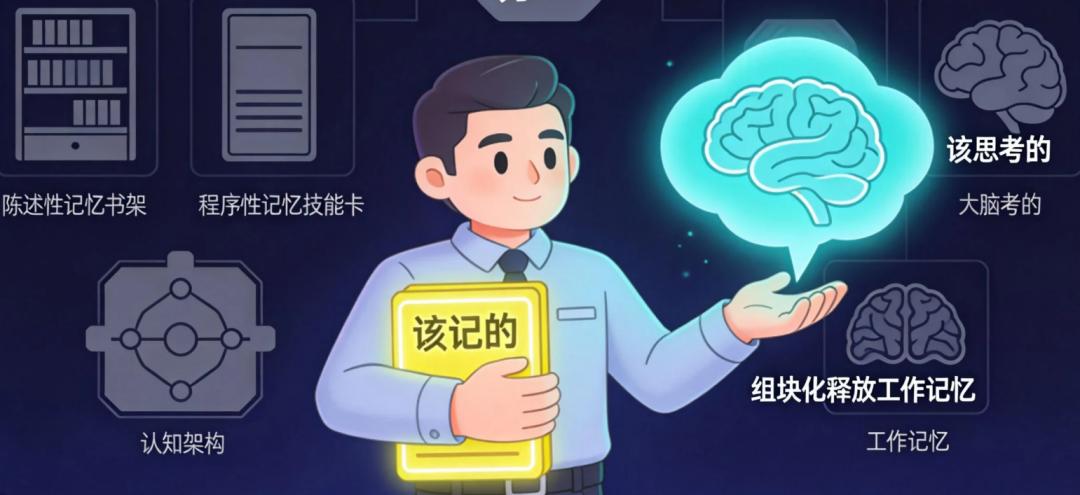
这个设计哲学,和人类的认知架构高度一致:陈述性记忆(declarative memory)负责存储事实和规则,程序性记忆(procedural memory)负责存储“怎么做”的技能,工作记忆(working memory)负责实时推理和决策——三者分工明确,互相配合。
这篇论文给我最大的启发,其实跳出了 AI 技术本身:在任何需要持续学习的系统里,快速适应和深度优化,从来不是对立的,而是互补的。前者让你不掉队,后者让你真正变强。
真正能在野外生存、持续进化的 Agent,是那些知道什么该立刻记住、什么该慢慢内化的系统。
MetaClaw,可能是我们离这个目标最近的一次尝试。
参考资料
论文链接:https://arxiv.org/abs/2603.17187