ASDA:自动生成skill增强LLM金融领域推理能力,算术性能提升17.33%,推理性能提升5.95%
“ASDA: Automated Skill Distillation and Adaptation for Financial Reasoning”
大语言模型(LLMs)进行金融领域适配通常需复杂训练微调,并且模型只能掌握固定的专业知识。目前已经出现了无训练的替代方案,但GEPA和ACE等方法在FAMMA金融推理基准测试中收效甚微。
本文提出自动化技能蒸馏与适应(ASDA)框架,通过迭代纠错学习自动生成结构化skill工件,无需修改模型权重。在FAMMA上评估,ASDA在算术推理上提升达17.33个百分点,在非算术推理上提升5.95个百分点,大幅超越所有无训练基线。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
本文提出自动化skill蒸馏与适应(ASDA)框架,通过迭代纠错学习自动生成结构化skill工件,无需修改模型权重。教师模型分析学生模型在金融推理任务中的失败情况,按子领域和错误类型聚类错误,合成包含推理程序、代码模板和示例的skill文件,在推理时动态注入。在FAMMA上评估,ASDA在算术推理上提升达17.33个百分点,在非算术推理上提升5.95个百分点,大幅超越所有无训练基线。生成的skill工件可读、可版本控制,符合Agent Skills开放标准,为有标注领域数据集的组织提供无需访问权重或重新训练的实用、可审计的领域适应途径。
简介
金融推理对通用大语言模型是独特挑战,需兼顾多步定量计算与领域特定判断。多基准评估显示模型存在性能上限,错误多源于领域知识缺口,增加参数无法解决,特定领域微调成本高、易过时且依赖监督资源。自动提示优化缺乏多步推理所需的模块化和可执行性。为此引入自动skill蒸馏与适应(ASDA)框架,其无需修改模型权重,通过错误分析自动生成可执行Agent skill。在 FAMMA 上评估,ASDA 经迭代优化后在算术和非算术推理上显著提升,生成的skill库是模型与部署环境间新的可版本控制、审核和再生的表征层。
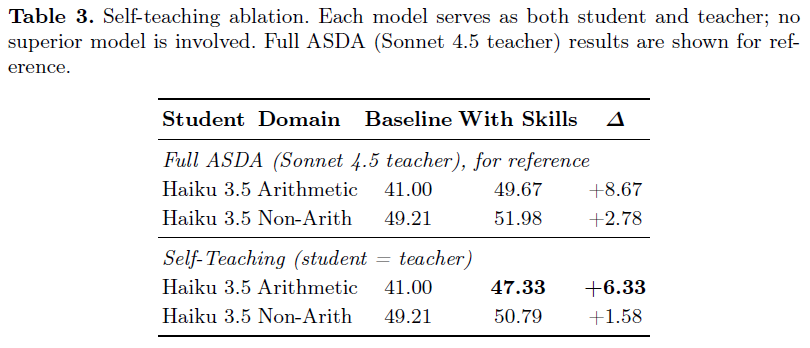
ASDA框架是首个仅用黑盒大语言模型访问自动生成特定领域推理可执行Agent skill的系统,在FAMMA上大幅超越所有无训练基线。ASDA仅用训练集中的问题和答案就能提升模型,无需更优教师模型,实现6.33个百分点提升(达全增益73%),适用于有标注领域数据集的企业直接部署。
相关工作
LLM金融领域适配
领域特定微调是使大语言模型适应金融任务的主流方法。BloombergGPT展示金融特定预训练潜力,但资源需求大;FinGPT通过基于LoRA的微调提供更易获取的方案;Xue等人探索从DeepSeekR1蒸馏到小模型用于金融推理。不过,所有微调方法都有局限性,会产生模型锁定的专业知识,基础模型更新或替换时需重新训练,且很多与商业大语言模型的黑盒API访问不兼容。
无需训练的领域自适应
自动化提示优化提供无权重替代方案,如自动文本微分或可优化模块组合。GEPA通过反射式提示进化在多基准测试中达SOTA,ACE在推理时积累知识,但输出为扁平文本,无法满足复杂领域推理。另一类工作以失败分析为学习信号,LEMMA为数学推理合成基于错误类型的训练数据,ASDA将此原则扩展到无训练可执行skill生成。测试时间训练(TTT)需梯度访问,与黑盒API部署不兼容,ASDA填补了两者间的空白。
基于skill的Agent架构
近期智能体研究探索skill库作为可复用知识产物,Voyager用JavaScript代码实现可组合执行skill,Agent Skills标准规范了Markdown skill文件,ASDA生成与之兼容的skill产物。skill提炼方面,SkillRL从交互智能体轨迹中提炼分层skill并与强化学习策略协同进化,需SFT和权重更新;而ASDA从错误分析中提炼推理模式用于静态领域问答,无需训练,兼容仅API模型。此前无工作解决从错误分析进行特定领域推理的自动化、无训练skill生成问题,ASDA填补此空白。
ASDA
ASDA采用师生架构,分两阶段:
1)预热流程,从系统误差分析建立初始skill库;
2)迭代优化循环,通过反复收集和验证证据优化skill。
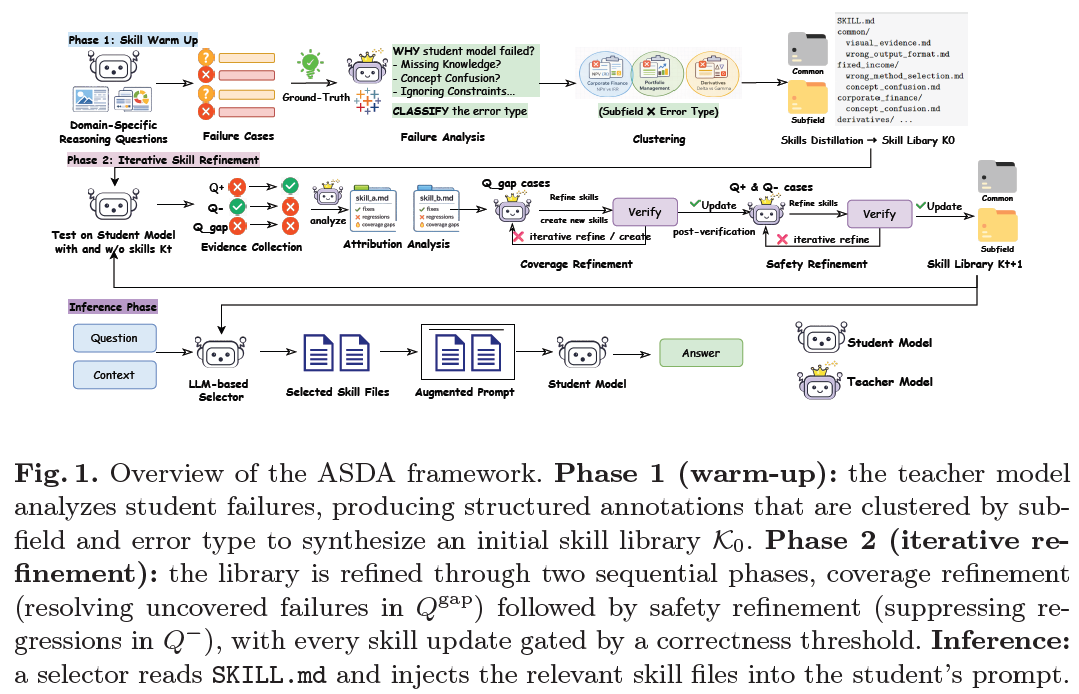
在描述每个阶段之前,我们先介绍贯穿始终的三个术语。错误类型是预定义分类法中的十个类别之一。模式是skill文件中单个的、命名的失败场景、一个特定的知识差距或模型所犯的重复错误。skill文件将所有共享相同财务子字段和错误类型的模式分组;例如fixed_income/wrong_method_selection。Md收集固定收益子领域中观察到的所有错误方法失败。
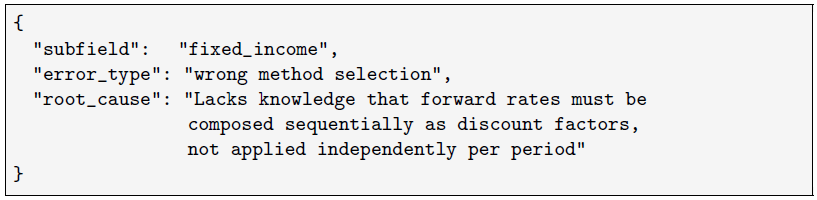
故障分析与结构化标注:热身阶段根据学生模型在训练集的失败构建初始skill库 K0,教师接收错题信息进行故障分析,输出结构化标注,明确错误类型和根本原因。
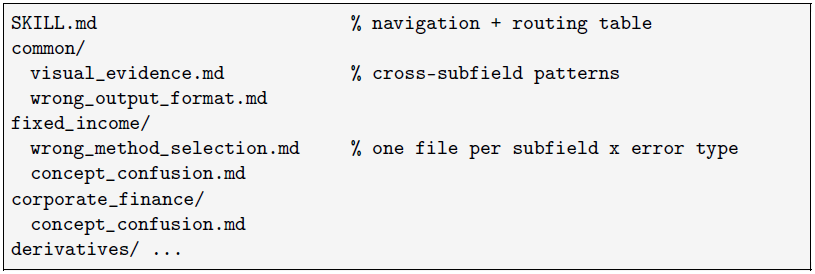
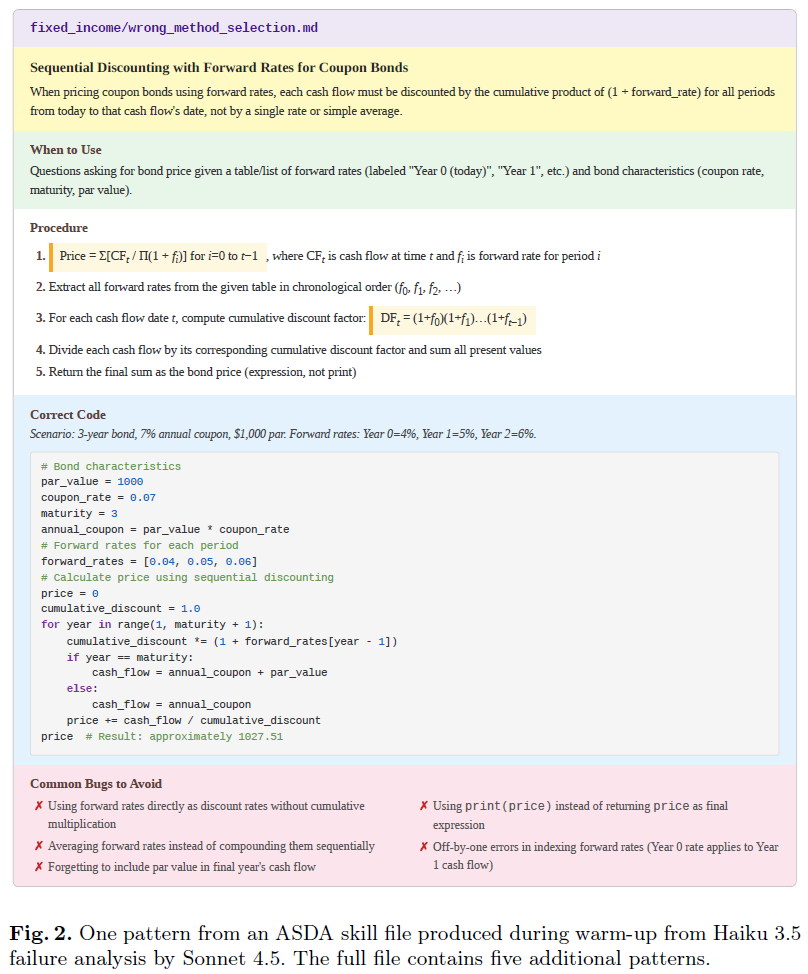
skill选择与注入:推理时,基于大语言模型的选择器根据问题文本和 SKILL.md 映射表确定相关金融子领域,匹配问题特征,可选择多个skill文件注入学生提示,引导推理。
双阶段迭代skill细化
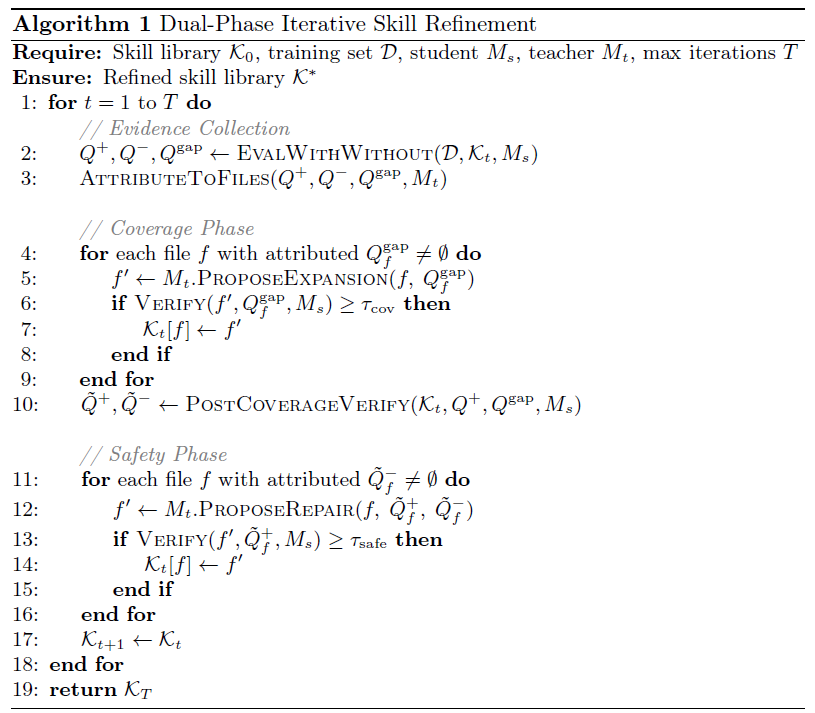
迭代精炼解决问题:热身阶段存在覆盖缺口和回归问题,通过迭代精炼解决,包括覆盖阶段和安全阶段,每次skill更新需通过验证门,不达标则重新生成提案,最多尝试Nmax次,否则回退。
证据收集与归因:每次迭代开始时,评估训练问题,分Q⁺ₜ(有skill正确)、Q⁻ₜ(有skill错误无skill正确)、Qgapₜ(两种情况都错误)三组,归因确定各文件对结果的贡献。
覆盖阶段:教师诊断Qgapₜ归因文件的覆盖失败原因,提出更新提案,通过验证门(恢复率超τcov)后更新,之后重新评估,更新正集和回归集。
安全阶段:解决Q⁻ₜ中的回归问题,教师根据Q⁺ₜ和Q⁻ₜ提出修订skill,通过验证门(τsafe),保证正例准确率不下降且恢复更多负例。
迭代更新:完成两阶段后,更新skill库Kₜ₊₁用于下一迭代。
实验设置
FAMMA基准
FAMMA-Basic提供管道所需的规模、算术/非算术分解及自包含文本上下文,含1945道源自大学教材和专业金融考试的题目,覆盖八个金融子领域、三个难度级别,明确区分算术与非算术问题以分别评估程序和概念skill效果。使用FAMMA-BasicTxt版本,其为每题提供OCR提取的文本上下文,确保评估针对推理能力而非检索。
数据过滤和拆分
为控制语言差异,将语料限制为 1378 个英语问题,使性能差异仅反映推理能力。因 FAMMA 无官方训练 - 测试划分,自行构建:将英语语料分为算术和非算术子集,按难度(易、中、难)和问题类型(选择题、开放式)进行 60/40 分层划分。得到算术训练题 448 个、测试题 300 个,非算术训练题 378 个、测试题 252 个。报告结果基于这些测试集,与 Xue 等人结果无可比性。
评估指标
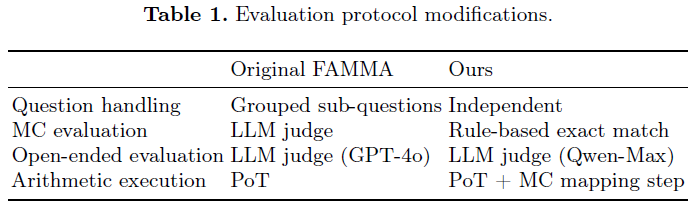
ASDA蒸馏管道按单个问答对操作,独立评估问题,将FAMMA组内首问共享上下文传播至所有子问题。6道算术题用PoT代码执行,有选择步骤匹配答案到选项。评估采用混合法,选择题用规则精确匹配,开放题用LLM判断。验证表明修改未夸大收益,换模型判断一致性达99.3%,采用FAMMA原策略结果相同。
基线
将ASDA与GEPA、ACE两种免训练自适应方法对比,二者在黑盒API访问且不修改权重的约束下运行,均优化统一应用于所有问题的单一整体文本。基线条件使用带标准任务提示的学生模型。GEPA和ACE此前未在FAMMA上评估,此次为首次。为确保公平比较,根据各方法架构要求调整训练条件。
实验设置
Qwen-Max 作开放式问题 LLM 评估裁判,Qwen-Turbo 负责将数值 PoT 输出映射到答案选项的 MC 选择步骤,推理温度设为 0 确保可重复性。
实验分析
主要结果
评估:对ASDA在两个学生模型的算术和非算术任务上进行评估,以GEPA和ACE为Haiku 3.5训练-free参考点,其在FAMMA上提升有限,显示flat - text优化结构局限。
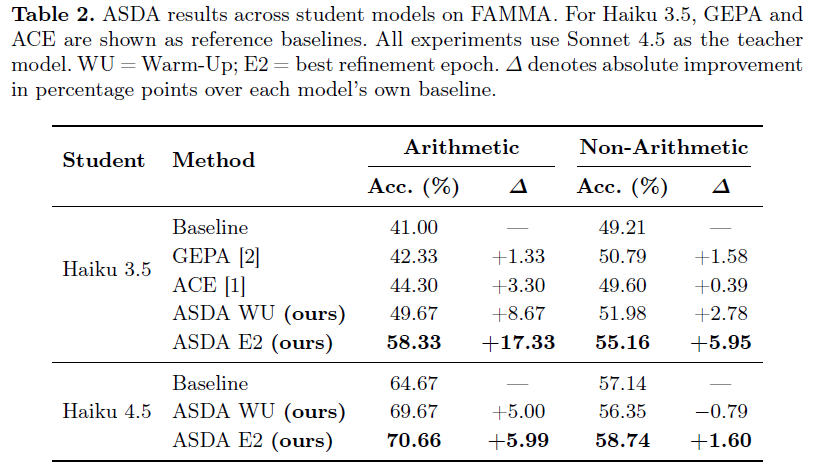
性能提升:ASDA持续提升Claude - family学生模型性能,Haiku 3.5算术任务热身时提升8.67 pp,两轮精炼后提升17.33 pp;Haiku 4.5算术提升5.99 pp,非算术提升较小。
迭代精炼效果:热身阶段针对常见失败模式获首波大提升,迭代精炼处理剩余失败,算术和非算术在第二轮精炼达最优,第三轮出现过拟合。
题型增益:skill对选择题增益大于开放式问题,选择题答案空间受限,skill引导更有效。
回归风险:常见为skill诱导过度推理,因选择器加载skill文件捆绑,正确作答题目可能因不必要阐述被干扰。
定性分析
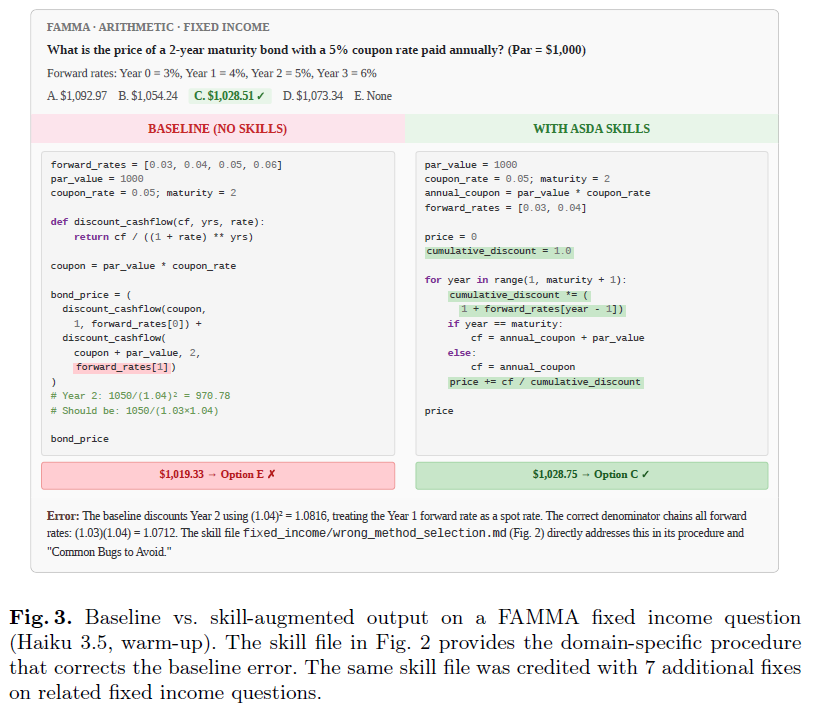
图3展示Haiku 3.5热身评估中算术案例,基线失败而skill注入成功,同一skill文件还解决7个相关固定收益问题,体现子领域特定skill工件的可重用性。
改善从何而来?自学习消融分析
ASDA的收益可能源于优秀教师模型贡献的知识或训练数据本身。通过自适应配置(学生模型自当教师)分离两者,在Haiku 3.5算术任务中,自适应提升6.33 pp,达使用Sonnet 4.5教师提升8.67 pp的73%,表明大部分收益来自训练数据。训练题仅提供问题和答案,模型能从自身错误中识别失败模式并合成skill。剩余2.34 pp差距体现教师贡献,更强模型诊断更准、skill提炼更精确。非算术任务也有类似模式(自适应提升1.58 pp,用Sonnet教师提升2.78 pp)。
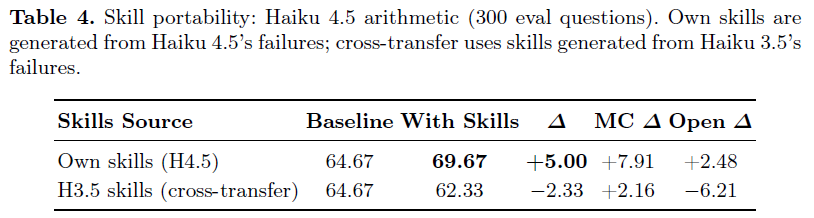
研究探讨skill跨模型转移效果,将 Haiku 3.5 失败生成的skill用于 Haiku 4.5,与 Haiku 4.5 自身失败导出的skill对比。跨模型转移净回归 -2.33 pp,开放式问答大幅下降(-6.21 pp)抵消了选择题小幅度提升(+2.16 pp);而 Haiku 4.5 使用自身skill在两类问题上均提升 5.00 pp。实际应用中,应独立为每个部署模型生成skill,跨模型复用skill难有正向收益甚至损害更强模型,且特定学生skill提炼在部署规模下操作可行。
总结
ASDA的自适应结果显示,ASDA改进主因是蒸馏过程结构而非教师知识,跨模型skill无法通用,skill是特定模型故障补救措施。在应用上,受监管行业可在标注数据集上运行蒸馏流程,版本控制skill文件,模型升级时重新生成。故障模式集中、任务有明确程序结构时,ASDA效果最佳,诊断质量影响适应效果。失败驱动蒸馏可将潜在领域知识外显,skill是特定模型故障补救,skill库是新表征层,能否推广及自适应替代强监督程度待研究。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
