8.25倍完成率,悄悄进化的龙虾诞生!丢掉外挂记忆库,每次报错都在变强
长久以来,模型训练完就处于静止状态,固守着出厂时的智慧,不会在真实的交互中积累经验。
来自北卡罗来纳大学、卡内基梅隆大学、加州大学的研究团队,构筑了一个能够真正在野生环境中自主进化的智能体系统MetaClaw。
通过提取失败教训生成行为准则,并在用户离开电脑的间隙利用日历和屏幕休眠信号,MetaClaw能悄无声息地在云端重塑大脑的神经网络。
MetaClaw构建了一个持续元学习框架,巧妙融合了不触碰底层参数的瞬间Skill注入,与基于过程奖励模型的深度策略优化。加上严格的代际版本隔离机制,在不中断任何日常服务的前提下,模型的任务完成率实现了高达8.25倍的惊人跨越。
停滞不前的智能助理
智能体早已展现出处理复杂多步任务的惊艳能力。人们期待智能体能够像一位真实的新员工,在日复一日的磨合中逐渐摸清老板的脾气,记住团队特有的文件命名规范,避开曾经踩过的雷区。
而部署在开放世界中的大多数智能体,始终处于静态锁死的环境里,经历过一次昂贵的预训练之后,便再也不会随着用户需求的变化而更新自身的内在逻辑。
以OpenClaw为例,单一智能体会接入超过20个信息流渠道,背负着繁杂且随时变动的工作负载。
用户的核心需求可能在上半个月全部集中于多步骤的文件系统重构,下半个月又突然转向多智能体之间的通讯协同。
面对任务分布的无规律漂移,一个参数被彻底冻结的模型会迅速与实际使用场景脱节,在那些预训练阶段覆盖不足的边缘任务上反复遭遇同样的失败。
技术界试图为模型加上记忆或Skill库来缓解上述困境。
基于记忆的方法倾向于把智能体曾经有过的完整对话轨迹原封不动地存入数据库,等待未来的某次检索。
原生的对话轨迹往往充满冗余和细枝末节的杂音,智能体很难从中提炼出放之四海而皆准的行为模式。
另一派基于Skill的方法,选择把过往经验浓缩成可复用的自然语言指令,仅仅把积累下来的Skill库当成一个外挂的静态词典,完全切断了与模型底层权重优化之间的联系。
引入强化学习来更新模型权重的路线同样面临不可逾越的鸿沟。
现有的强化学习机制通常在封闭的小规模离线环境里运行,并且完全无视了一个极其隐蔽的数据有效性危机。
伴随着智能体Skill库的不断扩充,过往收集的对话轨迹其实携带着旧版Skill背景下的过期奖励信号,将旧时代的考核标准直接用于更新新时代的模型参数,会严重污染梯度下降的方向。
每一种传统方法,都仅仅触及了模型适应能力演化的单点。
慢工细活与电光石火的交织
技术团队在MetaClaw中寻找到了一种精妙的平衡,将两种运作在截然不同时间尺度上的进化机制完美嵌套在同一个持续元学习框架内。
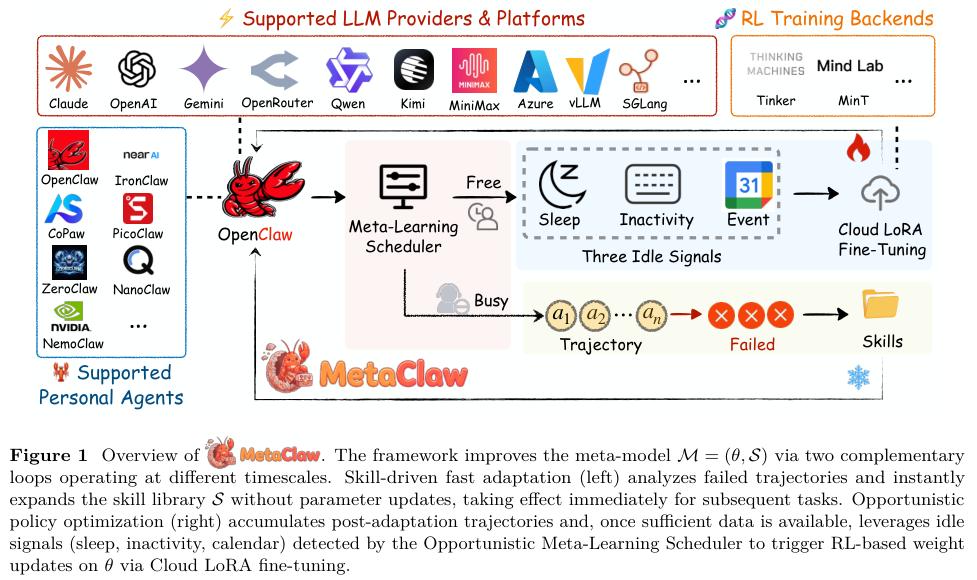
整个系统的演化轨迹不再是单向的参数微调,而是一套包含基础策略模型和不断膨胀的Skill库的复合双子星结构。
负责在电光石火间完成局部修复的是Skill驱动的快速适应引擎。
在没有梯度下降、不改变任何神经元权重的纯自然语言空间里,一个专门充当进化器的大语言模型会紧盯智能体每一次搞砸的任务轨迹。
仅仅通过一次失败的交互,进化器就能在几秒钟内抽丝剥茧,总结出诸如“读取文件前务必验证路径”或“执行破坏性命令前必须备份”这样凝练的经验法则。
新诞生的规则会立刻被收录进Skill库,并在下一次处理相关任务时,通过余弦相似度检索瞬间注入到智能体的系统提示词中。
系统无需经历任何重启与停机,就能凭借举一反三的能力立刻避开同样的陷阱。
填补底层能力短板的则是伺机而动的策略优化机制。
在积累了足够多的任务轨迹后,系统会引入过程奖励模型(PRM),针对智能体完成任务的每一个具体步骤进行细粒度的打分评估。
随后,MetaClaw会在云端通过LoRA技术对模型权重发起强化学习更新。
这里的核心奥秘在于,系统优化的目标根本不是为了提升原始任务的得分,而是致力于提升智能体在接收到新Skill指令后的执行服从度和配合度。
两套机制在MetaClaw体内形成了一个生生不息的良性循环。
底层权重的夯实能够让模型在失败时暴露出更具价值、逻辑更深层面的错误,从而喂养Skill进化器合成更为高级的战术指令。
而更加丰富精准的Skill库,又能引导智能体走出更具高回报潜力的正确路径,反哺给强化学习引擎更优质的训练养料。
系统真正在岁月的流逝中学会了如何去学习。
为了防止不同时代的经验互相打架,研究人员精心设计了Skill生成版本管理协议。
在这个协议下,所有引发模型产生新Skill的那些失败轨迹被称为支撑数据,它们在提炼出新规则后便会被立刻丢弃,绝对不允许进入强化学习的训练池。
只有在注入新Skill之后、代表智能体新行为特征的查询数据,才拥有参与权重更新的资格。
每当Skill库实现了一次代际跃升,训练缓存区里所有携带着旧版本戳记的样本都会被清空,确保每一次梯度更新都精准对齐智能体当下最新的能力边界。
见缝插针的无感调度
在真实的生产环境中给一个正在全天候运转的大脑做外科手术,需要极尽克制的工程巧思。
策略优化不仅需要消耗算力,更会在权重热替换的瞬间短暂打断推理服务。
为了守护用户的无缝体验,MetaClaw引入了伺机元学习调度器(OMLS),一个隐匿在操作系统后台默默寻找训练窗口的幽灵管家。
调度器会如同狩猎般,同时监控三种完全互补的设备闲置信号。
最基础的一道防线是用户自定义的睡眠时间表,系统会在夜深人静的固定时段内获得最宽裕的连续训练时长。
而在白天的碎片时间,调度器会不断轮询操作系统的输入设备空闲计时器。只要键盘和鼠标保持绝对静止超过30分钟,一扇通往云端的强化学习窗口就会被悄然推开。一旦用户的指尖重新触碰鼠标,训练任务就会依靠批次间的检查点技术在毫秒级的时间内优雅地按下暂停键。
最体现智慧火花的则是调度器与谷歌日历API的深度绑定。
当指针滑动到用户提前预约的会议日程区间时,系统会极具前瞻性地判定电脑屏幕前空无一人,主动唤醒沉睡的训练进程。
任何一个表明用户离开的信号都会触发学习,任何一个代表用户归来的动作都会让系统立刻回归待命状态。
MetaClaw能够从容应对庞大的生产级参数规模,并且将高强度的运算全部抛向云端,用户的本地主机完全不需要配备昂贵的显卡。
仿真沙盒里的生存压力
为了探明MetaClaw的进化潜力,研究团队摒弃了传统测试集中碎片化、各自为战的题海战术,搭建了名为MetaClaw-Bench的连续沙盒试炼场。
这座沙盒完整模拟了44个高强度的工作日,总计抛出934个极度贴近真实工作流的棘手问题。
在沙盒的每一天里,文件系统、工程配置文件和项目修改记录都具备真实的记忆属性,前一个任务留下的烂摊子会原封不动地成为下一个任务的初始环境,倒逼智能体必须具备全局规划的视野。
沙盒的前30个工作日构成第一阶段,包含346个高度偏向底层执行的实操任务,涵盖复杂文本编辑、深层JSON结构梳理和底层Shell脚本编写。
任务的刁钻程度随着日期的推移直线上升,到了最后的5天里,智能体必须连续跨越多重逻辑陷阱,才能勉强摸到及格线。
随后的14天构成第二阶段,抛出了588道规则严苛的文件检查题,重点考验智能体能否将繁杂的命名约束、时间戳格式等行为准则真正刻进骨子里。
在分别以GPT-5.2和Kimi-K2.5作为核心大脑的对照实验中,MetaClaw展现出了摧枯拉朽般的统治力。
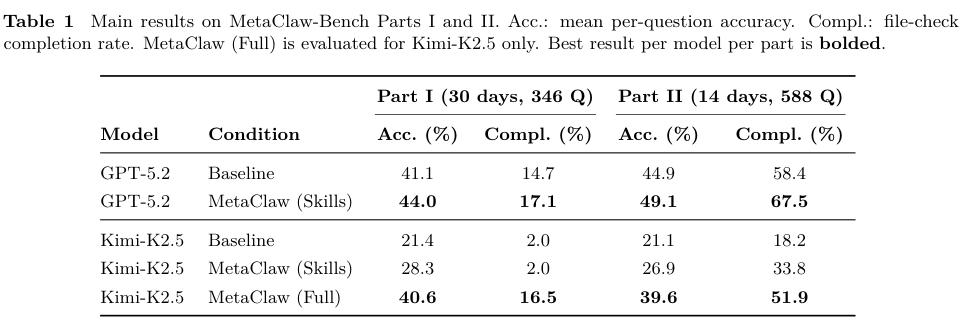
表1详细记录了MetaClaw-Bench两个阶段的测试数据。
在第一阶段的试炼中,仅仅依靠Skill注入的轻量级版本就让GPT-5.2的平均准确率从基准的41.1%爬升到了44.0%,Kimi-K2.5更是从21.4%暴涨至28.3%。
当Kimi-K2.5挂载上包含强化学习的完整版MetaClaw后,准确率一路狂飙至40.6%,几乎凭借一己之力抹平了与行业顶尖模型GPT-5.2之间的先天身位差距。
最为震撼的数据,藏在代表着端到端完美交付能力的文件检查完成率里。
仅仅依赖文字层面的Skill指导,Kimi-K2.5在第一阶段的完成率,依旧死死趴在2.0%的泥潭里。
一旦强化学习在后台完成了对执行稳定性的底层改造,完整版MetaClaw直接将完成率拔高到了16.5%,实现了8.25倍的核爆式增长。
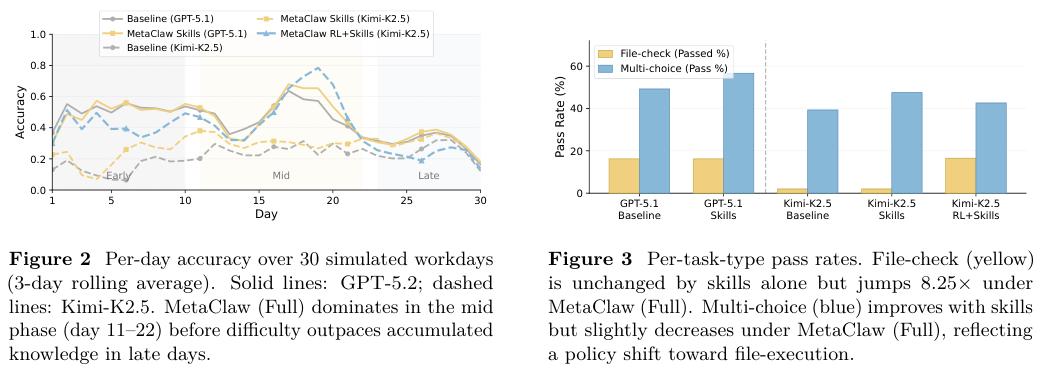
到了纯规则驱动的第二阶段,完成率更是从18.2%直接拉升至51.9%,相对涨幅高达185%。
数据清晰地勾勒出了两条截然不同的突围路线。单纯的Skill库注入犹如给模型塞进了一本详尽的操作指南,对于多项选择题,这样偏向于概念推理的任务有着立竿见影的奇效,却始终无法拯救手忙脚乱的执行端。当强化学习引擎介入后,模型才真正迎来了肌肉记忆的觉醒,将挂在嘴边的规则内化成了神经元深处的本能反应。
而且,本身能力越弱的基础模型,从这套框架中榨取到的上升红利就越发丰厚。
GPT-5.2自带庞大的隐性常识储备,Skill库能够提供的增量认知相对有限。
像Kimi-K2.5这样在预训练阶段未能遍历所有程序规范的模型,反而能如同海绵吸水般将Skill库里的显性知识照单全收。
通过将这套系统部署在极具性价比的开源模型上,企业完全可以在不牺牲质量的前提下,跨越生产级应用的成本门槛。
研究人员还MetaClaw无缝接入到包含23个独立环节的自动科研流水线AutoResearchClaw中。
面对从海量文献检索、复杂假说生成、沙盒代码验证直至多智能体同行评审的长线战役,仅仅开启无缝Skill注入的简配版MetaClaw就取得了惊艳的战果。
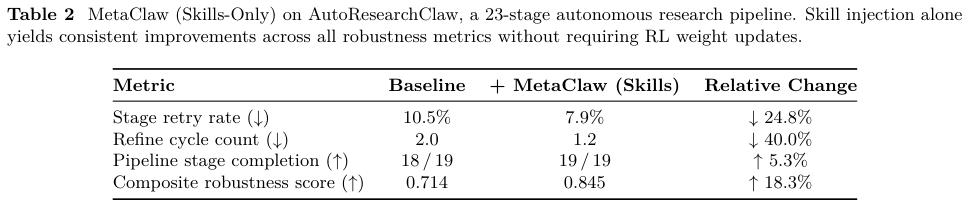
如表2所示,在不需要耗费一丁点算力去重写神经元权重的前提下,智能体跨越阶段时的重试率暴跌了24.8%,陷入死循环的修改次数锐减40.0%,综合鲁棒性得分迎来了18.3%的强势跃升。
表3展示了两个极具代表性案例,生动诠释了不同机制在实战中的互补之美。
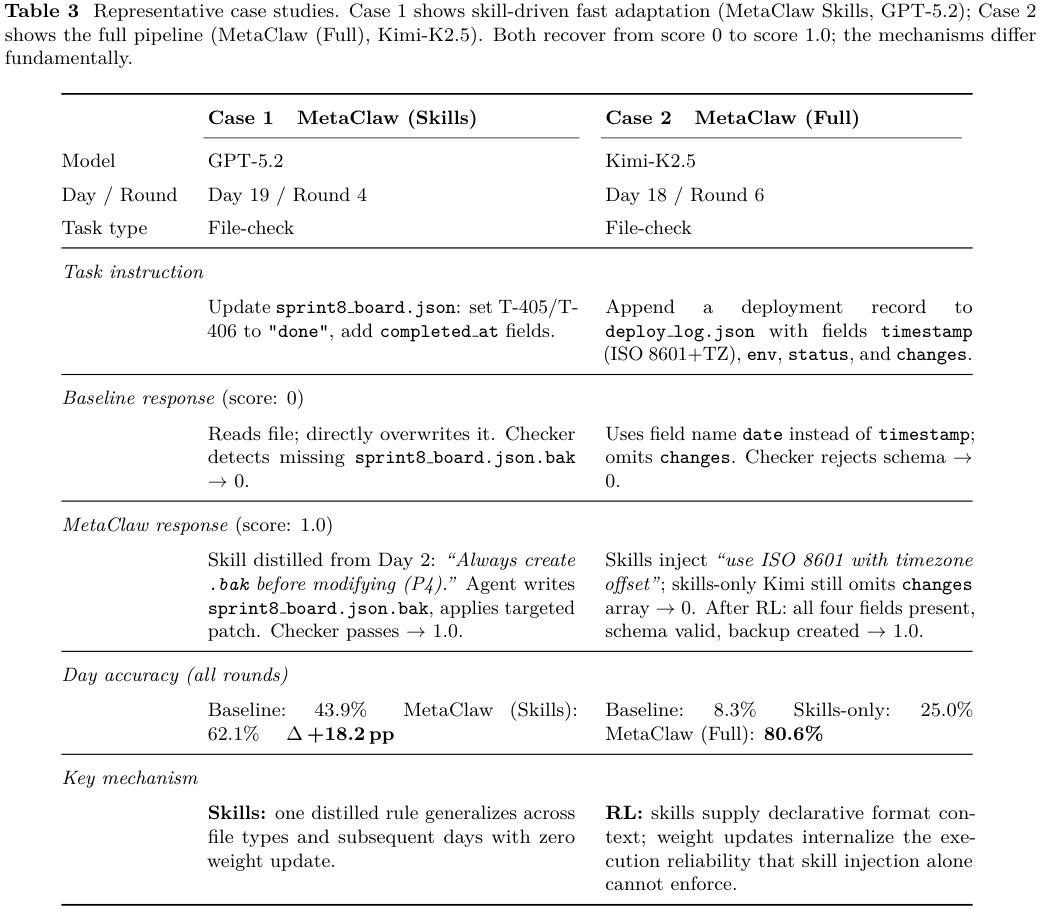
在第一个案例中,GPT-5.2接到指令去更新冲刺面板的JSON文件。原生的基线模型粗暴地选择了直接覆盖保存,被自动检查器以未创建备份的理由判定为零分。
搭载了Skill引擎后,系统立刻从第2天的历史失败中揪出了一条名为“在进行任何修改前必须生成.bak文件”的准则。智能体乖乖照做,仅仅依靠一句提示词的加持就拿下了满分,全程没有惊动任何参数更新。
第二个案例彻底暴露了纯Skill引擎的极限。任务要求在部署日志中追加一条携带复杂时区格式的记录,Kimi-K2.5不仅把字段名字写错了,还遗漏了整个改动数组,喜提零分。
即使Skill引擎敏锐地向系统注入了“强制使用携带时区偏移的ISO 8601标准”这条明确指令,模型依然在数组构建上掉了链子。
直到强化学习深度重塑了逻辑链路,模型才终于在输出符合规范时间戳的同时,稳如泰山地保留了所有必需的字段结构,完成了一次教科书级的满分救援。
MetaClaw真正打通了人工智能在部署后的生命线,让那些曾经被封印在冰冷硬盘里的参数,拥有了在硅基血液中奔流的自省本能。
参考资料:
https://github.com/aiming-lab/MetaClaw
https://github.com/aiming-lab/AutoResearchClaw
https://arxiv.org/pdf/2603.17187