FIRE:金融领域理论知识及实操综合评估基准
“FIRE: A COMPREHENSIVE BENCHMARK FOR FINANCIAL INTELLIGENCE AND REASONING EVALUATION”
大语言模型(LLMs)在金融领域应用受关注,但评估其处理复杂现实金融任务的能力仍是挑战。现有金融NLP基准多聚焦常规NLP任务,未评估解决真实金融业务问题能力。结果与业务价值联系弱,难量化AI投资回报率。
本文引入FIRE基准,含金融知识评估和真实金融操作两类任务,既评估 LLMs 理论金融知识,也评估其实践能力。构建和评估了3000个真实金融业务问题,1000题有参考答案可自动评估,2000题开发评分规则和自动评估流程。对包括 XuanYuan 4.0 在内的先进 LLMs 进行评估,公开基准问题和评估代码以利后续研究。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
大语言模型(LLMs)在金融领域应用受关注,但评估其处理复杂现实金融任务的能力仍是挑战。现有金融能力评估基准存在分类粗疏、重叠、忽视关键领域等问题,难以评估模型处理现实金融场景任务的能力。为此,推出综合基准 FIRE,既评估 LLMs 理论金融知识,也评估其实践能力。理论评估采用金融资格考试题目,实践评估构建系统评估矩阵,收集 3000 道金融场景问题。对包括 XuanYuan 4.0 在内的先进 LLMs 进行评估,公开基准问题和评估代码以利后续研究。
简介
大语言模型(LLMs)自ChatGPT发布后进步显著,能力从基础NLP拓展到数学推理、多模态推理等,还具备代理能力,加速在金融领域应用。除通用模型外,金融领域特定LLMs涌现,经预训练或微调可处理专业金融任务,应用涵盖投资报告生成、客服等。对LLMs金融能力的系统评估愈发重要,已提出众多金融基准来评估模型在特定任务上的表现。
现有金融NLP基准存在局限,多聚焦常规NLP任务,未评估解决真实金融业务问题能力。缺乏精细分类,结果与业务价值联系弱,难量化AI投资回报率,阻碍大模型在核心金融应用的大规模采用。
本文引入FIRE基准,含金融知识评估和真实金融操作两类任务,前者用专业资格考试问题,后者收集实际业务场景问题。
提出矩阵式评估框架,整合垂直业务和水平能力维度,用于构建和评估3000个真实金融业务问题,1000题有参考答案可自动评估,2000题开发评分规则和自动评估流程。
用FIRE评估通用和金融专业大模型,包括新开发的XuanYuan 4.0,揭示当前大模型在复杂金融领域的优劣势和能力差距。
FIRE
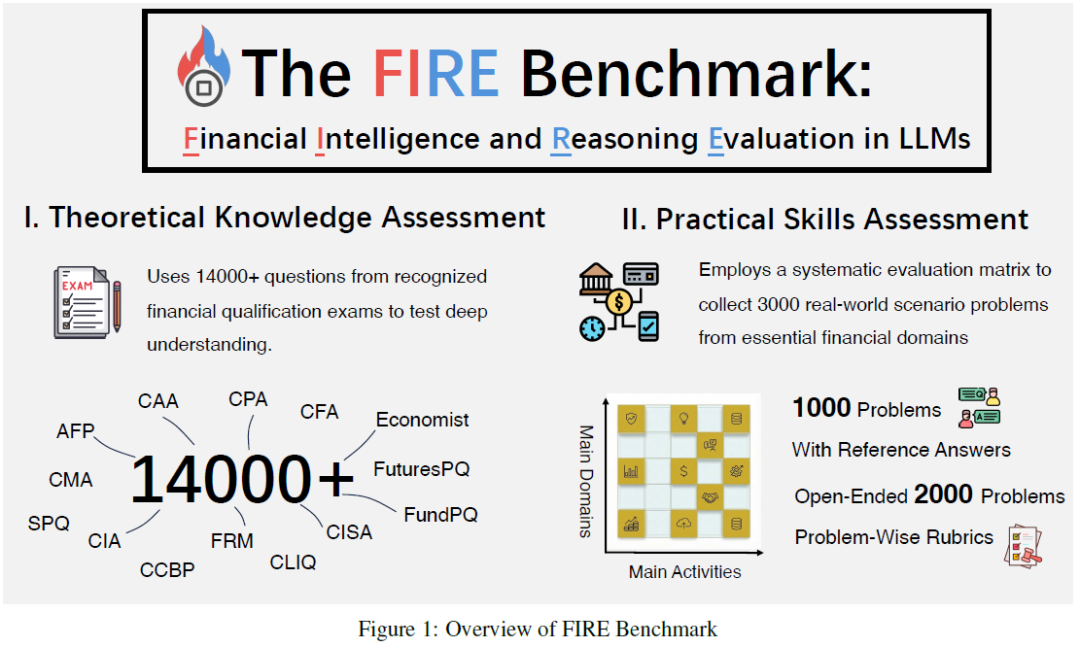
FIRE由度小满科技、清华五道口金融学院和人大财政金融学院联合开发,通过产学研合作确保能从理论和实践层面评估大语言模型。它包含两类问题:一是金融知识评估,用专业资格考试题目考查模型对核心金融概念的理解与应用;二是实践技能评估,用实际业务问题考查模型解决现实金融问题的能力。后续将详细介绍问题分类、评估协议和标准。
金融资质问题
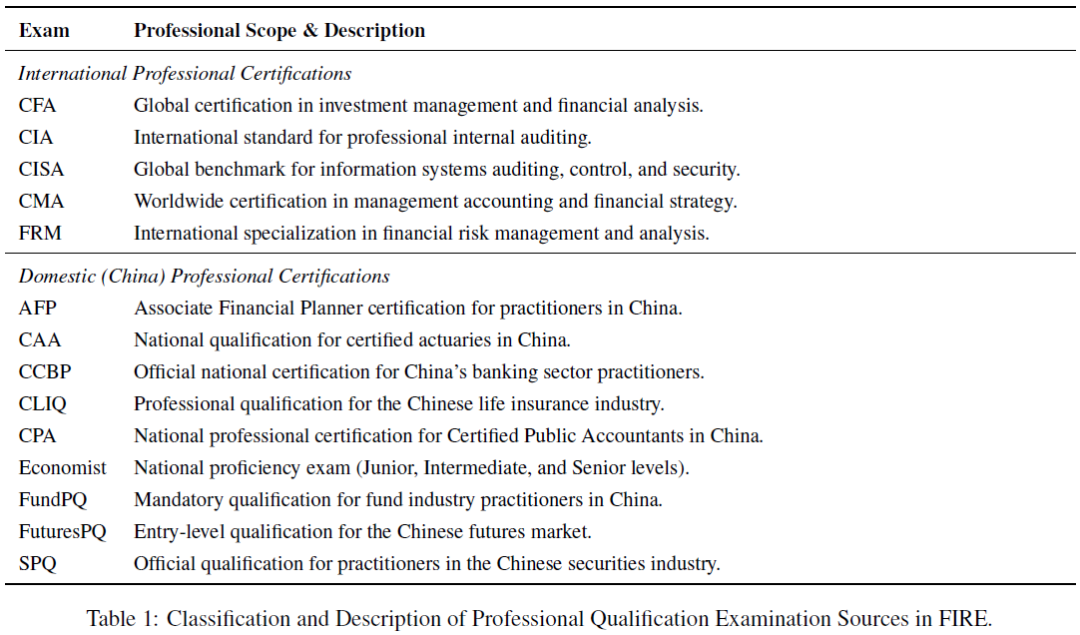
金融理论知识评估集约 14000 道题,源于 14 项核心金融考试,含 AFP、CFA 等,聚焦金融行业安全与合规。国内认证覆盖银行、证券等多领域资格,强调中国监管框架与合规实践,如证券法等。国际认证纳入 CFA、FRM 等,注重全球伦理原则与国际风险管理框架。
真实的金融场景问题
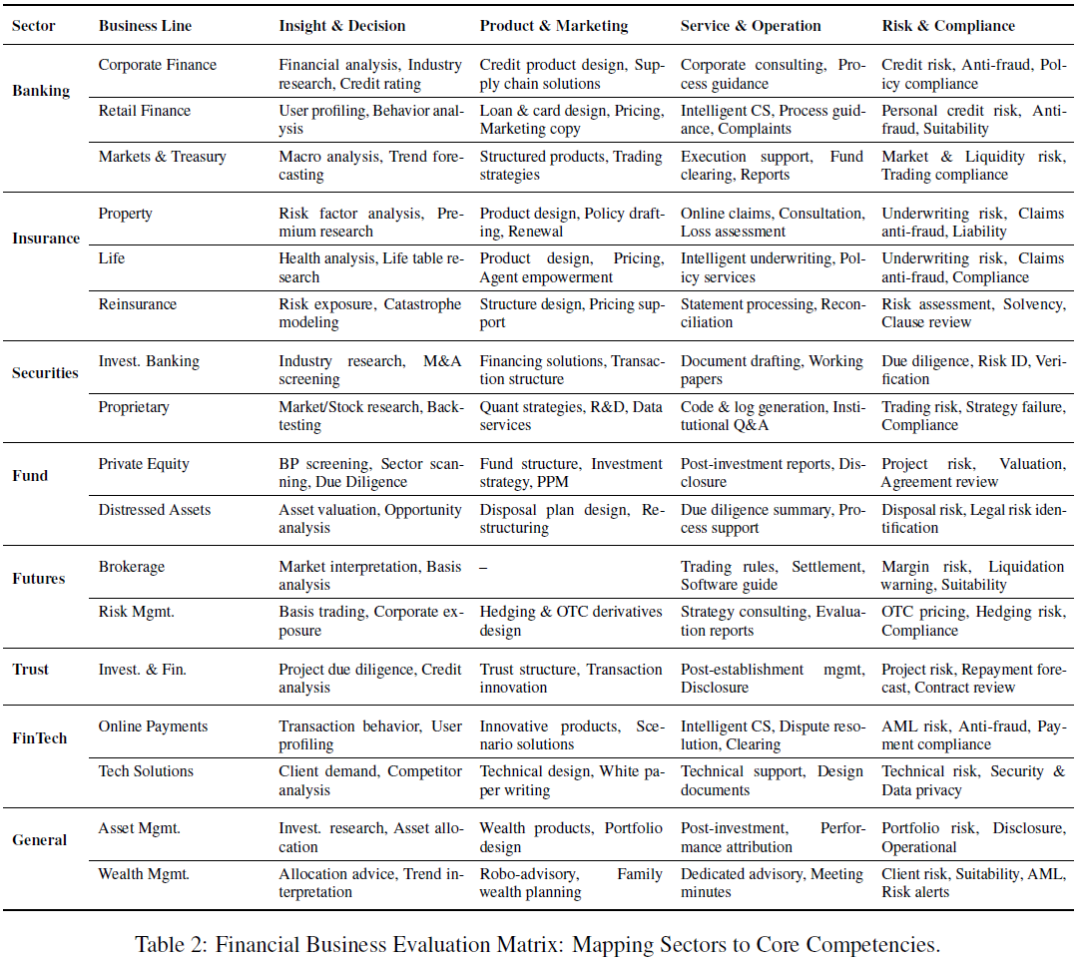
为评估大语言模型(LLMs)处理金融复杂性的能力,提出二维金融应用场景评估矩阵。矩阵行维度含银行、保险等八大金融部门及十七个子类别,列维度涵盖洞察与决策等四大功能支柱,可分解AI任务、指导数据训练与模型提升,为金融机构数字化转型提供蓝图。依此框架,编制3000个高保真场景问题数据集,实现对LLMs多维度评估。
评估标准
金融资格数据集用二元评分评估,多选问题预测与标准答案一致得1分,否则得0分。
真实金融场景任务评估方法因有无参考答案而异:
有参考答案的任务,模型按JSON格式输出,用自动提取管道验证,匹配得1分,不匹配得0分。
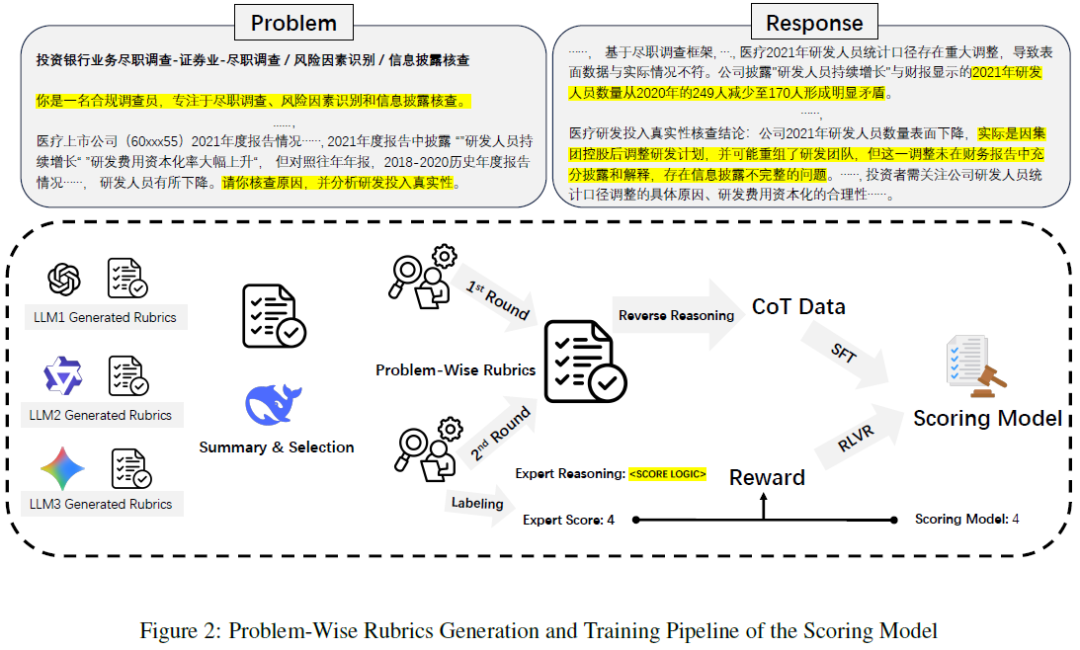
开放式任务用基于评分规则的自动评分法,有详细任务特定评分规则,由专门训练的评分模型分析问题和输出给出量化质量分。
开放式问题的评分模型
评估开放式金融任务无金标准参考时常用LLM评判范式,但不稳定,受响应长度、提示措辞和评估者偏差影响。为此采用金融领域结构化、基于 rubric 的评分框架,将专家评估分解为明确细粒度标准,提高稳定性和可解释性,还训练专用评分模型自动评估,训练流程见图2。
强基线:轩辕4.0
对领先的专有和开源大语言模型进行广泛评估,以在基准上建立全面性能基线。
专有模型:Gemini 3.0 Pro、GPT 5.2、Claude 4.5 Sonnet、Qwen3 Max。
开源模型:DeepSeek V3.2、Kimi K2 Thinking、GLM 4.6、Qwen3 - 235BA22B - Thinking - 2507、GPT - OSS - 120B、Seed - OSS - 36B - Instruct。
金融模型:Dianjin - R1、XuanYuan - FinX1。
评估时尽量标准化推理超参数,有官方推荐设置用官方的,否则默认采样温度 0.6、top - p 值 0.8。
实验
表3显示评估模型在专业认证考试中得分较高,说明先进大语言模型在金融知识获取和推理方面能力强。Gemini 3.0 Pro表现最佳,XuanYuan 4.0是优质开源基线,成绩与Gemini 3.0 Pro相当。
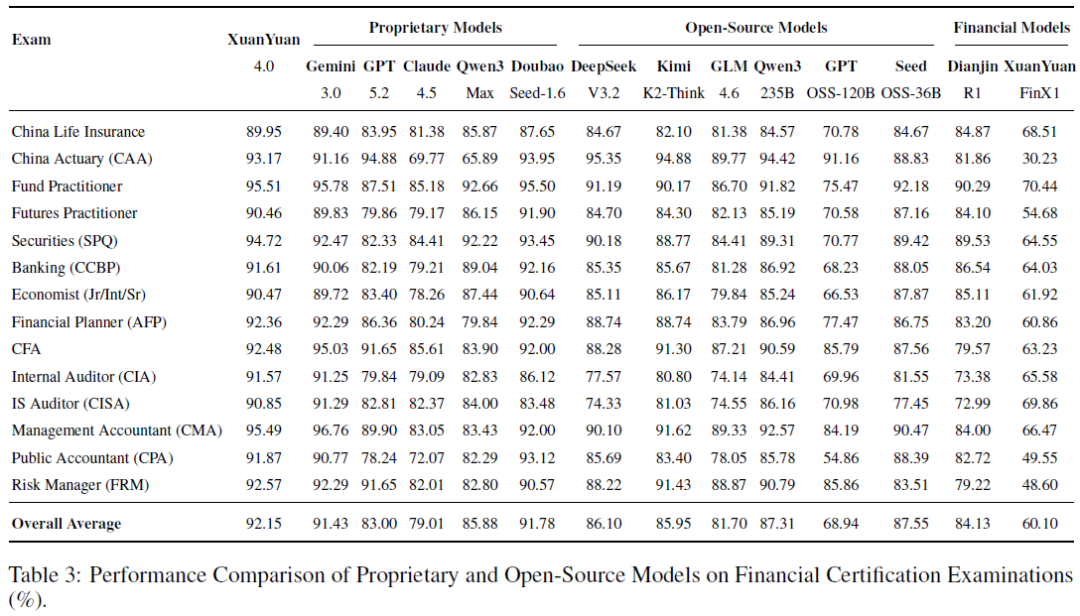
表4给出超3000个真实金融场景问题评估结果,GPT 5.2表现最优,XuanYuan 4.0经调优后在金融场景任务上超骨干模型及其他开源基线,性能与GPT 5.2接近,体现领域对齐可提升推理决策能力且成本低。
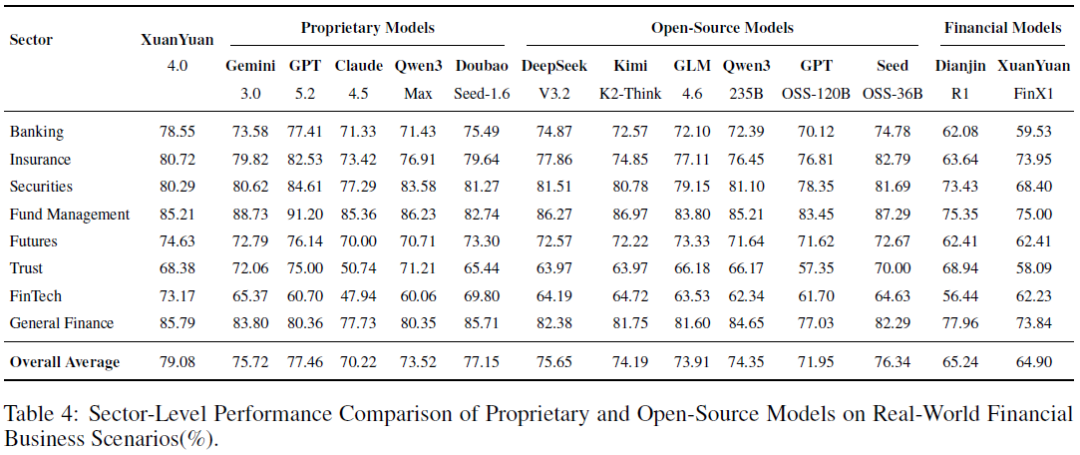
当前模型在金融资格考试表现好,但在现实金融场景能力有限,需研究缩小理论与实践差距。
总结
随着大语言模型(LLMs)在金融领域应用增多,需严格、高保真评估框架。本文推出 FIRE 基准,融合专业认证标准与场景任务,弥合学术指标与行业需求差距。评估显示模型在知识测评表现好,但应对复杂金融场景常失败,凸显当前架构无法将理论转化为实用智能的局限。这表明高风险环境下需进行领域特定优化,FIRE 为 LLMs 安全、可扩展融入全球金融生态提供基础框架。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
