15B参数吊打千亿大模型?微软这款“会思考”的AI,让算力焦虑彻底终结
随着多模态大模型参数规模与计算成本的持续攀升,如何在有限资源下实现高效推理成为行业焦点。微软研究院近期发布的Phi-4-reasoning-vision-15B,以150亿参数规模在视觉推理领域实现突破,仅用2000亿token训练数据即可媲美使用超万亿token训练的同类模型,为多模态AI的轻量化部署提供了新范式。
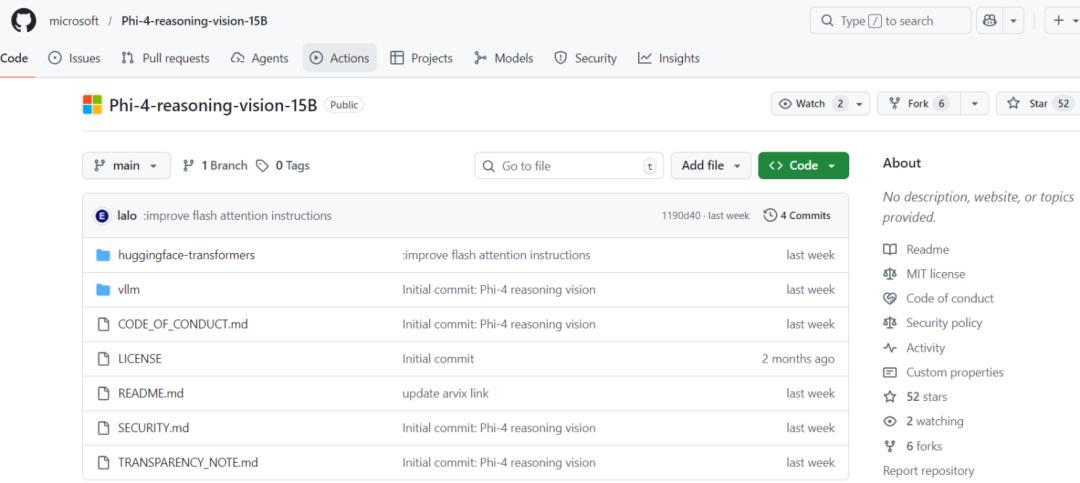
Phi-4-reasoning-vision-15B是微软研究院推出的开源多模态推理模型,基于Phi-4-Reasoning语言模型骨干,融合SigLIP-2视觉编码器,采用中期融合(Mid-Fusion)架构,在保持150亿参数紧凑体量的同时,实现了数学科学推理、GUI界面理解、图文问答等多维能力的均衡突破。该模型通过严格的数据筛选、动态分辨率处理与混合推理训练策略,在计算效率与推理精度之间达成帕累托最优,为资源受限场景下的多模态应用提供了高性价比解决方案。
(一)、多模态视觉推理能力
Phi-4-reasoning-vision-15B具备全面的视觉理解能力,涵盖图像描述生成、视觉问答(VQA)、文档阅读与收据解析、图表理解、多图像序列推理等任务。模型特别擅长处理包含复杂视觉信息的场景,如学术论文中的数学公式、网页界面元素定位、科学图表分析等,能够准确提取图像中的关键信息并进行逻辑推理。
(二)、自适应推理模式切换
该模型创新性地支持推理与非推理模式的智能切换。对于图像描述、OCR识别等感知类任务,模型默认采用直接响应模式(`<nothink>`),避免不必要的计算开销;面对数学证明、科学问题求解等需要多步推理的任务,则自动启用思维链模式(`<think>`),生成详细的中间推理步骤。这种混合策略在保证精度的同时显著降低了推理延迟。
(三)、高分辨率图像处理
基于SigLIP-2 Naflex动态分辨率视觉编码器,模型支持最高3600个视觉token(相当于720p高清分辨率),能够精确识别高分辨率截图中的细微UI元素、密集文本和小型图表。相比固定分辨率处理方案,动态分辨率技术在ScreenSpot-Pro等高分辨率基准测试中实现了近一倍的性能提升。
(四)、计算机界面理解与操作
模型在GUI定位与计算机使用(Computer Use)任务上表现卓越,能够准确识别屏幕上的按钮、输入框、菜单等交互元素,并返回归一化坐标(范围[0.0,1.0])。这一能力使其成为自动化测试、智能助手、RPA流程自动化等场景的理想选择。
(一)、中期融合架构设计
Phi-4-reasoning-vision-15B采用**中期融合(Mid-Fusion)**架构,通过预训练的SigLIP-2视觉编码器将图像转换为视觉token,经MLP投影层映射至语言模型的嵌入空间,再与文本token交错输入Phi-4-Reasoning骨干网络。相比早期融合(Early-Fusion)方案,中期融合在保持跨模态推理能力的同时,显著降低了训练成本与内存开销,仅需2000亿多模态token即可完成训练,远低于Qwen-3 VL、Kimi-VL等模型使用的超万亿token规模。
(二)、动态分辨率视觉编码
针对高分辨率图像处理,研究团队对比了多种方案:Dynamic S2、多裁剪(Multi-crop)、带S2的多裁剪以及SigLIP-2 Naflex动态分辨率。实验表明,**动态分辨率编码器**在MathVista、ScreenSpot、V*Bench等基准上 consistently 表现最优,特别是在3600 token配置下,ScreenSpot-Pro准确率从9.2%跃升至17.5%。这一技术突破解决了信息密集型场景(如桌面截图、移动端界面)中的细粒度感知难题。
(三)、三阶段训练策略
模型训练遵循精心设计的三阶段流程:
1. MLP预热阶段:仅训练跨模态投影层,使用小规模高质量图像-文本对数据,建立视觉与文本特征空间的初步对齐;
2. 指令微调阶段:全参数训练,覆盖单图视觉问答、数学科学推理、 grounding、OCR、计算机使用等全量任务,数据包含推理轨迹(带`<think>`标签)与直接响应(带`<nothink>`标签)的混合样本;
3. 长上下文与多图阶段:扩展至长文档理解、多图序列推理与安全对齐(RAI)训练,支持多轮视觉交互。
(四)、数据质量优先的筛选策略
研究团队投入大量精力进行数据清洗与增强:
人工审核开源数据集,按质量分为优秀、答案错误、问题低质、图像低质、格式错误等类别;
使用GPT-4o和o4-mini重新生成高质量答案与描述;
对高质量图像进行"数据复用":生成详细描述、创建多图匹配任务、构建"找出变化"序列数据;
引入LaTeX-OCR等专业化合成数据,增强数学公式识别能力。
(五)、混合推理数据配比
通过系统性消融实验,团队确定了20%推理数据与80%非推理数据的配比方案。研究发现,基于推理能力强大的语言模型骨干(Phi-4-Reasoning),仅需少量多模态推理数据即可将视觉信息有效接入现有推理框架。同时,增加数学科学数据(提升至3倍)不仅提升数学能力,还能协同增强计算机使用任务表现,展现出跨领域知识迁移效应。
(一)、智能教育辅助
Phi-4-reasoning-vision-15B在数学与科学推理方面的卓越表现,使其成为智能教育产品的理想核心引擎。学生可通过拍照上传数学题、物理图表或化学方程式,模型不仅能给出最终答案,更能展示完整的推导过程,实现"授人以渔"的辅导效果。其轻量化特性也支持在平板、教育一体机等终端设备上本地部署。
(二)、自动化UI测试与RPA
凭借精准的GUI元素定位能力,该模型可广泛应用于自动化测试工具与机器人流程自动化(RPA)场景。测试人员只需用自然语言描述操作目标(如"点击设置菜单中的网络选项"),模型即可识别屏幕坐标并生成自动化脚本,大幅降低UI测试的维护成本。
(三)、智能文档处理
模型对收据、发票、表格、图表等结构化文档的解析能力,使其适用于财务报销自动化、合同审核辅助、数据录入等商务场景。结合OCR与推理能力,可从复杂版式中提取关键信息并进行逻辑校验。
(四)、多模态内容创作
在旅游博客配图描述、社交媒体内容生成、电商产品详情页撰写等创意场景中,模型能够根据图像内容生成富有感染力的个性化文案,支持创作者提升内容生产效率。
(一)、环境准备
安装相关依赖
pip install torch==2.8.0 torchvision==0.23.0 torchaudio==2.8.0 --index-url https://download.pytorch.org/whl/cu128 -Upip install transformers==4.57.1 Pillow accelerate einops# [可选] 安装 flash-attentionpip install packaging wheelpip install flash-attn --no-build-isolation
(二)、模型加载
import osimport torchfrom transformers import AutoModelForCausalLM, AutoProcessorfrom PIL import Imagedevice = "cuda:0"model_path = "microsoft/Phi-4-reasoning-vision-15B"print("Loading model...")model = AutoModelForCausalLM.from_pretrained(model_path,torch_dtype=torch.float16,device_map=device,attn_implementation="flash_attention_2", # optional: use "sdpa" if you don't have flash_attention installedtrust_remote_code=True,)processor = AutoProcessor.from_pretrained(model_path, trust_remote_code=True)print(f"Model loaded on {model.device}")
(三)、纯文本推理
messages = [{"role": "user", "content": "What is the answer for 1+1? Explain it."}]prompt = processor.tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)inputs = processor(prompt, images=None, return_tensors="pt").to("cuda:0")generate_ids = model.generate(**inputs,max_new_tokens=4096,eos_token_id=processor.tokenizer.eos_token_id,do_sample=False,)generate_ids = generate_ids[:, inputs["input_ids"].shape[1]:]response = processor.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]print(response)
(四)、图像+ 文本
from PIL import Imageimage = Image.open("your_image.jpg").convert("RGB")# Use the <image> token to indicate where image content goesmessages = [{"role": "user", "content": "<image>\nDescribe this image in detail."}]prompt = processor.tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)inputs = processor(text=prompt, images=[image], return_tensors="pt").to("cuda:0")with torch.inference_mode():generate_ids = model.generate(**inputs,max_new_tokens=4096,eos_token_id=processor.tokenizer.eos_token_id,do_sample=False,)generate_ids = generate_ids[:, inputs["input_ids"].shape[1]:]response = processor.tokenizer.decode(generate_ids[0], skip_special_tokens=True)print(response)
Phi-4-reasoning-vision-15B的发布标志着多模态大模型向"小而精"方向的重要演进。通过严谨的架构选择、极致的数据工程与创新的混合训练策略,微软研究院证明了150亿参数模型完全可以在效率与能力之间找到最佳平衡点。对于开发者而言,这意味着更低的部署成本、更快的响应速度与更广泛的应用可能性。
项目地址
官方技术报告:https://www.microsoft.com/en-us/research/wp-content/uploads/2026/03/Phi-4-reasoning-vision-15B-Tech-Report.pdf
HuggingFace模型库:https://huggingface.co/microsoft/Phi-4-reasoning-vision-15B
GitHub开源仓库:https://github.com/microsoft/phi-4-reasoning-vision-15B
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀