结合BERT情绪分析的Node Transformer体系结构股票市场预测
“Stock Market Prediction Using Node Transformer Architecture Integrated with BERT Sentiment Analysis”
【 扫描文末二维码加入星球获取论文 】
摘要
股票市场预测面临挑战,传统方法难以捕捉金融市场复杂模式与依赖关系。本文提出结合Node Transformer架构与基于BERT的情感分析的集成框架用于股价预测,将股市表示为图结构,BERT提取社交媒体情感信息并与市场特征融合,Node Transformer处理历史数据。
对20只标普500股票实验显示,集成模型1天预测平均绝对百分比误差(MAPE)0.80%,优于ARIMA(1.20%)和LSTM(1.00%)。情感分析使预测误差总体降10%、财报发布时降25%,图架构额外提升15%,1天预测方向准确率达65%。配对t检验验证改进显著(p < 0.05),模型在高波动期稳健,MAPE低于1.5%,而基线模型超2%。
简介
股票价格预测是量化金融的基础挑战,对投资管理意义重大。其受非平稳价格动态、高维特征空间、复杂股票间依赖及投资者心理等因素干扰。
股票价格预测的挑战
金融预测面临多重挑战:
市场数据存在噪声和不规则性,微观结构噪声影响短期价格观测,随机波动干扰信号,有效市场假说使预测难超越基准,且信息融入价格速度受多种因素影响。
行为因素增加复杂性,投资者情绪和认知偏差导致市场波动,传统模型难解释,市场压力下资产相关性和波动性变化明显。
监管环境带来困难,政策变动引发市场突变,历史模型难以应对。
现有方法
当前股票价格预测方法多样:
基本面分析评估公司财务与市场地位以估算内在价值;技术分析研究历史价格和成交量模式找交易信号;机器学习用算法在特征工程数据集找模式。
深度学习架构有潜力,LSTM 处理序列数据但难捕捉长距离依赖;Transformer 用自注意力机制克服此局限;图神经网络解决标准序列模型无法表示实体关系的问题;Node Transformer架构结合注意力机制和图结构。
研究动机及贡献
现有方法少将图建模与Transformer架构结合,文本与数值数据融合有限,市场波动时性能差。
本文提出综合框架:
用Node Transformer架构,将市场表示为动态图,处理多元输入。
融合BERT情感分析,纳入社交媒体情感信息。
用注意力融合机制,依市场条件和波动指标加权特征和情感信号。
构建含20家标普500公司历史价格及社交媒体情感分的数据集。
跨不同市场条件等进行实验验证,统计检验证明性能提升显著。
相关工作
股票价格预测历经统计建模、机器学习和深度学习范式,各有解释性、能力和数据要求方面的权衡,后续将追溯其发展并指出推动当前工作的差距。
统计方法
ARIMA能捕捉线性时间依赖、系数结构可解释,结合自回归(AR)和移动平均(MA)成分,经差分实现平稳。
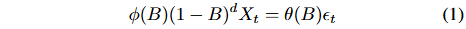
Low和Sakk对比发现ARIMA在长期股票预测中与LSTM精度相当;Wahyudi用AIC选模型,证明ARIMA对印尼股票短期波动预测有效。
向量自回归(VAR)将单变量ARIMA扩展到多变量,但ARIMA和VAR在处理非线性动态、制度转换和高维交互方面有局限。
传统机器学习
SVM、KNN和集成方法依靠特征工程预测。Nayak等开发混合SVMKNN模型用于印度股市指数预测,表现优于单一模型;Siddique和Panda结合核PCA、SVR与教学学习优化,降维提升精度;Basak等用XGBoost结合技术指标进行长期股价预测,苹果和雅虎股票60天和90天预测F分数0.82 - 0.97。但这些方法依赖特征工程,跨市场制度泛化能力弱。
深度学习方法
卷积神经网络(CNNs):通过局部感受野和参数共享从结构化数据中提取层次模式,如Chandar提出TI - CNN,Wen等将其用于S&P 500数据,能有效捕获局部依赖,但不适合建模长程时间动态。
循环神经网络(RNNs):包括LSTM和GRU,通过隐藏状态处理序列数据。LSTM用输入、遗忘和输出门控制信息流解决梯度消失问题。Di Persio等比较RNN变体用于谷歌股票预测,LSTM表现更好;Hossain等用级联LSTM - GRU处理S&P 500数据;双向LSTM双向处理序列,Xu等、Liu等将其用于股票预测。
图神经网络
GNNs 通过将市场建模为图来捕捉相互依赖关系,Node代表公司,边代表各种关系。陈等人提出结合图卷积网络与双 CNN 的图卷积特征 CNN 模型,在测试中国股票时表现优于非图方法;王等人引入多图卷积神经网络,定义静态和动态相关图,在测试 42 个中国市场指数时,平均预测误差较 LSTM 和基于注意力的基线降低 5.11%。
Transformer模型
Transformer架构采用新的序列到序列建模方法,自注意力机制计算各位置间的成对交互,公式含查询、键、值矩阵及缩放因子;多头注意力通过不同投影多次投影查询、键和值,公式涉及多个头及输出权重;Li和Qian开发的金融Transformer可同时处理多时间框架,提高对制度变化的敏感性;Node Transformer将注意力扩展到图结构数据,通过图邻域注意力学习Node表示。
混合模型和研究差距
混合模型结合空间特征提取器与序列学习器,如CNN-BiLSTM-attention模型,在多基准测试中表现优于单一范式模型,在波动期有优势。
现有研究存在关键差距,如少有人结合基于图的股票间建模与Transformer时间处理,非结构化文本与结构化数值数据整合有限,波动期性能下降,计算需求阻碍实时部署。
本文工作是提出集成Node Transformer与基于BERT的情感分析,捕捉股票关联和长程依赖,纳入情感作为预测信号。
数据集和预处理
金融市场数据集
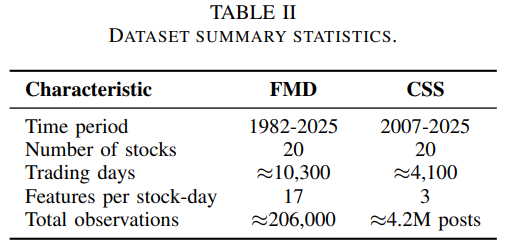
金融市场数据集(FMD)整合历史股市数据与技术指标,时间跨度为1982年1月1日至2025年3月31日,涵盖标普500指数中20家具行业代表性的公司,因选当前指数成分股存在幸存者偏差。
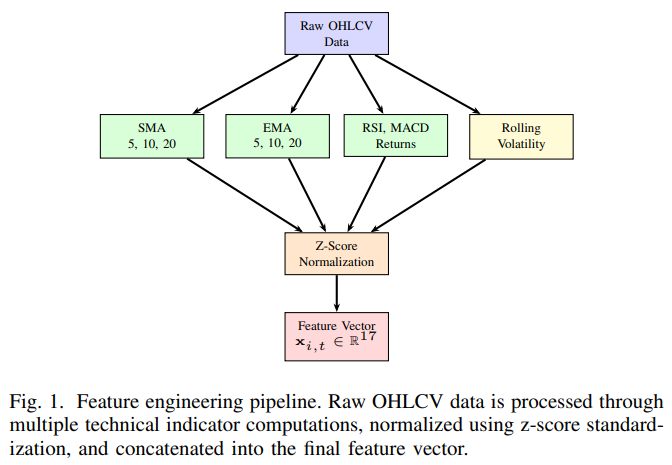
为每家公司收集6个每日交易变量(OHLCV),并计算多种技术指标,包括SMA、EMA、RSI、MACD、日收益率与对数收益率、滚动波动率。
采用时间感知插补策略处理缺失值,训练数据短期缺口用线性插值,验证和测试数据用前向填充,长缺口训练数据也用前向填充。每个观测包含6个原始变量和11个衍生指标。
特征归一化采用扩展窗口 z-分数方法防前瞻偏差,对特征 x_{i,t} 计算归一化值,测试数据用全量训练集固定归一化统计量,确保测试期信息不影响标准化,图 1 展示特征工程流程。
情感数据集
情感分析组件依赖两个互补数据集,分别捕捉基准标注情感和大规模社交媒体活动。
MSE 数据集:公开的社交媒体金融消息语料库,由金融专家标注情感分数(-1 至 +1),含多种信息,是 BERT 情感模块微调的主要训练和验证资源。
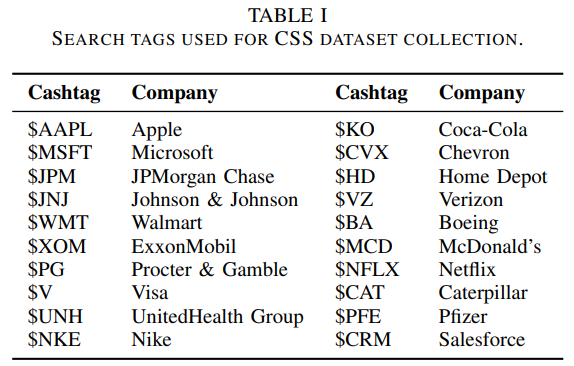
CSS 数据集:通过 X(原 Twitter)API 构建,搜索 20 只股票标签,涵盖 2007 年 1 月至 2025 年 3 月约 420 万条帖子。
流程:BERT 模型在 MSE 数据集上微调后用于 CSS 语料,生成每日股票情感分数,经多时间尺度汇总后作为Node Transformer输入。
预处理:两数据集均进行去除 HTML 编码等相同预处理。
数据分区
时间分割防前瞻偏差,金融数据训练集为1982.1.1-2010.12.31(70%),验证集为2011.1.1-2016.12.31(15%),测试集为2017.1.1-2025.3.31(15%)。
情感数据分区与金融数据重叠部分一致,X数据始于2007年,情感训练期为2007.1-2010.12,2007年前金融数据情感特征设为中性;情感集成主要在2017-2025测试集评估。
MSE数据集单独分区,按情感类别分层,70%训练、15%验证、15%测试;BERT模型先独立微调评估,再集成到预测流程。表II总结数据集特征。
方法
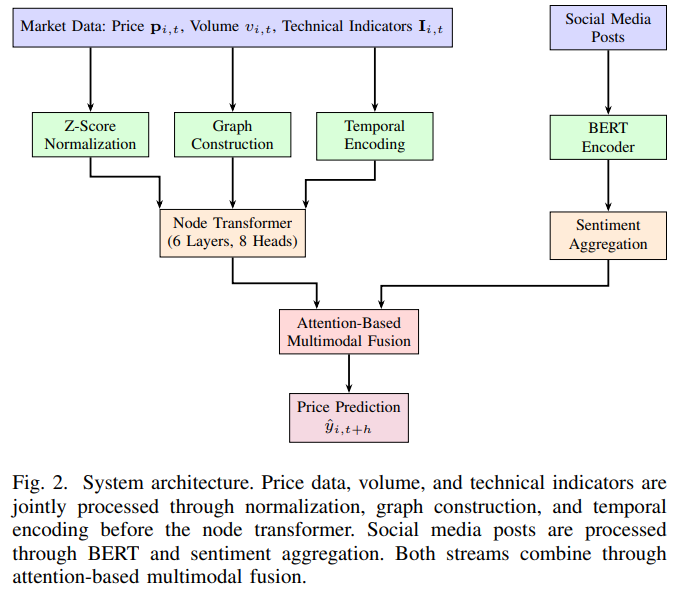
本框架将Node Transformer架构与基于BERT的情感分析相结合,融合定量财务指标与定性文本信号。采用模块化结构,图基Transformer和情感分析管道为独立组件,通过基于注意力的融合层耦合,该层可根据市场状况动态调整各信息流权重。
概览
图2展示整体系统架构,框架通过两条并行路径处理历史市场数据和情绪信息。定量分支对市场特征归一化、构建图结构、应用时间编码后输入Node Transformer;定性分支用BERT编码器处理社交媒体文本并多尺度聚合情绪得分。两流在注意力融合层汇合输出最终价格预测。
股票市场的图形表示
股票市场用图 G=(V,E,E) 表示,V 含 20 个股票Node,E 为全连接边集,E 是边权重矩阵,该规模兼顾计算与截面覆盖,利于深度时间分析,全连接且边权重可学习。消融结果表明图结构有预测优势。
边权重初始化为
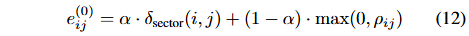
δ sector 基于 GICS 分类,ρ ij 是训练期日回报皮尔逊相关系数。
训练时边权重迭代更新:
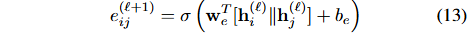
边无向,e ij = e ji。
Node Transformer
输入表示:每只股票用复合特征向量表示,含市场数据、指标、位置信息和身份嵌入。
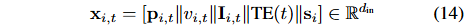
时间编码:按Vaswani等方法,注入位置信息,不同维度捕捉不同频率模式。
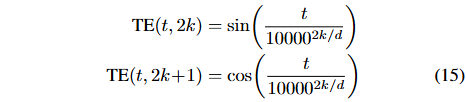
图感知多头自注意力:结合学习的边权重矩阵作为结构偏置,因果掩码确保仅用之前信息。
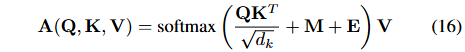
时间特征门控:根据时间上下文自适应加权特征。
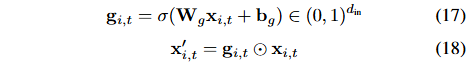
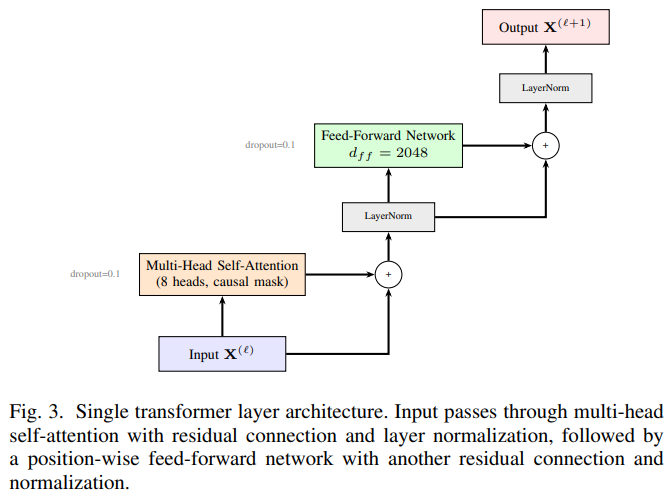
前馈网络:每层含位置前馈网络。
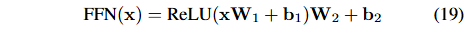
完整架构:6层堆叠,有残差连接和层归一化,用0.1的丢弃率正则化。
基于BERT的情感分析
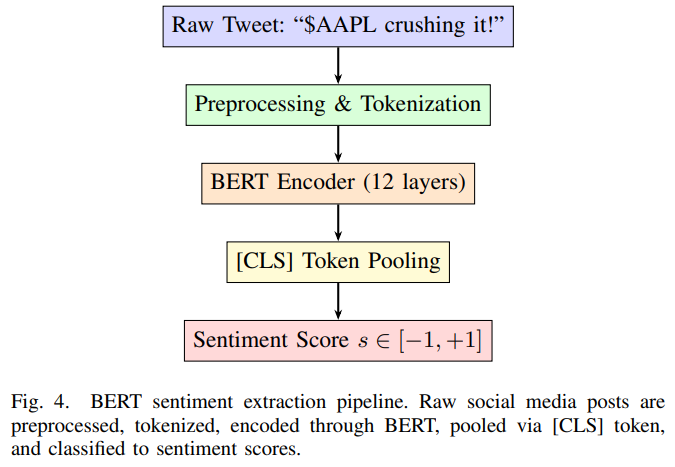
情感组件采用bert-base-uncased的BERT模型,其有12层transformer、768个隐藏维度和12个注意力头,双向注意力适合金融文本。
领域适配:金融领域嵌入层增强标准BERT词元嵌入,最大序列长度设为512。
微调过程:在MSE数据集上按三阶段渐进解冻策略微调,先冻住嵌入层和前8个transformer块,训练上层和分类头;再从顶到底逐步解冻;最后全部解冻联合训练。
因金融文本情感标签不平衡,用焦点损失函数替代标准交叉熵,聚焦难分类样本。图4展示完整情感提取流程。
多尺度情感特征:对原始每日情感得分进行多时间尺度平滑处理,用不同天数的指数移动平均捕捉即时反应和持续情感趋势。
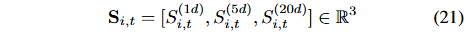
情感引导注意力:让情感调节注意力机制,通过缩放关键表示,使情感信号强的时间步获得不同程度的关注。
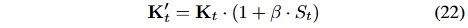
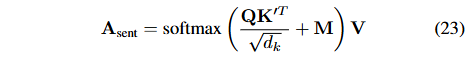
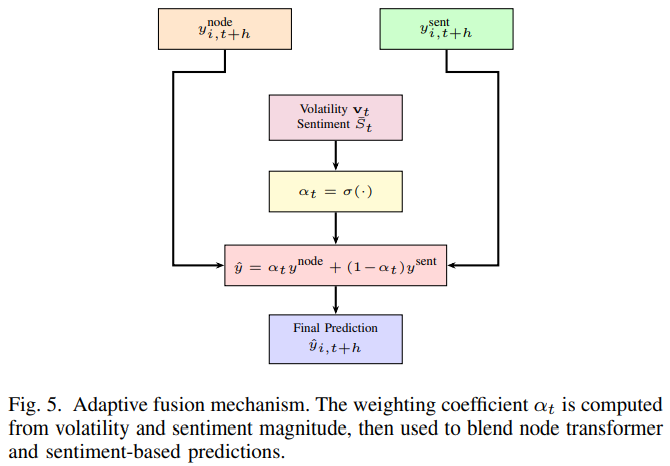
自适应集成:最终预测采用学习的凸组合,用 sigmoid 门根据市场条件(如波动率和情感信号)动态调整价格特征和情感预测的权重。
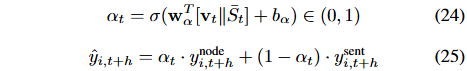
训练目标
训练用于价格预测和交易决策的模型需优化多方面,采用复合损失函数。
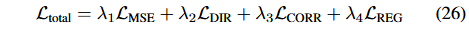
其中,L MSE 为均方误差,惩罚预测与实际价格偏差;L DIR 是二元交叉熵,奖励正确的价格涨跌预测;L CORR 为相关性损失,确保股票横截面排名;L REG 是 L2 正则化,防止过拟合。权重 λ1=1.0,λ2=0.5,λ3=0.2,λ4=10-4 在验证数据上调整,L MSE 占主导,其他项辅助提升趋势检测和排名一致性。
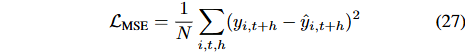
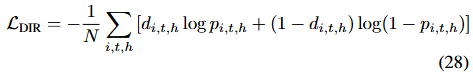
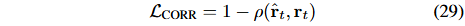
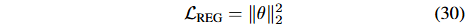
训练过程
BERT 编码器在 MSE 数据集上单独微调后冻结,作为固定特征提取器生成情感分数。
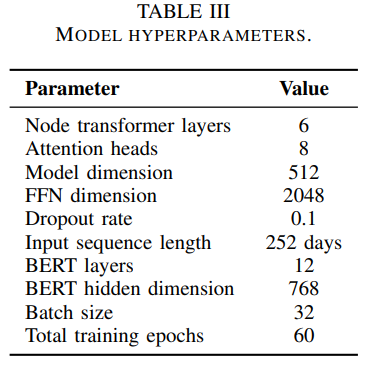
预测模型训练分三阶段:前 10 个 epoch 冻结Node Transformer,训练情感聚合、融合和输出层,学习率 10⁻⁴;中间 20 个 epoch 解冻Node Transformer顶部三层,学习率降至 5×10⁻⁵;最后 30 个 epoch 解冻所有Node Transformer参数,学习率 10⁻⁵。
优化使用 Adam(β₁ = 0.9,β₂ = 0.999,ϵ = 10⁻⁸),学习率先线性预热 4000 步,后余弦衰减至零。
批量大小 32,梯度累积 4 步,有效批量大小 128。
实验
实验设置
实验使用1982年1月至2025年3月数据集,涵盖多轮市场周期。采用单一时序划分,1982 - 2010年训练、2011 - 2016年验证、2017 - 2025年测试,测试期含多种市场制度。模型在NVIDIA A100 GPU训练,全模型约18小时收敛,评估指标仅基于测试集计算。
评估指标
预测目标 y i,t+h 为 h(1、5、20 个交易日)后的收盘价 C t+h,价格预测直观且适用于交易,可从价格走势得方向准确率。
用五个指标评估模型:
平均绝对百分比误差(MAPE):衡量预测误差平均幅度,具尺度不变性。
均方根误差(RMSE):以原始价格单位衡量准确性,对异常值敏感。
方向准确率(DA):衡量价格走势方向预测的正确率。
Theil’s U 统计量:与简单随机游走预测对比,U<1 表明模型更优。
信息系数(IC):评估股票横截面排名能力,用于多空投资组合构建。
基线
为公平比较,对 8 个涵盖统计、经典机器学习和深度学习范式的基线模型在相同数据分割上训练。超参数通过验证集(2011 - 2016)网格搜索调整,最终性能在测试集(2017 - 2025)评估。
统计基线:ARIMA 按 AIC 选阶(p, d, q),p, q∈[0, 5],d∈[0, 2],为每只股票单独建模;VAR 用 BIC 选滞后阶数(最多 10 阶),考虑多变量跨股票依赖。
经典机器学习模型:随机森林用 100 棵树、最大深度 10;SVR 用 RBF 核,C 和 γ 网格搜索;XGBoost 用 1000 个估计器,验证损失早停防过拟合。
深度学习基线:LSTM 2 层 128 隐藏单元、60 天回看窗口;简单 Transformer 4 层、8 注意力头、256 维嵌入;BERT + LSTM 混合模型将 BERT 提取的情感特征与 LSTM 价格模型拼接。
情感模型评估
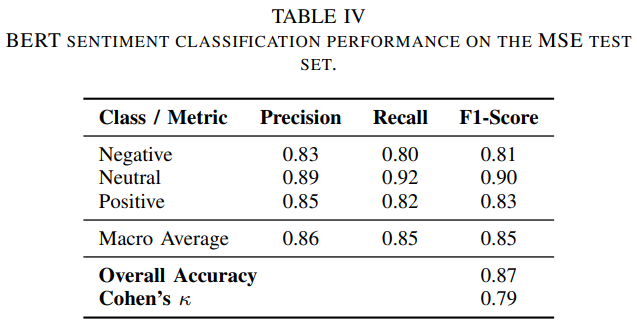
在评估完整预测流程前,对微调后的BERT情感分类器在MSE数据集上独立评估。数据集按70%、15%、15%分为训练、验证和测试集,分层划分以保持类别分布。模型在训练集微调,按渐进解冻策略并依验证损失提前停止。结果基于测试集。因数据集类别不平衡,除准确率外还报告宏平均分数。微调模型整体准确率87%,宏平均F1为0.85,各类F1在0.81(负)到0.90(中性)间。中性类因样本多、事实性财务报告易分类,精度和召回率高;负类召回率最低,因社交媒体看跌语言难分类。Cohen’s κ为0.79,表明分类器有判别能力。消融研究显示情感整合使MAPE降10%,13%的分类错误率说明Node Transformer门控机制能从有缺陷的情感信号中提取预测价值。
结果
整体性能:通过不同预测期的MAPE评估,提出模型Theil’s U为0.59,捕捉到真实结构模式。1天预测MAPE为0.80%,较ARIMA和LSTM有改善,且长预测期优势扩大。
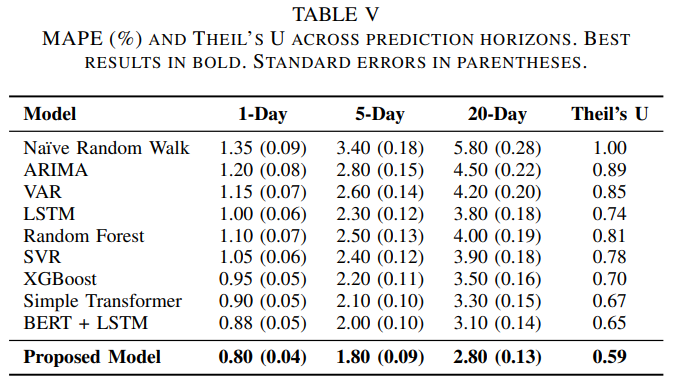
方向准确性:提出模型方向准确率达65%,超随机基线15个百分点,超LSTM 7个百分点,置信区间显示改善非抽样误差。
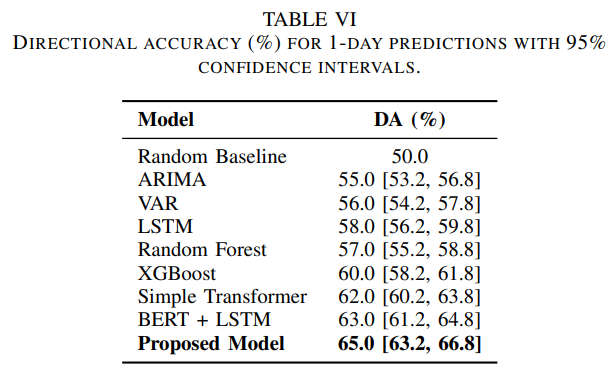
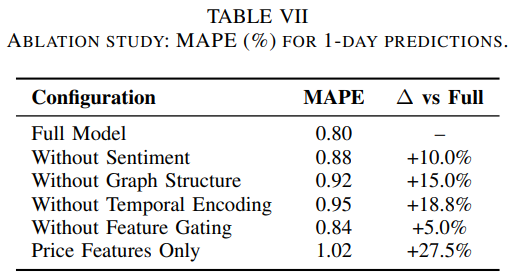
消融研究:图结构、情绪整合、时间编码分别贡献15%、10%、18.8%的提升;仅用价格信息性能下降27.5%。
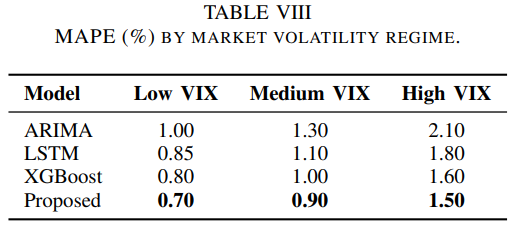
不同波动制度下的表现:高波动期提出模型MAPE低于1.5%,基线模型为1.6 - 2.1%,门控机制增强其稳定性。
统计显著性:配对t检验显示提出模型与基线对比p < 0.05,Cohen’s d为0.17 - 0.34,与ARIMA和BERT + LSTM差异更显著。
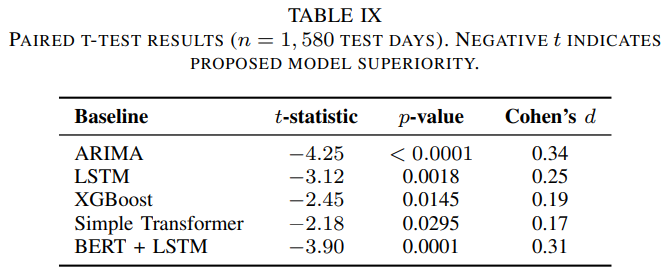
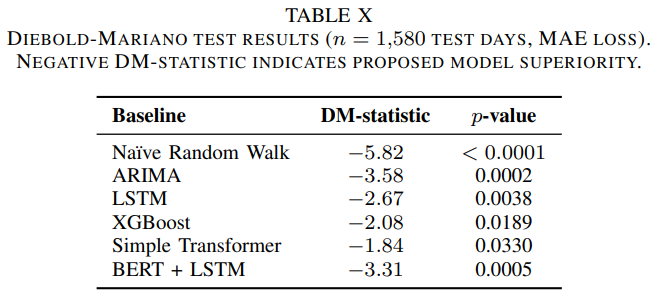
配对t检验假设预测误差独立分布,金融时间序列常违背此假设。补充Diebold - Mariano(DM)检验,用Newey - West标准误评估两模型预测准确性。DM统计量相对配对t检验值减小,所有比较p < 0.05,与简单Transformer对比优势缩小,最强DM统计量针对朴素随机游走。
多空策略(多前5、空后5)15个月(2024.1 - 2025.3)毛累计回报率25.3%,高于标普500的15.1%。考虑10个基点交易成本,日均组合换手率32%,净累计回报率18.4%,超买入持有基准3.3个百分点,净年化夏普比率1.15,说明模型有风险调整收益,低频率再平衡策略值得研究。
讨论
结果解释
集成模型在指标、时间范围和市场条件上持续改进,增益幅度因组件和情境而异,揭示其预测优势机制。
图表示法捕捉独立模型遗漏的股票间依赖关系,图结构带来15%的改进,表明明确的关系建模有预测价值。
情绪整合在信息事件时很有价值,财报季有25%的改进,表明社交媒体情绪含价格未充分反映的早期信号,不同行业表现有差异。
门控机制实现自适应特征加权,动量特征在波动期权重高,长期指标在稳定期权重高,这种自适应行为自然产生。
影响
实践层面:模型方向准确性助从业者做短期交易决策,增强波动期预测能力利于风险管理,图结构揭示股票关系助投资组合多元化。
理论层面:融入情绪提升表现表明市场未及时消化定性信息,支持有限效率;财报季 25%的提升说明社交媒体含未反映在股价中的早期信号;图模型成功证明市场是复杂互联系统。
限制
研究发现需结合多方面局限解读:
股票选择存在生存偏差,所选 20 只股票基于当前标准普尔 500 指数成分股,未涵盖 1982 - 2025 年间失败、被收购或摘牌公司,报告业绩可能虚高;20 Node图结构仅代表有限市场截面。
数据相关假设影响结果泛化性,边权重初始化依赖训练期相关性,但市场相关性非平稳;2007 年后才有 X 数据,情感特征前期无训练信号,且分析依赖单一平台英文内容,API 政策变化影响可重复性。
经济意义分析未考虑可变市场影响和执行滑点,回测中 32%的日换手率会放大未建模摩擦,报告净回报为可实现业绩上限。
模型复杂度高,对实时高频应用有挑战,评估使用与模型开发相同的 20 只股票,限制了对未知证券的外部有效性评估。
未来研究方向
多个方向值得研究:
一是扩大股票范围至标普 500 或国际市场,测试图架构扩展性与Node增多时的信息有效性;
二是纳入多语言情绪源和不同平台信息,拓宽信息基础;
三是开发高效注意力机制,实现高频交易实时部署;
四是添加制度转换检测机制,适应市场结构转变;
五是将预测框架与投资组合优化和风险管理结合,提升经济价值。
总结
本文提出结合Node Transformer架构与基于BERT的情感分析的集成框架用于股价预测。该模型将股市表示为图,个股为Node,边编码行业关联和价格相关性;用微调的BERT处理社交媒体文本提取情感信号,通过基于自适应注意力的融合机制与价格特征融合。对20只标普500股票1982 - 2025年数据实验,一日预测MAPE为0.80%,优于ARIMA和LSTM;消融研究显示去除情感和图结构会增加误差;方向准确率达65%,显著优于基线。研究表明联合建模股票依赖和投资者情绪可带来更准确稳健的预测。未来应扩展框架、纳入多源情感数据、研究高效注意力变体并与投资组合优化和风险管理结合。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
