哪个模型最适合“养虾”?国产MiniMax-M2.1和Kimi-K2.5杀疯了
一个评估大模型“养虾”(OpenClaw)成绩的基准PinchBench诞生了。
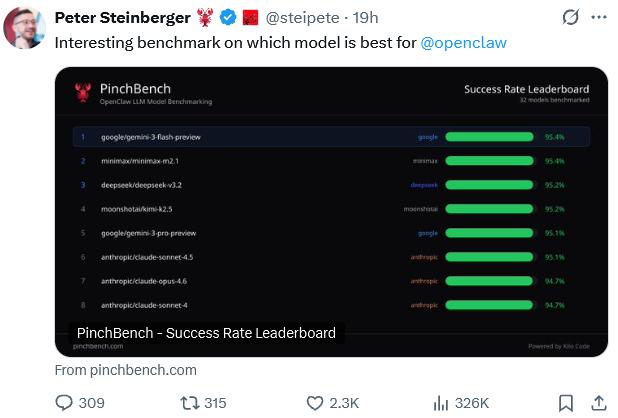
OpenClaw之父也转发点赞。
PinchBench智能体评测系统,通过真实的成功率、执行速度和运行成本数据,评测出各家大模型在OpenClaw的实际业务场景中的真实表现。
值得注意的是这个测评系统还未上新最近新发布的模型,例如谷歌极致性价比与速度的Gemini 3.1 Flash-Lite,社区高度评价最适合龙虾的OpenAI刚刚发布的GPT-5.4。
这两个模型OpenClaw刚刚支持了!
在此之前,哪家模型最适合“养虾”呢?
数据揭示各家模型真实水平
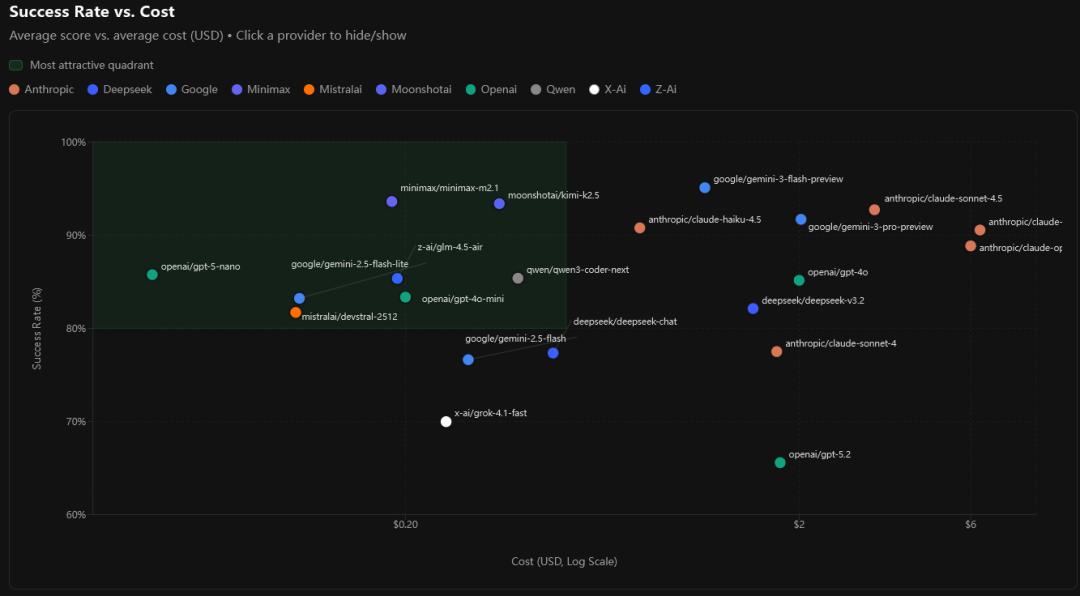
成功率排在榜首的是谷歌的gemini-3-flash-preview,其以95.1%的极高成功率傲视群雄。
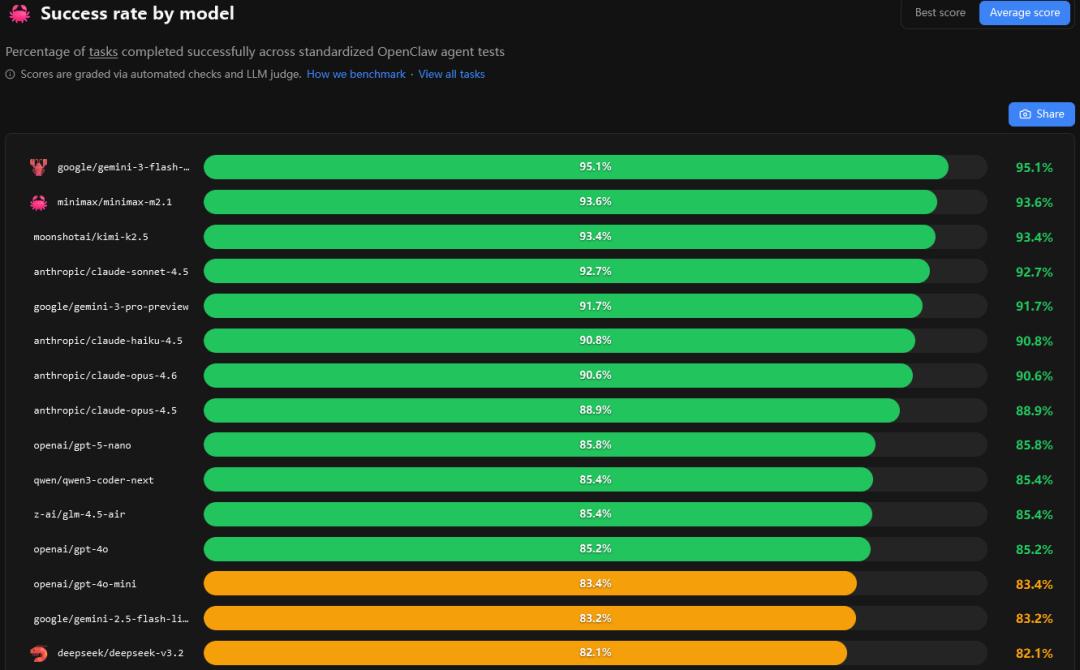
紧随其后的是MiniMax的minimax-m2.1和月之暗面的Kimi-k2.5,两者的成功率分别达到了93.6%和93.4%。
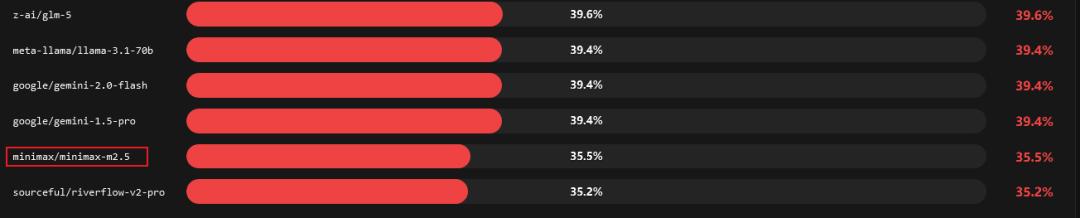
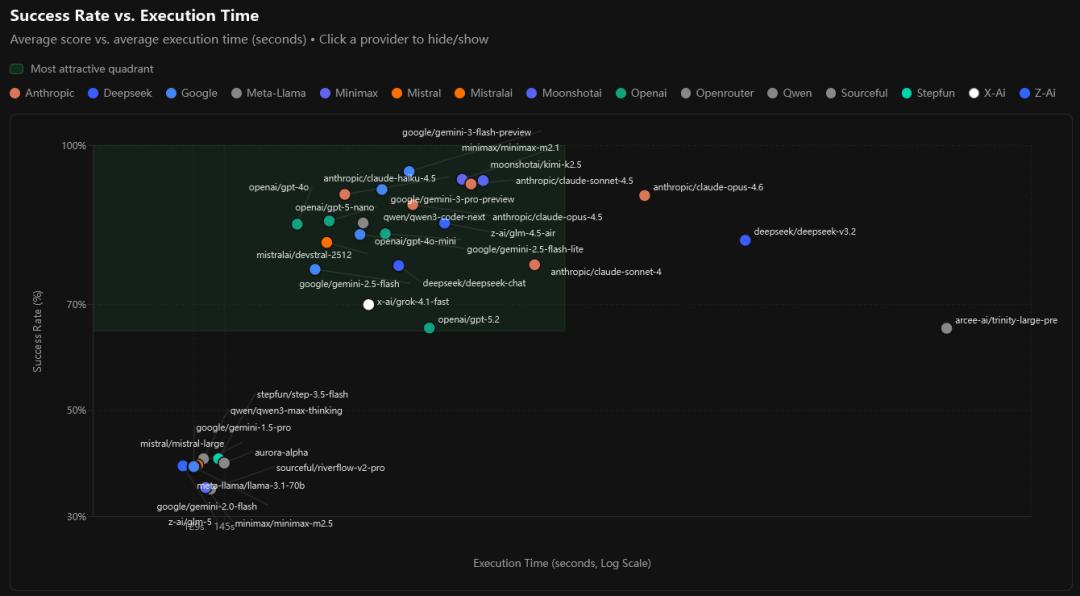
令人意想不到的是minimax-m2.5反而只有35.5%的成功率。
在任务完成速度榜单中,minimax-m2.5以105.96秒的成绩夺得速度冠军。
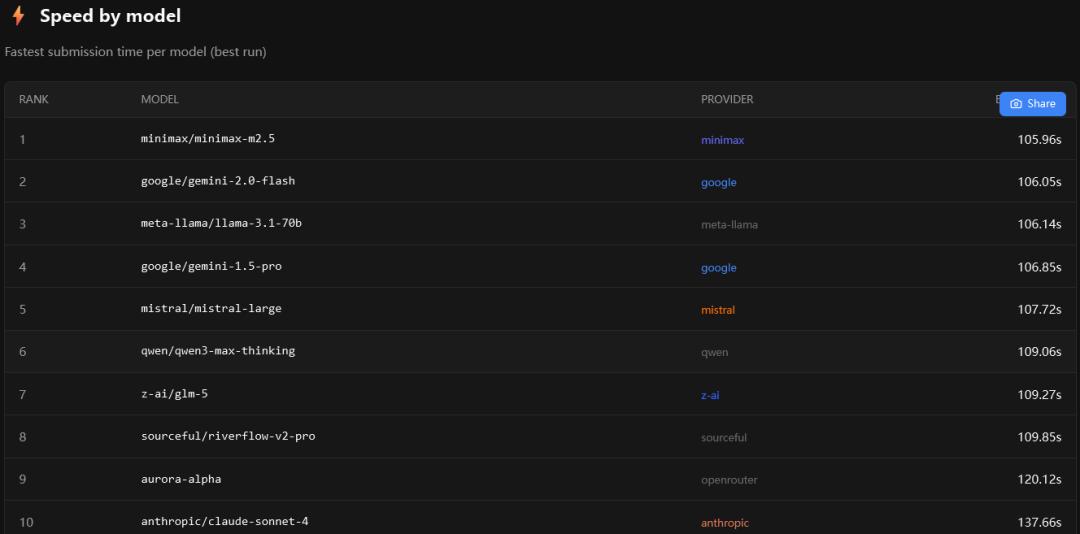
紧跟在后面的是谷歌的gemini-2.0-flash和Meta的llama-3.1-70b,耗时都在106秒上下。
部分以深度思考见长的模型由于需要更多的计算时间,在排名上相对靠后。
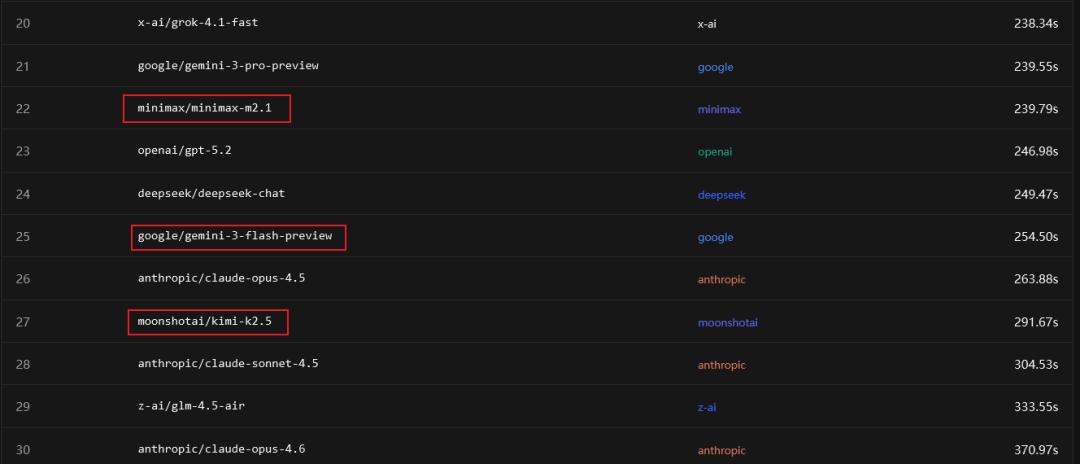
而成功率前三的模型,在速度上排到了20名之后。
每次调用消耗的资金成本是所有开发者最关心的问题。
在成本榜单上,OpenAI的gpt-5-nano展现出了极致的性价比,单次最优运行成本仅需0.03美元。谷歌的gemini-2.5-flash-lite以0.05美元紧随其后。
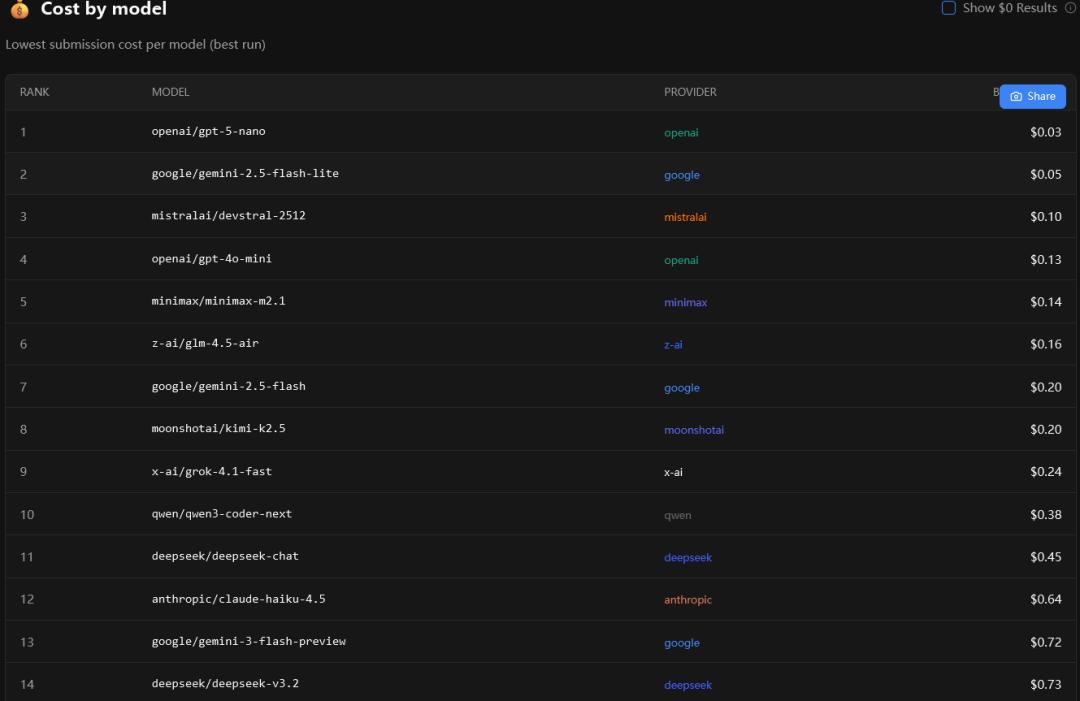
整体来看,排名前8的轻量化模型每次任务的成本,都控制在0.2美金以内。成功率前三的minimax-m2.1和Kimi-k2.5赫然在列。
那些动辄需要消耗近一美元的重型模型虽然能力强大,但在处理日常琐碎任务时显然不够经济划算。
榜单交织在一起,为开发者挑选合适的干活搭子提供了最直观的参考。
综合考虑性能、成本和速度,minimax-m2.1和Kimi-k2.5均落在了最佳区间。除了这两个,国产模型glm-4.5-air和qwen3-coder-next也在最佳区间内,也是不错的选项。
完全贴合真实工作场景的考试
得出这些精准数据的背后是一套极其严谨的评测系统。
PinchBench基准,不同于那种让机器做选择题的传统跑分软件,它更像是一个模拟真实办公环境的试炼场。
系统会将各类语言模型接入特定的代理框架中,让它们化身为独立的数字员工。考官会给这些数字员工分发一模一样的实际工作任务。系统全程在旁边掐表计费,并严格按照标准答案核对工作成果。
为了保证考题的标准化,所有的任务都被写成了带有特定格式的文本文件,统一存放在专门的代码仓库里。这就好比将教案锁在保险柜中一样严谨。
一份合格的考卷包含五个核心部分。
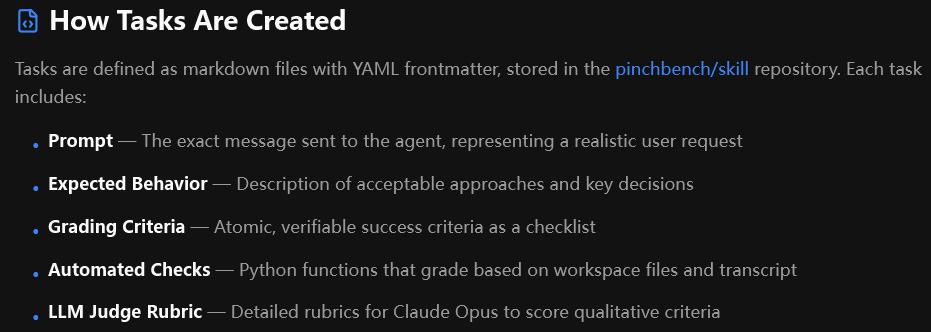
考卷上必须有极其拟真的用户原始诉求作为提示词。它还必须清晰描述出完成该任务可以接受的办事思路和关键决策点。紧接着就是一份类似于飞行员检查清单一样的评分标准,每一项都要求独立且可验证。
系统还配备了自动运行的Python脚本。这些代码就像是不知疲倦的巡考员,专门检查考生留下的文件和工作日志。对于那些无法用代码直接判断对错的主观题,系统以Claude Opus模型担任主观题裁判。
目前的题库中一共积攒了23项实操任务。
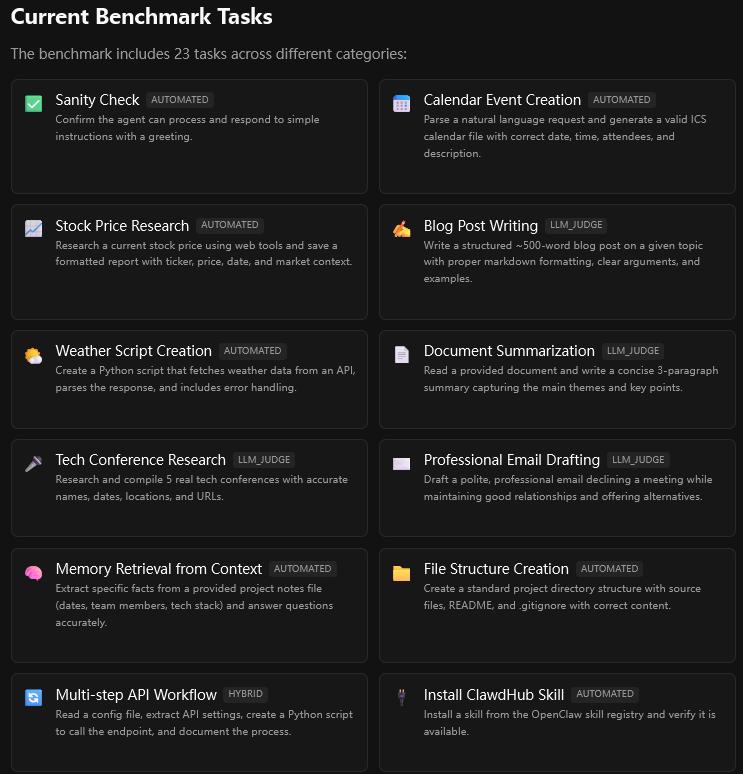
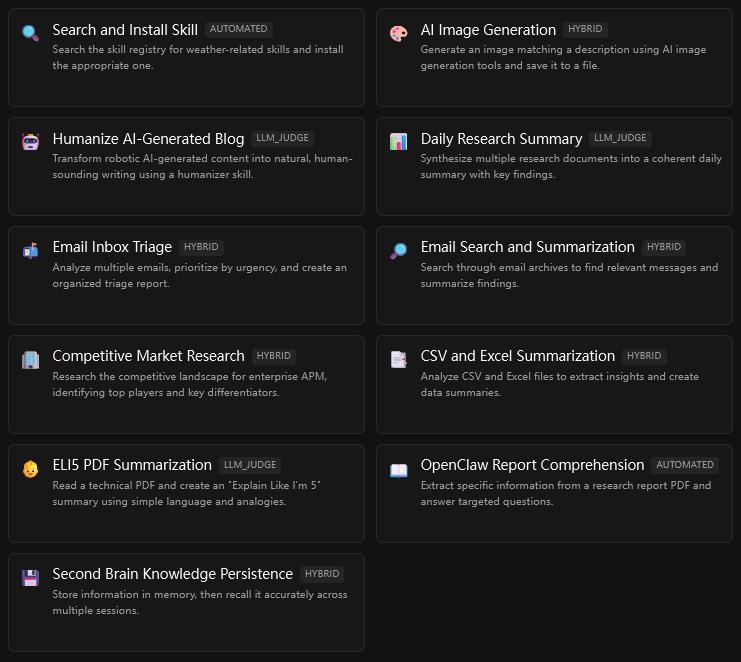
这些任务涵盖了一个白领员工日常可能遇到的方方面面。最简单的是基础的理智测试,系统会自动检查这些智能体能否听懂人话并给出礼貌的回应。
稍微复杂一点的任务类似于行政助理的工作。比如让它们根据一段口语化的要求,直接生成一个格式完全正确的日历文件。其中要准确包含时间、地点、参会人员和会议说明。
再进阶一些就是研究员的角色。它们需要利用网络搜索工具去挖掘某只股票的最新价格,并整理出一份包含行情和市场背景的规范报告。或者去全网搜集即将举办的科技会议信息,核实具体的名称地点并整理成册。
对于程序员的工作,系统会要求它们编写一个查询天气的脚本程序。这个程序不但要能正确调用接口,还得具备处理网络故障的抗压能力。甚至还有要求它们按照标准规范一次性建好整个项目文件夹目录结构的硬核考题。
文字工作也是重头戏。系统会让它们阅读长篇幅的技术文档,然后用三段话精准概括核心要点。或者是面对一篇极其生涩的技术论文,要求它们用讲童话故事般通俗的语言写一份面向五岁小孩的科普说明。
甚至连人际交往的情商都纳入了考核。考题会要求它们写一封委婉拒绝高管会议邀请的电子邮件,在保持专业礼貌的同时还要巧妙提供替代方案。系统还会测试它们的长线记忆能力,把一些项目细节交代给它们,隔很久之后再考它们是否还能准确回忆起团队成员的负责模块。
批改这些五花八门的试卷有三种不同的方式。
第一种是绝对理性的机器自动打分,主要检查特定文件有没有生成、代码里有没有某个函数调用。
第二种是裁判打分制。对于像博客写作、邮件措辞这种没有标准答案的主观题,系统会调出详细的评分细则给裁判模型,让裁判从内容质量、得体程度等多个维度给出具体的评级。
第三种则是混合双打,机器先检查客观事实,裁判再评估文字质量,双管齐下确保评分精准。
哈希值代码提交锁定评测版本
为了防止有人在考题上做手脚,系统引入了极其严格的版本控制机制。
每一次运行测试,系统都会把当前题库代码的一串唯一加密标识记录下来。这就相当于给每一次考试都盖上了一个带有精确时间戳的钢印。
只要题库仓库里发生哪怕一个标点符号的改动,系统就会生成一个全新的加密标识。这种机制让每一份榜单上的成绩,都能精准追溯到当时用的到底是哪一套具体的考题和评分标准,杜绝了任何暗箱操作的可能。
系统并非死板到不近人情。
如果开发者只是在题库里修改了说明文档、调整了测试工具的配置文件,这些完全不影响考题本身难度的改动,系统会予以宽容。系统会将这些版本依然标记为现行版本,其跑出的成绩依然可以和之前的成绩放在同一个榜单上比较。
一旦有人碰了考题的提示词、修改了裁判的评分标准或者是改动了自动检查的逻辑代码,系统就会立刻翻脸。原有版本的成绩将失去现行资格,系统会开启一个全新的世代,重新计算排名。
这种严谨的机制就像是维护着一部厚重的考试编年史。
旧版本的成绩单永远不会被销毁,它们安静地躺在历史档案库中。任何人都可以随时查阅当年那些老模型在旧考题下的青涩表现。
在人工智能能力飞速进化的今天,用枯燥的跑分去衡量一个模型已经不再适用。
像这样将其投入真实繁杂的业务场景中,去计算每一次敲击键盘的成本和时间,才是检验其价值的终极标准。
参考资料:
https://pinchbench.com/
https://github.com/pinchbench/skill