2步生成4张2K高清大图,效率提升40倍!阿里开源 Qwen Image 2512 Turbo,AI生图效率飙升!
点击下方名片关注AIGC Studio公众号!获取最新AI前沿应用/AIGC实践教程!
在AI生成图像的领域里,速度与质量的平衡一直是研究者们追求的终极目标。传统扩散模型往往需要数十步甚至上百步的前向计算,才能生成一张令人满意的图片,用户不得不长时间盯着进度条发呆。然而,阿里近日宣布了一项革命性突破——他们成功将Qwen最新开源模型的SOTA压缩水平从80-100步骤骤降至2步,实现了速度的飞跃,让AI生图真正进入了“眨眼之间”的时代。
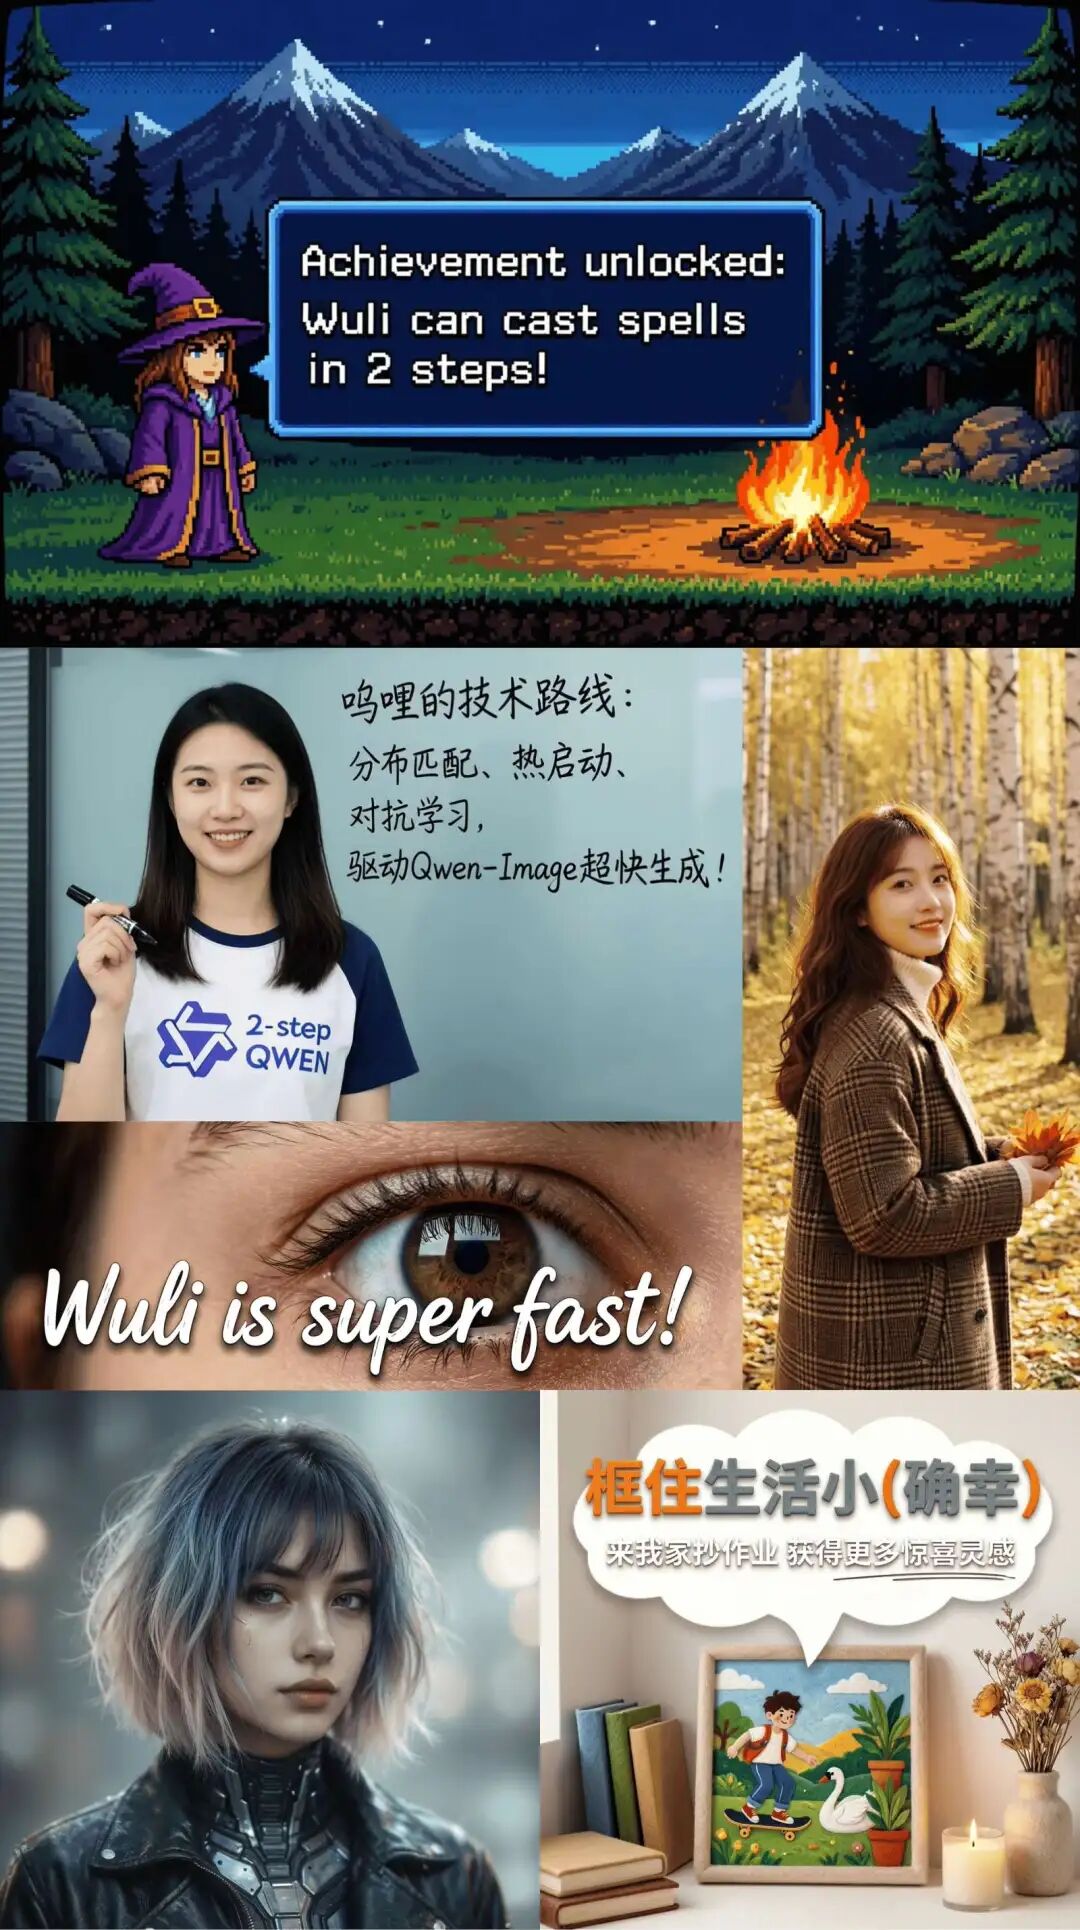
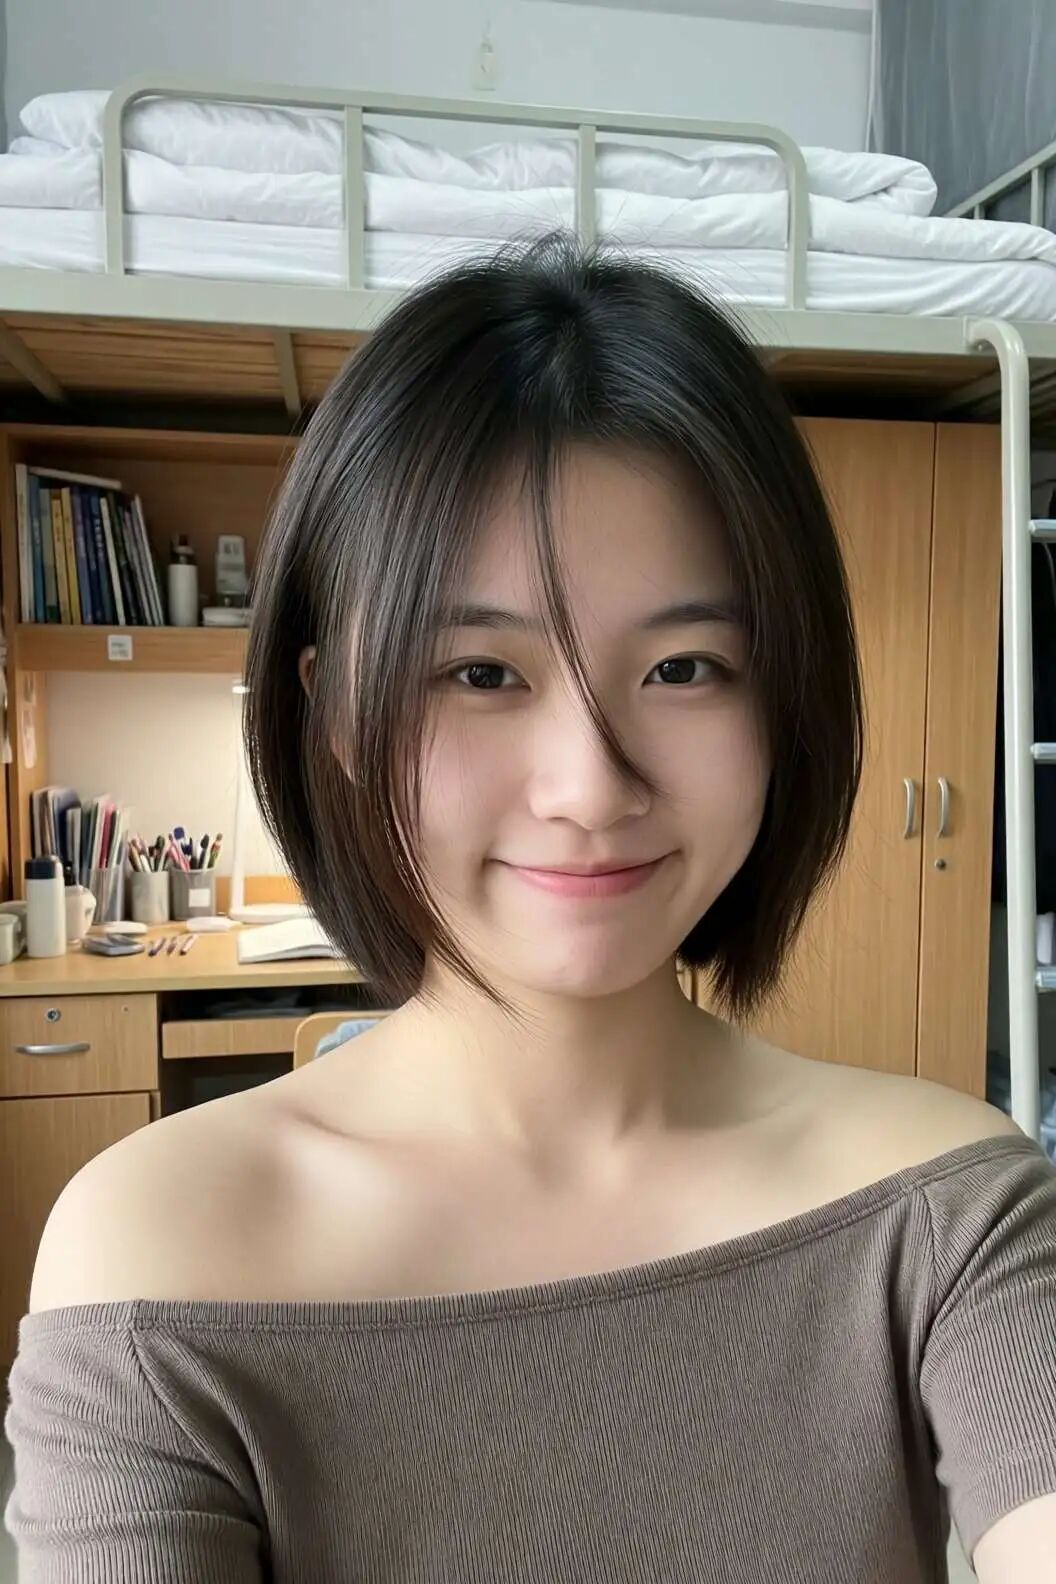
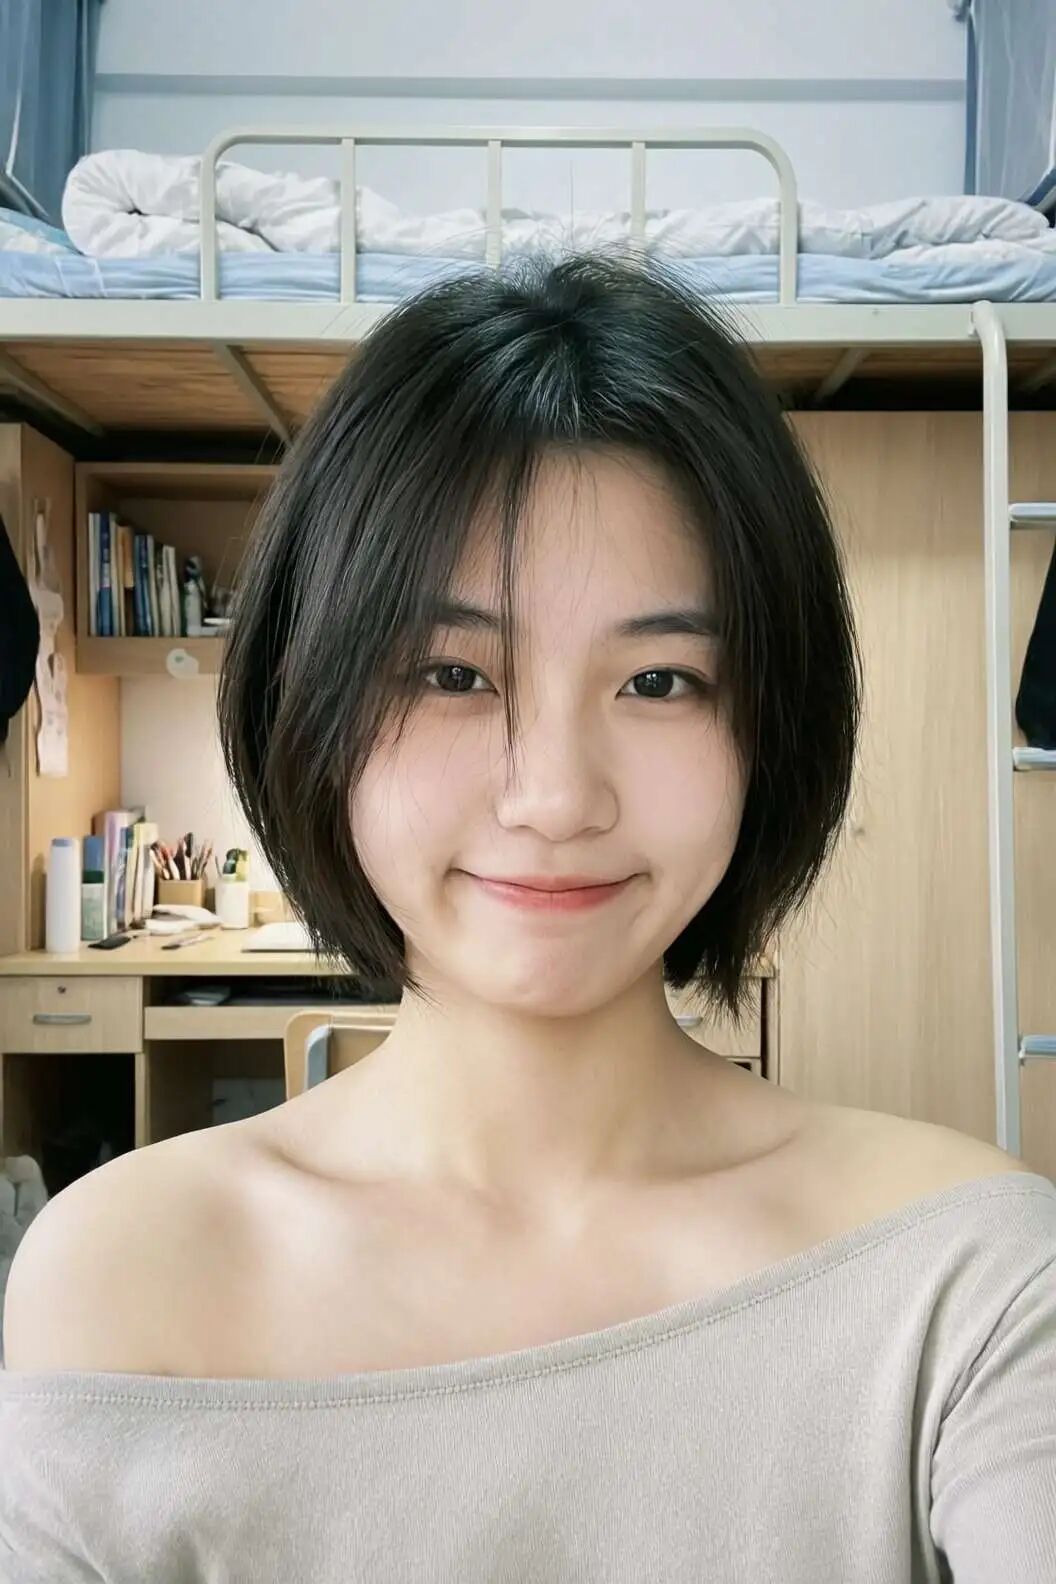
想象一下,以往需要近一分钟才能生成的2K级高清大图,现在仅需5秒钟,你就能拿到4张!这不仅仅是速度上的提升,更是对AI生图效率的一次彻底革新。阿里智能引擎团队通过创新的蒸馏方案,将Qwen-Image模型的生成步数大幅压缩,同时保证了生成图像的高质量。目前,这一突破性成果已经通过Checkpoint的形式发布至HuggingFace和ModelScope平台,供全球开发者下载体验。
- HuggingFace:https://huggingface.co/Wuli-art/Qwen-Image-2512-Turbo-LoRA-2-Steps
- ModelScope:https://www.modelscope.cn/models/Wuli-Art/Qwen-Image-2512-Turbo-LoRA-2-Steps
- 试用:https://wuli.art/generate
早期蒸馏方案往往受限于轨迹蒸馏的“细节困境”,即模型在低迭代步数下难以生成高质量、细节丰富的图像。阿里智能引擎团队没有走老路,而是选择了从样本空间到概率空间的智慧转变。他们借鉴了DMD2算法的核心思想,将约束从直接对齐样本转换为在概率空间中进行指导,通过Reverse-KL Loss设计,让模型自己生成图片并接受教师模型的指导,哪里不对改哪里。
这种转变不仅显著提升了生成图片的细节性和合理性,还解决了传统轨迹蒸馏中图像模糊、细节扭曲的问题。同时,团队还通过热启动(PCM蒸馏)缓解了分布退化问题,进一步提升了模型的生成质量。
为了进一步提升模型在细节上的表现能力,阿里智能引擎团队还引入了对抗学习(GAN)机制。通过真实数据混合策略、特征提取器引入以及Loss权重调整等改进措施,对抗训练不仅提升了模型的泛化度和训练稳定性,还显著增强了生成图像的画面质感和细节表现。
阿里智能引擎团队的这一突破,不仅仅是对自身技术实力的一次展示,更是对AI生图领域的一次重要贡献。他们始终坚持开放共享的技术文化,此前已贡献了包括Havenask、RTP-LLM在内的多项优秀开源项目。未来,他们期待与开源社区共同成长,将更先进的工程能力转化为触手可及的创作工具。
现在,这一革命性的2步生成模型已经集成到呜哩AI平台上,无论你是专业设计师、内容创作者还是AI爱好者,都能通过呜哩AI平台轻松体验到AI生图的极致效率与魅力。
阿里智能引擎团队的这一突破,无疑为AI生图领域树立了新的标杆。他们用实际行动证明,通过不断创新与优化,AI生图不仅能够更快,还能更好。未来,我们有理由相信,AI生图将在更多领域发挥重要作用,为我们的生活带来更多惊喜与可能。
- Diffsynth-Engine:https://github.com/modelscope/DiffSynth-Engine
- Example Code:
import math
from diffsynth_engine import fetch_model, QwenImagePipeline, QwenImagePipelineConfig

# Create pipeline
config = QwenImagePipelineConfig.basic_config(
    model_path=fetch_model("Qwen/Qwen-Image-2512", path="transformer/*.safetensors"),
    encoder_path=fetch_model("Qwen/Qwen-Image-2512", path="text_encoder/*.safetensors"),
    vae_path=fetch_model("Qwen/Qwen-Image-2512", path="vae/*.safetensors"),
    offload_mode="cpu_offload",
)
pipe = QwenImagePipeline.from_pretrained(config)

# Load our turbo LoRA
pipe.load_lora(
    path=fetch_model("Wuli-art/Qwen-Image-2512-Turbo-LoRA-2-Steps", path="Wuli-Qwen-Image-2512-Turbo-LoRA-2steps-V1.0-bf16.safetensors"),
    scale=1.0,
    fused=True,
)

# Change scheduler config
scheduler_config = {
    "exponential_shift_mu": math.log(2.5),
    "use_dynamic_shifting": True,
    "shift_terminal": 0.7155
}
pipe.apply_scheduler_config(scheduler_config)

# Sample image
output = pipe(
    prompt="a young girl with flowing long hair, wearing a white halter dress and smiling sweetly. The background features a blue seaside where seagulls fly freely.",
    cfg_scale=1,
    num_inference_steps=2,
    seed=42,
    width=1328,
    height=1328
)
output.save("output.png")
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~