FinAnchor:轻量级多模型对齐金融文本表示
“FinAnchor: Aligned Multi-Model Representations for Financial Prediction”
金融文本预测是金融与自然语言处理交叉领域的核心问题,处理的多为长文档,决策相关信号稀疏微妙。本文提出FinAnchor轻量级框架,不微调底层模型,整合多LLM嵌入。在五个数据集上实验表明,FinAnchor整体性能最佳。
【 扫描文末二维码加入星球获取论文 】
摘要
金融长文档预测挑战大,有效信号少且易被噪声掩盖,不同任务和时期生成嵌入的最优大语言模型不同。本文提出FinAnchor轻量级框架,不微调底层模型,整合多LLM嵌入。它选锚嵌入空间,学习线性映射使其他模型表示与之对齐,聚合特征形成统一表示用于下游预测。在多金融NLP任务中,FinAnchor优于单模型基线和标准集成方法,证明锚定异构表示用于稳健金融预测有效。
简介
金融文本预测是金融与自然语言处理交叉领域的核心问题,处理的多为长文档,决策相关信号稀疏微妙。早期用传统机器学习管道,后预训练语言编码器取代手动特征设计,近来大语言模型(LLMs)受关注。但不同LLMs对同一长金融文档编码有不同归纳偏差,会产生异质推理和不同预测。这引发思考:能否系统整合异质表示空间,将互补证据转化为可用信号,避免性能不稳定或下降。
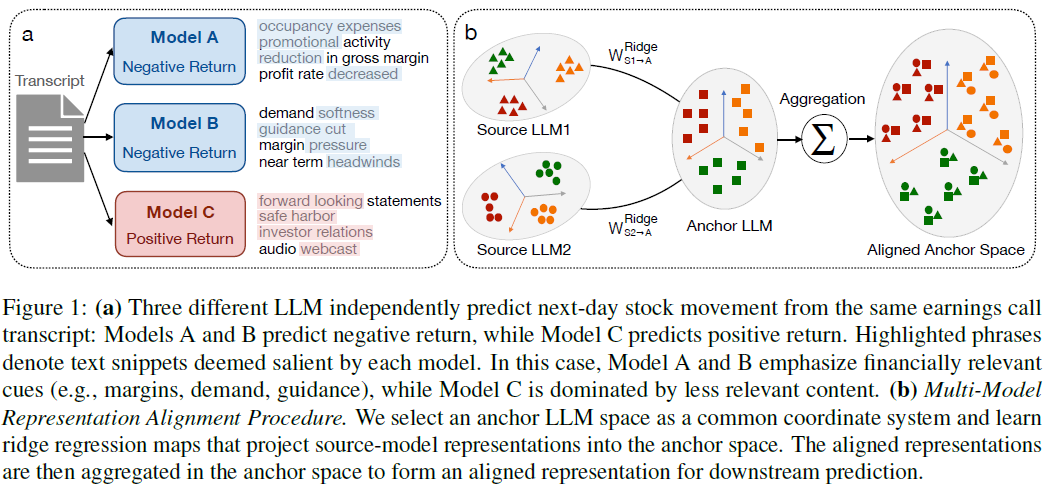
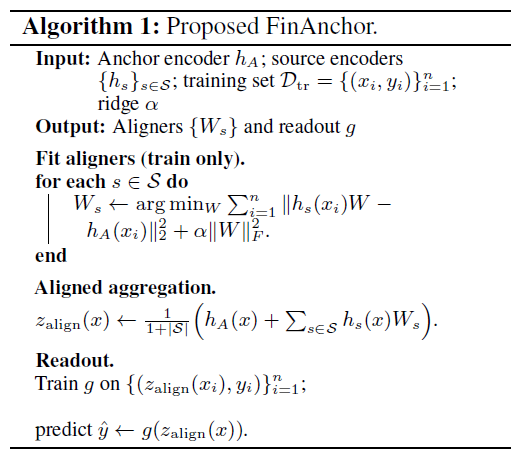
本文提出FinAnchor框架,在不微调基础模型下让多编码器聚合明确。选一个编码器为锚空间,用训练集学习其他编码器到锚空间的线性对齐映射,对齐后用固定算子聚合表示并训练下游读出器,降低训练和推理成本、保留可审计性。在多个金融预测任务上评估,用时间分割评估泛化性,还提供面向从业者的可解释性分析。
本文主要贡献:
引入轻量级多编码器对齐聚合框架,结合冻结大语言模型表示。
在多金融预测任务上系统评估,与单编码器和朴素多编码器基线对比。
提供可解释性分析,识别收益来源。
方法
问题设置
以文档 t_i 和标签 y_i 为示例,用 M 个冻结大语言模型编码器对 t_i 编码得表示 x_i,采用基于时间的数据集划分,仅训练嵌入层上的轻量级组件。
线性对齐到锚空间
不同编码器的原始嵌入在异构坐标系,选锚编码器 a,用岭回归学习线性映射将源编码器投影到锚空间,用训练集拟合映射矩阵 W_m,并在验证和测试集应用,报告训练集决定系数 R^2。
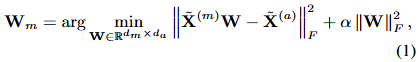
对齐表示聚合
对齐后在锚空间计算平均表示,最后对训练集进行特征标准化并用于验证和测试集。
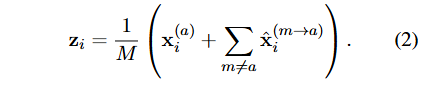
轻量级输出
在聚合表示 z_i 上训练小分类器 g_θ,二分类用多层感知机和交叉熵损失,多分类用softmax分类器和类重加权,在验证集进行模型选择和早停,选阈值优化标准并用于测试集。
实验
实验回答三问题:
RQ1:与基线模型性能对比;
RQ2:增益源于稳定系统信号而非偶然噪声;
RQ3:是否具备可解释性。
实验设置
任务与数据集:
收益惊喜预测:二元文本分类,输入长金融文本,评估集为会议电话记录、10 - Q文件和纳斯达克新闻文章。
股票走势预测:二元分类,输入收益电话记录,标签为股票次日涨跌。
FOMC立场分类:三元分类,预测FOMC通信货币政策立场,使用FOMC通信语料库。
基线对比:对比LLM零样本提示、LLM少样本提示、Longformer、Hierarchical FinBERT、单LLM表示五种基线。
实现细节:
以Gemma2 - 9BIT为锚模型,Qwen3 - 8B和Llama 3.1 - 8B - IT为源模型。
截断输入至最多20000个标记,学习岭映射对齐多模型表示。
MLP读出采用PyTorch,三层256隐藏层,0.5丢弃率和ReLU激活。
报告准确率、F1分数。
与基线对比
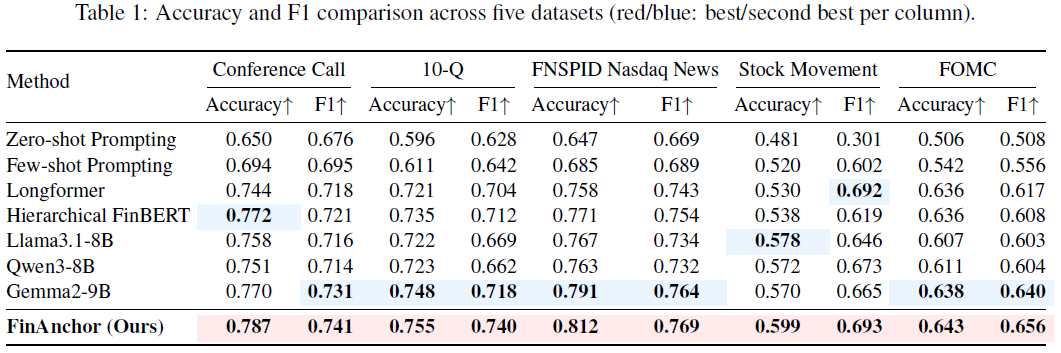
在五个数据集(会议纪要、10 - Q报告、FNSPID纳斯达克新闻、股票走势、FOMC)上对比FinAnchor与多种基线模型,结果有四点关键发现:一是基于提示的方法落后于学习型编码器,长文档任务差距最大;二是传统长文档编码器仍有竞争力,Longformer和Hierarchical FinBERT在三个文本密集型数据集表现出色;三是FinAnchor整体性能最佳,在五个数据集上准确率和F1值最高,在部分数据集大幅超越最强单模型LLM基线;四是在更具挑战性的股票走势和FOMC任务中,FinAnchor仍获最佳结果,表明该方法在信号较弱时也有益。
一致性分析
研究目的:探究FinAnchor收益反映的是系统信号还是随机波动,遵循证据链:基础表征有互补错误模式,多样性带来纠错空间并体现为决策转变,且转变在置信度上与真实情况方向一致。
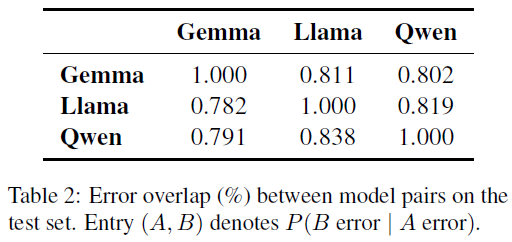
错误重叠:通过查看不同大语言模型表征是否犯相同错误进行诊断,单模型读数间成对错误重叠率远低于1,表明各表征有独特错误,是校正锚定误差的前提。
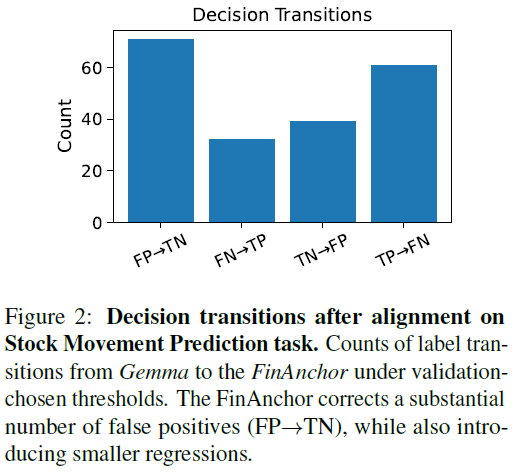
决策转变:考察对齐是否将多样性转化为可操作的校正。用对齐模型替换锚定读数时,FinAnchor呈现不对称转变,如大量假阳性转为真阴性,这在金融预测中有利于风险控制,有实际效用。
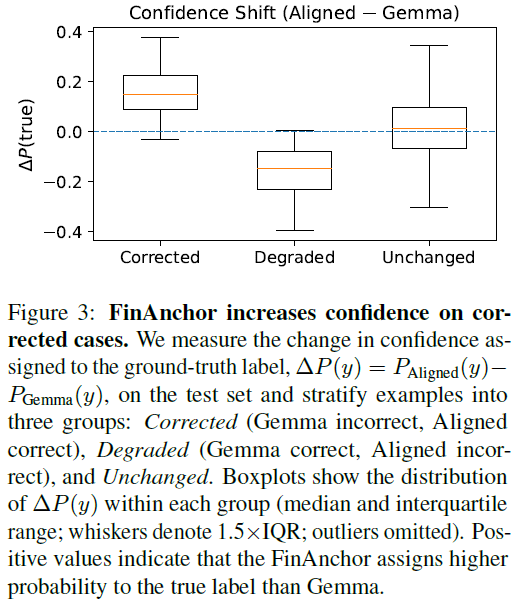
可信度漂移:为判断决策翻转是否源于阈值附近不稳定漂移,测量对齐是否将概率质量系统性重新分配到真实标签。定义置信度偏移 ∆p_true(x) = p_A(y | x) - p_G(y | x),若 FinAnchor 提取稳定信号改进模型,校正案例的 ∆p_true 应为正,未改变案例应接近零。图 3 符合预期,表明 FinAnchor 的改进源于真实标签置信度的一致提升,而非任意扰动。
可解释性分析
本文从两方面考察表征对齐后决策过程的变化:
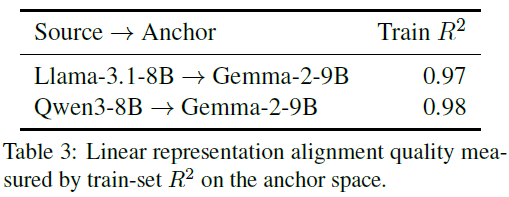
线性对齐质量:通过表3报告各源表征与锚(Gemma)嵌入空间对齐的岭回归映射的决定系数(R²),高R²表明不同大语言模型表征在该领域有兼容几何结构,对齐能将不同坐标系转换为共同语义框架,使后续融合有意义。
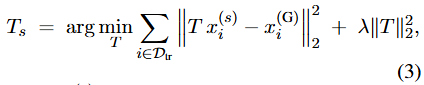
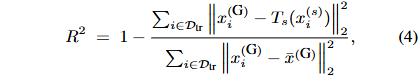
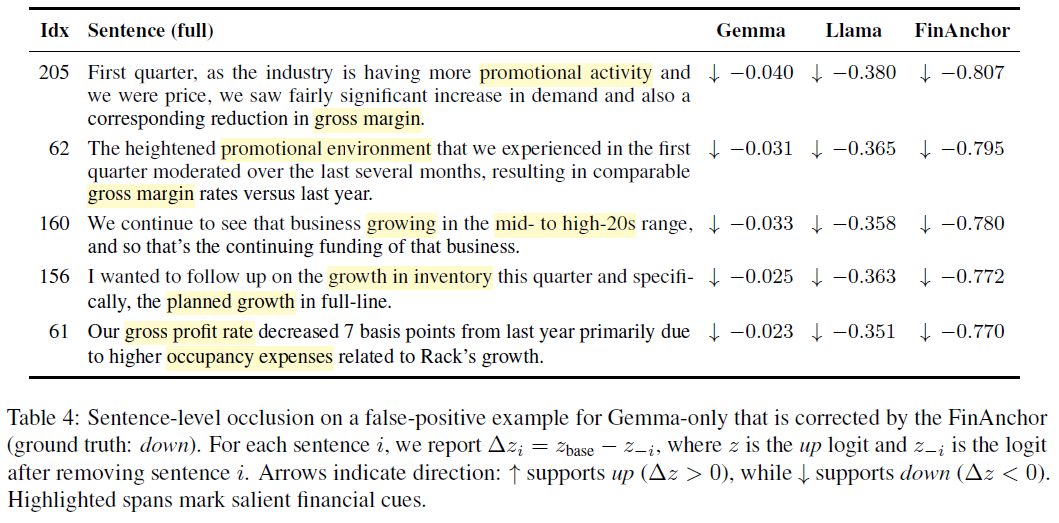
案例研究:表4展示Gemma单独使用时的假阳性示例经FinAnchor纠正的情况。通过遮挡法测量句子影响,发现FinAnchor对财务显著的看跌线索赋予更大权重,通过结构化的证据重新加权改变决策,而非随机干扰置信度。
限制
研究聚焦金融预测,用固定骨干模型和统一评估协议,研究结果普适性待在更多任务、语言和模型族中验证;方法结合冻结表征与对齐聚合模块,虽简化训练和部署,但引入额外实现选择和超参数,需开展系统敏感性研究和工程成本分析以增强可重复性和实用性。
总结
本文提出结合异构大语言模型表示的简单对齐方法,即学习线性映射到锚空间、聚合对齐视图并训练轻量级读出器用于金融预测。在五项任务中,FinAnchor 优于单视图基线且易实现。分析表明改进并非源于噪声,不同视图错误不同,对齐将多样性转化为有效修正,尤其能减少虚假买入信号;可解释性分析显示增益源于对齐模型间互补语义证据,而非随机扰动。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
