DYCOR:股票趋势预测方法,捕捉股票间潜在关系,平均IC提高53.3%、Rank IC提高11.2%
“DYCOR: Capturing Hidden Stock Relationships for Stock Trend Prediction”
准确预测股票趋势对金融机构等有重要意义,现有方法基于基本面或技术分析。基本面分析利用股价及新闻等外部数据,可能无法捕捉股票间细微时变互动,预设的静态股票关系难以适应股市高波动性。
本文提出DYCOR股票趋势预测方法,可捕捉股票间演变和潜在关系,提升预测准确性。实验证明,DYCOR多数情况下优于基线方法,平均IC高53.3%、Rank IC高11.2%,能有效建模动态关系,增强预测稳定性。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
股票趋势预测因金融市场复杂动态而极具挑战,现有方法依赖静态关系且目标有局限。本文为此提出 DYCOR 方法,有两大创新:动态股票聚类,自适应发现隐藏关系;关联感知训练,细粒度反映相关性。在 NASDAQ、NYSE 和 S&P 500 三个数据集评估,相比基线方法表现更优且运行效率有竞争力。
简介
准确预测股票趋势对金融机构等有重要意义,但因金融市场复杂,这一直是挑战。随着深度学习和金融数据增多,提出众多预测方法,现有方法基于基本面或技术分析。基本面分析利用股价及新闻、银行-企业网络等外部数据,但依赖外部数据可能无法捕捉股票间细微时变互动,预设的静态股票关系难以适应股市高波动性。
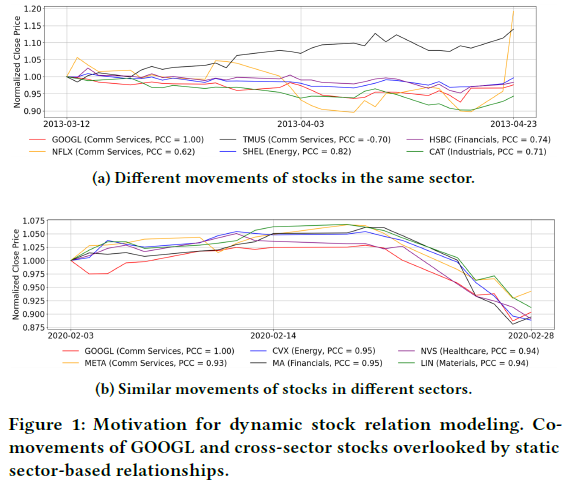
技术分析方法分四类:个股预测法仅关注单股历史数据;全对相关性法建模股票间两两依赖关系;超图法捕捉股票群体交互。但三者均难灵活反映时变多样的市场行为:方法(i)孤立处理个股;方法(ii)仅捕捉两两交互;方法(iii)构建的图固定,无法捕捉市场变化。图1展示静态股票关系的局限,表明静态关系图难捕捉时变的股票依赖,在动态市场下可能导致关系建模偏差。
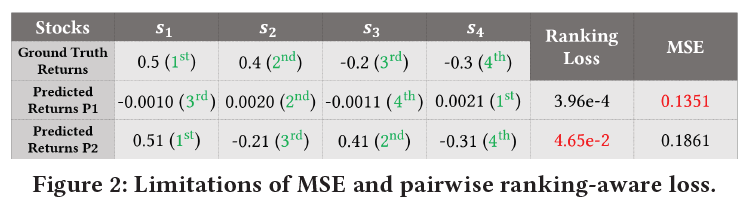
现有常用损失函数(MSE和排名损失)有局限:MSE易通过预测接近零的值最小化误差,不考虑股票相对差异;排名损失在成对差异符号一致时无法捕捉幅度不匹配,可能误导模型性能评估。
本文提出DYCOR股票趋势预测方法,含四部分:动态股票聚类、股票内相关性分析、股票间跨簇聚合、相关性感知训练,可捕捉股票间演变和潜在关系,提升预测准确性。
本文主要贡献:
发现现有方法因依赖个体特征等难以反映动态股票交互;
引入DYCOR新框架;
在多指数上评估,DYCOR多数情况下优于基线方法,平均IC高53.3%、Rank IC高11.2%,能有效建模动态关系,增强预测稳定性。
相关工作
股票趋势预测方法分两类:
基本面分析:利用新闻、高管网络等外部信息,如RSR、STHAN - SR等方法,但依赖预定义概念、关系和规则,创建静态相关图,限制市场潜在交互多样性。
技术分析:
个股预测:仅基于单只股票特征预测,如ARIMA、RNN等,未考虑股票间关系。
全对相关性:利用股票间成对相关性,如DTML、MASTER等,但忽略高阶或群体交互。
超图方法:捕捉复杂高阶股票关系,如CI - STHPAN、StockMixer。
预备知识
定义 3.1:股票 𝑠 在时间 𝑡 的趋势定义为次日收益率。
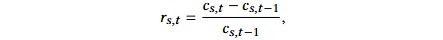
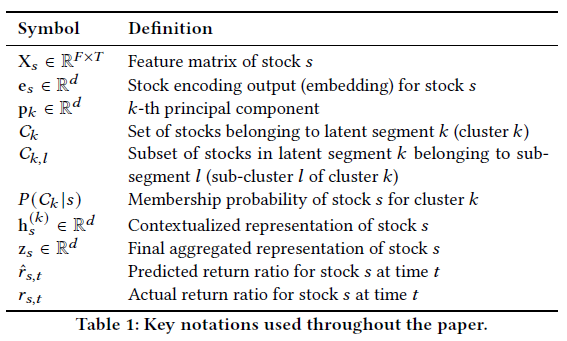
𝑐𝑠,𝑡 为股票 𝑠 在 𝑡 时刻收盘价, 𝑟𝑠,𝑡 是预测目标值,每只股票在长度为 𝑇 的回溯窗口各时间步有 𝐹 个特征,构成特征矩阵 X𝑠 ∈ R𝐹 × 𝑇。
定义 3.2:给定股票集合 𝑆,{X𝑠}𝑠 ∈ 𝑆 ∈ R | 𝑆 | × 𝐹 × 𝑇 表示所有股票特征,股票趋势预测目标是利用每只股票截至 𝑡 时刻的历史特征预测其收益率 𝑟𝑠,𝑡,即学习函数 𝑓𝜃 预测所有股票收益率。
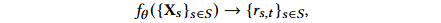
DYCOR
概览
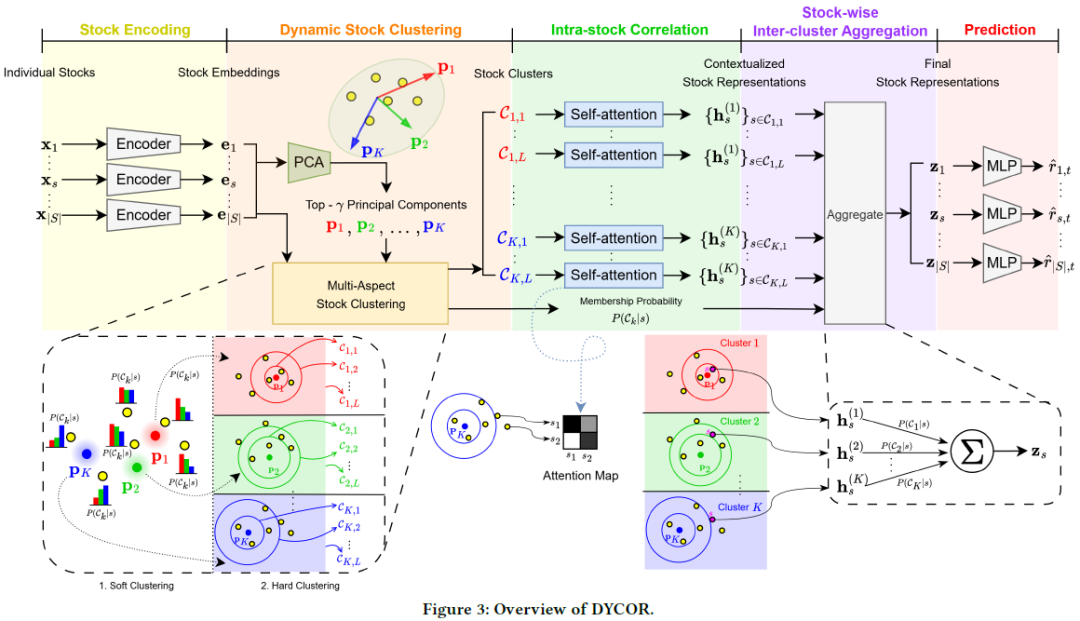
DYCOR整体架构含五阶段:股票编码阶段对股票历史特征编码生成嵌入;动态股票聚类阶段用PCA算主成分,依相似度聚类;股内关联阶段用自注意力机制建模子集群内股票关系;股票间集群聚合阶段按成员概率加权组合各股票多表示形成最终表示;预测阶段预测各股票回报率。
股票编码
股票编码器以各股票回看窗口特征 Xs∈R F×T 为输入,将其编码为潜在表示,含三个关键组件:
股票趋势分解:用移动平均滤波器将 Xs 分解为趋势 Xs tr 和波动 Xs fl 两部分,经线性投影得 Xs′,捕捉平滑趋势与短期波动。
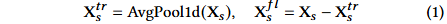
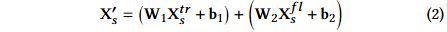
时间混合:通过访问回看窗口所有可能前缀,在各特征不同时间步间交换信息,生成含历史信息的时间表示 X^s。
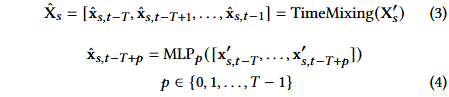
指标混合:在 X^s 各时间步隐藏特征间交换信息,考虑技术指标交互。实现时对一维卷积压缩序列应用时间和指标混合。通过一维卷积(Conv1d)得到隐藏特征,单层MLP聚合这些特征,生成股票嵌入 es,其维度 d=T2+T。es 能捕捉中期趋势与短期波动、时间依赖关系和跨指标关系。
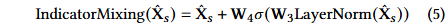
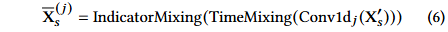
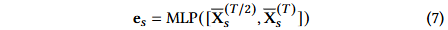
动态种群聚类
股票在行业内及市场中常表现出相关行为,本文采用数据驱动的动态股票聚类,捕捉市场条件变化下股票的复杂互动,区别于基于预定义行业分类的静态方法。
潜在分段表示:从之前阶段的股票嵌入中,用主成分分析(PCA)提取反映市场不同方面的正交表示,选取累积解释方差比超过γ的最小主成分集。
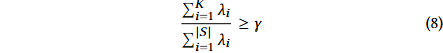
多方面股票聚类:
采用软聚类和硬聚类两种方法。软聚类计算每只股票属于潜在分段的成员概率,用带温度参数τ的softmax操作将相似度转化为概率,τ值越高,概率分布越软。
硬聚类将每个潜在分段内的股票进一步分为L个潜在子分段,按股票属于该潜在分段的概率降序排序后均分,以检测股票间细微差异。
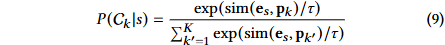
股票间相关性
对每个潜在子段 C_{k,l},利用自注意力机制,基于股票相关性计算所有 s ∈ C_{k,l} 股票的子段感知上下文表示 H_{k,l}。
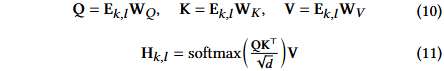
从每只股票 s 角度,此阶段获得 K 个上下文表示,能从多方面捕捉股票关系。
实际中,可通过计算 S 中所有股票间的掩码自注意力,并行应用上述公式到每个 C_{k} 的子段,每只股票仅关注其所属潜在子段的股票。
股票类集群间聚合
股票受多个潜在细分市场不同程度影响,如半导体企业既与同行业企业表现相似,又受其他行业客户企业影响。此前阶段各股票有从多个潜在细分市场独特视角得到的嵌入空间表示,此阶段通过按各方面影响程度加权聚合这些表示得到股票最终表示,为与股票关联度更高的潜在细分市场视角赋予更高权重,以反映股票同时受多细分市场不同程度影响的复杂现实。
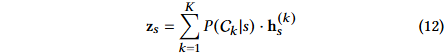
预测
两层MLP以每只股票的最终表示 zs 预测其回报 r^s,t。
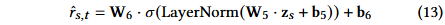
相关性训练
多数现有股票趋势预测方法同时采用回归损失和排名损失,但排名损失会忽略股票回报的方向一致性和相对大小,无法反映显著的幅度差异。
为解决此不足,采用预测回报与真实回报的复合损失训练方法。L reg 为对异常值稳健的Huber损失,L corr 为相关感知损失,λ corr 经验值取0.65。
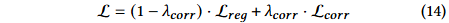
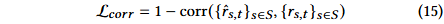
L corr 旨在最大化PCC,通过真实回报的标准分数作为每只股票的损失权重,使模型关注偏离均值较大的股票,学习回报间的相对顺序和比例关系。
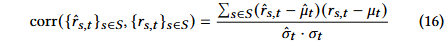
实验
实验设置
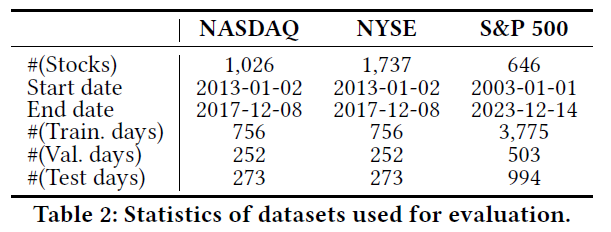
数据集:用三个美国股市真实数据集(NASDAQ、NYSE、S&P 500)评估,前两者由[9]整理,S&P 500 源自雅虎财经,均经预处理。
评估指标:采用信息系数(IC)、排名信息系数(Rank IC)、IC 信息比率(ICIR)、Rank IC 信息比率(Rank ICIR)、Recall@n、NDCG@n 评估。
基线模型:与 LSTM、Transformer 等常用模型,TimeMixer、iTransformer 等时间序列预测模型,以及 RSR、DTML 等股票趋势预测模型对比。
实验细节:结果为五次独立运行的平均值,通过网格搜索调参。回看窗口长度 𝑇 = 16;NASDAQ 和 S&P 500 子簇数 𝐿 = 4,NYSE 为 𝐿 = 6;PCA 累积解释方差比阈值 𝛾 = 0.93;软最大温度参数 𝜏 = 0.2;学习率 1e - 4。
结果
表3显示DYCOR在多数评估指标上表现优于基线模型:在NASDAQ各指标表现最佳,IC较MATCC提升约54%,Rank IC较DTML提升16%;在NYSE各指标均占优,IC和ICIR较StockMixer分别提升约56%和68%;在S&P 500的IC和ICIR表现最佳,较RSR分别提升50%和42%,Rank IC和Rank ICIR仅次于StockMixer。S&P 500因高波动性和长训练周期使多数基线模型表现不佳。
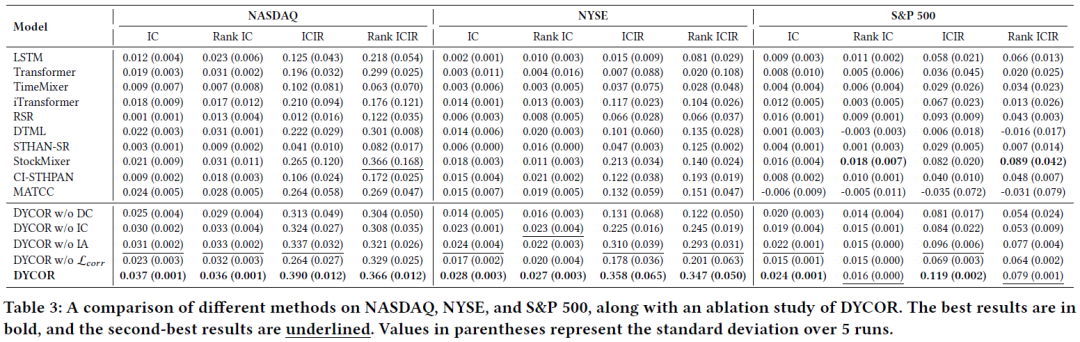
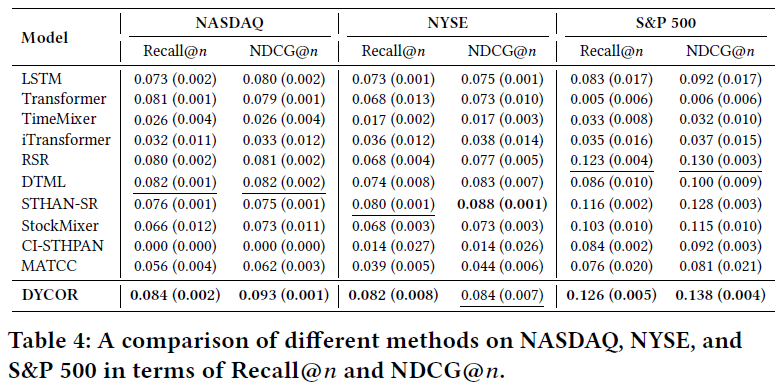
表4用检索指标证实DYCOR有效性,在NASDAQ和S&P 500的Recall@ 𝑛和NDCG@ 𝑛指标上领先,评估 𝑛 ∈ {5, 10, 20},以 𝑛 = 20展示结果,各 𝑛 值表现趋势一致。
消融分析
为验证方法关键组件贡献,进行消融研究。对比 DYCOR 及其移除特定组件的变体性能:
移除动态股票聚类(w/o DC),各数据集性能显著下降,NYSE 降幅最大,表明该组件随市场规模扩大作用关键。
移除股票内相关性(w/o IC),性能中度下降,说明建模同簇内股票相关性有助于提升准确性。
移除股票间跨簇聚合(w/o IA),性能轻微下降。
仅用 Huber 损失和排序损失(w/o L_corr),各数据集性能持续下降,凸显训练中纳入股票相关性监督的重要性。
分析
动态种群聚类分析。用动态时间规整(DTW)评估动态股票聚类结果,计算簇内股票对的平均DTW距离(簇内距离)和不同簇股票对的DTW距离(簇间距离),结果显示各市场中簇内距离均低于簇间距离,表明簇内相似度更高。
图4展示纽约证券交易所测试期随机时间戳下,与各主成分最相似的前5只股票价格,各簇内股票价格模式相似,不同簇股票走势差异大,且相似走势股票分属不同行业,说明股票关系超越传统行业分类且动态演变。图5展示了簇3内行业部门的多样化分布,进一步说明簇内的跨行业构成。
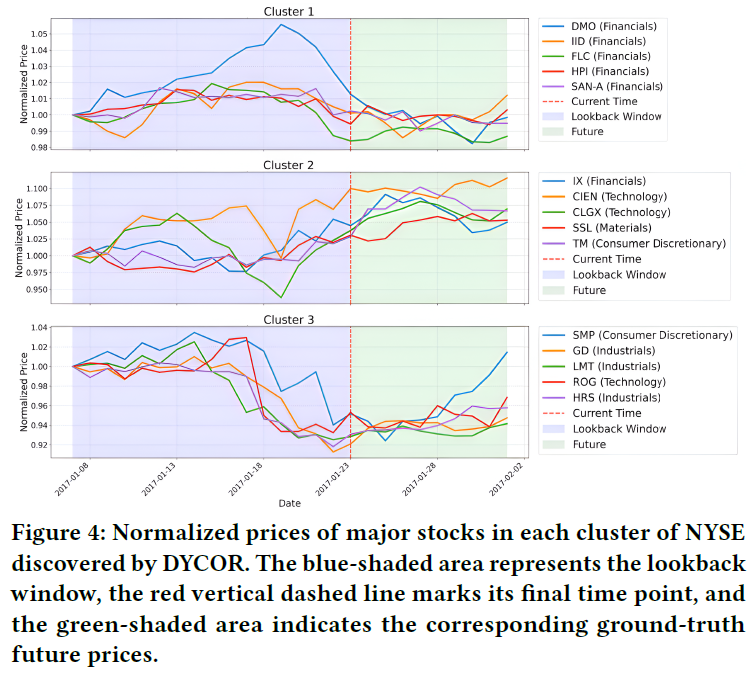
图4分析显示,DYCOR动态股票聚类能捕捉潜在业务关系、供应链连接等,突破传统行业分类局限。如Cluster 1内股票多属同一行业,Cluster 2和3含多行业股票但价格走势相似,深入分析可发现跨行业隐藏业务联系。
图4还表明各聚类内股票未来走势相似,DYCOR不仅利于单日预测,也对中期预测有价值,但本文仅聚焦单步预测以便对比。
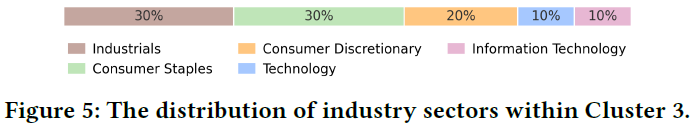
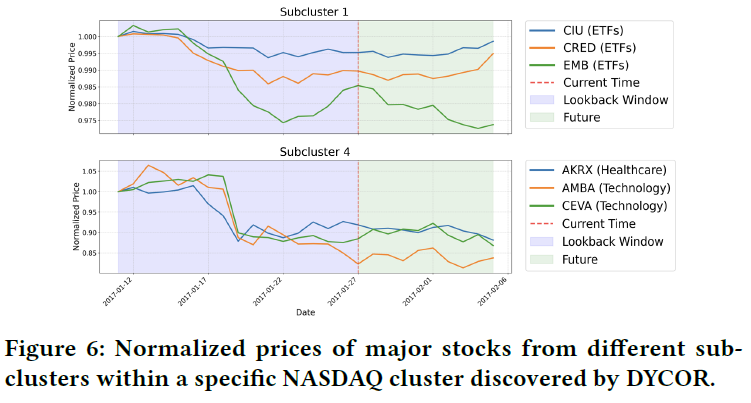
图6展示不同子聚类股票归一化价格走势,虽整体趋势相同,但1月中旬表现有差异,体现子聚类策略能精细捕捉股票走势差异,通过股票内相关性建模。
计算每日股票次日收益率方差分析市场波动对聚类结果的影响,发现DYCOR在方差增大时形成更多聚类,中等方差下有高IC和Rank IC。
关联感知损失的有效性。图7a对比DYCOR及其不同损失配置变体的NDCG@𝑛:仅用回归损失因对股票间依赖监督不足致性能欠佳;回归+排序无法充分捕捉预测与真实收益同号时的幅度差异,回归+corr(DYCOR)在NDCG@5和NDCG@10上与回归+排序差距更明显,能更好识别高影响股票,验证了4.7节讨论的局限性。
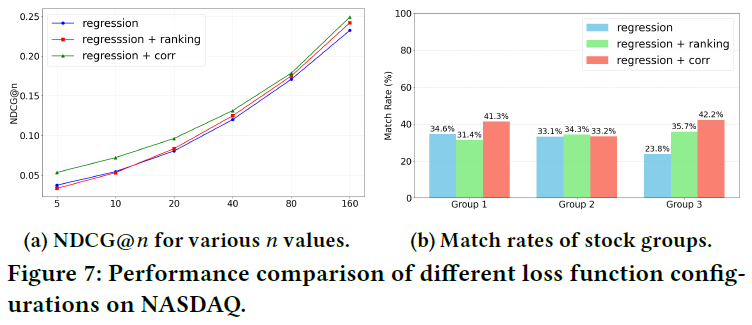
为进一步验证相关感知损失有效性,将股票按预测收益降序排序并分三组,计算每组按真实趋势正确分类的股票百分比。图7b显示三种损失配置的匹配率,回归+corr在第1和3组匹配率最高,或因最大化PCC时,真实收益偏离均值大且预测与真实在方向和幅度上匹配的股票对PCC贡献大。
时间效率
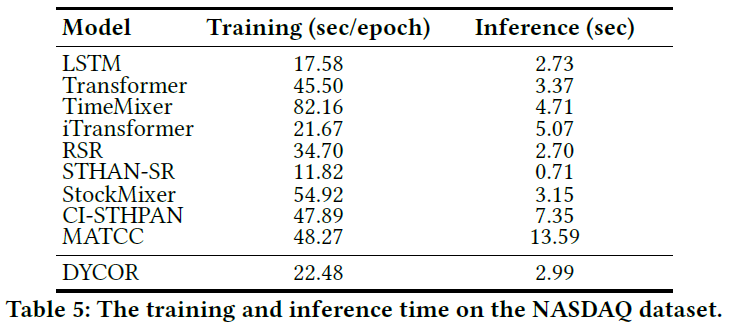
在 NASDAQ 数据集相同硬件设置下评估计算效率,报告各方法训练和推理时间。DYCOR 推理快、预测强,训练效率佳,单轮训练时间显著低于 CI - STHPAN 和 MATCC 等竞品。
超参数敏感性
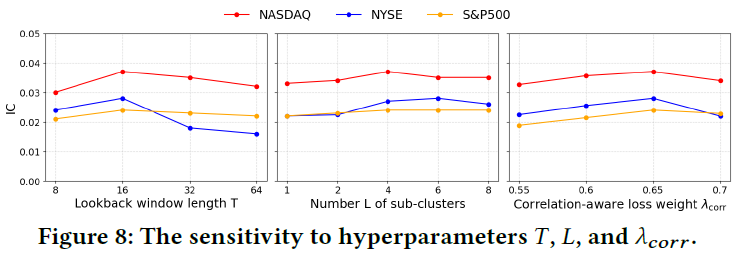
图8展示三个关键超参数(回溯窗口长度T、子簇数量L、相关感知损失权重λ_corr)敏感性分析结果:三数据集在T = 16时性能最优;DYCOR在NYSE上L = 6时IC达0.028,在NASDAQ和S&P 500上L = 4时IC分别达0.037和0.024;三数据集λ_corr最优值均为0.65。
总结
本文提出 DYCOR 解决现有股票趋势预测方法的两个局限:一是难以捕捉动态和跨行业关系,二是现有损失函数无法充分捕捉预测与真实趋势的相关性。DYCOR 融合动态聚类、股票内相关性和跨聚类聚合,通过相关感知训练使预测与真实趋势方向一致。实验显示其性能优越,能捕捉复杂股票关系。未来将拓展至多步预测并评估交易应用表现。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
