Janus-Q:端到端事件驱动交易框架,夏普比率提升 102.0%,方向准确率提高 17.5%
“Janus-Q: End-to-End Event-Driven Trading via Hierarchical-Gated Reward Modeling”
金融市场长期用时间序列建模研究,纯数值预测因市场噪声、非平稳性和制度转变而具挑战性,促使引入替代信息源。资产价格变动常由离散可解释事件引发,不同事件类别市场反应异质,现有交易系统未充分利用事件级信息,多将文本新闻作辅助。
本文提出 Janus-Q 端到端事件驱动交易框架,分两阶段:阶段一构建含 62400 篇文章的大规模金融新闻事件数据集;阶段二结合监督学习与强化学习进行决策导向微调。
实验表明,Janus-Q 比市场指数和大语言模型基线表现更优,夏普比率最高提升 102.0%,方向准确率比最强竞争策略提高超 17.5%。
【 扫描文末二维码加入星球获取论文 】
摘要
金融市场走势常由新闻传达的离散金融事件驱动,现有基于文本信息的交易信号学习系统面临两大挑战:缺乏大规模以事件为中心的数据集、语言模型推理与金融有效交易行为不匹配。
本文提出 Janus-Q 端到端事件驱动交易框架,分两阶段:阶段一构建含 62400 篇文章的大规模金融新闻事件数据集;阶段二结合监督学习与强化学习进行决策导向微调。
实验表明,Janus-Q 比市场指数和大语言模型基线表现更优,夏普比率最高提升 102.0%,方向准确率比最强竞争策略提高超 17.5%。
简介
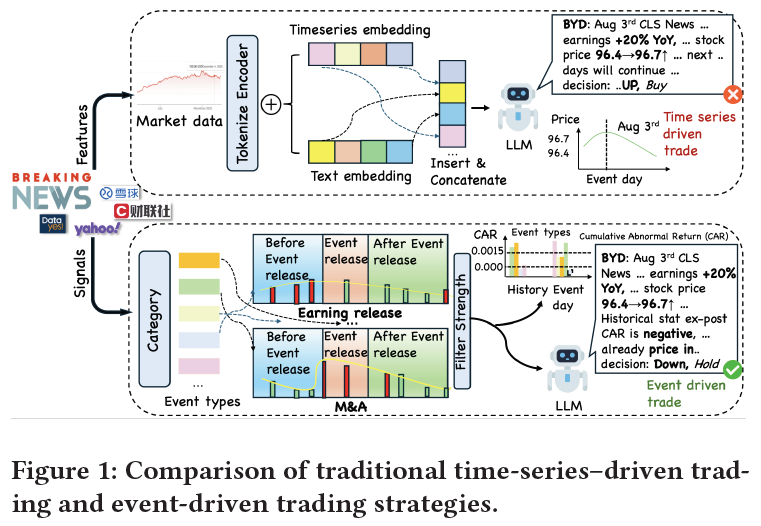
金融市场长期用时间序列建模研究,纯数值预测因市场噪声、非平稳性和制度转变而具挑战性,促使引入替代信息源。资产价格变动常由离散可解释事件引发,不同事件类别市场反应异质,现有交易系统未充分利用事件级信息,多将文本新闻作辅助。
当前的方法存在两大挑战:一是缺乏事件-市场粒度,现有金融数据集难区分有意义新闻与噪声,通用领域数据集稀缺;二是语义推理与市场现实不一致,语言模型语义判断与市场结果不匹配。
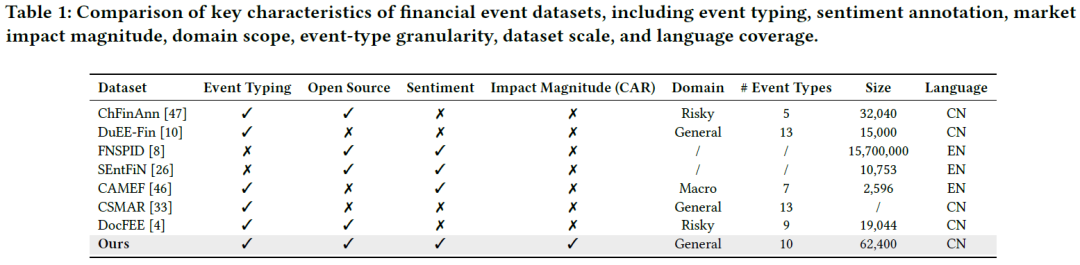
本文提出 Janus-Q 两阶段事件驱动交易框架,构建含 62400 篇专家标注新闻文章的大规模金融事件数据集。研究基于数据集开发决策导向训练范式,采用多步优化,先监督微调建立事件描述到预期CAR的映射,再用HGRM进行强化微调,解决语义-市场差距。
实验表明 Janus-Q 表现优于市场指数、时间序列模型及各类基线模型,平均方向准确率提高17.5%、事件类型准确率提高18.2%,消融研究证实HGRM的关键作用。
本文主要贡献:
构建含62400篇金融新闻的大规模数据集;
提出首个端到端事件驱动交易框架 Janus-Q;
评估显示其交易表现强且稳定,夏普比率提高102.0%、方向准确率提高5.4%,证实事件理解与交易决策有效对齐。
相关工作
事件驱动建模
早期事件驱动市场分析源于计量和统计金融,经典事件研究法通过因子模型估计预期回报衡量市场反应。后续研究纳入文本信息,机器学习和深度学习方法将文本与市场数据结合。如Ding等提取结构化事件建模,Wang等引入StockMem框架辅助预测。但现有方法重预测,未明确建模事件属性,且缺乏交易标准数据集。为此,提出集成事件分类、情感标注和事件影响评估的以事件为中心的数据集。
大模型用于交易
近期研究探索用大语言模型(LLMs)处理交易相关任务,其能处理非结构化金融文本并给出推理过程,相比传统模型可解释复杂市场事件、适应市场冲击。如Yang等将指令调优的LLM用于金融分析和交易,Zhang等提出基于LLM的金融代理FinAgent,Xiao等研究多智能体交易框架、推出Trading - R1,Li等提出RETuning框架。但当前基于LLM的交易系统有局限:一是交易决策多依赖价格或成交量信号,文本信息融合弱;二是强化学习方法奖励设计简单,难以权衡经济意义上的取舍。为此提出分层门控奖励模型,将事件级语义推理与基于市场的交易结果相结合。
方法
以事件为中心的数据构建
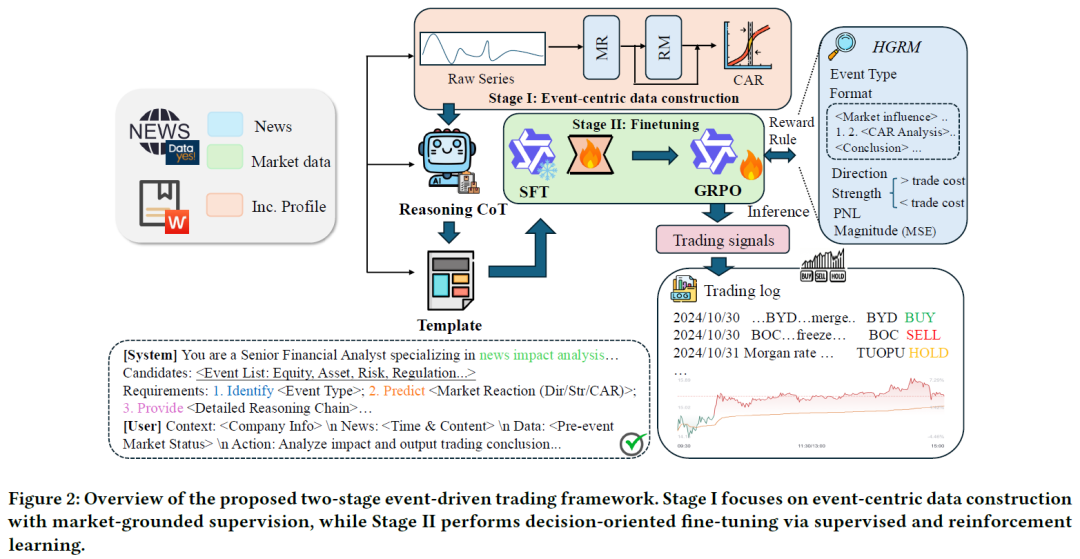
本文探究事件对关联资产在方向和幅度上的影响,以及与其他事件类型影响的差异。通过构建事件中心数据集,结合市场影响和金融新闻事件语义解读。
事件-CAR 建模
以事件发生时的股票新闻为基础,用事件窗口的累计异常收益率(CAR)量化市场影响。定义估计窗口和事件窗口,前者用于估计无事件正常收益,后者捕捉异常价格反应。
市场模型(MR):通过估计窗口的市场模型去除市场波动,得到异常收益率(AR)。
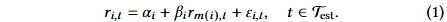
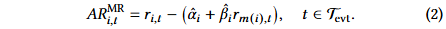
风险模型(RM):对 MR 得到的 AR 进一步用多因素风险模型中性化,得到因子中性的 AR。
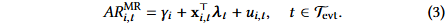
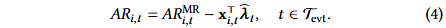
累积异常收益(CAR):计算 CAR 总结事件导致的异常价格变动。
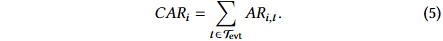
事件分类和情感标注
用 CAR 量化事件对资产价格的经济影响,同时为每个事件关联结构化语义标签。每个事件用真实标签 𝑦 = { 𝑐, 𝑑, 𝑠, 𝑒} 表示,其中 𝑐 为已实现的 CAR,𝑒 为标注的事件类型。方向 𝑑 由 𝑑 = sign( 𝑐) 确定,交易强度 𝑠 由预定义阈值 𝜏 决定,二者表征市场对事件的反应,补充 𝑐 的定量影响幅度。
面向决策的微调
纯监督微调无法保证模型推理转化为符合市场的决策。现有强化学习方法依赖启发式、加法设计的奖励,竞争目标可能相互抵消,难以模拟经济上有意义的权衡。
本文基于事件中心数据集,进行面向决策的微调,采用多步训练范式:先进行监督微调(SFT)稳定结构化事件推理。用 Group Relative Policy Optimization(GRPO)进行强化微调,直接优化交易决策。
设计结构化奖励机制:
等级控制奖励模型:生成包含预测累计异常回报、方向、交易执行与否、事件类型的复合预测。若预测方向或交易强度缺失,从预测累计异常回报推断。
硬方向门:方向正确性:设硬方向门 g dir,防止错误市场极性下的虚假利润,s dir < 0 时 g dir = 0 阻止后续奖励。
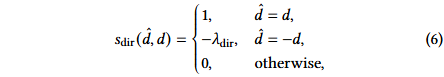
软方向门: 事件类型的一致性:引入事件类型软门,预测事件类别错误时折扣奖励,鼓励事件理解与交易结果一致。
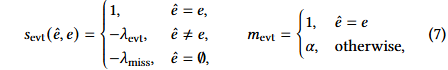
交易奖励:具有强度正则化的成本感知PnL:定义考虑成本的单事件交易回报,仅预测交易强度为“强”时激活,结果奖励裁剪到对称范围。正则化预测的交易强度,对误判采用非对称成本惩罚,防止模型出现极端交易行为。
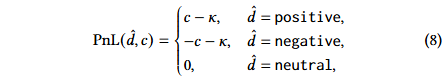
量级塑造和过程奖励。方向未被阻断时添加幅度塑形项 f_{ma} 提供精细监督,还设轻量级过程奖励 r_{proc} 评估推理部分,惩罚过长回复和过度自问。
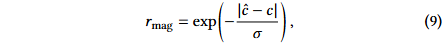
整体奖励。最终 HGRM 奖励分层构成,高层门控控制低层奖励激活,g_{dir} 可阻断低层奖励。
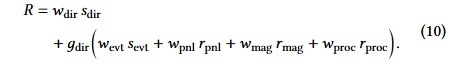
实验
实验设置
对股票集S中股票s,在交易日t执行Janus - Q驱动的多空交易策略:
信号生成:分析t日9:30至t + 1日9:30新闻,为每只股票s生成方向信号γₛ,ₜ(长仓、短仓、持有)。
事件加权信号聚合:t日按事件类型权重wₖ聚合新闻信号,用t + 1日开盘前信息分配每日预算。
入场规则:若聚合信号γₛ,ₜ为长(短)仓,t + 1日以开盘价oₛ,ₜ₊₁开仓。
出场规则:持仓至后续两个交易日中最后一个交易日τ(t),以收盘价cₛ,ₜ₍ₜ₎平仓。
评价目标
对 Janus-Q 在事件驱动交易中的有效性进行综合评估,重点考察整体交易表现及关键设计组件贡献,围绕四个研究问题展开实验:
RQ1:Janus-Q 在交易表现和决策准确性上是否持续优于市场指数和竞争模型基线;
RQ2:各核心组件对其整体交易表现的贡献;
RQ3:多样化奖励目标对提升学习稳定性和决策导向交易表现的效果;
RQ4:Janus-Q 在解读金融事件时与人类判断的契合程度。
数据集和评估指标
模型在整合文本与金融信息的多源数据集上评估。新闻文章于 2023.1.1 - 2025.1.25 从 Datayes 收集,股价数据于 2023.1.1 - 2025.2.6 从 Tushare 获取,数据按 4:4:1:1 比例划分。还纳入 Wind 平台的企业资料用于语义丰富。采用 MAE、RMSE、DA、ETA、SR、MDD 六个指标评估模型,综合考量预测质量和投资表现。
基线模型
提出的方法与四类基线对比评估:
市场指数:以沪深 300、500、1000 等代表中国股市大、中、小盘的指数为被动投资基准。
时间序列导向大语言模型:如 Time - MQA、ChatTS - 14B、TimeMaster 等用于时间序列预测。
金融领域特定大语言模型:像 FinMA、DISC - FinLLM、Stock - Chain 等经金融语料预训练或微调,可用于市场分析和交易评估。
通用大语言模型:包括 QwQ - 32B、Claude - 3 - Haiku 等,未针对金融任务调优。
结果
将Janus-Q与16种基线方法在六项通用评估指标上对比。市场处于修正、回调和盘整阶段,各基准指数风险调整后收益为负,多数时间感知模型和金融大语言模型表现不佳,通用大语言模型中仅QwQ-32B和DeepSeek-v3.1-nex-n1有正夏普比率但波动大。Janus-Q抓住12月下旬上涨,后续稳定增长,最终累计回报最高。
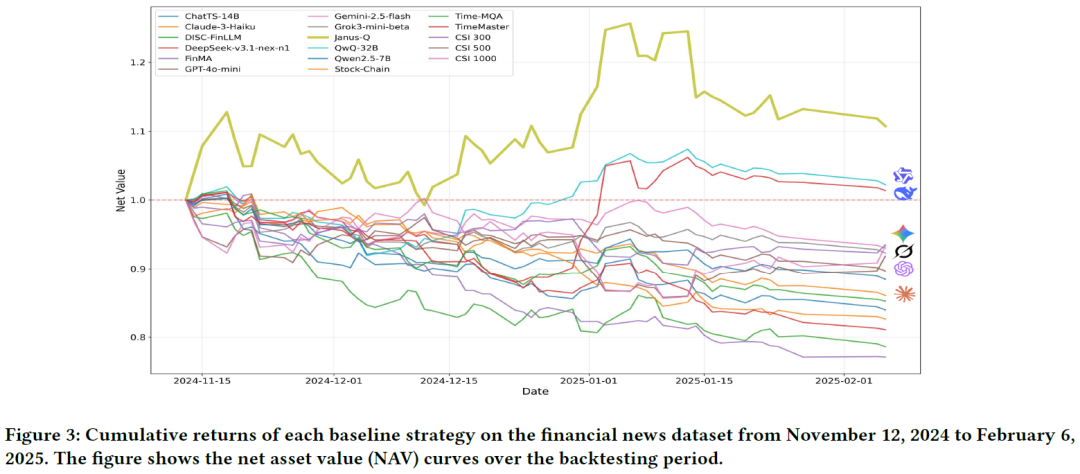
表2显示Janus-Q在决策和交易层面指标上均优于所有基线。它的CAR预测误差最低,较最佳时间感知模型、最强金融大语言模型基线和最佳普通大语言模型分别降低18.3%、50.6%和5.4%;方向准确率分别超三者17.5%、29.0%和22.4%。
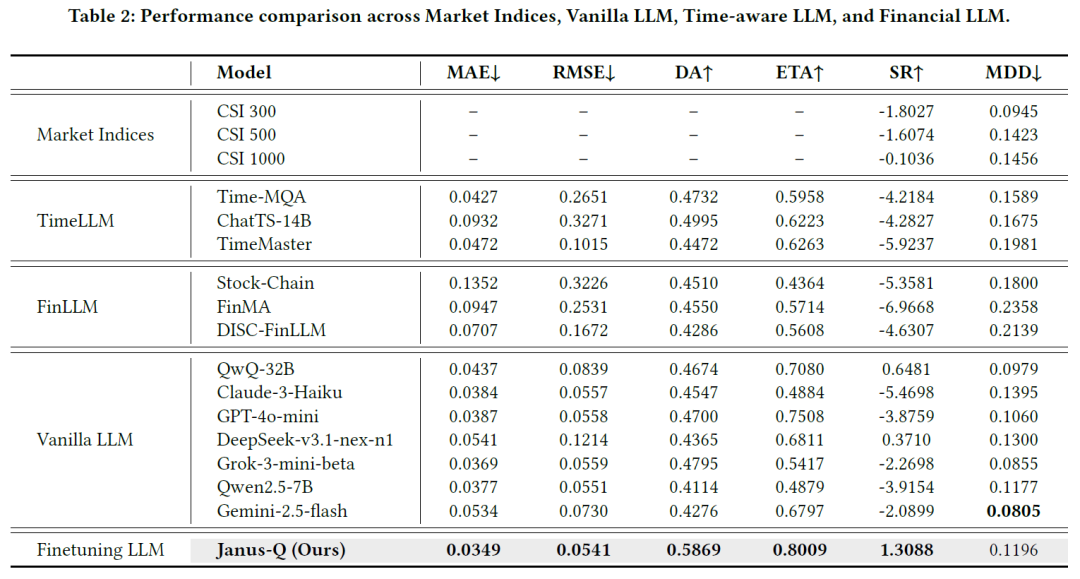
领域特定金融大语言模型(FinLLM)表现逊于多数通用大语言模型,或因微调时任务与领域不匹配、架构或上下文长度受限;时间感知模型回测表现不佳,仅注入文本线索不足以支撑稳健交易,直接优化事件到决策映射更有价值。Janus-Q夏普比率达1.3088,超亚军QwQ-32B一倍多,相对提升超102.0%,而时间感知和金融大语言模型基线在测试期夏普比率为负。部分基线虽回撤略低,但回报大幅降低,Janus-Q在盈利性与稳定性间取得更好平衡,风险调整后表现更优。
消融分析
表3展示Janus-Q各组件消融研究结果,移除任一组件都会降低性能,表明框架有效性源于核心模块协同。移除监督微调性能恶化最明显,方向准确率降超14%,夏普比率由正转负,凸显其奠定决策基础的关键作用;移除强化优化使夏普比率降约13%,说明强化学习主要微调已有策略;移除CAR监督或公司级信息,预测准确性和盈利能力也有下降,显示市场影响线索和公司特定信息对事件驱动交易有贡献。
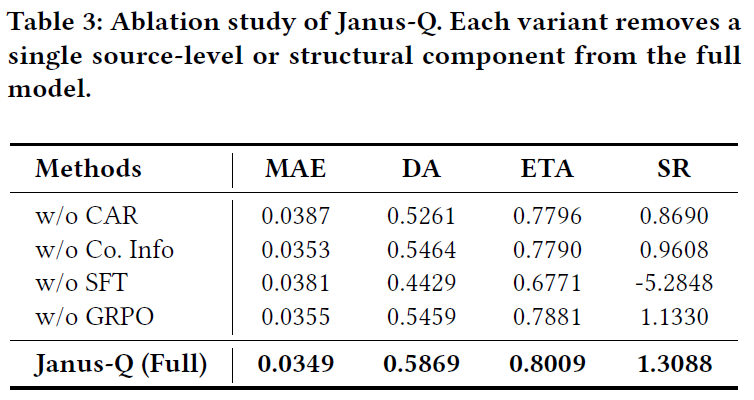
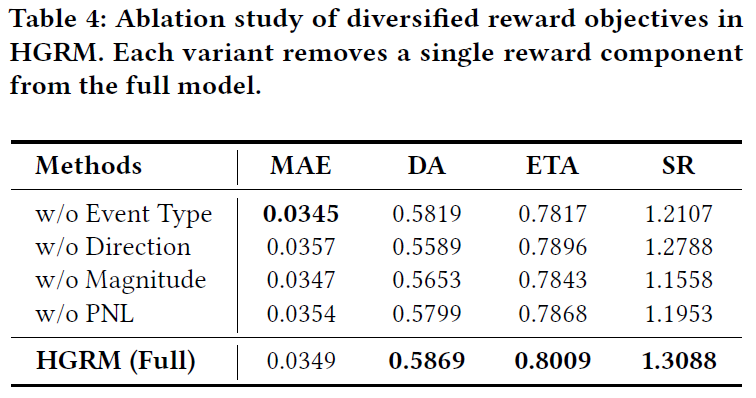
表4研究从全HGRM中移除单个奖励目标的影响,结果显示所有消融变体表现均不如全模型,说明多样化奖励目标在学习稳定有效交易策略中起互补作用。移除方向相关目标使决策质量下降最明显,方向准确率降超4.8%,但对交易表现影响较温和;移除事件类型监督稍降预测误差,使交易表现小降;消除幅度或损益目标使表现显著变差,夏普比率分别降约11.7%和8.7%。全HGRM决策准确率最高、交易表现最强,表明联合优化多样化奖励目标对稳定学习和决策导向的事件驱动交易至关重要。
案例分析
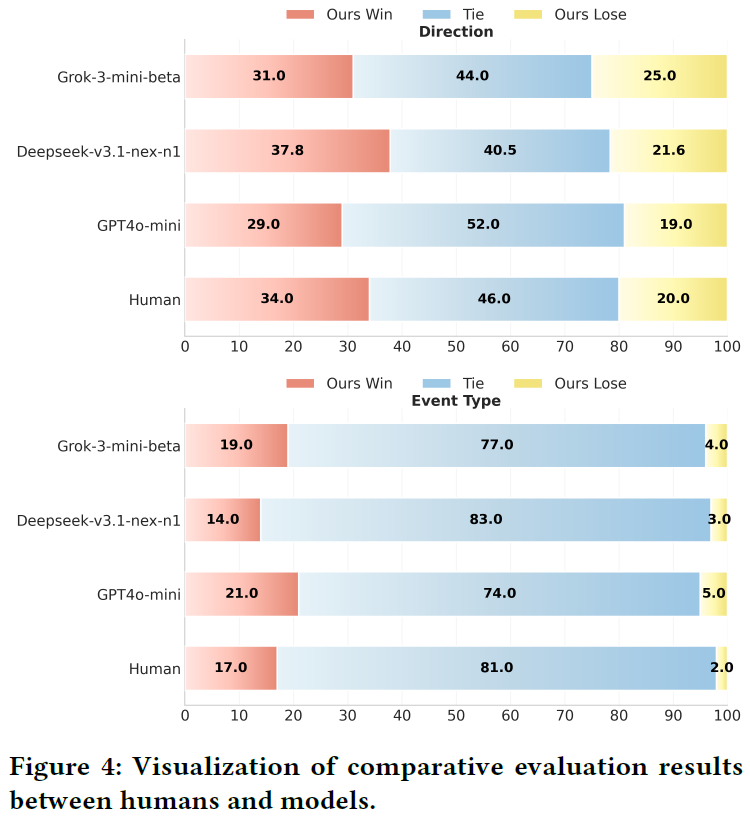
对200个测试样本进行事件解释评估,招募三位不同金融专业背景人员通过多数投票形成人类共识基准。方向预测上,Janus-Q 与人类和其他模型有较高一致性,平局率40.5% - 52.0%,最高胜率37.8%,输率不超25.0%;事件类型理解方面,平局占比74.0% - 83.0%,输率低于5.0%,有14.0% - 21.0%的胜率。Janus-Q在事件解释上比人类评估者更准确,且具备决策和上下文敏感交易所需的灵活性。
总结
本文研究事件驱动交易,提出 Janus-Q 两阶段事件驱动交易框架,该框架构建事件中心数据集用于市场影响分析,采用多步训练范式。实验表明,Janus-Q在决策准确性和交易表现上超市场指数和大语言模型基线。未来计划扩展框架以支持更细粒度事件结构、多模态输入和跨市场回测。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
