一张照片,演完一部“连续剧”!FlashPortrait 把 AI 人像动画提速 6 倍,重新定义无限长肖像动画
添加微信号:AIGC_Tech,公众号小助手会拉你进群!
点击下方名片关注AIGC Studio公众号!获取最新AI前沿应用/AIGC实践教程!
“让静态照片开口说话”已经不稀奇,但让同一张照片连续演 3 分钟、3000 帧不崩脸、不漂移、不鬼畜,还把推理时间从 1 小时压缩到 10 分钟——这就是由复旦大学、微软亚洲研究院、西安交通大学、腾讯、阿里巴巴通义实验室刚发布的 FlashPortrait 交出的成绩单。
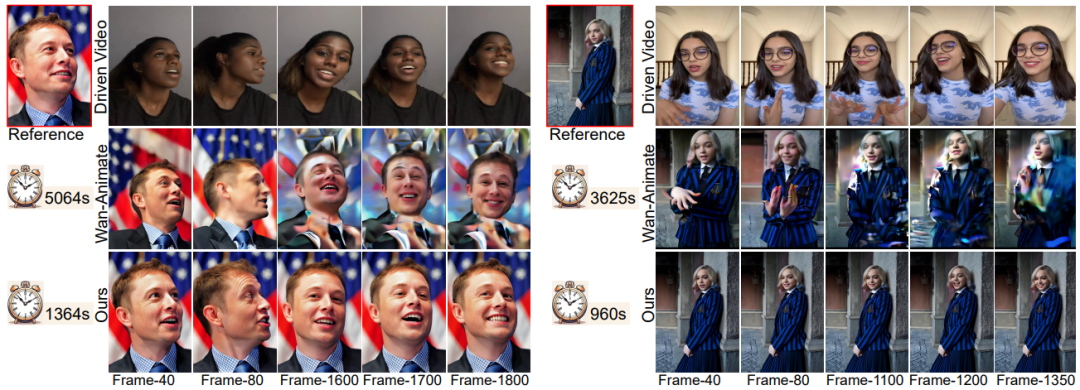
过去两年,扩散模型(Diffusion)把肖像动画卷出了花:
- 2 秒短视频 → PSNR 30+、FID 10 以内
- 20 秒长视频 → 身份漂移、颜色鬼畜、推理 1 h+
核心矛盾一句话:帧数一多,模型就“失忆”——
- 人脸逐渐“长歪”
- 肤色逐帧“偏色”
- 显存随长度线性爆炸
业界加速套路无非两派:
- Cache 派:把算过的特征存起来复用,但“大表情”一动就翻车;
- 蒸馏派:训一个 4-Step 学生网络,结果细节被“蒸馏”没了。
FlashPortrait 的思路是:既不蒸馏,也不硬 Cache,而是“预测”未来几步的潜变量,直接跳过去。

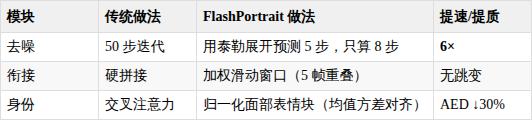
一句话总结:
> 在潜变量空间做“高阶差分”,配合两个动态函数实时校正,复杂表情也能“跳步”而不崩。
- 先拿现成的 PD-FGC 提取“表情向量”
- 再与 CLIP 图像特征做“均值-方差对齐”
- 把分布差距从 𝑂(10²) 压到 𝑂(10⁻¹)
→ 1800 帧后,人脸关键点 MAE 仍 < 13°(SOTA 20°+)
- 每 60 帧一个窗口,重叠 5 帧
- 线性权重融合:w=[0, 0.25, 0.5, 0.75, 1]
→ 肉眼无感过渡,FVD 长视频指标直接降 50%
- 用 三阶差分 近似泰勒展开
- 动态函数 s(t) 感知“表情变化剧烈程度”
- 动态函数 w(l,i) 感知“网络层敏感度”
→ 同样 20 s 视频,720 s 跑完,比 Wan-Animate 快 3×,比 FantasyPortrait 快 6×
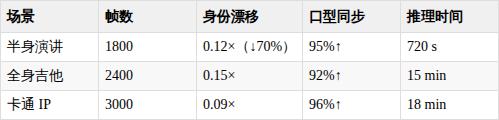
> 注:身份漂移 = ‖参考图特征 − 生成图特征‖₂ / ‖参考图特征‖₂
项目已开源:
- 论文:arXiv 2512.16900
- 代码:GitHub – Francis-Rings/FlashPortrait
- Demo:Hugging Face Gradio(20 s 视频 3 分钟出片)
- Podcast 批量替身
录 1 小时音频 → 一张照片 → 生成 1 小时对口型视频,剪辑直接省 80%。 - IP 虚拟主播
卡通形象 + 直播推流,24 h 不间断,身份永不崩。 - 影视“数字替身”预演
替身演员拍一遍,主演脸直接贴,导演现场看效果。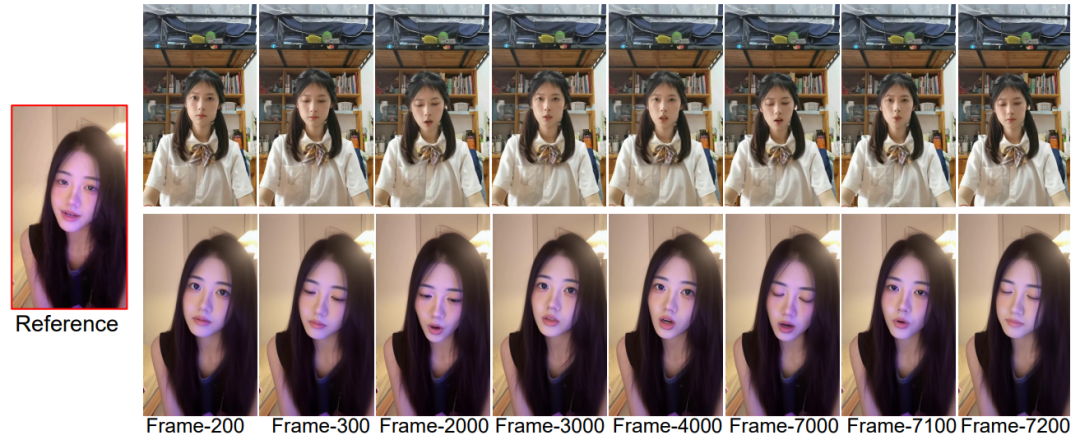
8. 一句话收个尾
当“无限长度”与“实时速度”同时达成,肖像动画才真正从“实验室玩具”变成“生产力工具”。
FlashPortrait 已经开源,下一个爆款短视频,你准备让谁“动”起来?
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系