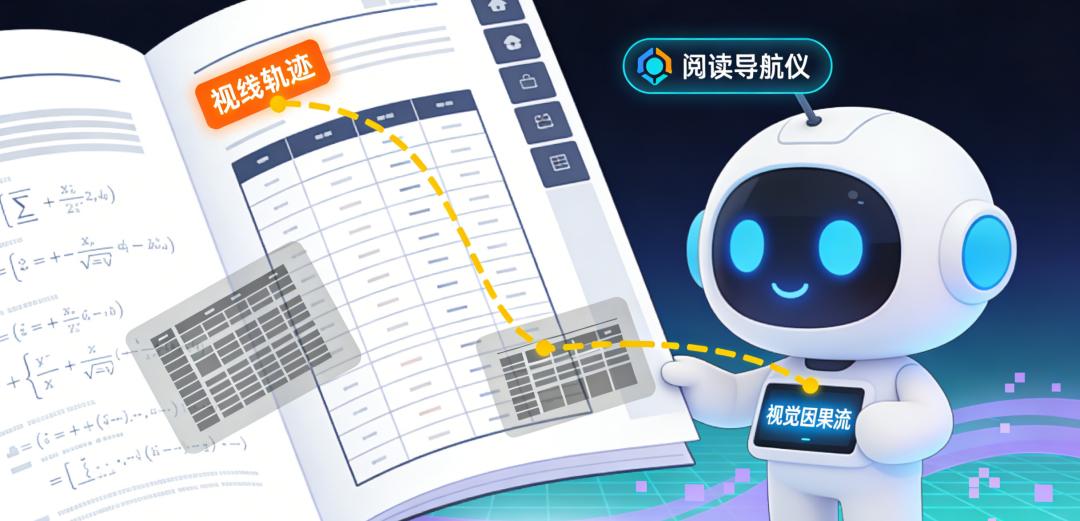
DeepSeek-OCR 2 的视觉认知革命:视觉因果流让AI “读懂逻辑”
你有没有过这样的经历?用PDF阅读器的OCR功能转换一篇带表格的论文,结果打开文本一看,表格里的行和列全乱了——第一行的标题跑到了第三行后面,公式里的“x²”被拆成了“x”和“2”;或者读一份带插图的报告,OCR把图注当成了正文,硬生生插在段落中间,让整段话变得不知所云。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
我之前处理一份年度财报时就遇到过这种糟心情况:报表里的“营收”和“成本”列被颠倒,害得我对着数字核对了半小时才发现是OCR的锅。那时候我就好奇,为什么机器看文档的方式,和我们人差这么多?直到读到DeepSeek-AI团队的《DeepSeek-OCR 2: Visual Causal Flow》论文,我才找到答案——原来传统的视觉语言模型(VLM),一直在用一种“最死板的方式”看世界。
一、机器的“阅读强迫症”:为什么传统OCR总在“读错顺序”?
先想一个简单的问题:你是怎么看这篇文章的?大概率是从标题开始,然后读导语,再顺着段落往下走;但如果这篇文章里有一张表格,你会先看表格标题,再扫一眼列名,然后才看具体数据——你不会像读小说一样,从表格的左上角第一个单元格,逐行逐列读到右下角。
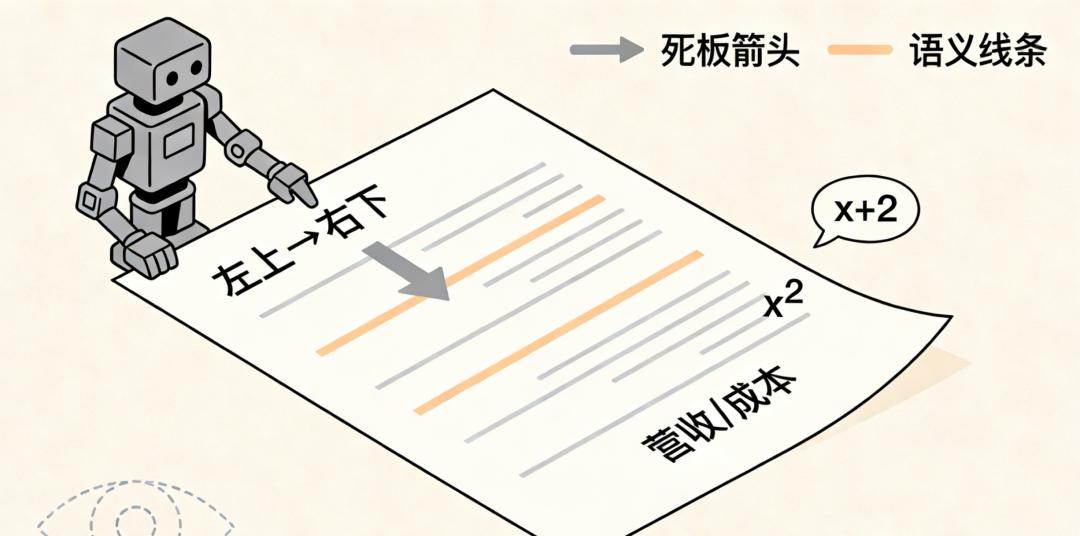
这就是人类视觉认知的核心特点:我们的“阅读顺序”跟着语义走,而不是跟着空间位置走。心理学里有个概念叫“视觉扫视路径”,说的就是人眼会根据信息的逻辑关系调整移动轨迹,比如看报纸时先抓头条,看菜谱时先找菜名,看论文时先看图表标题再看内容。
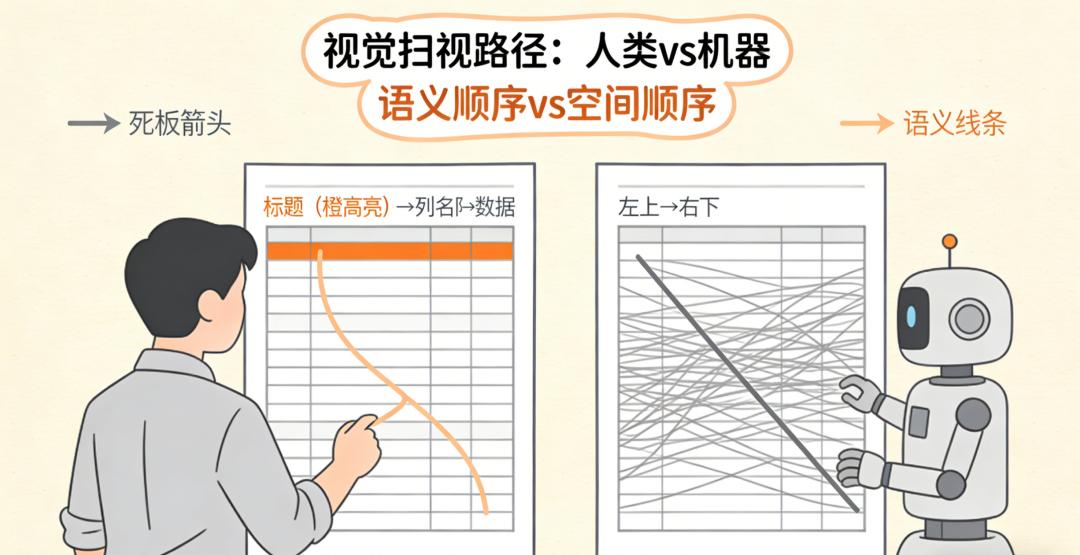
但传统的OCR模型,却一直有个“阅读强迫症”:它们处理图像时,会把图像切成一个个小方块(也就是“视觉tokens”),然后不管内容是什么,都严格按照“左上→右下”的固定顺序处理——就像一个刚学会认字的小学生,不管书里是故事、表格还是公式,都必须从第一页第一行第一个字,读到最后一页最后一行最后一个字。
这种“死板”在简单文档(比如纯文字段落)里问题不大,但遇到复杂布局(比如带公式的论文、带表格的财报、带插图的手册)就会出大错。比如一篇论文里,正文旁边有个补充说明的“侧边栏”,传统模型会把侧边栏的文字插在正文中间,因为它按空间顺序扫到了;再比如一个跨两行的表格单元格,模型会把它拆成两个独立的内容,因为它按行扫描时“看不到”单元格的逻辑关联。
这就是DeepSeek-OCR 2要解决的核心问题:让机器像人一样,根据语义逻辑调整“阅读顺序”,而不是被空间位置绑架。研究员们给这个能力起了个名字——“视觉因果流”,简单说就是“后看的内容,要和先看的内容有逻辑关系”,就像你先看了“表格标题:2024年营收”,再看表格里的“1月:500万”,这两者是因果关联的;但如果你先看“1月:500万”,再看表格标题,逻辑就乱了。
二、DeepEncoder V2:给机器装个“阅读导航仪”
要让模型学会“按逻辑读文档”,关键在编码器(Encoder)——这个部件相当于模型的“眼睛”,负责把图像信息转换成能理解的“语言”。传统模型用的是CLIP(一种通用视觉编码器),就像一副“通用眼镜”,能看清图像但不懂“阅读逻辑”;DeepSeek-OCR 2则把这副“眼镜”换成了DeepEncoder V2,相当于给模型装了个“阅读导航仪”。
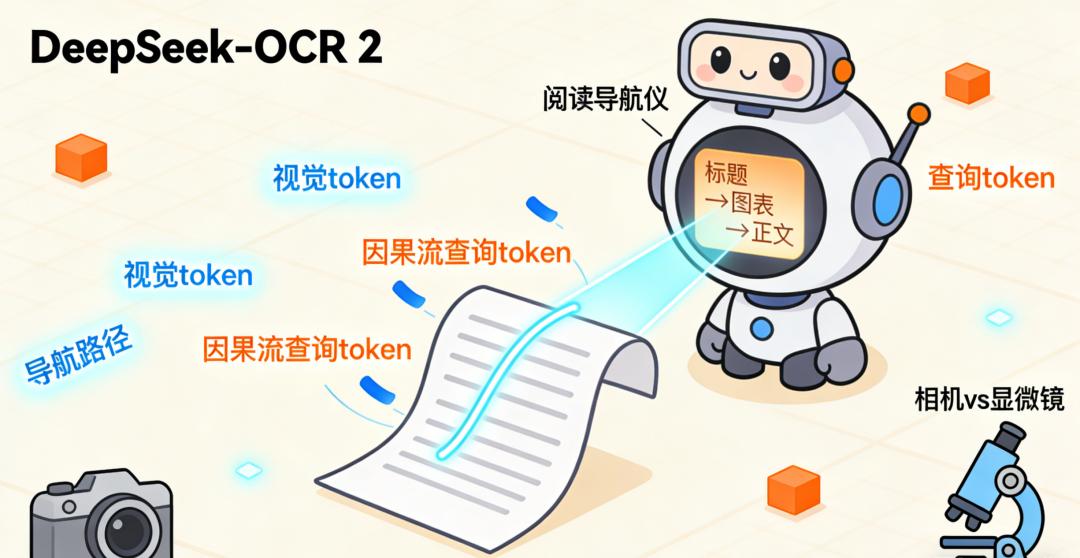
我得用几个通俗的比喻,才能讲清这个“导航仪”的妙处——毕竟论文里的“因果流查询”“注意力掩码”这些术语,普通人听着就头大。
1. 把“通用相机”换成“定制显微镜”:用LLM架构替代CLIP
传统模型的CLIP编码器,就像一台“拍全景的相机”,能把整个文档拍下来,但分不清“哪些是关键信息,该先看”;而DeepEncoder V2把CLIP换成了LLM(大语言模型)架构——你可以理解成把“相机”换成了“带导航的显微镜”:既能像显微镜一样聚焦细节(比如公式里的符号、表格里的数字),又能像导航一样按逻辑顺序移动镜头。
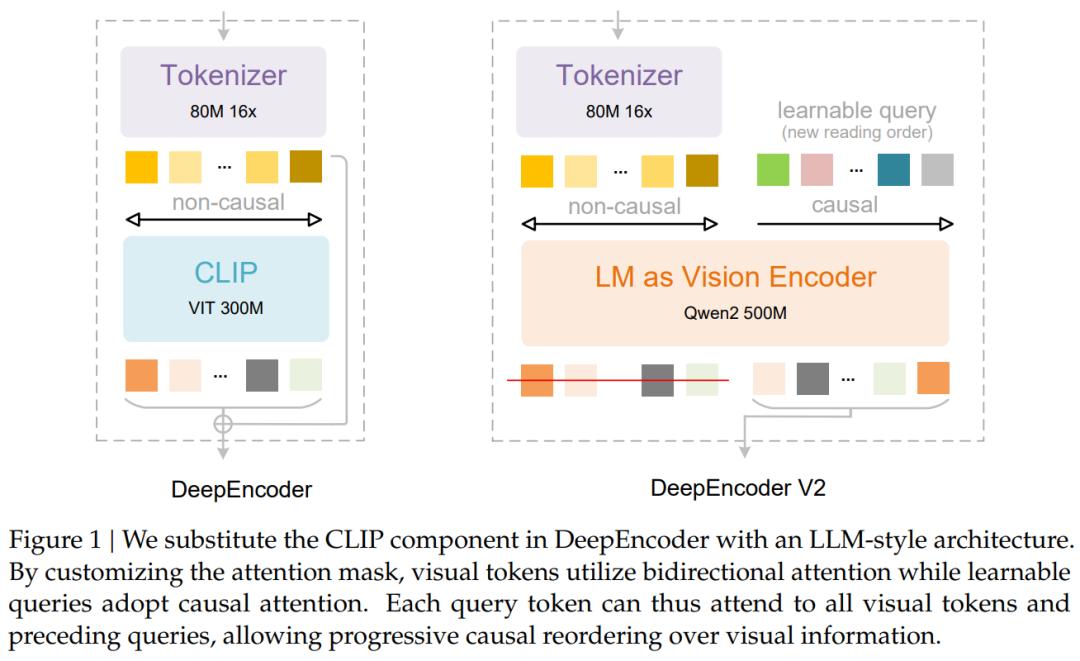
为什么LLM架构能做到这点?因为LLM天生就懂“顺序逻辑”——它处理文字时,会根据前文语义预测后文(比如你说“今天天气很好,我打算去”,LLM知道接下来大概率是“公园”“散步”这类词)。把这种“顺序逻辑”用到视觉处理上,模型就能理解“先看标题,再看内容”的因果关系,而不是瞎扫。
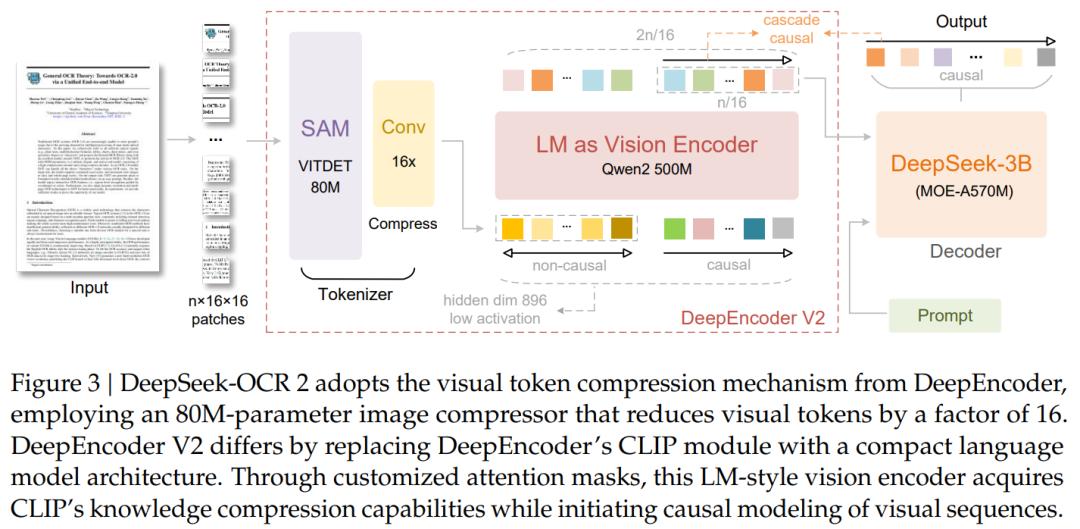
研究员们选的是Qwen2-0.5B(一款5亿参数的轻量LLM),这个选择很务实——既不会像大模型那样费算力,又能保证“顺序逻辑”的能力。就像给模型配了个“轻便的导航仪”,不会因为太重而影响走路速度。
2. 给模型配个“阅读清单”:因果流查询的作用
你读复杂文档时,会不会先在心里列个“阅读清单”?比如“先看摘要→再看图表→最后看结论”。DeepEncoder V2里的“因果流查询”(Causal Flow Query),就是模型的“阅读清单”——这些是一组可学习的“查询tokens”,相当于模型提前想好“我要按什么顺序看这些内容”。
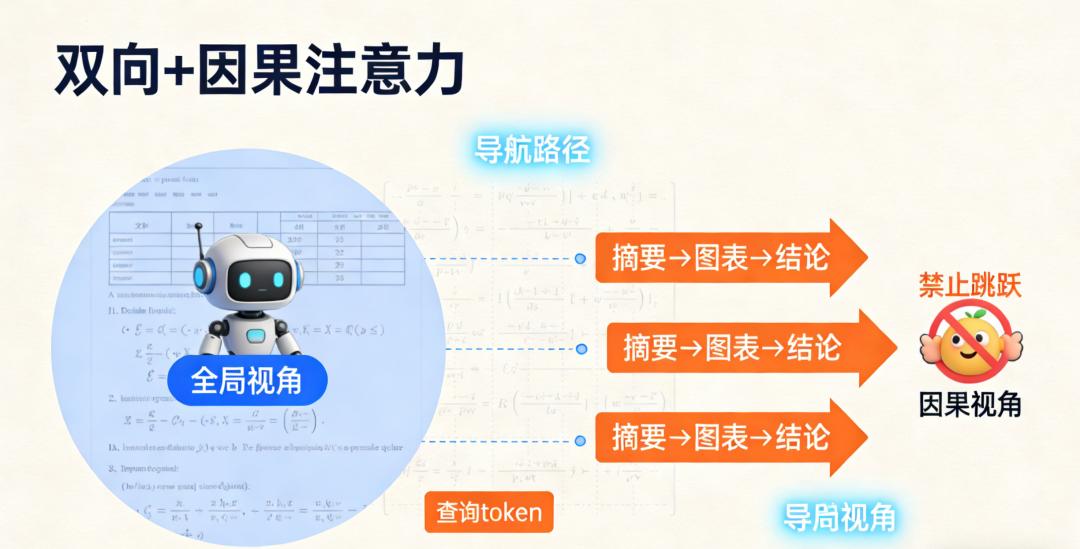
这里有个很妙的设计:因果流查询的数量和视觉tokens的数量相等(比如视觉tokens有256个,查询也有256个)。为什么要这样?论文里说这是为了“重新注视”(re-fixation)——你可以理解成模型看文档时,也会“回头核对”,就像你读表格时,看完一行再回头看列名确认“这列是营收还是成本”。如果查询数量不够,模型就没法“回头看”,很容易漏掉逻辑关联。
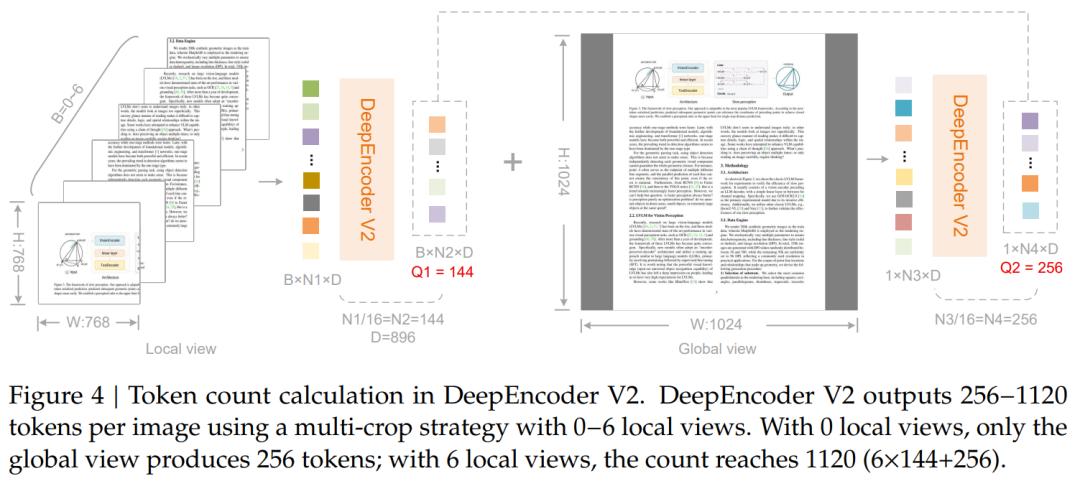
还有个细节:这些查询tokens是“附在”视觉tokens后面的,就像你把“阅读清单”贴在文档旁边,看的时候随时对照——模型处理时,查询能看到所有视觉tokens(全局信息),还能看到前面的查询(之前的阅读顺序),这样就不会“看了后面忘了前面”。
3. 给“视线”划边界:注意力掩码的双重作用
如果你试过同时看两本书,就知道“注意力不集中,什么都看不懂”。模型也一样——如果它同时看所有内容,就没法按顺序处理。DeepEncoder V2的“注意力掩码”(Attention Mask),就是给模型的“视线”划边界,让它知道“什么时候该看全局,什么时候该按顺序看”。
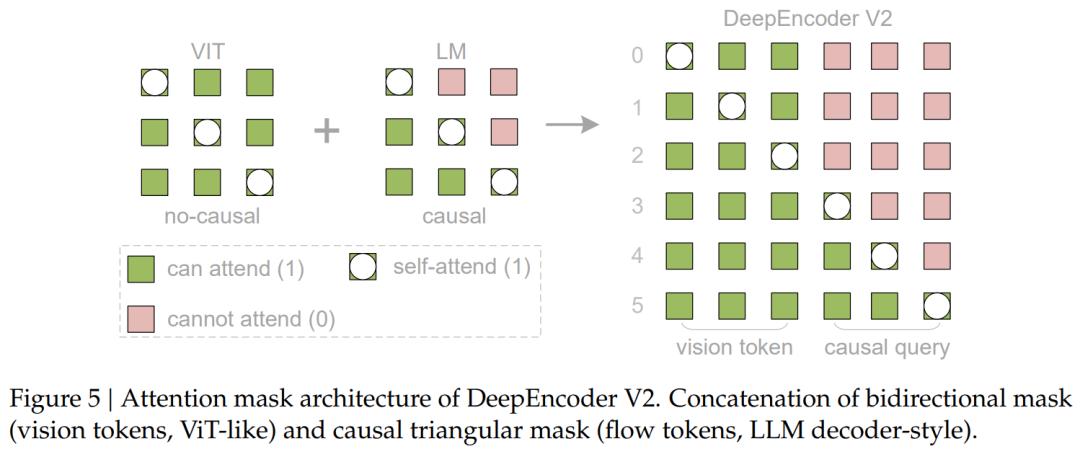
这个掩码分两部分,特别像人看文档的两种状态:
• 双向注意力(左半区):对应视觉tokens,模型能同时看所有视觉内容——就像你打开文档时,先扫一眼全局,知道“这里有个表格,那里有个公式”;
• 因果注意力(右半区):对应因果流查询,模型只能看“前面的查询”——就像你按清单阅读时,看完“摘要”才看“图表”,不会跳着来。
论文里用了个矩阵公式表示这个掩码,但我们不用管公式,只要想明白:这个设计让模型既不会“只见树木不见森林”(只看局部忽略全局),也不会“只见森林不见树木”(只看全局没按顺序)。就像你开车时,既要看前方路况(全局),又要按导航顺序走(因果),缺一不可。
三、实验结果:不只是“更准”,而是“更懂逻辑”
读论文时,我最关心的不是“提升了几个百分点”,而是“这个技术真的解决了实际问题吗”。毕竟很多模型在实验室里表现再好,到真实场景里还是会掉链子。
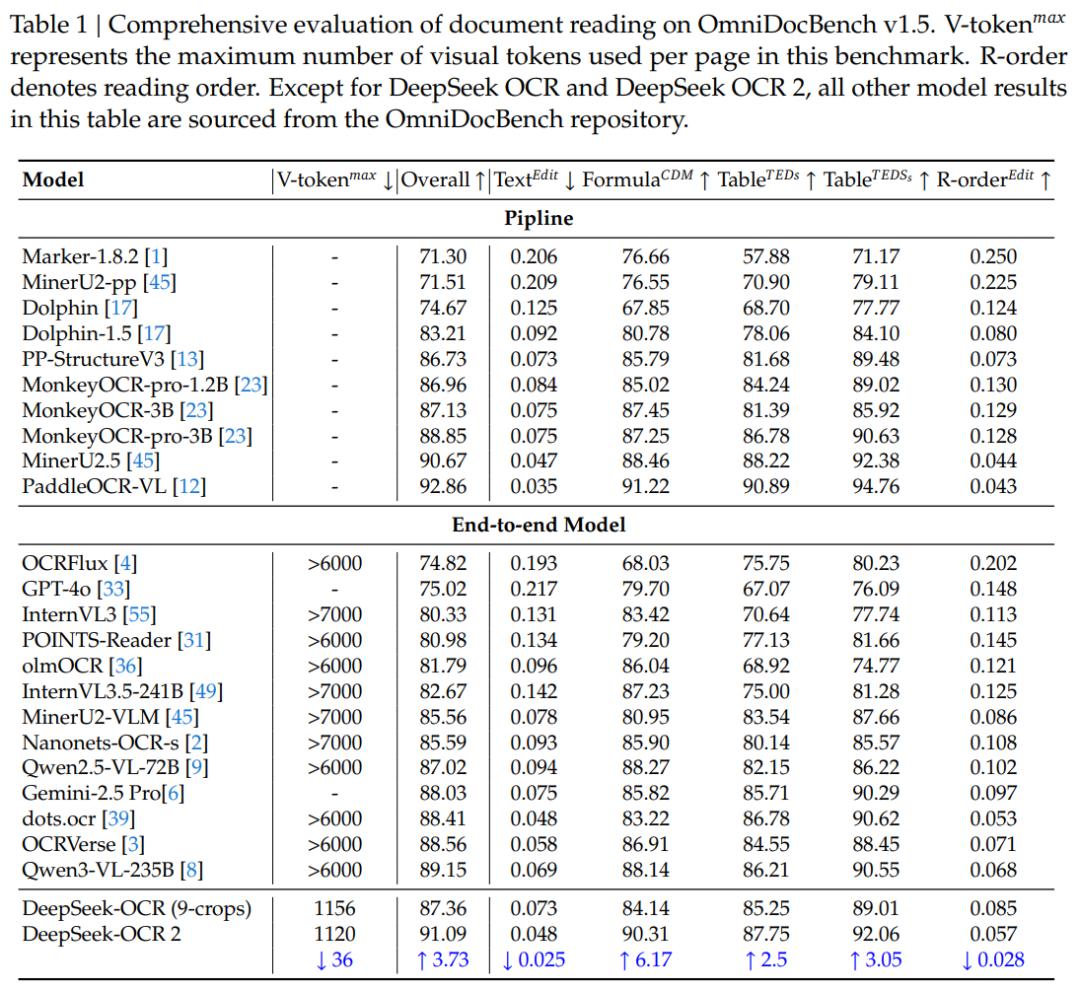
DeepSeek-OCR 2在OmniDocBench v1.5(一个包含1355页文档的 benchmark,涵盖论文、杂志、财报等9类场景)上的表现,让我觉得“这技术真的有用”——不是因为它的整体准确率到了91.09%(比之前的DeepSeek-OCR高3.73%),而是因为两个更关键的指标:
1. 阅读顺序错误率降了:从“乱序”到“顺逻辑”
传统模型最让人头疼的就是“阅读顺序乱”,比如把表格里的行弄反、把公式插在正文中间。论文里用“编辑距离(ED)”衡量这个问题——数值越小,顺序越对。DeepSeek-OCR 2的阅读顺序ED从0.085降到了0.057,看起来降得不多,但实际用起来差别很大。
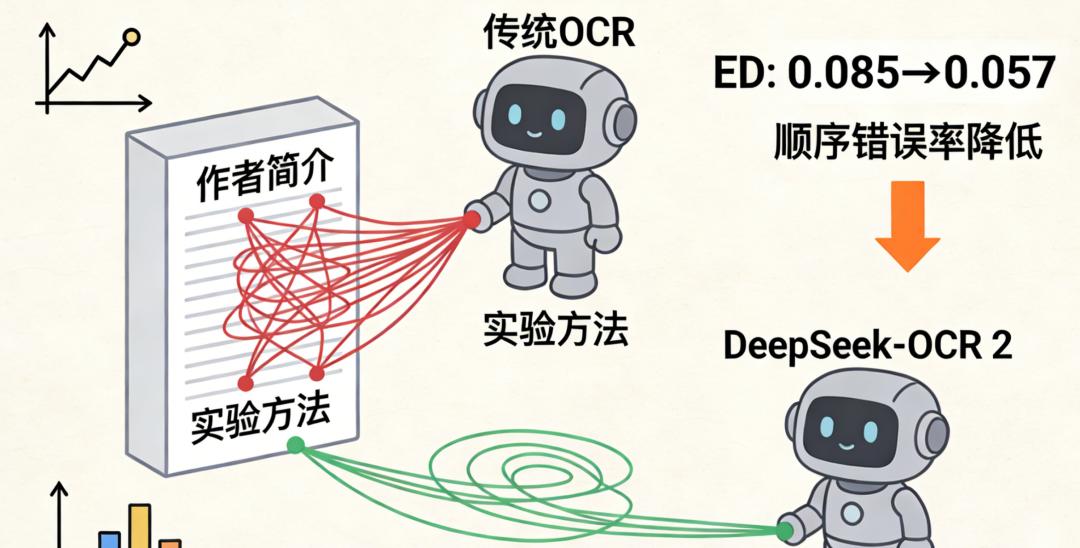
举个例子:之前处理一份带侧边栏的论文,传统模型会把侧边栏的“作者简介”插在正文的“实验方法”部分,读起来完全不通;而DeepSeek-OCR 2会先读完“实验方法”,再读侧边栏的“作者简介”——因为它知道“正文和侧边栏是两个逻辑模块,不能混着读”。
这一点特别重要,因为很多专业文档(比如病历、合同)对“顺序”的要求极高——如果OCR把“过敏史”插在“用药建议”后面,可能会导致严重后果。
2. 复杂元素识别更准:公式、表格不再“读错”
论文里还有个细节:DeepSeek-OCR 2在公式识别(CDF指标)和表格识别(TEDS指标)上的提升,比纯文字识别更明显。比如公式识别准确率提高了6.17%,表格识别提高了2.5%——这说明模型真的“懂”这些复杂元素的逻辑,而不是瞎猜。
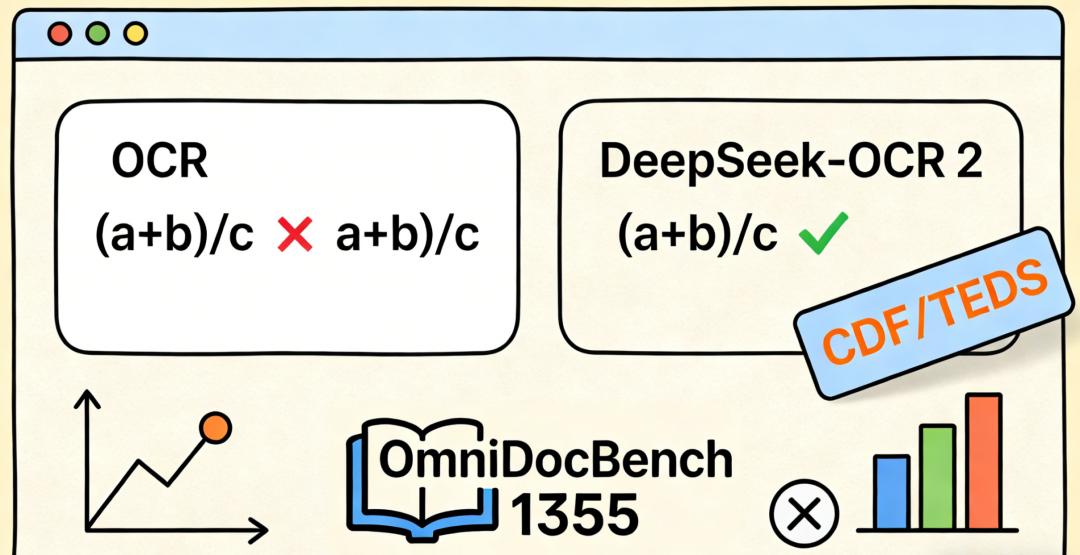
我之前用传统OCR处理带分式的公式,比如“(a+b)/c”,模型经常拆成“a+b/c”,因为它按从左到右的顺序扫,没看懂“分子是一个整体”;而DeepSeek-OCR 2能认出“(a+b)”是分子,“c”是分母,因为它会先看公式的整体结构(因果逻辑),再看局部符号——就像你看公式时,先看括号划分的整体,再看里面的内容。
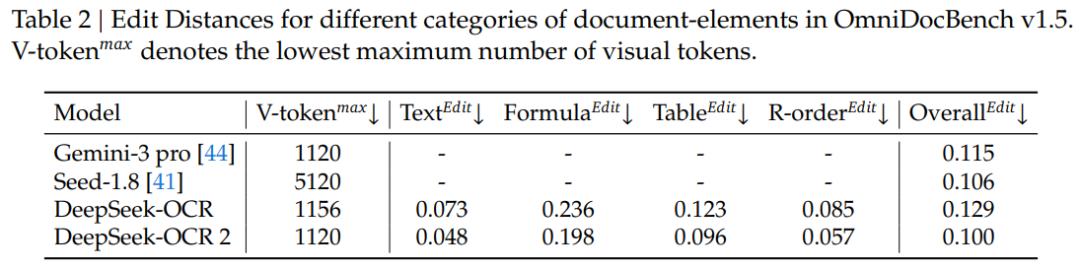
还有个很务实的设计:模型的视觉tokens数量控制在256到1120之间。256对应1024×1024图像的处理(日常文档足够用),1120则和Gemini-3 Pro的最大视觉tokens数持平——这意味着它既能在普通设备上跑(不费算力),又能处理大尺寸文档(比如高清论文图)。
四、我的疑问与思考:这项技术真的能走向“2D推理”吗?
读论文时,我有两个疑问,一个关于“局限”,一个关于“未来”——毕竟没有完美的技术,清醒的认知比盲目吹捧更重要。
1. 疑问一:为什么在“报纸”上表现还不够好?
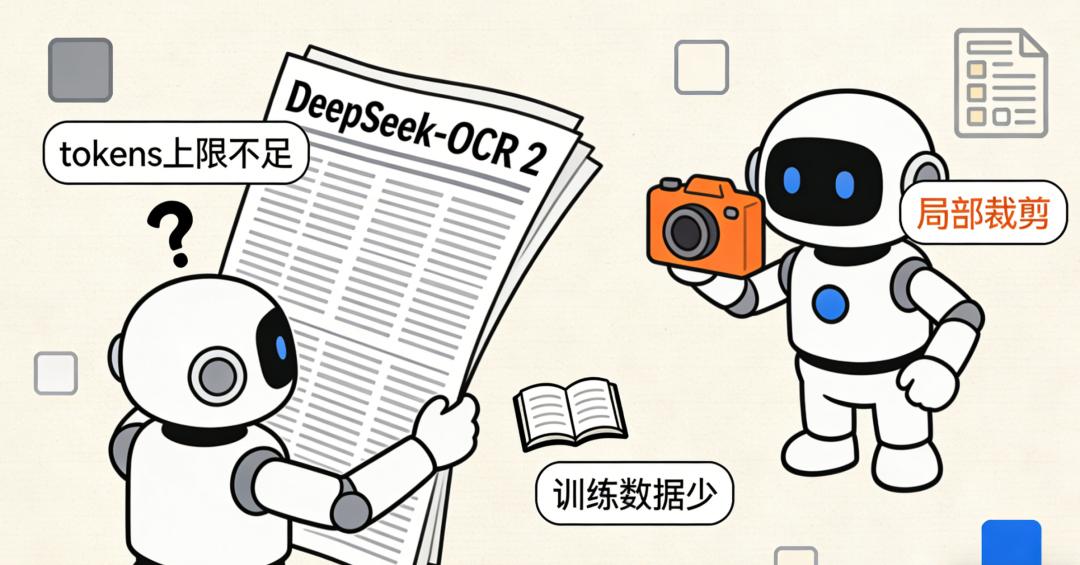
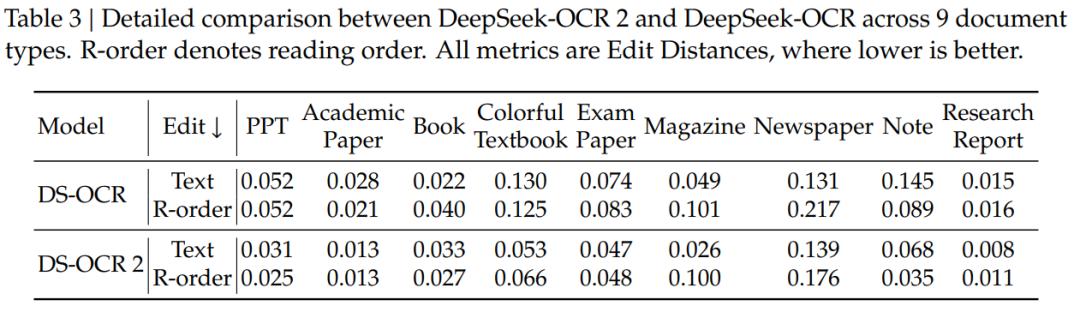
论文里提到,DeepSeek-OCR 2在“报纸”这类文档上的文字识别编辑距离(ED)反而比之前高了一点(>0.131)。研究员们解释了两个原因:一是视觉tokens上限不够(报纸文字太多,256到1120可能不够用),二是训练数据少(只有25万份报纸样本)。
这个解释很坦诚,也让我想到一个点:技术的进步往往受限于“数据的广度”。就像一个人没见过多少报纸,自然不知道报纸的排版逻辑(比如头条在上方、副栏在侧边);模型也一样,没足够多的报纸样本,就没法学会“读报纸的逻辑”。
不过这个问题不难解决——增加局部裁剪数量(比如从6个局部视图增加到8个)就能提升tokens上限,多收集报纸数据也能优化模型。就像给模型多买几本书,让它多见识见识不同的排版风格。
2. 疑问二:“两阶段1D推理”真的能实现“2D推理”吗?
论文结尾提到一个很有野心的方向:通过“编码器的1D因果排序”+“解码器的1D autoregressive推理”,实现真正的2D推理——简单说就是“用两次1D处理,模拟人对2D图像的理解”。
我一开始觉得“这可能吗?”毕竟人看2D图像时,是同时处理空间和逻辑的(比如看一幅画,你既知道人物在左边、风景在右边,又知道人物是主体该先看),而两次1D处理会不会像“把正方形切成两条线,再拼起来”,还是少了点什么?
但再想想,这或许是个“务实的折中方案”——目前的AI还没法完全模拟人类的2D认知,那不如先把2D问题拆成两个1D问题(先按逻辑排序,再按顺序推理),一步一步来。就像人类造飞机,不是一开始就造超音速飞机,而是先造滑翔机,再慢慢改进。
研究员们也提到,要实现真正的2D推理,可能需要“更长的因果流tokens”——让模型有更多“回头看”的机会,就像人看复杂图像时,会多次扫视不同区域,而不是只扫一次。这让我想到心理学里的“视觉工作记忆”——人能记住之前看过的信息,并用它指导后续的扫视,模型或许也需要类似的“记忆能力”。
五、不只是OCR:这项技术背后的“认知革命”
读到最后,我突然意识到:DeepSeek-OCR 2的价值,不只是“让OCR更准”,而是AI从“模仿人类行为”到“模仿人类认知”的一小步——这或许比技术本身更重要。
传统的AI技术,大多是“模仿人类的行为”:比如人能识别猫,AI就学习识别猫;人能读文字,AI就学习读文字。但DeepSeek-OCR 2不一样,它在“模仿人类的认知逻辑”——比如人是按语义顺序看文档的,AI就学习这种顺序;人会“回头核对”信息,AI就设计等量的因果流查询。
这种“认知模仿”的意义在哪里?举个例子:未来处理合同文档时,AI不只是“读对文字”,还能“按法律逻辑读”——先看“甲方乙方”,再看“权利义务”,最后看“违约责任”;处理病历文档时,AI能“按诊疗逻辑读”——先看“症状”,再看“检查结果”,最后看“医嘱”。
这让我想起《人类简史》里的观点:人类之所以能统治地球,是因为我们能“构建共同的逻辑框架”(比如货币、法律、语言)。AI如果能学会人类的“认知逻辑框架”,而不只是模仿表面行为,或许才能真正理解人类的需求。
当然,现在的DeepSeek-OCR 2还只是“初级阶段”——它只在文档OCR场景验证了这个思路,要扩展到更复杂的视觉场景(比如看街景、看图纸)还有很长的路。但至少,它指出了一个方向:AI的进步,不是“堆更多参数”,而是“更懂人类的认知逻辑”。
六、参考资料
• 标题:DeepSeek-OCR 2:视觉因果流(DeepSeek-OCR 2: Visual Causal Flow)
• 作者:Haoran Wei、Yaofeng Sun、Yukun Li
• 单位:DeepSeek-AI
• 链接:https://arxiv.org/pdf/2601.20552