NeurIPS'25谷歌GIST:破解多样vs高效两难,定义智能采样新范式
你有没有过这样的经历:手机相册里存了上万张照片,想挑几十张做成年度纪念册,结果要么挑的全是类似的风景照(看似丰富实则重复),要么东一张西一张毫无逻辑(看似多样却没重点)?其实,AI训练时也面临着一模一样的困境——面对数十亿数据点,怎么选一个小子集,既能覆盖数据的“全貌”(多样性),又能帮模型高效学东西(效用性)?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
直到看到NeurIPS'25谷歌提出的GIST算法时,我才意识到这个“选数据”的问题,比想象中更像一场需要精密计算的晚宴策划。不是随便凑一桌人,而是要在“嘉宾互不重复”和“话题有价值”之间找平衡,还得有数学上的“兜底保证”——这大概就是AI从“粗放式训练”走向“精细化采样”的关键一步。
先搞懂:为什么“选数据”比“存数据”更难?
在聊GIST之前,我得先坦白一个曾经的误解:我以为AI训练就是“数据越多越好”,反正算力够就行。直到看到研究员们的分析才明白,冗余数据不仅会浪费算力(比如重复的猫图片),还可能让模型“学偏”(比如某类图片太多,模型就认不出少见的品种)。
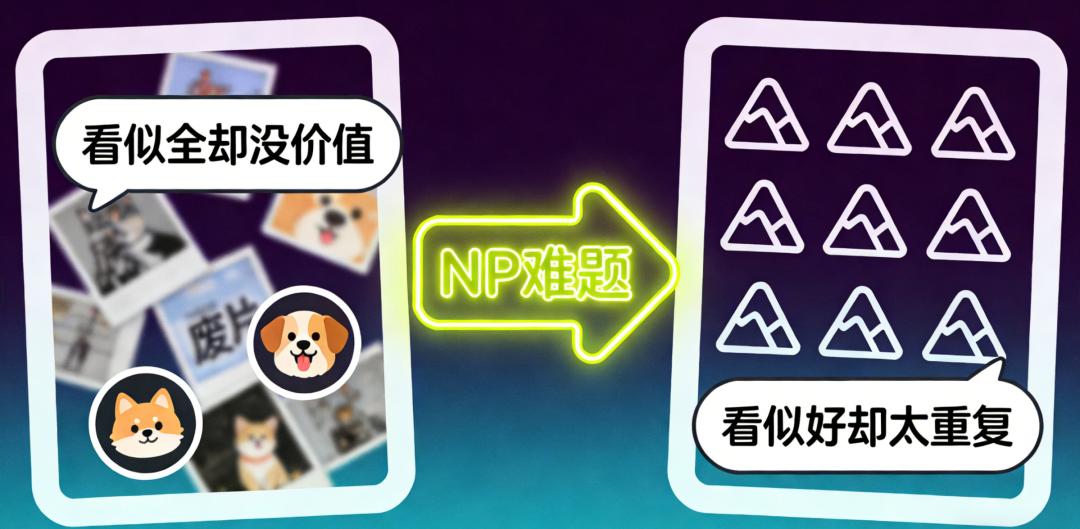
但这里有个核心矛盾——你怎么定义“好”的子集?如果只追求“多样性”,就像把相册里每种类型的照片各挑一张,结果可能选了模糊的废片、重复的截图,看似全面却没一张有纪念意义;如果只追求“效用性”,就像只挑最清晰的风景照,最后纪念册变成了“同一座山的N种角度”,完全失去了年度回顾的意义。
这种矛盾在AI领域被称为“多样性-效用权衡”,而且它不是简单的“二选一”,而是个数学上的“NP难题”——也就是说,没有任何算法能高效找到“绝对最优解”,尤其是面对亿级数据时。就像你要在1000个嘉宾里选50人办晚宴,既不能有互相讨厌的人(多样性),又要保证每个人都能贡献有价值的话题(效用性),逐一排查所有组合几乎不可能。
过去的算法要么偏科:要么只抓“有用”的点(比如只选难分类的图片),结果选出来的全是类似的“难题”;要么只抓“多样”的点(比如按距离随机选),结果选了一堆和任务无关的数据。而GIST最让我惊喜的地方,就是它没试图“完美解决”这个难题,而是用一种“聪明的妥协”,给出了有数学保证的答案——这有点像我们选纪念册时的思路:先定个规则(比如“同一场景最多选2张”),再在规则里挑最好的,最后再调整规则找到最优解。
拆解GIST:一场用数学策划的“AI晚宴”
第一次读GIST的原理时,我对着“最大独立集”“双标准贪婪算法”这些术语皱了眉,直到把它和“晚宴策划”对应起来,才突然看懂了逻辑。其实GIST就做了三件事,每一步都像在精细打磨一场晚宴的嘉宾名单。
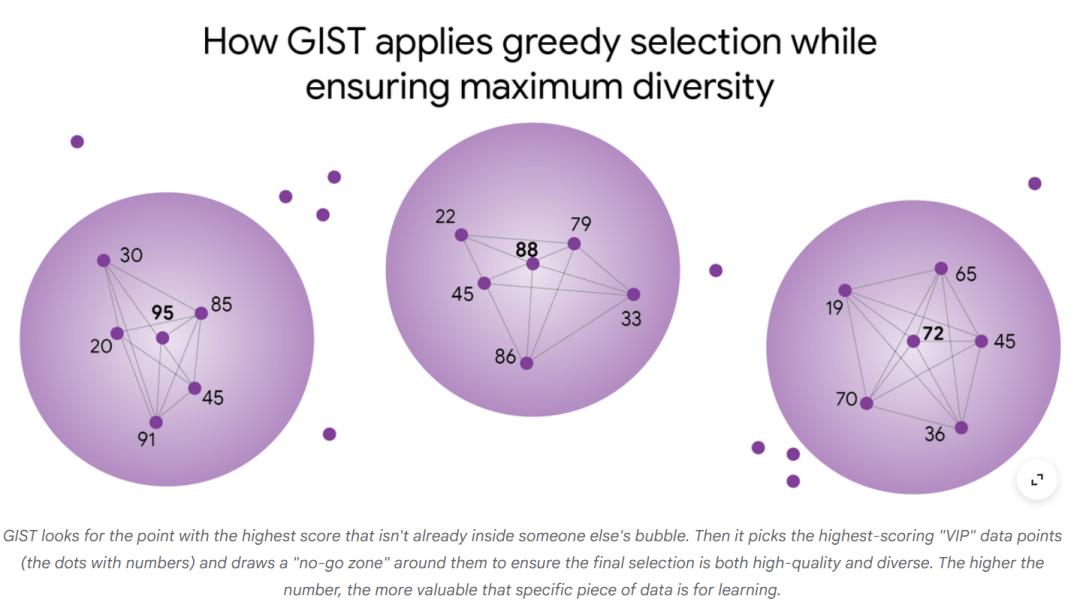
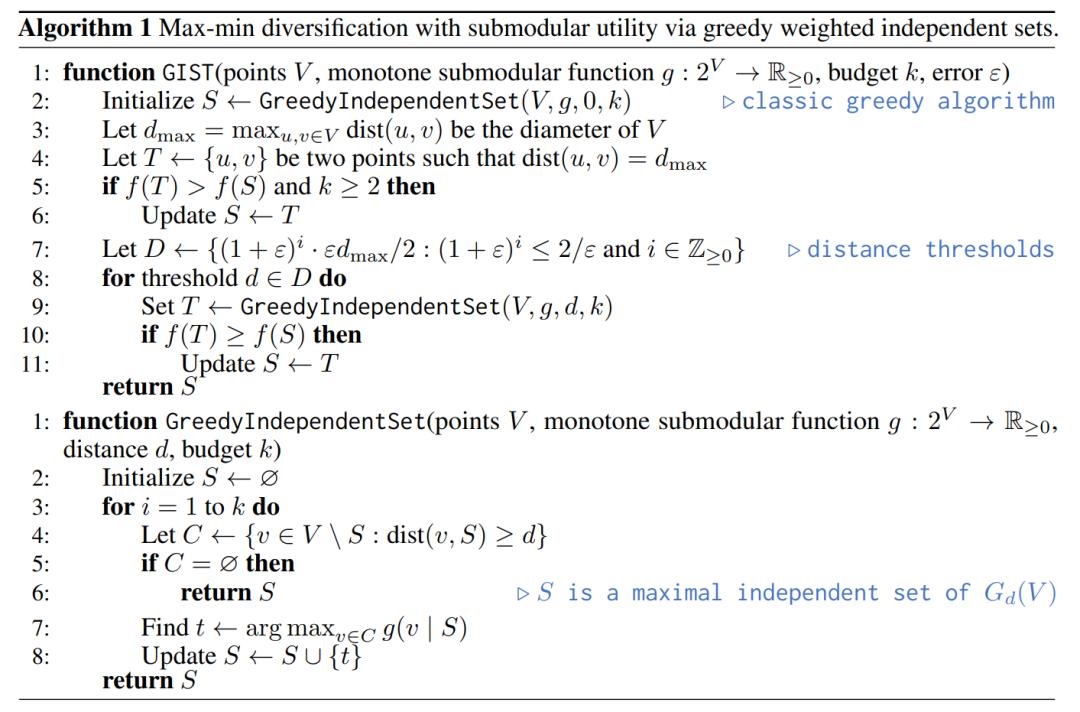
第一步:给“重复嘉宾”画个“禁区”
GIST首先会给每个数据点(相当于嘉宾)设定一个“最小距离”——就像你规定“不能邀请同一公司的同事”,或者“不能邀请互相认识超过10年的人”。这个距离不是物理上的,而是数据在“嵌入空间”里的相似度(比如两张猫图片的特征相似度)。
然后,它会把数据变成一张“关系图”:如果两个数据点的距离小于设定值(比如两张几乎一样的金毛照片),就给它们连一条线,代表“这两个人不能同时入选”。这一步的核心是先解决“重复问题”,避免后续选出来的子集里全是“熟人”。
我刚开始疑惑:为什么不直接找“最远的点”?后来想通了——如果只找最远的,可能会选到和任务无关的数据(比如训练猫分类模型,却选了一张很远但无关的狗图片)。GIST的聪明之处在于,它先“圈定禁区”,但不急于选点,而是为后续的“选价值”铺路。
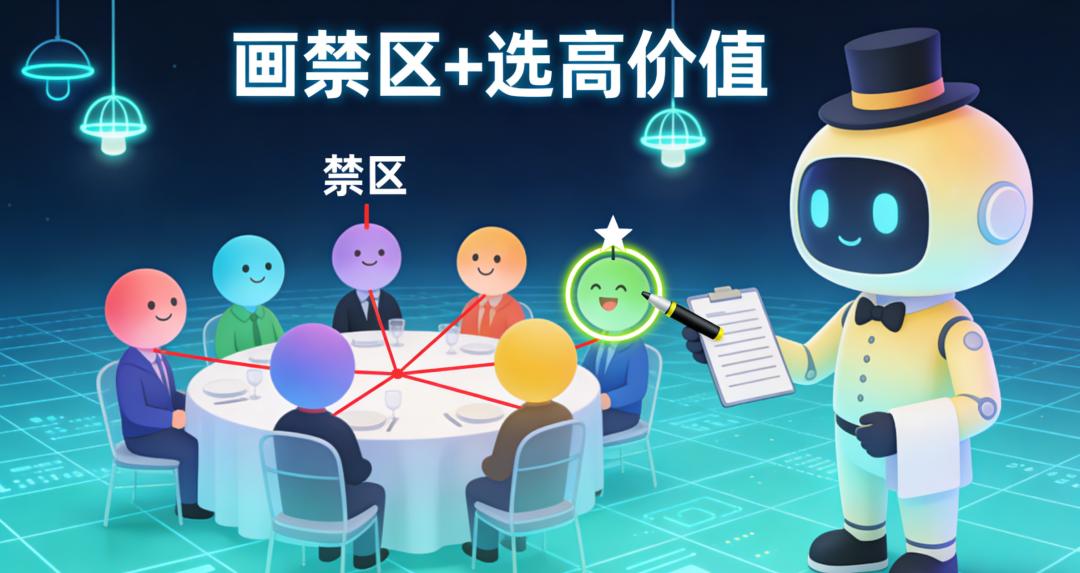
第二步:在“禁区规则”里挑“最有价值的人”
有了关系图,接下来的问题就变成了“最大独立集问题”:在图里选最多的点,且这些点之间没有连线(互不冲突),同时这些点的“总价值”最高。这就像晚宴策划的核心:在“不能有冲突”的规则下,选最能贡献话题的嘉宾。
但这个问题本身也是“NP完全”的——比如有100个嘉宾,可能的组合有2^100种,根本算不完。GIST没有硬算,而是用了“双标准贪婪算法”,简单说就是“逐个试规则,每次挑当前最好的”:
它会遍历很多个“距离阈值”(比如先试“同公司不选”,再试“同行业不选”),对每个阈值都做一件事:先挑价值最高的点(比如行业专家),然后把这个点的“禁区”里的所有点都排除(比如专家所在公司的人都不能选),再从剩下的点里挑下一个价值最高的,直到选够数量。
这个过程像极了我们选纪念册的进阶版:先试“同一场景最多选1张”,挑最好的;再试“同一场景最多选2张”,挑最好的;最后对比所有尝试的结果,选那个“既不重复又最有纪念意义”的子集。
第三步:用数学保证“不会太差”
最让我觉得安心的是GIST的“理论保证”——它能确保选出来的子集,效用至少是“绝对最优解”的一半。听起来好像不高,但要知道,研究员们已经证明:想让这个保证超过0.56都是NP难的。也就是说,GIST已经快摸到了这个问题的“理论天花板”。
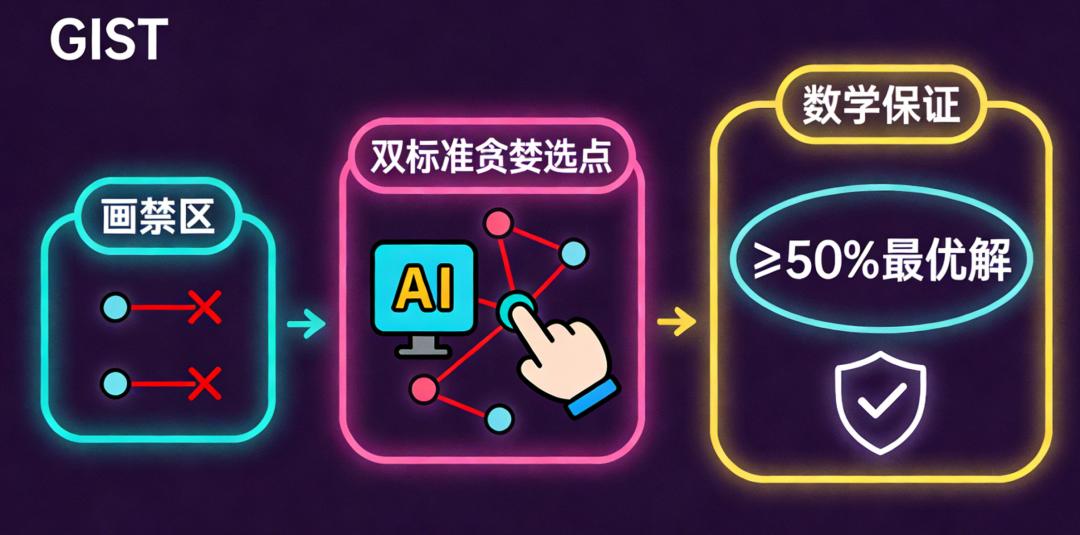
这就像你办晚宴,虽然不知道“绝对最好”的名单是什么,但你能保证自己选的名单,至少有“最好名单”一半的价值——对于需要稳定效果的AI训练来说,这种“数学安全网”比“偶尔选到好子集”重要得多。
从实验室到落地:GIST真的好用吗?
看论文时,我最关心的不是理论多漂亮,而是它在实际场景中能不能用。研究员们的实验结果,倒是打消了我的顾虑。
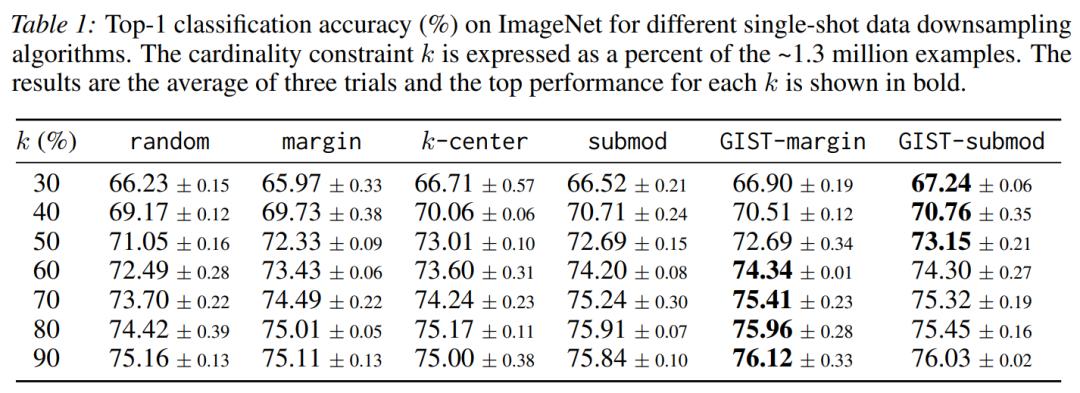
在ImageNet数据集上的测试里,GIST表现得很“务实”:用ResNet-56模型训练时,它选的10%数据子集,比随机采样、只挑难样本、传统子模方法的Top-1精度都高。更关键的是速度——选数据的时间和训练模型的时间比起来,几乎可以忽略不计。比如训练一个模型要3天,GIST选数据可能只需要10分钟,这对于需要频繁调整数据的大规模训练来说,太重要了。
还有个很有意思的应用案例:YouTube的首页排名团队用了类似GIST的“最大最小多样性”思路,来优化视频推荐。过去推荐可能只推热门视频,导致用户很快看腻;现在既保证推荐的视频类型多样(比如你看了科技视频,还会推些人文视频),又保证每个视频都是你可能感兴趣的(效用性),最终提升了用户的长期留存。
这让我想到了心理学里的“曝光效应”——人们会偏好熟悉的事物,但过度熟悉会让人厌倦。GIST的逻辑其实暗合了这种心理:既不能让AI“只看熟悉的数据”(冗余),也不能让它“看完全陌生的数据”(无用),而是在“已知有用”和“未知多样”之间找平衡。
不完美的地方:GIST的“小遗憾”
当然,GIST不是万能的。研究员们也提到了它的局限,这也是我觉得这篇研究很客观的地方。
比如“嵌入失真”的问题:如果数据的“嵌入空间”本身就不准(比如把猫的图片错误地嵌入到狗的特征附近),那么GIST基于距离的判断就会出错。这就像你给嘉宾做“关系调查”时,把“互不认识”的人标成了“认识”,最后选出来的名单自然有问题。
还有“噪声数据”的麻烦:有些数据点因为“与众不同”(比如一张模糊到看不出是什么的图片),会被GIST当成“多样”的点选进来,但实际上对模型训练毫无用处。这就像晚宴上选了一个“背景很特别”但全程不说话的嘉宾,看似多样,却没贡献价值。
另外,GIST的“单次采样”更适合预训练阶段的“数据瘦身”,如果是需要动态调整数据的主动学习场景,还需要和其他方法配合。这让我明白,没有任何一种技术能“包打天下”,AI的进步往往是“多种方法的协作”,就像人类解决复杂问题时,需要不同领域的专家配合一样。
不止是选数据:GIST背后的“平衡思维”
读到最后,我发现GIST给我的启发,早已超出了“数据采样”本身。它更像一种解决“多元目标冲突”的思维方式——不是追求单一指标的极致,而是在多个目标之间找“有保证的平衡”。
这让我想起《中庸》里的“致中和”——不是折中,而是在矛盾中找到最优的平衡点。AI训练曾经的思路是“堆数据、堆参数”,像极了我们年轻时“追求越多越好”的心态;而GIST的出现,更像一种“成熟的选择”——知道自己要什么,也知道什么是“足够好”,用理性的规则代替盲目的堆砌。
再往大了想,这种“平衡思维”可能是未来AI发展的重要方向。比如大模型的“推理”和“记忆”如何平衡?推荐系统的“个性化”和“多样性”如何平衡?甚至AI的“效率”和“公平性”如何平衡?GIST的价值不在于它解决了“选数据”这一个问题,而在于它提供了一种思路:面对复杂的两难问题,与其追求“完美解”,不如设计一套“有保证的、可落地的平衡方案”。
就像我们的生活:选工作时,平衡“兴趣”和“收入”;选朋友时,平衡“三观契合”和“性格互补”;甚至选纪念册时,平衡“多样”和“有意义”。GIST用数学告诉我们,这种平衡不是“凭感觉”,而是可以通过精密的设计实现的——这大概就是技术最动人的地方:它把人类的智慧,变成了可复制、可验证的规则,让复杂的选择变得更理性。
参考资料
• 标题:GIST: Greedy Independent Set Thresholding for Diverse Data Summarization
• 作者:Matthew Fahrbach, Srikumar Ramalingam, Morteza Zadimoghaddam, Sara Ahmadian, Gui Citovsky, Giulia DeSalvo
• 单位:Google
• 链接:https://arxiv.org/pdf/2405.18754