GLM-5技术报告晓读:26%前端提效,HLE新高,开源AI追上闭源前沿
旺晓通:深入浅出解读,轻松通晓技术
当我打开智谱发布的GLM-5技术报告时,第一眼就盯住了Humanity's Last Exam工具推理的数值:50.4%。要知道,上一代GLM-4.7的这个分数只有42.8%,短短一个版本的迭代,提升了近8个百分点。
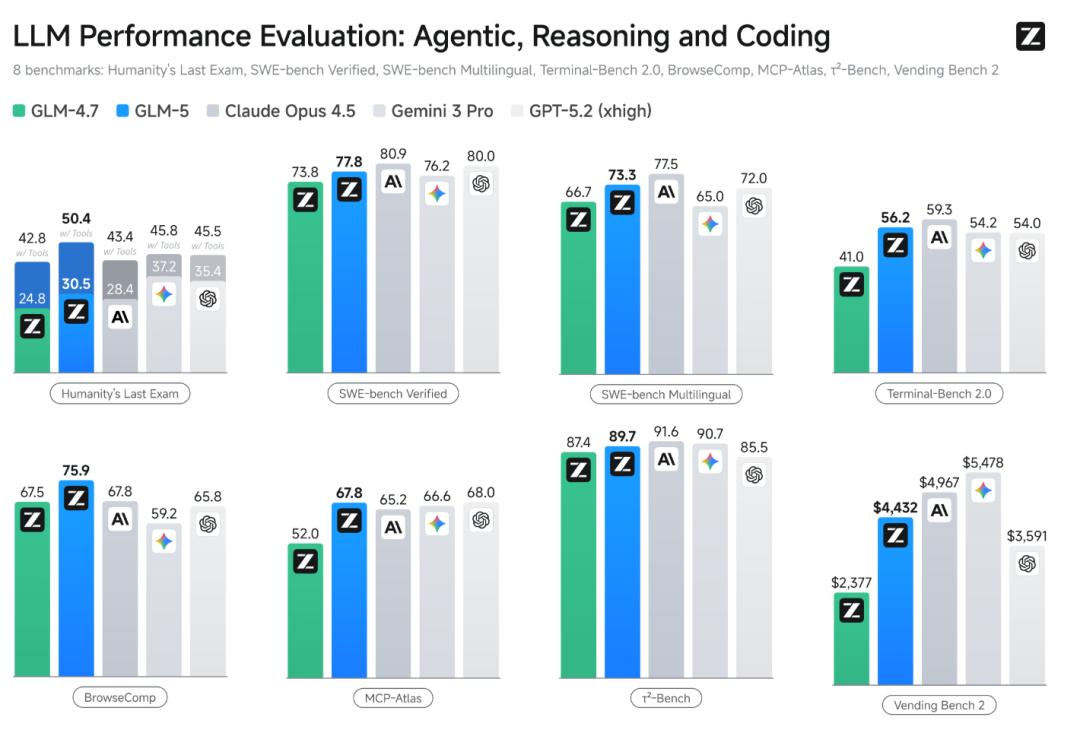
更让我意外的是,这个提升并非来自“无脑堆参数”——GLM-5把全量参数从355B拉到744B,却只将激活参数从32B提升到40B,相当于用5.4%的激活参数,撬动了模型能力的大幅跃升。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
你会不会和我有一样的疑问:为什么大模型发展到今天,终于跳出了“参数越大能力越强”的误区?GLM-5的这组数据背后,藏着大模型从“能说”到“能做”的哪些核心逻辑?而它做到的“开源模型顶尖”,又是否真的让开源AI摸到了闭源前沿的门槛?
大模型的三个“伪命题”,GLM-5终于踩碎了
看GLM-5的技术设计前,我想先聊一个行业共识:过去两年的大模型发展,其实陷入了三个看似正确的“伪命题”。
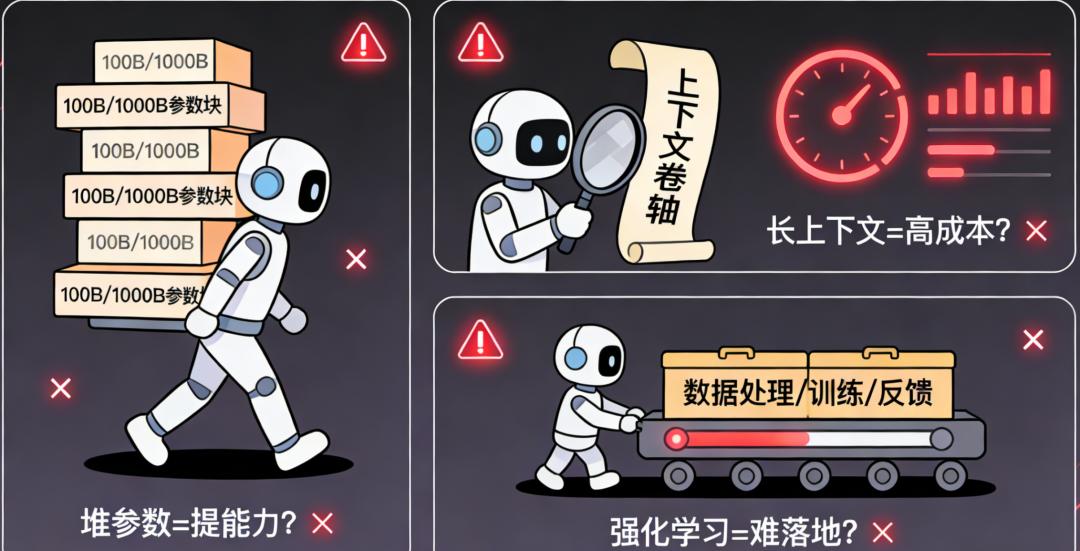
第一个伪命题,堆参数=提能力。就像一家公司为了完成项目,不问岗位需求只一味招人,结果人浮于事、沟通成本剧增。此前的很多大模型,把参数从百亿堆到千亿,能力确有提升,但部署成本也跟着指数级上涨,普通企业根本用不起,最终只能成为实验室里的“花瓶”。
第二个伪命题,长上下文=高成本。长上下文能力是大模型处理复杂任务的关键,比如解读万字文档、完成跨月的项目规划,但传统的注意力机制,让长上下文必然伴随算力的大量消耗,就像用放大镜逐字看一本书,看的内容越多,花的时间越长。
第三个伪命题,强化学习=难落地。强化学习(RL)是让大模型从“合格”到“优秀”的关键,但传统的RL训练是“串行工作”,一个环节做完才能进行下一个,训练效率极低,就像工厂的流水线少了传送带,每个工序都要手动衔接,根本无法规模化。
这三个伪命题,本质上指向同一个问题:大模型的发展,需要从“野蛮生长”的规模竞赛,转向“精耕细作”的工程化设计。而GLM-5的所有创新,都是围绕这个核心展开的——它没有否定“缩放”的价值,而是让缩放变得“更聪明”。
三个核心设计,像给大模型装了“智能大脑+高效手脚”
GLM-5的技术创新,没有花里胡哨的新概念,却精准解决了上述三个痛点。我不想照搬技术报告里的专业表述,而是用三个生活中的比喻,拆解它的核心逻辑。
第一个设计,744B全量参数+40B激活参数,像给大模型建了一座“带核心藏书区的图书馆”。全量744B参数是图书馆的所有藏书,保证了知识的全面性,而40B激活参数是门口的核心藏书区,把最常用、最核心的知识放在这里,读者不用翻遍整个图书馆,就能快速找到答案。这种设计的妙处在于,既保留了大模型的知识储备,又避免了全量参数运行的算力浪费,就像我们大脑的工作方式——不会同时激活所有神经元,只会针对具体问题调动相关区域。
第二个设计,融合DeepSeek稀疏注意力(DSA),像让大模型学会了“抓重点看书”。传统的注意力机制是“逐字阅读”,哪怕是无关内容,也要消耗算力处理,而稀疏注意力就像我们读报告时,会跳过无关的铺垫,直接看标题、图表和结论,既保留了对整体内容的理解,又大幅节省了时间。GLM-5通过这种方式,在不损失长上下文能力的前提下,显著降低了部署成本,让大模型从“实验室专属”走向“企业可复用”。
第三个设计,自研slime异步强化学习基础设施,像给大模型的训练装上了“新媒体团队的协作系统”。传统的RL训练是“串行工作”,数据处理、模型训练、效果反馈依次进行,而slime是“异步协作”,多个环节可以同时推进,还能根据反馈实时调整,就像新媒体团队写稿、设计、排版同步进行,编辑看到初稿就能提出修改意见,不用等终稿完成再返工。这种设计让RL训练的吞吐量和效率大幅提升,让大模型的“后期打磨”变得更精细、更高效。
这三个设计看似独立,实则相辅相成:全量参数保证“有知识”,激活参数保证“调得快”,稀疏注意力保证“跑得省”,异步RL保证“练得精”。说到底,GLM-5的核心创新,不是发明了新的技术,而是把现有技术做了最合理的组合,让大模型的能力落地有了可行的路径。
从“体感编码”到“智能体工程”,大模型终于开始“认真工作”
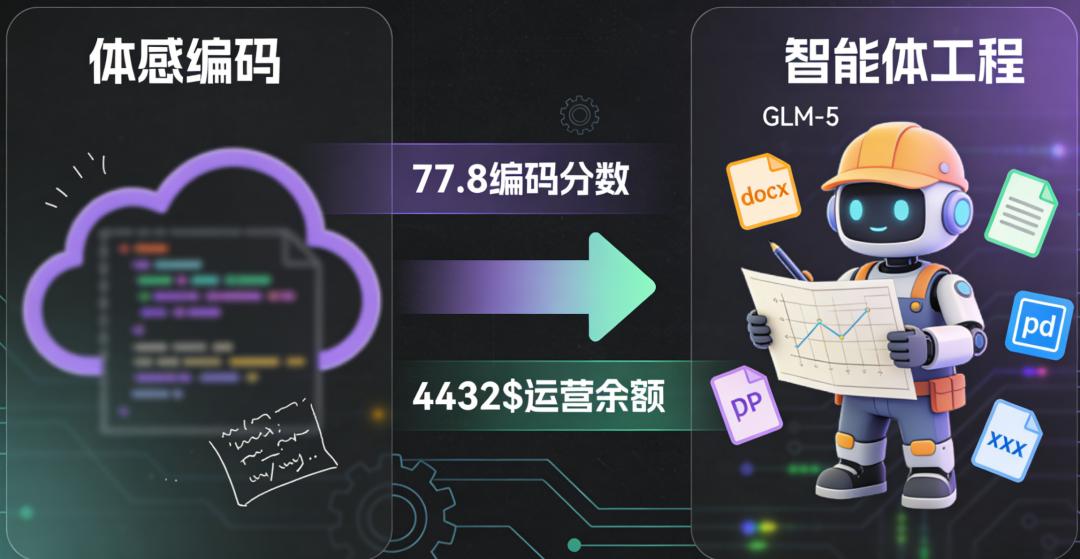
技术报告里有一个词让我印象深刻:从Vibe Coding到Agentic Engineering,翻译过来就是从“体感编码”到“智能体工程”。我理解的“体感编码”,是大模型凭感觉完成任务,比如写一段代码、做一个简单的推理,而“智能体工程”,是让大模型像一个专业的工程师一样,能完成复杂的、长周期的、有明确目标的任务。
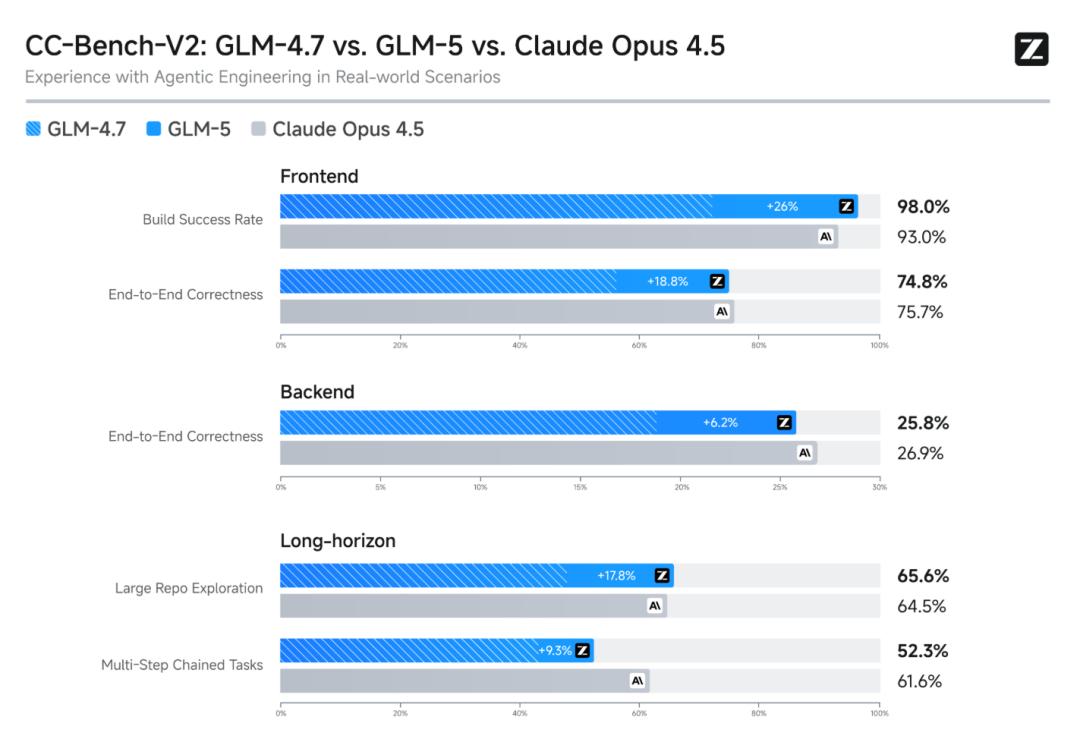
GLM-5的实验结果,恰恰印证了这种转变。在编码任务SWE-bench Verified中,它拿到了77.8的分数,比GLM-4.7提升4个百分点,这个提升看似不多,却意味着大模型从“能解决常规编码问题”,升级到“能处理复杂的工程bug”;
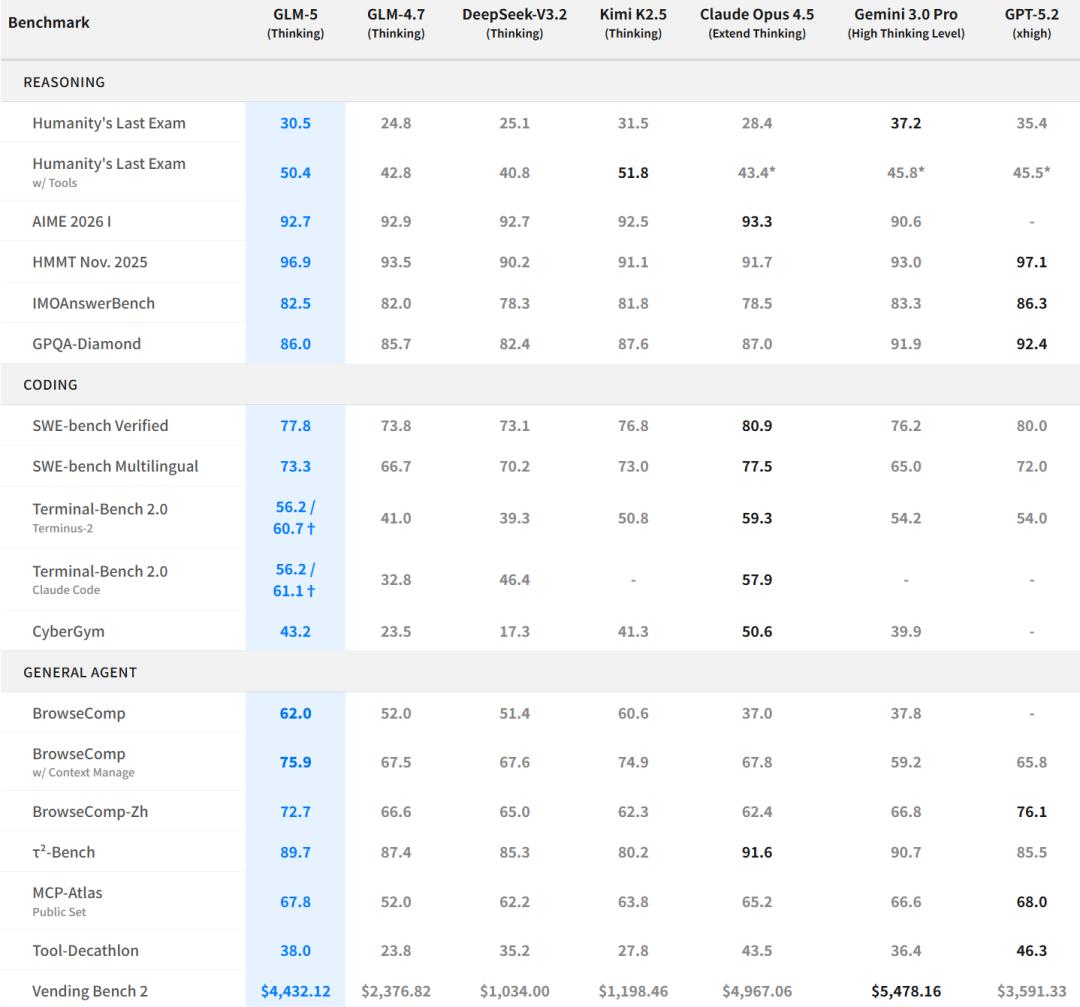
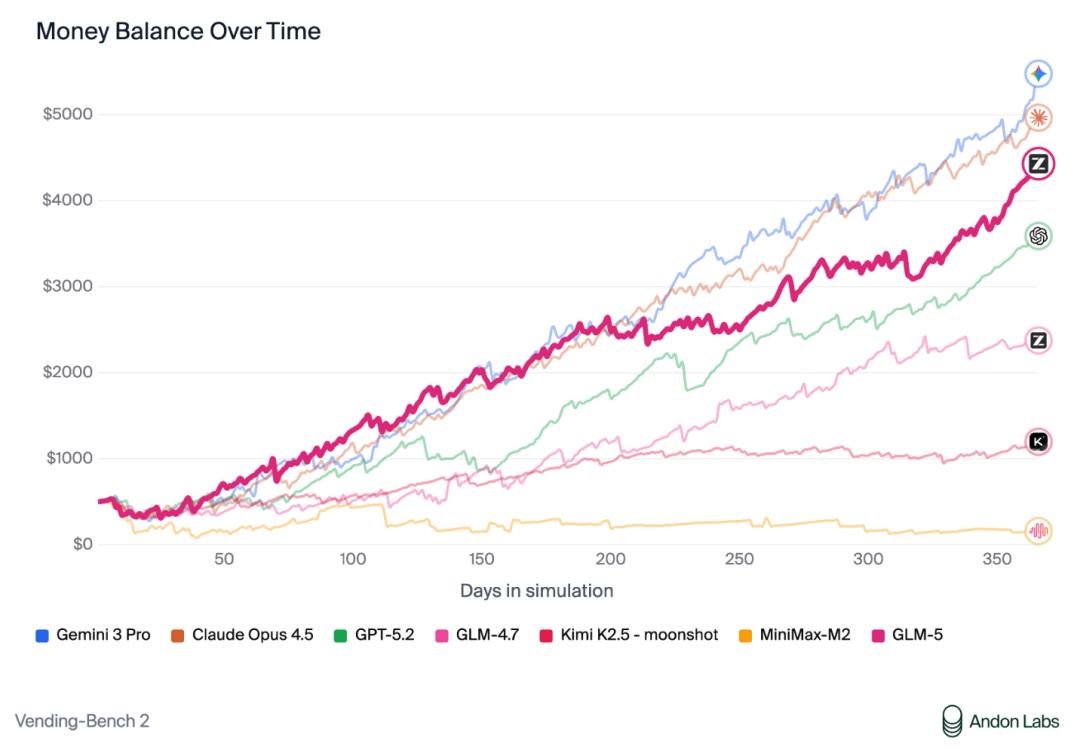
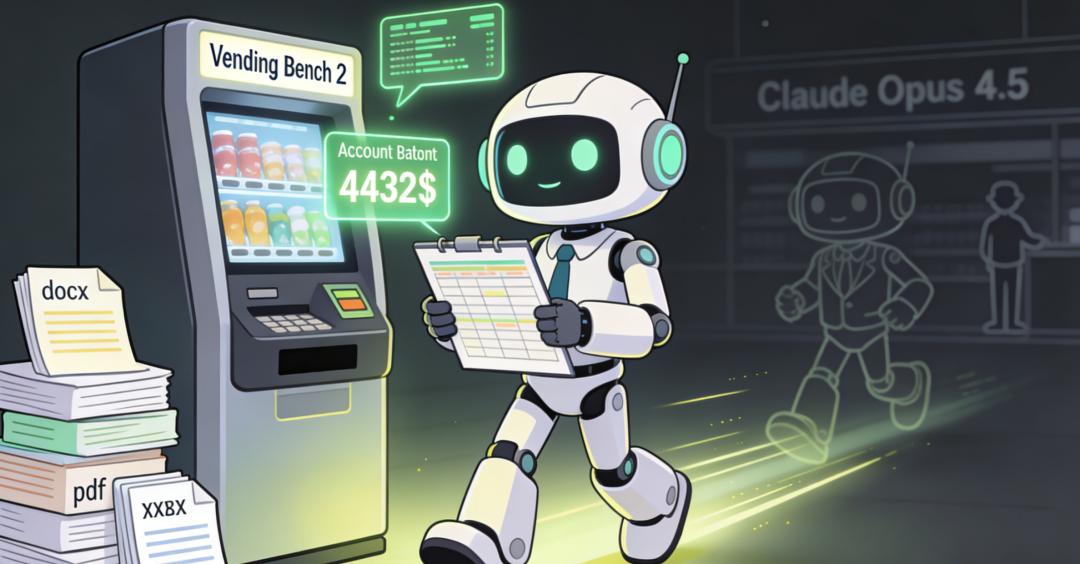
在长程运营任务Vending Bench 2中,它在模拟一年的售货机运营中,最终账户余额达到4432美元,成为开源模型中的第一名,逼近闭源的Claude Opus 4.5,这证明它拥有了极强的长程规划和资源管理能力,就像一个新手店长,经过系统训练后,运营能力几乎追上了资深店长。
最让我惊喜的是它的工具推理能力,在Humanity's Last Exam工具推理任务中,50.4%的分数不仅大幅超越上一代,甚至超过了最新闭源模型。要知道,工具推理是大模型从“聊天机器人”到“工作助手”的关键——人类工作时,会用计算器、查资料、翻文档,大模型只有学会使用工具,才能真正替代人类完成实际工作。GLM-5的这个分数,意味着开源模型终于在“工具使用”这个核心能力上,摸到了闭源前沿的门槛。
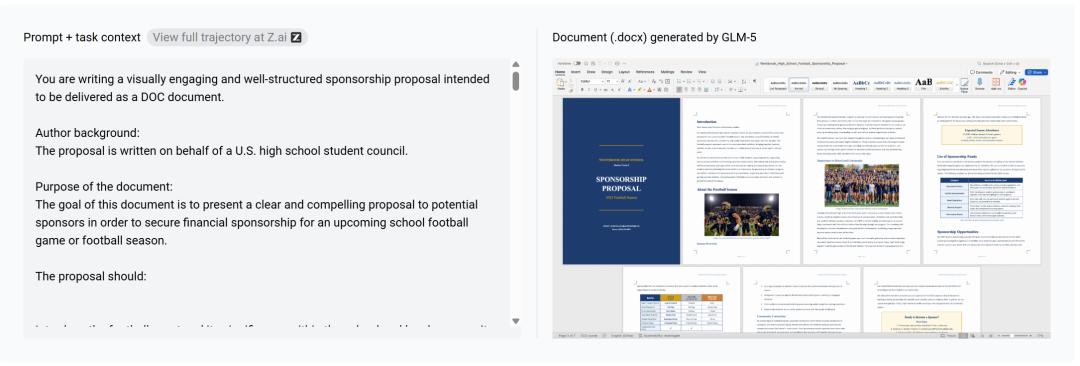
还有一个细节值得关注:GLM-5能直接把文本指令转化为.docx、.pdf、.xlsx等格式的实用文档,从赞助提案到财务报告,能直接生成可落地的成果。这让我想到了匠人精神——过去的大模型是“画图纸的设计师”,而GLM-5变成了“能做出成品的工匠”,这种从“纸上谈兵”到“落地实操”的转变,才是技术真正的价值。
跨域联想:大模型的进化,和人类的认知成长何其相似
研究GLM-5的设计逻辑时,我总忍不住联想到人类的认知成长,两者的底层逻辑几乎一致。
心理学中有一个概念叫刻意练习,核心是不做无意义的重复,而是有目标、有反馈、有方法的训练。这和GLM-5的设计不谋而合——它没有盲目堆参数、堆数据,而是通过激活参数的精准选择、稀疏注意力的算力优化、异步RL的精细打磨,让每一份算力、每一组数据都发挥最大价值,这正是大模型的“刻意练习”。
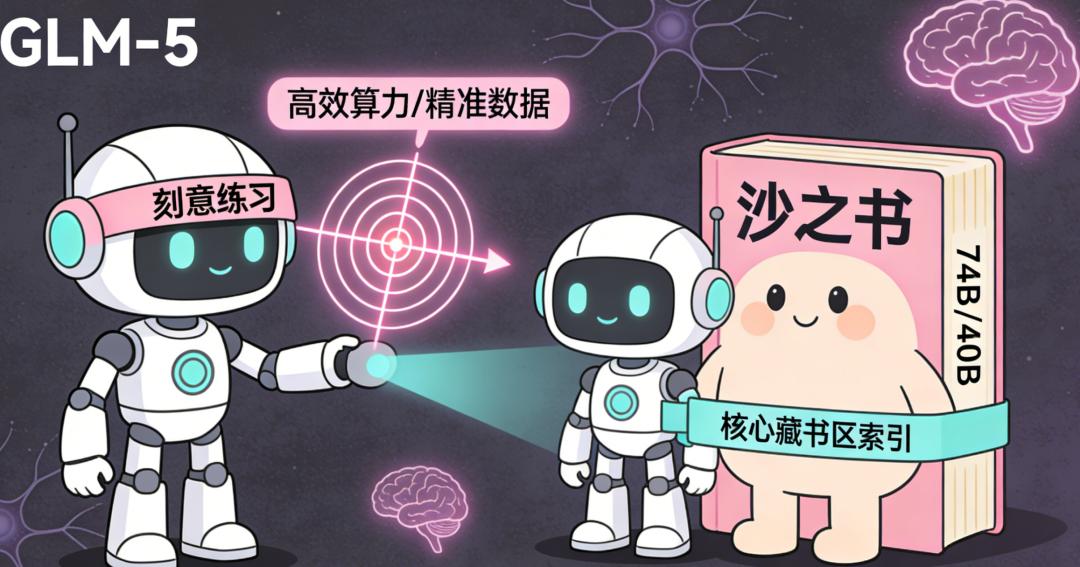
而博尔赫斯在《沙之书》中写过一本无限的书,拥有所有的知识,却因为没有索引、没有结构,最终无法被利用。这像极了早期的大模型,参数越来越大、知识越来越多,却因为没有高效的调取方式,只能在简单任务中发挥作用。而GLM-5的设计,就是给这本“沙之书”做了索引、分了区域、建了核心藏书区,让无限的知识能被精准、高效地利用。
还有管理学中的精益生产,核心是去掉一切无用的浪费,让生产流程更高效。GLM-5的稀疏注意力、激活参数设计,本质上就是大模型的“精益生产”——去掉无意义的算力消耗,让模型的运行更高效、更经济。
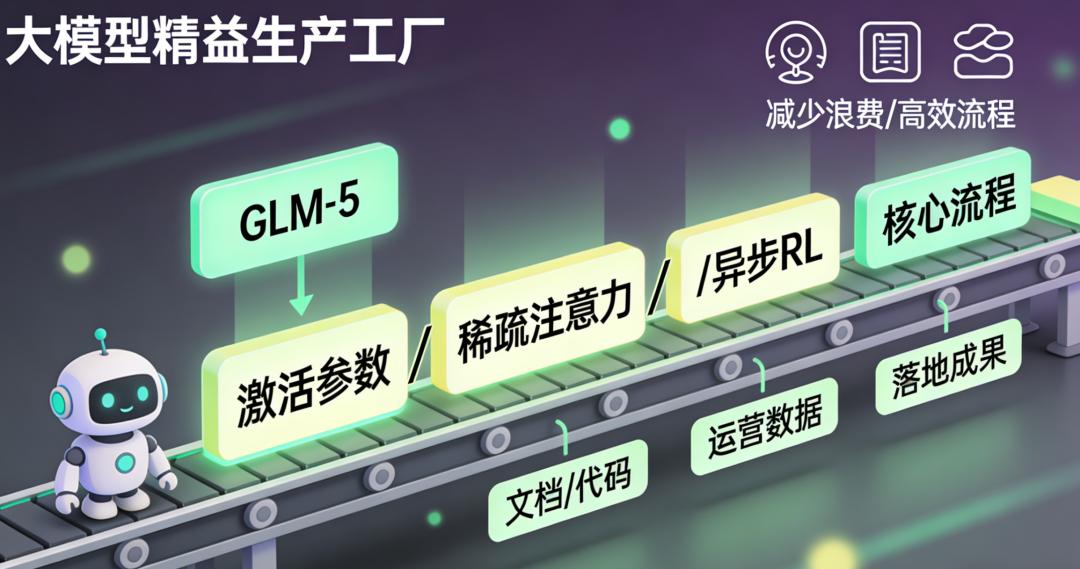
说到底,智能的本质从来都不是“拥有多少知识”,而是“如何高效利用知识”。人类如此,大模型亦如此。
GLM-5的未来,还有哪些可能性?
看完GLM-5的技术报告,我为开源模型的进步感到欣喜,但也有二个真实的疑问,想和大家一起探讨。
第一个疑问,40B激活参数是最优解吗? GLM-5将激活参数从32B提升到40B,实现了能力的大幅提升,但这个比例是不是适用于所有任务?比如在创意生成任务中,是否需要更少的激活参数来保证灵活性?在复杂的工程任务中,是否需要更多的激活参数来保证精度?如果未来能实现激活参数的动态调整,根据不同任务匹配不同的激活比例,大模型的效率会不会更高?
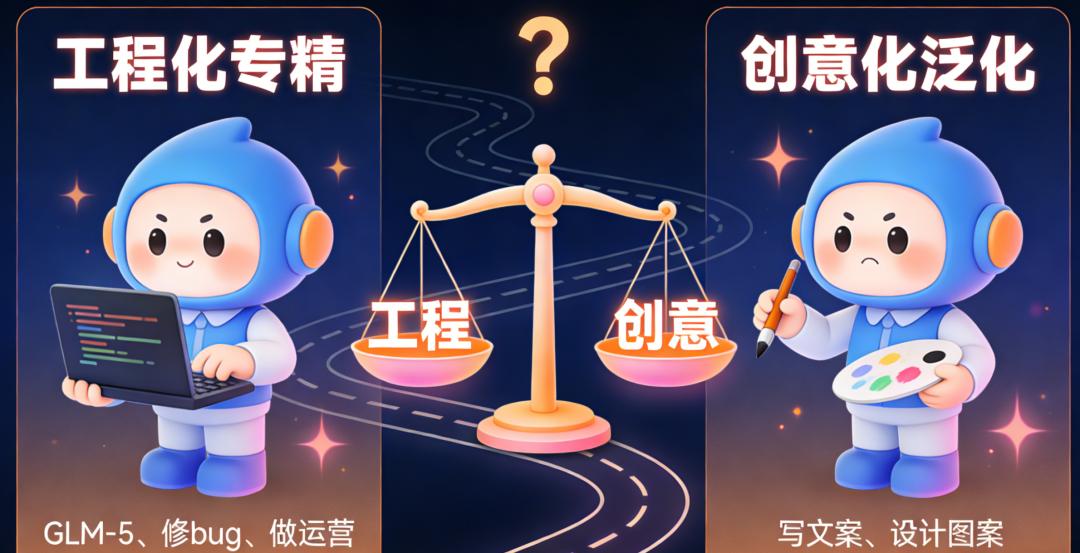
第二个疑问,工程化之外,创意性如何平衡? GLM-5的定位是复杂系统工程和长程智能体任务,报告中的实验也主要聚焦在推理、编码、运营等工程化任务上,那么它在文学创作、广告文案、艺术设计等创意性任务中表现如何?大模型的发展,是否会走向“工程化专精”和“创意化泛化”的两条赛道?
这些疑问,或许就是GLM-5未来的进化方向,也是整个大模型行业需要回答的问题。
不止是GLM-5,大模型的时代正在变天
最后,我想跳出GLM-5本身,聊聊它背后的行业趋势。GLM-5的发布,不仅是一个模型的升级,更是大模型行业从“规模竞赛”到“工程化时代”的标志。
过去,我们评判一个大模型的好坏,只看参数、看数据、看跑分;未来,我们评判一个大模型的价值,会看它的部署成本、看它的落地能力、看它能解决多少实际问题。就像评判一个员工,不再只看学历,而是看他的工作效率、看他的解决问题的能力。
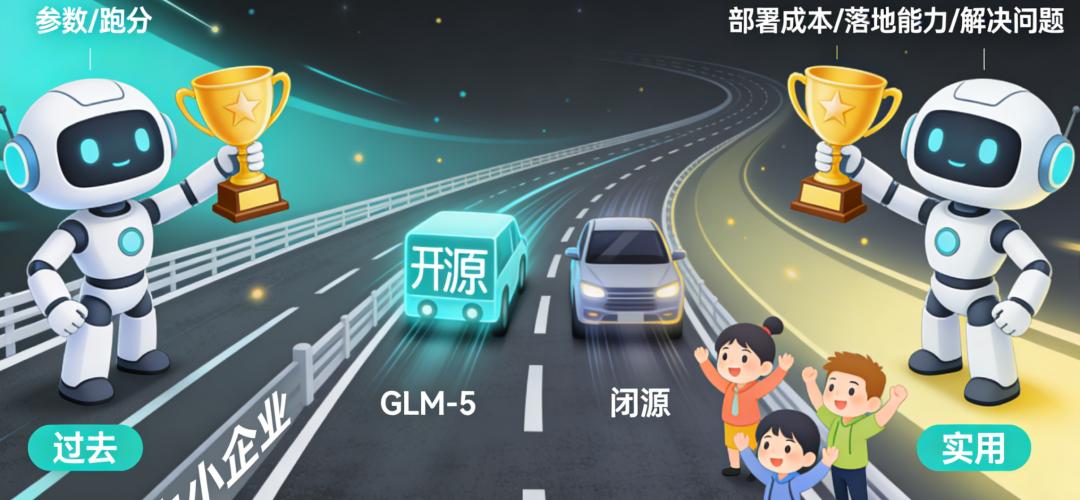
而开源模型的崛起,更是让大模型的发展走向普惠。在此之前,闭源模型凭借算力、数据的优势,占据了大模型的第一梯队,而GLM-5的发布,让开源模型终于追上了闭源前沿的脚步。这种竞争,不仅能推动技术的快速迭代,更能让AI技术走出实验室,走进各行各业,让中小企业、普通开发者都能享受到AI的红利。
从GLM-5身上,我看到了AGI的另一种可能:它不是一个无所不能的“超级大脑”,而是一个高效、实用、可落地的“工作伙伴”。它不会替代人类,而是会成为人类的延伸,让我们从繁琐的重复性工作中解放出来,把更多的时间用在创意、思考、创新上。
这或许就是AI技术最珍贵的价值:不是让机器变得更像人,而是让人变得更像人。
参考资料
• 标题:GLM-5: From Vibe Coding to Agentic Engineering
• 研发团队:智谱AI
• 链接:https://z.ai/blog/glm-5